

Hľadanie funkčných závislostí v dátach sa používa v rôznych oblastiach analýzy dát: správa databáz, čistenie dát, reverzné inžinierstvo databáz a exploračná analýza. O samotných závislostiach sme už publikovali. Anastázie Birillo a Nikity Bobrova. Tentoraz sa Anastázia — absolventka Computer Science Center tohto roku — delí o pokrok tejto práce v rámci NIR, ktorú obhájila v centre.
Výber úlohy
Počas štúdia v CS centre som začala hĺbkovo študovať databázy, konkrétne hľadanie funkčných a rozdielových závislostí. Táto téma bola spojená s témou mojej bakalárskej práce na univerzite, takže počas práce na bakalárke som začala čítať články o rôznych závislostiach v databázach. Napísala som prehľad tejto oblasti — jednu z mojich prvých. v angličtine a predložila ju na konferenciu SEIM-2017. Bola som veľmi rada, keď som sa dozvedela, že bola prijatá, a rozhodla som sa hĺbšie venovať téme. Samotná koncepcia nie je nová — začali ju aplikovať už v 90-tych rokoch, no aj dnes nachádza uplatnenie v mnohých oblastiach.
V druhom semestri štúdia v centre som začala výskumný projekt na zlepšenie algoritmov hľadania funkčných závislostí. Pracovala som na ňom spolu s postgraduálnym študentom SPbGU Nikitom Bobrovom v JetBrains Research.
Výpočtová náročnosť hľadania funkčných závislostí
Hlavný problém — výpočtová náročnosť. Počet možných minimálnych a netriviálnych závislostí je obmedzený hornou hodnotou  , kde
 — počtom atribútov tabuľky. Časová náročnosť algoritmov závisí nielen od počtu atribútov, ale aj od počtu riadkov. V 90-tych rokoch mohli algoritmy na hľadanie FZ na bežnom stolnom počítači spracovávať dátové sady obsahujúce až 20 atribútov a desiatky tisíc riadkov počas niekoľkých hodín. Moderné algoritmy, ktoré pracujú na viacjadrových procesoroch, odhaľujú závislosti pre dátové sady pozostávajúce zo stoviek atribútov (až 200) a stoviek tisíc riadkov, približne v rovnakom čase. Napriek tomu je to stále nedostatočné: takýto čas je neprijateľný pre väčšinu reálnych aplikácií. Preto sme vyvíjali prístupy na urýchlenie existujúcich algoritmov.
Schémy kešovania pre priesečné partitiony
V prvej časti práce sme vyvinuli schémy cachingu pre triedu algoritmov, ktoré používajú metódu priesečníka partícií. Partícia pre atribút predstavuje súbor zoznamov, kde každý zoznam obsahuje čísla riadkov so rovnakými hodnotami pre daný atribút. Každý taký zoznam sa nazýva klaster. Mnohé moderné algoritmy používajú partície na určenie, či je závislosť udržiavaná alebo nie, pričom sa riadia lemou: Závislosť  je udržiavaná, ak
 . Tu
 je určená partícia a používa sa pojem veľkosť partície – počet klastrov v nej. Algoritmy, ktoré používajú partície, pri porušení závislosti pridávajú dodatočné atribúty do ľavej časti závislosti, po čom ju znova prepočítajú, vykonávajúc operáciu priesečníka partícií. Takáto operácia sa v článkoch nazýva špecializácia. Avšak všimli sme si, že partície pre závislosti, ktoré budú udržiavané až po niekoľkých kolách špecializácie, môžu byť aktívne znovu používané, čo môže významne skrátiť čas práce algoritmov, keďže operácia priesečníka je náročná.
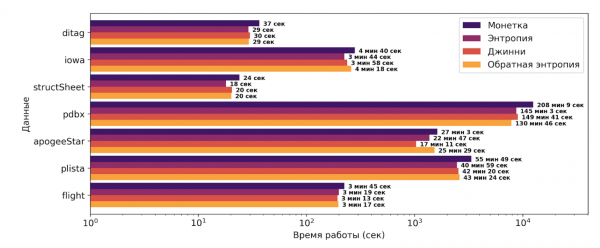
Preto sme navrhli heuristiku založenú na Shannonovej entropii a Giniho neistote, ako aj našej metrike, ktorú sme nazvali Opačná entropia. Je to malá modifikácia Shannonovej entropie a rastie s tým, ako rastie jedinečnosť súboru údajov. Navrhnutá heuristika vyzerá nasledovne:

Tu  — miera jedinečnosti nedávno vypočítanej partície
 , a
 je mediánom stupňa jedinečnosti pre jednotlivé atribúty. Ako metrika jedinečnosti boli vyskúšané všetky tri metriky opísané vyššie. Taktiež je možné poznamenať, že v heuristike sú prítomné dva modifikátory. Prvý naznačuje, ako blízko je aktuálna partition k primárnemu kľúču a umožňuje väčšiu mieru cachovania tých partition, ktoré sú ďaleko od potenciálneho kľúča. Druhý modifikátor umožňuje sledovanie obsadenosti cache a tak stimuluje pridávanie väčšieho množstva partition do cache pri voľnom mieste. Úspešné vyriešenie tejto úlohy umožnilo zrýchliť algoritmus PYRO o 10-40% v závislosti od datasetu. Je potrebné poznamenať, že algoritmus PYRO je najúspešnejší v tejto oblasti.
Na obrázku nižšie môžete vidieť výsledky aplikácie navrhnutej heuristiky v porovnaní so základným prístupom k cachovaniu založenom na hádzaní mince. Os X je logaritmická.
Alternatívny spôsob ukladania partition
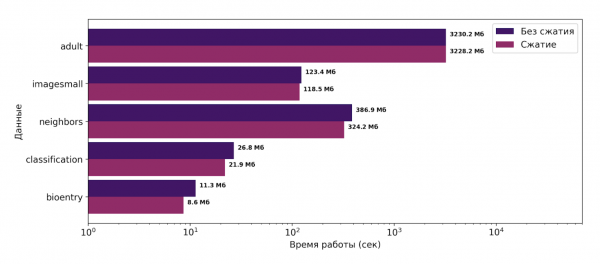
Následne sme navrhli alternatívny spôsob ukladania partition. Partition predstavuje súbor klastrov, v ktorých sú uložené čísla n-tíc so synchronizovanými hodnotami podľa určitých atribútov. Tieto klastry môžu obsahovať dlhé sekvencie čísiel n-tíc, napríklad ak sú údaje v tabuľke usporiadané. Preto sme navrhli schému kompresie pre ukladanie partition, a to konkrétne intervalové ukladanie hodnôt v klastri partition:
$$display$$pi(X) = {{underbrace{1, 2, 3, 4, 5}_{Prvý~interval}, underbrace{7, 8}_{Druhý~interval}, 10}}\ downarrow{Kompresia}\ pi(X) = {{underbrace{$, 1, 5}_{Prvý~interval}, underbrace{7, 8}_{Druhý~interval}, 10}}$$display$$
Táto metóda dokázala znížiť spotrebu pamäte počas činnosti algoritmu TANE o 1 až 25%. Algoritmus TANE je klasický algoritmus na vyhľadávanie FD, počas jeho práce využíva partition. V rámci praxe bol vybraný práve algoritmus TANE, pretože implementovať do neho intervalové ukladanie bolo podstatne jednoduchšie ako napríklad do PYRO, aby sa zhodnotilo, či navrhovaný prístup funguje. Získané výsledky sú prezentované na obrázku nižšie. Os X je logaritmická.
Konferencia ADBIS-2019
Na základe výskumu v septembri 2019 som vystúpila s článkom Na konferencii 23. európskej konferencie o pokroku v databázach a informačných systémoch (ADBIS-2019) počas prezentácie vyzdvihol prácu Bernhard Thalheim, významný človek v oblasti databáz. Výsledky výskumu tvorili základ mojej diplomovej práce na mat-fyzike na SPbGU, počas ktorej boli obe navrhované prístupy (cacheovanie a kompresia) implementované do oboch algoritmov: TANE a PYRO. Výsledky ukázali, že navrhované prístupy sú univerzálne, pretože pri oboch algoritmoch a oboch prístupoch došlo k výraznému zníženiu spotrebovanej pamäte, ako aj k významnému skráteniu času spracovania algoritmov.
Zdroj: habr.com
