

Ako je známe, spoločnosť SAP ponúka kompletné portfólio softvéru pre spracovanie transakčných údajov, ako aj ich analýzu a vykazovanie. Predovšetkým platforma SAP Business Warehouse (SAP BW) predstavuje nástroj na ukladanie a analýzu údajov s širokými technickými možnosťami. Napriek svojim objektívnym výhodám má systém SAP BW jeden významný nedostatok: vysoké náklady na ukladanie a spracovanie údajov, najmä pri využívaní cloudovej služby SAP BW on Hana.
A čo keby sme ako úložisko začali používať nejaký non-SAP a ideálne OpenSource produkt? V spoločnosti X5 Retail Group sme sa rozhodli pre GreenPlum. To síce rieši otázku nákladov, ale hneď sa objavujú otázky, ktoré sa pri použití SAP BW riešili takmer automaticky.
Predovšetkým, akým spôsobom získavať údaje zo zdrojových systémov, ktoré sú väčšinou riešeniami SAP?
Projekt "HR-metriky" bol prvý, v ktorom bolo potrebné túto otázku riešiť. Naším cieľom bolo vytvorenie úložiska HR údajov a vybudovanie analytických správ týkajúcich sa správy zamestnancov. Hlavným zdrojom údajov je transakčný systém SAP HCM, v ktorom sa vedú všetky personálne, organizačné a mzdové aktivity.
Extrakcia údajov
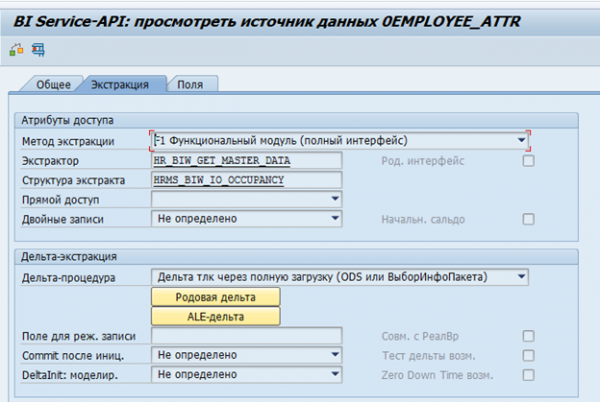
V SAP BW pre SAP systémy existujú štandardné extraktory údajov. Tieto extraktory môžu automaticky zbierať potrebné údaje, sledovať ich integritu a určovať zmeny. Napríklad, štandardný zdroj údajov pre atribúty zamestnanca 0EMPLOYEE_ATTR:
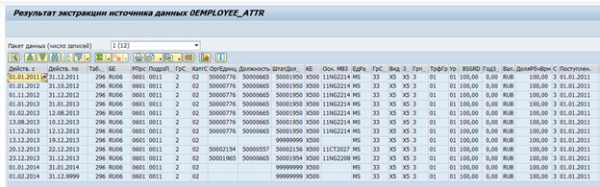
Výsledok extrakcie údajov z neho pre jedného zamestnanca:
V prípade potreby môže byť takýto extraktor modifikovaný na základe vlastných požiadaviek alebo môže byť vytvorený vlastný extraktor.
Prvá myšlienka sa objavila o možnosti ich opätovného využitia. Bohužiaľ, toto sa ukázalo ako neuskutočniteľná úloha. Väčšina logiky je implementovaná na strane SAP BW, a bezbolestne oddeliť extraktor na zdroji od SAP BW sa nepodarilo.
Stalo sa jasným, že je potrebný vývoj vlastného mechanizmu na extrakciu údajov zo systémov SAP.
Štruktúra ukladania údajov v SAP HCM
Aby sme pochopili požiadavky na takýto mechanizmus, musíme najprv určiť, aké konkrétne údaje budeme potrebovať.
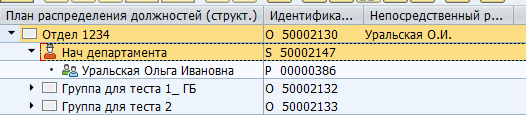
Väčšina údajov v SAP HCM je uložená v plochých SQL tabuľkách. Na základe týchto údajov aplikácie SAP vizualizujú organizačné štruktúry, zamestnancov a ďalšie HR informácie. Napríklad takto vyzerá organizačná štruktúra v SAP HCM:
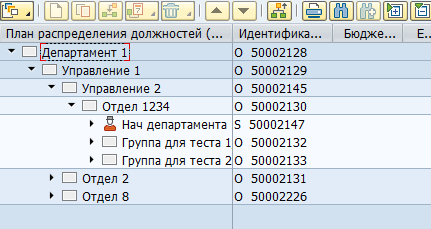
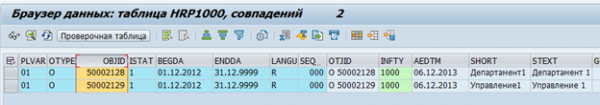
Fyzicky sa tento strom uchováva v dvoch tabuľkách — v hrp1000 objekty a v hrp1001 vzťahy medzi týmito objektmi.
Objekty „Oddelenie 1“ a „Úrad 1“:
Vzťah medzi objektmi:
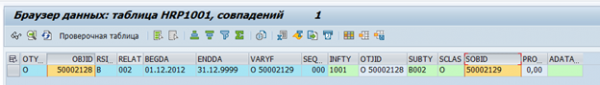
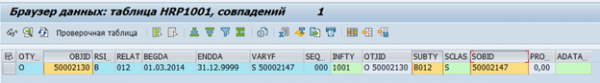
Existuje obrovské množstvo typov objektov a typov vzťahov medzi nimi. Existujú ako štandardné vzťahy medzi objektmi, tak aj prispôsobené pre vlastné špecifické potreby. Napríklad štandardný vzťah B012 medzi organizačnou jednotkou a pracovnou pozíciou ukazuje na vedúceho oddelenia.
Zobrazenie vedúceho v SAP:
Uloženie v databázovej tabuľke:
Údaje zamestnancov sú uložené v tabuľkách pa*. Napríklad údaje o pracovných udalostiach zamestnanca sú uložené v tabuľke pa0000
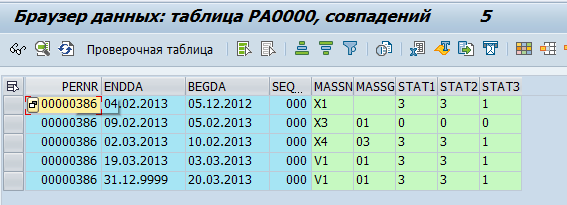
Rozhodli sme sa, že GreenPlum bude získavať "surové" údaje, t.j. jednoducho ich kopírovať z tabuľiek SAP. Potom budú v GreenPlum spracované a transformované na fyzické objekty (napríklad Oddelenie alebo Zamestnanec) a metriky (napríklad priemerná početnosť zamestnancov).
Bolo určených približne 70 tabuliek, z ktorých je potrebné prenášať údaje do GreenPlum. Potom sme prešli na vypracovanie spôsobu prenosu týchto údajov.
SAP ponúka dosť veľké množstvo integračných mechanizmov. Ale najjednoduchší spôsob — priamy prístup k databáze je z dôvodu licenčných obmedzení zakázaný. Takže všetky integračné toky musia byť realizované na úrovni servera aplikácií.
Ďalším problémom bolo absencia údajov o odstránených záznamoch v databáze SAP. Pri odstránení riadku v databáze sa fyzicky vymaže. T.j. vytvorenie dĺžky zmien podľa času zmeny nebolo možné.
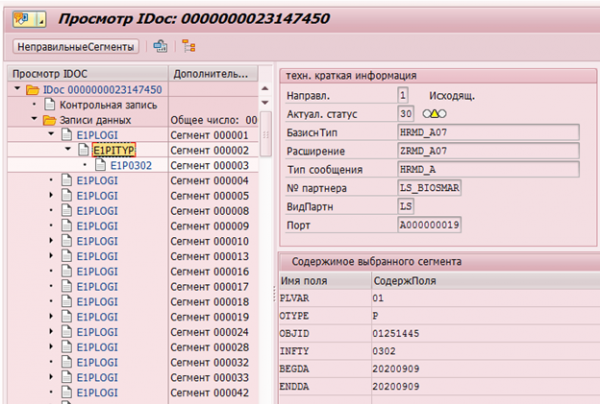
Samozrejme, v SAP HCM existujú mechanizmy na zaznamenávanie zmien údajov. Napríklad pre neskorší prenos do prijímacích systémov existujú ukazovatele zmien (change pointer), ktoré zaznamenávajú akékoľvek zmeny a na základe ktorých sú vytvorené Idoc (objekt na prenos do externých systémov).
Príklad IDoc zmeny infotypu 0302 u zamestnanca s evidenčným číslom 1251445:
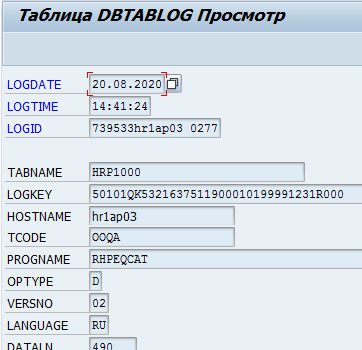
Alebo vedenie logov zmien údajov v tabuľke DBTABLOG.
Príklad logu odstránenia záznamu s kľúčom QK53216375 z tabuľky hrp1000:
Ale tieto mechanizmy nie sú dostupné pre všetky potrebné údaje a ich spracovanie na úrovni aplikačného servera môže vyžadovať značné množstvo zdrojov. Preto hromadné zapínanie logovania na všetky potrebné tabuľky môže viesť k výraznej degradácii výkonu systému.
Ďalším vážnym problémom boli klastrové tabuľky. Údaje o hodnotení času a výpočte mzdy v RDBMS verzii SAP HCM sú uložené vo forme súboru logických tabuliek pre každého zamestnanca za každý výpočet. Tieto logické tabuľky sú vo forme binárnych údajov uložené v tabuľke pcl2.
Klastr výpočtu mzdy:
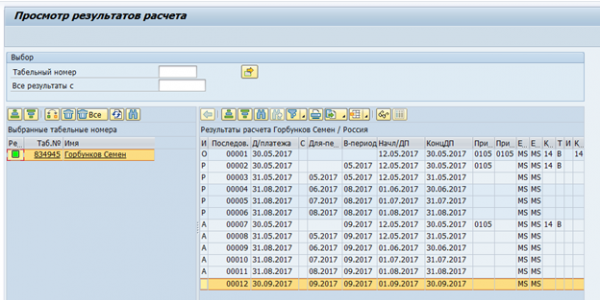
Údaje z klastrových tabuliek nie je možné čítať SQL príkazom, ale vyžaduje sa použitie makropokynov SAP HCM alebo špeciálnych funkčných modulov. Zodpovedajúcim spôsobom bude rýchlosť čítania takýchto tabuliek pomerne nízka. Na druhej strane, v týchto klastroch sú uložené údaje, ktoré sú potrebné len raz za mesiac – konečný výpočet mzdy a hodnotenie času. Takže rýchlosť v tomto prípade nie je tak kritická.
Pri hodnotení možností na vytvorenie delta zmien údajov sme sa rozhodli zvážiť aj možnosť s úplným exportom. Možnosť každý deň prenášať gigabajty nemenných údajov medzi systémami nemôže vyzerať atraktívne. Avšak má aj niekoľko výhod – nie je potrebné implementovať delta na strane zdroja, ani implementovať integráciu tejto delty na strane prijímača. Zodpovedajúcim spôsobom sa znižuje nákladovosť a doba realizácie a zvyšuje sa spoľahlivosť integrácie. Pri tom bolo stanovené, že takmer všetky zmeny v SAP HR sa dejú v horizonte troch mesiacov pred aktuálnym dátumom. Takže bolo prijaté rozhodnutie zastaviť sa na dennom úplnom exporte údajov z SAP HR za N mesiacov pred aktuálnym dátumom a na mesačnom úplnom exporte. Parameter N závisí od konkrétnej tabuľky
a kolíše od 1 do 15.
Pre extrakciu údajov bola navrhnutá nasledujúca schéma:
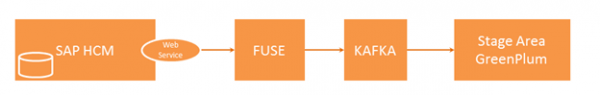
Externý systém vytvára požiadavku a posiela ju do SAP HCM, kde sa táto požiadavka kontroluje na úplnosť údajov a oprávnenia na prístup k tabuľkám. V prípade úspešnej kontroly SAP HCM spustí program, ktorý zberá potrebné údaje a odosiela ich do integračného riešenia Fuse. Fuse určuje potrebnú tému v Kafka a posiela údaje tam. Následne sa údaje z Kafka prenášajú do Stage Area GP.
V tejto reťazci nás zaujíma otázka extrakcie údajov zo SAP HCM. Zastavme sa na nej podrobnejšie.
Schéma interakcie SAP HCM-FUSE.
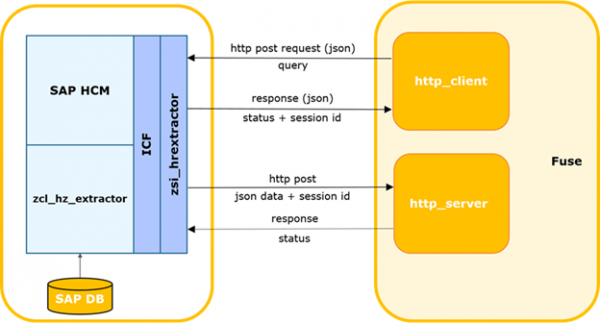
Externý systém určuje čas poslednej úspešnej požiadavky v SAP.
Proces môže byť spustený podľa časovača alebo inej udalosti, vrátane nastavenia časového limitu na čakanie na odpoveď s údajmi od SAP a iniciovanie opätovnej požiadavky. Po tom vytvára požiadavku delta a odosiela ju do SAP.
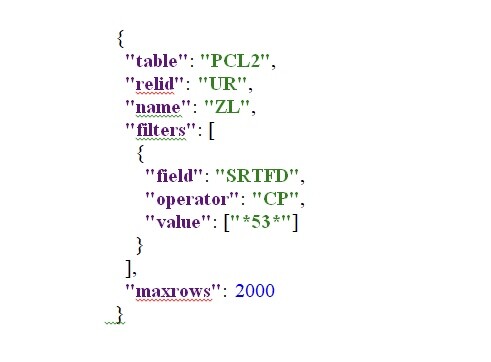
Údaje požiadavky sa prenášajú v tele vo formáte json.
Metóda http: POST.
Príklad dotazu:
Služba SAP vykonáva kontrolu požiadavky na úplnosť, zhodu so súčasnou štruktúrou SAP a prítomnosť oprávnenia na prístup k požadovanej tabuľke.
V prípade chýb služba vracia odpoveď s príslušným kódom a popisom. V prípade úspešnej kontroly vytvára pozadový proces na generovanie výberu, generuje a synchronne vracia jedinečný id relácie.
Externý systém v prípade chyby registruje túto chybu v denníku. V prípade úspešnej odpovede odovzdáva id relácie a názov tabuľky, podľa ktorej bola požiadavka vykonaná.
Externý systém registruje aktuálnu reláciu ako otvorenú. Ak existujú iné relácie pre danú tabuľku, sú zatvorené s registráciou upozornenia v denníku.
Pozadová úloha SAP vytvára kurzor podľa zadaných parametrov a paket údajov určitej veľkosti. Veľkosť paketu – maximálny počet záznamov, ktoré proces číta z databázy. Predpokladá sa, že sa rovná 2000. Ak je vo výbere databázy viac záznamov než použitá veľkosť paketu, po odoslaní prvého paketu sa vytvára ďalší blok s príslušným offsetom a inkrementovaným číslom paketu. Čísla sa inkrementujú o 1 a posielajú sa striktne za sebou.
Ďalej SAP odosiela paket do vstupu web služby vonkajšieho systému. A tento systém vykonáva kontroly prichádzajúceho balíka. V systéme musí byť zaregistrovaná relácia s prijatým id a táto relácia musí byť v otvorenom stave. Ak je číslo balíka > 1, v systéme musí byť zaregistrované úspešné prijatie predchádzajúceho balíka (package_id-1).
V prípade úspešnej kontroly vonkajší systém parsuje a ukladá dáta tabuľky.
Dodatočne, ak je v balíku prítomná vlajka final a serializácia prebehla úspešne, systém integrácie je informovaný o úspešnom dokončení spracovania relácie a modul aktualizuje stav relácie.
V prípade chyby kontrol / parsovania bude chyba zaznamenaná a balíky pre túto reláciu budú vonkajším systémom odmietnuté.
Rovnako aj v opačnom prípade, keď vonkajší systém vracia chybu, táto je zaznamenaná a prenos balíkov sa ukončuje.
Na požiadanie údajov na strane SAP HCM bol implementovaný integračný servis. Servis bol realizovaný na frameworku ICF (SAP Internet Communication Framework — ). Umožňuje vykonávať požiadavky na údaje zo systému SAP HCM podľa určitých tabuliek. Pri zostavovaní požiadavky sú k dispozícii možnosti nastaviť zoznam konkrétnych polí a parametre filtrovania s cieľom získať potrebné údaje. Realizácia servisu pritom nepredpokladá žiadnu obchodnú logiku. Algoritmy výpočtu delty, parametrov požiadavky, kontroly integrity a pod. sú takisto implementované na strane vonkajšieho systému.
Tento mechanizmus umožňuje zhromažďovať a prenášať všetky potrebné údaje za niekoľko hodín. Takáto rýchlosť sa nachádza na hranici prijateľnosti, preto je toto riešenie považované za dočasné, ktoré umožnilo uspokojiť potrebu nástroja pre extrakciu v projekte.
V cieľovom obraze na riešenie úlohy extrakcie údajov sa skúmajú možnosti využitia systémov CDC typu Oracle Golden Gate alebo ETL nástrojov typu SAP DS.
Zdroj: habr.com
