

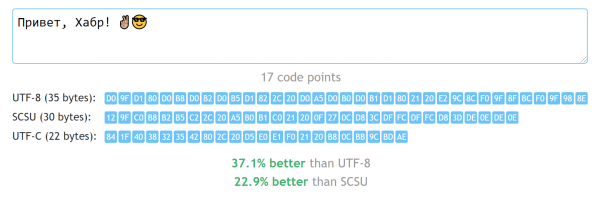
Ak ste vývojár a pred vami je úloha vybrať kódovanie, skoro vždy bude správnym riešením Unicode. Konkrétny spôsob reprezentácie závisí od kontextu, ale často tu je tiež univerzálna odpoveď — UTF-8. Je dobré, pretože umožňuje používať všetky znaky Unicode, bez plytvania príliš veľa bajtov vo väčšine prípadov. Pravda, pre jazyky používajúce nielen latinku, "nie príliš veľa" — to je aspoň dva bajty na znak. Je možné lepšie, bez návratu k pravekým kódovaniam, ktoré nás obmedzujú na len 256 dostupných znakov?
Nižšie navrhujem oboznámiť sa s mojím pokusom odpovedať na túto otázku a implementáciu relatívne jednoduchého algoritmu, ktorý umožňuje ukladať reťazce v drvivej väčšine jazykov sveta, bez pridávania tej nadbytočnosti, ktorá je v UTF-8.
Disklejmer. I hneď urobím niekoľko dôležitých vyjadrení: opísané riešenie sa neponúka ako univerzálna náhrada za UTF-8, je vhodné len v úzkom zozname prípadov (o ktorých budem neskôr) a určite ho nemožno používať na interakciu s externými API (ktoré o ňom ani nevedia). Najčastejšie pre kompaktne úložisko veľkých objemov textových údajov sa hodia algoritmy všeobecného kompresie (napríklad deflate). Navyše, už počas vytvárania svojho riešenia som našiel existujúci štandard v samotnom Unicode, ktorý rieši tú istú úlohu — je o niečo zložitejší (a často horší), ale predsa len je to prijatý štandard, nie niečo zostavené na kolene. O ňom tiež hovorím.
O Unicode a UTF-8
Na začiatok — pár slov o tom, čo vlastne je Unicode a UTF-8.
Ako vieme, predtým boli populárne 8-bitové kódovania. S nimi to bolo jednoduché: 256 znakov sa dá očíslovať číslami od 0 do 255, a čísla od 0 do 255 sú samozrejme reprezentovateľné v podobe jedného bajtu. Ak sa vrátime na úplný začiatok, kódovanie ASCII je obmedzené len na 7 bitov, preto najstarší bit v jeho bajtovom zastúpení je nulový, a väčšina 8-bitových kódovaní je s ním kompatibilná (lišia sa len v "hornej" časti, kde najstarší bit je jeden).
Čím sa kódovanie líši od Unicode a prečo sú s ním spojené rôzne reprezentácie – UTF-8, UTF-16 (BE a LE), UTF-32? Pozrime sa na to postupne.
Hlavný štandard Unicode popisuje iba zodpovednosti medzi znakmi (a v niektorých prípadoch – jednotlivými komponentami znakov) a ich číslami. Možných čísel v tomto štandarde je veľmi veľa – od 0x00 do 0x10FFFF (1 114 112 kusov). Keby sme chceli uložiť číslo v takom rozsahu do premennej, ani 1, ani 2 bajty by nám nestačili. A pretože naše procesory nie sú optimalizované na prácu s trojbajtovými číslami, museli by sme na jeden znak používať celé 4 bajty! To je UTF-32, ale práve kvôli tejto "plytvaní" tento formát nie je populárny.
Našťastie sú znaky v Unicode usporiadané nie náhodne. Ich veľké množstvo je rozdelené na 17 „rovín", z ktorých každá obsahuje 65536 (0x10000) «kódových bodov"). Pojem „kódový bod“ tu znamená jednoducho číslo znaku, ktoré mu priradil Unicode. Ako už bolo povedané, v Unicode sú číslované nielen jednotlivé znaky, ale aj ich komponenty a pomocné označenia (a niekedy ani nie sú priradené číslu – možno dočasne, ale pre nás to nie je až také dôležité), preto je presnejšie vždy hovoriť o počte čísel ako o ich znakoch. Napriek tomu v ďalšom texte budem častejšie používať slovo „znak“, pričom myslím na termín „kódový bod“.
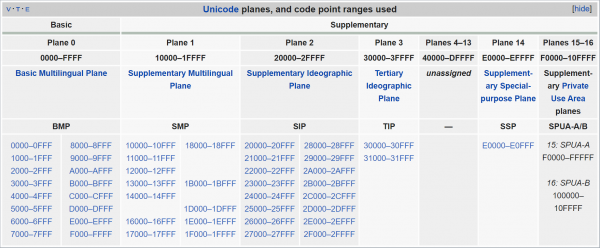
Roviny Unicode. Ako vidno, väčšina (roviny od 4 po 13) je stále nevyužitá.
Najzaujímavejšie je, že celá hlavná „dužina“ leží v nulovej rovine, ktorá sa nazýva "Basic Multilingual Plane". Ak reťazec obsahuje text v jednom z moderných jazykov (vrátane čínštiny), za hranice tejto roviny nevyjdete. Avšak ani zvyšok Unicode nemožno ignorovať – napríklad emoji sa väčšinou nachádzajú na konci nasledujúcej roviny, "Supplementary Multilingual Plane" (tá sa tiahne od 0x10000 do 0x1FFFF). Preto UTF-16 pristupuje takto: všetky znaky, ktoré spadajú do Basic Multilingual Plane, kódujú sa „ako sú“, zodpovedajúcim im dvojbajtovým číslom. Avšak časť čísel v tomto rozsahu vôbec neoznačuje konkrétne symboly, ale naznačuje, že za touto dvojicou bajtov je potrebné zvážiť ešte jednu – skombinovaním hodnôt týchto štyroch bajtov spolu dostaneme číslo, ktoré pokrýva celý povolený rozsah Unicode. Takéto zobrazenie sa nazýva „surrogátne páry“ – možno ste o nich počuli.
Takže, UTF-16 vyžaduje dva alebo (v veľmi zriedkavých prípadoch) štyri bajty na jeden „kódový bod“. Je to lepšie ako neustále používať štyri bajty, ale latinka (a iné ASCII symboly) pri takomto kódovaní spotrebúva polovicu obsadeného miesta na nuly. UTF-8 má za cieľ to opraviť: ASCII v ňom zaberá, ako predtým, iba jeden bajt; kódy od 0x80 do 0x7FF — dvoch bajtov; od 0x800 do 0xFFFF — troch, a od 0x10000 do 0x10FFFF — štyroch. Z jednej strany, latinke sa to vyplatilo: vrátila sa kompatibilita s ASCII a aj rozdelenie je viac rovnomerne „rozmazané“ od 1 do 4 bajtov. Ale abecedy, iné ako latinská, bohužiaľ, nijako nevyhrávajú v porovnaní s UTF-16, a mnohé teraz vyžadujú tri bajty namiesto dvoch – rozsah pokrytý dvojbajtovým zápisom sa zúžil 32-krát, s 0xFFFF do 0x7FF, a do neho nepatrí už ani čínština, ani napríklad gruzínčina. Cyrilike a ďalším piatim abecedám – hurá – sa šťastie usmialo, 2 bajty na symbol.
Prečo to takto vychádza? Poďme sa pozrieť, ako UTF-8 predstavuje kódy symbolov:
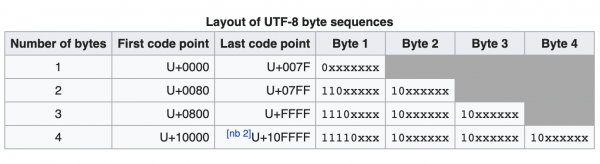
Priamo na zobrazenie čísel sa tu použili bity, označené symbolom x. Je vidno, že v dvojbajtovom zápise je takých bitov iba 11 (z 16). Vedené bity tu nesú len služobnú funkciu. V prípade štyrbajtového zápisu a úplne pod číslo kódového bodu je vyčlenených 21 bit z 32 – zdalo by sa, že tu by stačili aj tri bajty (ktoré dávajú spolu 24 bitov), ale služobné markery zjedia príliš veľa.
Je to zlé? V skutočnosti nie veľmi. Na jednej strane, ak veľmi dbáme na obsadzované miesto, máme algoritmy kompresie, ktoré ľahko odstránia všetku nadbytočnú entropiu a redundanciu. Na druhej strane, cieľom Unicode bolo poskytnúť maximálne univerzálne kódovanie. Napríklad reťazec zakódovaný v UTF-8 môžeme zveriť kódu, ktorý predtým pracoval iba s ASCII, a nebojíme sa, že tam uvidí znak z ASCII rozsahu, ktorý tam naozaj nie je (veď v UTF-8 všetky bajty začínajúce s nulovým bitom sú práve ASCII). A ak sa rozhodneme náhodou odstrániť malý koniec z veľkého reťazca, bez dekomprimovania na začiatku (alebo obnoviť časť informácií po poškodenom úseku) — nie je pre nás ťažké nájsť to posunutie, kde začína nejaký znak (stačí preskočiť bajty, ktoré majú bitový prefix. 10).
Prečo teda vymýšľať niečo nové?
Zároveň sa občas vyskytnú situácie, keď sú algoritmy kompresie ako deflate zle aplikovateľné a chceme dosiahnuť kompaktné ukladanie reťazcov. Osobne som sa s takouto úlohou stretol, keď som uvažoval o konštrukcii pre veľký slovník, ktorý zahŕňa slová v rôznych jazykoch. Na jednej strane — každé slovo je veľmi krátke, preto bude jeho kompresia neefektívna. Na druhej strane — implementácia stromu, ktorú som zvažoval, bola navrhnutá tak, aby každý bajt ukladaného reťazca vytváral samostatný vrchol stromu, takže minimalizácia ich množstva bola veľmi užitočná. V mojej knižnici (rovnako ako v , na ktorom je založená) sa podobný problém rieši jednoducho — reťazce, ktoré sú zabalené do -slovníka, sa tam ukladajú v Ale, ako nie je ťažké pochopiť, to dobre funguje len pre obmedzenú abecedu — reťazec v čínštine do takého slovníka už nenaskladáte.
Osobitne zdôrazním ešte jednu nepríjemnú nuansu, ktorá vzniká pri použití UTF-8 v takej dátovej štruktúre. Na obrázku vyššie je vidieť, že pri zápise znaku vo forme dvoch bajtov sa bity týkajúce sa jeho čísla nezhodujú, ale sú prerušené pár bit 10 uprostred: 110xxxxx 10xxxxxx. Kvôli tomu, keď v kóde znaku pretečú nižšie 6 bity druhého bajtu (t.j. dôjde k prechodu 10111111 → 10000000), mení sa aj prvý bajt. Ukazuje sa, že písmeno „p“ je označované bajtmi 0xD0 0xBF, a nasledujúca písmeno „r“ — už 0xD1 0x80. V prefixovom strome to vedie k rozdeleniu rodičovského uzla na dva — jeden pre prefix 0xD0, a druhý pre 0xD1 (hoci celá cyrilika by mohla byť kódovaná iba druhým bajtom).
Čo som získal
Keď som čelil tejto úlohe, rozhodol som sa precvičiť si hry s bitmi a zároveň sa lepšie oboznámiť so štruktúrou Unicode ako celku. Výsledkom bol formát kódovania UTF-C („C“ od compact), ktorý spotrebuje maximálne 3 bajty na jeden kódový bod, a veľmi často umožňuje minúť len jeden ďalší bajt na celý kódovaný riadok. To vedie k tomu, že na mnohých ne-ASCII abecedách sa takéto kódovanie ukazuje o 30-60 % kompaktnejšie ako UTF-8.
Zostavil som príklady implementácie algoritmov kódovania a dekódovania vo forme , môžete ich slobodne používať vo svojom kóde. Ale predsa len zdôrazním, že v určitom zmysle tento formát zostáva „bicyklom“, a neodporúčam ho používať bez vedomosti, na čo ho potrebujete. Je to predsa len viac experiment než vážne „vylepšenie UTF-8“. Napriek tomu, kód je napísaný úhľadne, stručne, s veľkým množstvom komentárov a pokrytím testami.
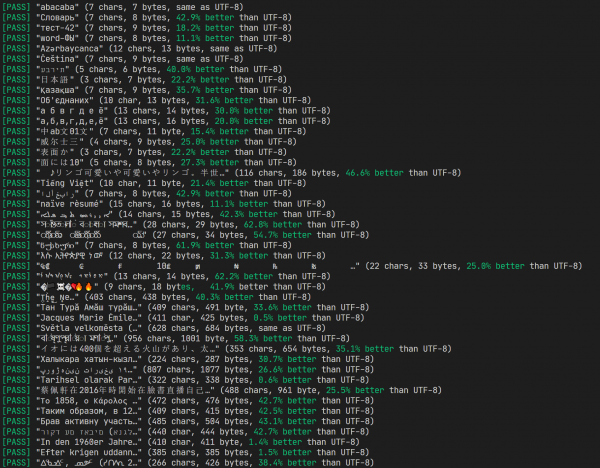
Výsledok vykonania testov a porovnanie s UTF-8
Ešte som vytvoril , kde si môžete posúdiť prácu algoritmu, a ďalej podrobnejšie vysvetlím jeho princípy a proces vývoja.
Odstraňujeme nadbytočné bity
Za základ som vzal, samozrejme, UTF-8. Prvá a najzjavnejšia vec, ktorú možno zmeniť — znížiť počet riadiacich bitov v každom bajte. Napríklad, prvý bajt v UTF-8 vždy začína buď s 0, alebo s 11 — a prefix 10 je iba u nasledujúcich bajtov. Nahradíme prefix 11 na 1, a u nasledujúcich bajtov úplne odstránime prefixy. Čo dostaneme?
0xxxxxxx — 1 bajt
10xxxxxx xxxxxxxx — 2 bajty
110xxxxx xxxxxxxx xxxxxxxx — 3 bajty
Stop, a kde je štvobajtová zápis? A tá už nie je potrebná — pri zápise tromi bajtmi máme teraz k dispozícii 21 bitov a to stačí na všetky čísla do 0x10FFFF.
Čo sme tu obetovali? Najdôležitejšie — zistenie hraníc symbolov z ľubovoľného miesta v buffere. Nemôžeme sa jednoducho uchechnúť na ľubovoľný bajt a od neho nájsť začiatok nasledujúceho symbolu. To je obmedzenie nášho formátu, ale v praxi sa potreba takéhoto zriedka vyskytuje. Zvyčajne sme schopní prechádzať bufferom od samého začiatku (najmä pokiaľ ide o krátke riadky).
Situácia s pokrytím jazykov 2 bajtmi sa tiež zlepšila: teraz dvojbajtový formát poskytuje rozsah 14 bitov, a to kódy až do 0x3FFF. Číňanom sa nedarí (ich hieroglyfy sú väčšinou v rozsahu od 0x4E00 do 0x9FFF), ale Grékom a mnohým iným národom sa uľahčilo — ich jazyky sa tiež zmestia do 2 bajtov na symbol.
Zadajte stav enkodéra
Teraz sa zamyslime nad vlastnosťami samotných riadkov. V slovníku sa najčastejšie nachádzajú slová napísané znakmi jedného písma, a pre mnohé iné texty to platí tiež. Bolo by dobré určité raz uviesť toto písmo a potom už len uvádzať číslo písmena v ňom. Pozrime sa, či nám umiestnenie znakov v tabuľke Unicode pomôže.
Ako bolo uvedené vyššie, Unicode je rozdelené na plochy po 65536 kódov každá. Ale toto delenie nie je veľmi užitočné (ako už bolo povedané, väčšinou sa nachádzame v nulovej ploche). Zaujímavejšie je delenie na bloky. Tieto rozsahy už nemajú pevné dĺžky a nesú väčší význam — zvyčajne každý spája znaky jedného písma.
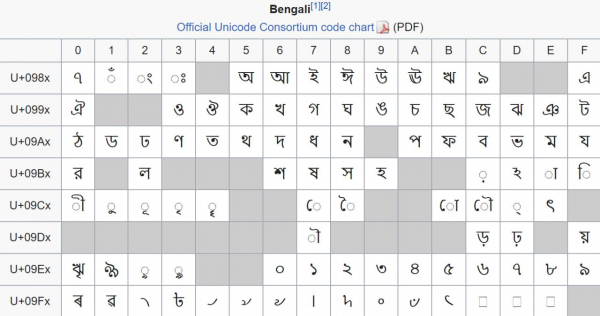
Blok, obsahujúci znaky bengálskeho písma. Žiaľ, z historických dôvodov, je to príklad nie veľmi hustého balenia — 96 znakov je chaoticky rozmiestnených po 128 kódových bodoch bloku.
Začiatky blokov a ich veľkosti sú vždy násobky 16 — je to urobene jednoducho pre pohodlie. Okrem toho mnohé bloky začínajú a končia na hodnotách, ktoré sú násobkom 128 alebo dokonca 256 — napríklad základná cyrilika zaberá 256 bajtov od 0x0400 do 0x04FF. To je celkom pohodlné: ak raz uložíme prefix 0x04, potom môže byť akýkoľvek cyrilský znak zapísaný jedným bajtom. Pravda, takto stratíme možnosť vrátiť sa k ASCII (a k akýmkoľvek iným znakom vôbec). Preto to robíme takto:
- Dva bajty
10yyyyyy yxxxxxxxnie len označujú znak s číslomyyyyyy yxxxxxxx, ale aj menia aktuálne písmo nayyyyyy y0000000t.j. zapamätáme si všetky bity okrem najnižších 7 bit); - Jeden bajt
0xxxxxxxje symbol aktuálneho písma. Je potrebné ho jednoducho sčítať s posunom, ktorý sme si zapamätali v kroku 1. Kým sme písmo nemenili, posun je rovný nule, a preto sme si zachovali kompatibilitu s ASCII.
Podobne pre kódy, ktoré vyžadujú 3 bajty:
- Tri bajty
110yyyyy yxxxxxxx xxxxxxxxoznačujú znak s číslomyyyyyy yxxxxxxx xxxxxxxx, menia aktuálne písmo nayyyyyy y0000000 00000000(zapamätali sme si všetko, okrem najnižších 15 bit), a nastavujú príznak, že teraz sme v dlhých v režime (pri zmene písma späť na dvojbytový tento príznak resetujeme); - Dva bajty
0xxxxxxx xxxxxxxxv dlhom režime je to symbol aktuálneho písma. Podobne, skladať ho budeme so posunom z kroku 1. Celý rozdiel je len v tom, že teraz čítame po dva bajty (pretože sme prešli do takého režimu).
Znie to dobre: teraz, kým musíme kódovať znaky z toho istého 7-bitového rozsahu Unicode, míňame 1 zbytočný bajt na začiatku a iba po bajte na každý znak.
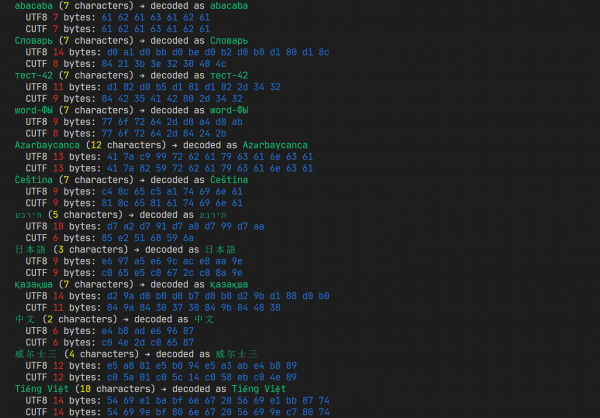
Práca jednej z raných verzií. Už často obchádza UTF-8, ale stále je čo zlepšovať.
Čo sa zhoršilo? Po prvé, máme zavedený stav, a to konkrétne posun aktuálneho písma a príznak dlhého režimu. To nás navyše obmedzuje: teraz môžu byť rovnaké znaky kódované rôznymi spôsobmi v rôznych kontextoch. Hľadanie podreťazcov, napríklad, bude potrebné vykonávať už s ohľadom na toto, a nie len porovnávaním bajtov. Po druhé, akonáhle sme zmenili písmo, zle je to s kódovaním ASCII znakov (a to nie je len latinka, ale aj základná interpunkcia vrátane medzier) — vyžadujú opätovnú zmenu písma na 0, teda zase zbytočný bajt (a potom ešte ďalší, aby sme sa vrátili k nášmu hlavnému).
Jedno písmo je dobré, dve sú lepšie
Skúsime trochu zmeniť naše bitové prefixy, vtesnene k trom vyššie popísaným ešte jeden:
0xxxxxxx — 1 bajt v bežnom režime, 2 v dlhom
11xxxxxx — 1 bajt
100xxxxx xxxxxxxx — 2 bajty
101xxxxx xxxxxxxx xxxxxxxx — 3 bajty
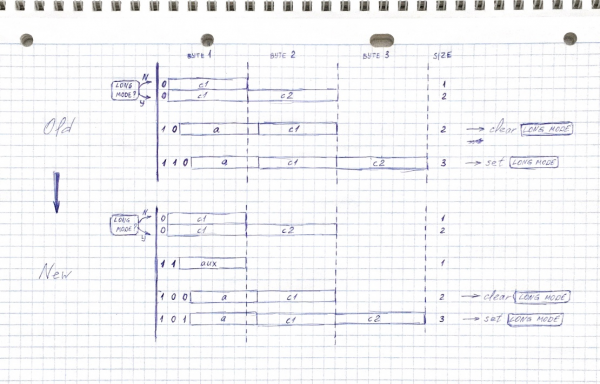
Teraz v dvojbajtovom zápise je na jeden dostupný bit menej — zmestia sa kódové body až do 0x1FFF, a ne 0x3FFF. Napriek tomu, stále je to pociteľne viac, než v dvojbajtových kódoch UTF-8, väčšina rozšírených jazykov sa stále zmestí, najvýraznejšia strata — vypadla a , Japonci sú smutní.
Aký je to nový kód 11xxxxxx? Это небольшой «загашник» размером в 64 символа, он дополняет наш основной алфавит, поэтому я назвал его вспомогательным (auxiliary) písmom. Keď prepíname aktuálne písmo, kus starého písma sa stáva pomocným. Napríklad, prešli sme z ASCII na cyriliku — v „zásobe“ je teraz 64 znakov, obsahujúcich latinku, číslice, medzery a čiarku (najčastejšie vkladanie v ne-ASCII textoch). Vrátili sme sa späť na ASCII — a pomocným písmom sa stane hlavná časť cyriliky.
Vďaka prístupu k dvom abecedám môžeme spracovať veľké množstvo textov s minimálnymi nákladmi na prepínanie abeced (interpunkcia sa väčšinou vráti späť do ASCII, ale následne mnohé ne-ASCII symboly budeme získavať už z doplnkovej abecedy bez opätovného prepínania).
Bonus: označením doplnkovej abecedy predponou 11xxxxxx a nastavením jej počiatočného posunu na 0xC0, máme čiastočnú kompatibilitu s CP1252. Inými slovami, mnohé (ale nie všetky) západoeurópske texty kódované v CP1252 budú vyzerať rovnako aj v UTF-C.
Tu však nastáva problém: ako z hlavnej abecedy získať pomocnú? Môžeme ponechať rovnaké posunutie, ale — žiaľ — tu už štruktúra Unicode hrá proti nám. Veľmi často hlavná časť abecedy nie je na začiatku bloku (napríklad, ruské veľké „А“ má kód 0x0410, hoci cyrilský blok začína s 0x0400). Týmto spôsobom, ak zoberieme do „rezervy“ prvých 64 symbolov, môžeme stratiť prístup k chvostovej časti abecedy.
Na odstránenie tohto problému som ručne prešiel niektoré bloky, ktoré zodpovedajú rôznym jazykov, a uviedol pre nich posunutie pomocnej abecedy vo vnútri hlavnej. Latinku som, na výnimku, úplne preusporiadal podobne ako base64.
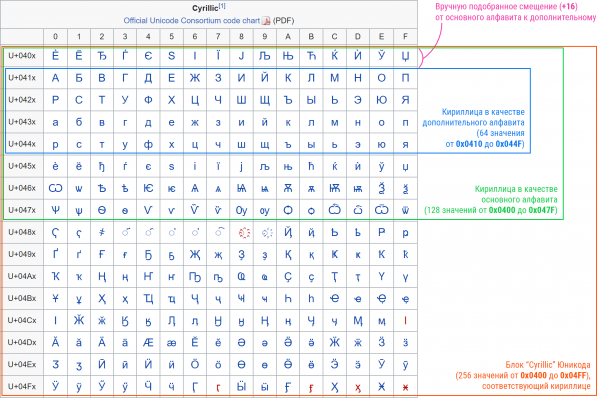
Finálne úpravy
Poďme sa nakoniec zamyslieť, kde ešte môžeme niečo doladiť.
Všimnime si, že formát 101xxxxx xxxxxxxx xxxxxxxx umožňuje kódovať čísla až do 0x1FFFFF, zatiaľ čo Unicode končí skôr, na 0x10FFFF. Inými slovami, posledný kódový bod bude reprezentovaný ako 10110000 11111111 11111111. Takže môžeme povedať, že ak má prvý byte tvar 1011xxxx (kde xxxx je viac ako 0), znamená to niečo iné. Napríklad, môžeme tam pridať ďalších 15 symbolov, ktoré sú neustále k dispozícii na kódovanie jedným bytom, ale rozhodol som sa ísť inou cestou.
Pozrieme sa na tie bloky Unicode, ktoré teraz vyžadujú tri byty. V zásade, ako už bolo povedané, sú to čínske znaky — ale s nimi je ťažké niečo urobiť, je ich 21 tisíc. Ale uletela tam aj hiragana s katakanou — a tých už nie je veľa, menej ako dvesto. A keďže sme si spomenuli na Japoncov — tam ležia aj emoji (v skutočnosti sú roztrhnuté po celom Unicode, ale hlavné bloky sú v rozmedzí 0x1F300 – 0x1FBFF). Ak si pomyslíme, že teraz existujú emoji, ktoré sú zložené z viacerých kódových bodov (napríklad emoji sa skladá až zo 7 kódov!), je naozaj škoda míňať na každý po tri bajty (7×3 = 21 bajtov za jeden symbol, to je hrôza).
Preto vyberáme niekoľko vybraných rozsahov, ktoré zodpovedajú emoji, hiragane a katakane, prečíslujeme ich do jedného kontinuálneho zoznamu a kódujeme vo forme dvoch bajtov namiesto troch:
1011xxxx xxxxxxxx
Skvelé: vyššie uvedené emoji , ktoré pozostáva zo 7 kódových bodov, v UTF-8 zaberá 25 bajtov, a my sme ho zmestili do 14 (presne po dva bajty na každý kódový bod). Mimochodom, Habr sa rozhodol ho nezobraziť (ani v starom, ani v novom editore), takže som ho musel vložiť ako obrázok.
Skúsime opraviť ešte jeden problém. Ako si pamätáme, hlavná abeceda je v podstate horných 6 bitov, ktoré držíme v pamäti, a prilepujeme kód každého ďalšieho dekódovaného symbolu. V prípade čínskych hieroglyfov, ktoré sú v bloku 0x4E00 – 0x9FFF, je to buď bit 0, alebo 1. To nie je veľmi pohodlné: budeme musieť neustále prepínať abecedu medzi týmito dvoma hodnotami (t.j. míňať po tri bajty). Ale všimnime si, že v dlhom režime môžeme z kódu odpočítať počet symbolov, ktoré kódujeme pomocou krátkeho režimu (po všetkých vyššie uvedených fintách to je 10240) — potom sa rozsah hieroglyfov posunie k 0x2600 – 0x77FF, a v tomto prípade budú na celom tomto rozsahu horné 6 bity (z 21) rovné 0. Takže sekvencie hieroglyfov budú používať po dva bajty na hieroglyf (čo je optimálne pre tak veľký rozsah), bez potreby prepnúť abecedu.
Alternatívne riešenia: SCSU, BOCU-1
Znalci Unicode, len čo si prečítajú názov článku, pravdepodobne ponáhľajú pripomenúť, že priamo medzi štandardmi Unicode existuje (SCSU), ktorý popisuje spôsob kódovania veľmi podobný tomu, ktorý je popísaný v článku.
Priznám sa úprimne: o jeho existencii som sa dozvedel až po tom, čo som sa hlboko ponoril do písania svojho riešenia. Keby som o ňom vedel od začiatku, pravdepodobne by som sa pokúsil napísať jeho implementáciu namiesto vymýšľania vlastného prístupu.
Zaujímavé je, že SCSU využíva nápady, ktoré sú veľmi podobné tým, ku ktorým som dospel sám (namiesto pojmu „alfabéty“ sa tam používajú „okná“, a je ich viac ako u mňa). Zároveň má tento formát aj nevýhody: je o niečo bližšie k algoritmom kompresie ako kódovania. Konkrétne, štandard ponúka množstvo spôsobov reprezentácie, ale nehovorí, ako vybrať z nich optimálny – na to musí enkóder aplikovať nejaké heuristiky. Takže SCSU-enkóder, ktorý poskytuje dobré balenie, bude zložitejší a objemnejší ako môj algoritmus.
Na porovnanie som preniesol relatívne jednoduchú implementáciu SCSU do JavaScriptu – objemom kódu sa ukázala porovnateľná s mojím UTF-C, ale v niekoľkých prípadoch dosiahla výsledky o desiatky percent horšie (niekedy môže aj prevyšovať, ale nie mnohými). Napríklad texty v hebrejčine a gréčtine kódoval UTF-C o 60 % lepšie ako SCSU. (pravdepodobne kvôli ich kompaktným abecedám).
Samostatne dodám, že okrem SCSU existuje aj iný spôsob kompaktného zobrazenia Unicode – , ale jeho cieľom je kompatibilita s MIME (čo som nepotreboval), a používa trochu iný prístup k kódovaniu. Jeho účinnosť som nehodnotil, ale zdá sa mi, že nebude vyššia ako SCSU.
Možné vylepšenia
Môj algoritmus nie je univerzálny by design (v tomto, asi, sú moje ciele najviac odlišné od cieľov konsorcia Unicode). Už som spomenul, že bol vyvíjaný prevažne na jednu úlohu (ukladanie viacjazyčného slovníka v prefixovom strome) a niektoré jeho charakteristiky sa nemusia dobre hodiť pre iné úlohy. Ale fakt, že nie je štandardom, môže byť aj pozitívom – môžete ho ľahko prispôsobiť svojim potrebám..
Napríklad, je zrejmé, že je možné zbaviť sa existencie stavu, urobiť kódovanie stateless – jednoducho neaktualizovať premenné vypínače, auxOffs a is21Bit v enkóderi a dekóderi. V takom prípade nebude možné efektívne baliť sekvencie znakov jednej abecedy, zato bude zaručené, že ten istý znak sa vždy kóduje rovnakými bajtmi, bez ohľadu na kontext.
Okrem toho je možné prispôsobiť kodér na konkrétny jazyk, zmenou predvoleného stavu – napríklad, orientovaním na ruské texty nastaviť na začiatku enkóderu a dekóderu. offs = 0x0400 a auxOffs = 0. Najmä to dáva zmysel v prípade stateless režimu. Celkovo to bude vyzerať ako používanie starej osembitovej kódovania, len to neodníma možnosť vkladať znaky z celého Unicode podľa potreby.
Ďalšia nevýhoda, o ktorej som už spomínal — v obsiahlym texte kódovanom v UTF-C nie je rýchly spôsob, ako nájsť hranicu znaku, ktorý je najbližší k ľubovoľnému bytu. Odrezaním posledných, povedzme, 100 bytov z kódovaného bufferu riskujete, že dostanete odpad, s ktorým niet čo robiť. Na uchovávanie viacgigabajtových logov kódovanie nie je určené, ale celkovo to môžeme opraviť. Byt 0xBF nikdy by sa nemal objaviť ako prvý byt (ale môže byť druhý alebo tretí). Preto pri kódovaní môžete vložiť sekvenciu 0xBF 0xBF 0xBF každých, povedzme, 10 Kb — potom pri potrebe nájsť hranicu stačí prehľadať vybraný kus, kým nenájdete podobný marker. Po poslednom 0xBF zaručene bude začiatok znaku. (Pri dekódovaní túto sekvenciu z troch bytov, samozrejme, treba ignorovať.)
Na záver
Ak ste dočítali až sem - blahoželám! Dúfam, že ste, rovnako ako ja, zistili niečo nové (alebo si osviežili pamäť) o štruktúre Unicode.
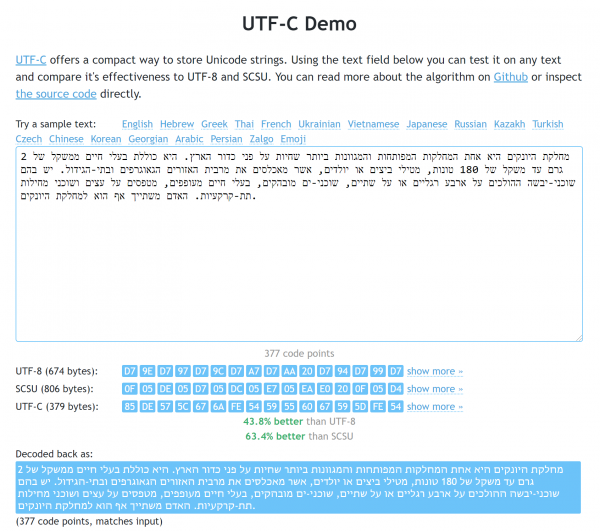
Demonštračná stránka. Na príklade hebrejčiny sú viditeľné výhody ako oproti UTF-8, tak aj oproti SCSU.
Nehodlajte považovať vyššie uvedené úvahy za útok na normy. Avšak celkovo som spokojný s výsledkami svojich prác, preto som rád, že sa o ne : napríklad, JS knižnica v minifikovanej podobe váži len 1710 bytov (a samozrejme nemá žiadne závislosti). Ako som už spomínal, s jej fungovaním sa môžete oboznámiť na (tam je aj sada textov, na ktorých ju môžete porovnať s UTF-8 a SCSU).
Na záver opäť upozorním na prípady, kedy by ste mali používať UTF-C nie:
- Ak sú vaše reťazce dostatočne dlhé (od 100-200 znakov). V takom prípade by ste mali premýšľať o aplikácii kompresných algoritmov ako deflate.
- Ak potrebujete ASCII transparentnosť, teda pre vás je dôležité, aby sa v kódovaných sekvenciách nevyskytovali ASCII kódy, ktoré neboli v pôvodnom reťazci. Týmto potrebám sa môže vyhnúť, ak pri interakcii s externými API (napríklad pri práci s databázou) odovzdáte výsledok kódovania ako abstraktnú množinu bajtov, nie ako reťazce. Inak riskujete, že získate neočakávané zraniteľnosti.
- Ak chcete mať možnosť rýchlo nájsť hranice znakov pri ľubovoľnom posune (napríklad pri poškodení časti reťazca). Môžete to urobiť, ale iba prehliadnutím reťazca od začiatku (alebo aplikovaním úpravy popísanej v predchádzajúcej časti).
- Ak potrebujete rýchlo vykonávať operácie na obsahu reťazcov (triediť ich, hľadať v nich podreťazce, konkatenovať). Preto je potrebné najprv reťazce dekódovať, a teda UTF-C bude pomalší ako UTF-8 v týchto prípadoch (ale rýchlejší ako algoritmy kompresie). Keďže ten istý reťazec je vždy kódovaný rovnako, presné porovnávanie dekódovania to nevyžaduje, môže sa vykonávať po bajtoch.
Aktualizácia: používateľ súhrnne som zverejnil graf, ktorý ukazuje hranicu použiteľnosti UTF-C. Na ňom je vidieť, že UTF-C je efektívnejší ako algoritmus všeobecného účelu (variácie LZW), pokiaľ je balený reťazec kratší. ~140 znakov (pravda, poznamenám, že porovnanie bolo vedené na jednom texte; pre iné jazyky sa výsledok môže líšiť).
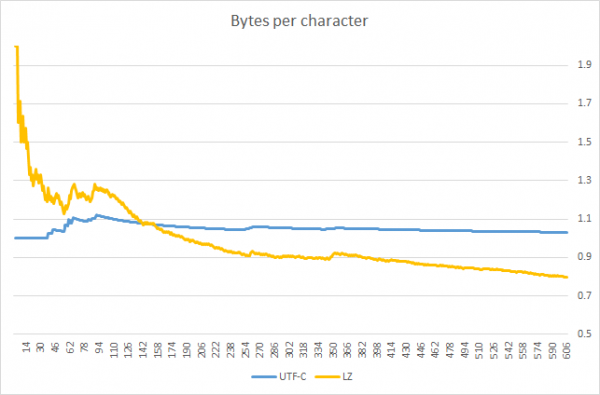
Zdroj: habr.com
