

Leto tradične znižuje nielen nákupnú aktivitu, ale aj intenzitu zmien v infraštruktúre webových projektov, hovorí nám Kapitán Zrejmosť. Je to jednoducho preto, že aj IT odborníci majú niekedy dovolenku. A tiež CTO. Tí, ktorí zostávajú na svojich postoch, to majú ťažšie, ale teraz nejde o to: možno práve preto je leto najlepší čas na to, aby ste si bez zbytočného zhonu premysleli existujúcu schému zálohovania a vytvorili plán na jej vylepšenie. A v tom vám bude užitočný skúsenosť Egora Andreeva z , o ktorej hovoril na konferencii .
Pri budovaní záložných lokalít a pri zálohovaní existuje niekoľko pascí, do ktorých môžeme spadnúť. A spadnúť do nich je úplne neprijateľné. A všetko to, ako aj v mnohých iných oblastiach, ničí náš perfekcionizmus a… lenivosť. Snažíme sa všetko spraviť dokonale, a to nie je potrebné! Je potrebné robiť len určité veci, ale urobiť ich správne a dotiahnuť do konca, aby fungovali normálne.
Failover – to nie je žiadna veselo zábavná vec „len tak pre istotu“; je to niečo, čo má splniť presne jednu funkciu – znížiť čas výpadku, aby služba, spoločnosť, stratila menej peňazí. A vo všetkých metódach zálohovania navrhujem premýšľať v nasledujúcom kontexte: kde sú peniaze?
Prvá pasca: keď budujeme veľké spoľahlivé systémy a zaoberáme sa zálohovaním – znižujeme počet havárií. To je strašné omyl. Keď sa zaoberáme zálohovaním, počet havárií pravdepodobne zvyšujeme. A ak všetko urobíme správne, celkovo znížime čas výpadku. Havárií bude viac, ale budú sa diať s menšími nákladmi. Čo je to zálohovanie? – to je zloženie systému. Akékoľvek zloženie je zlé: objavujú sa nám viac skrutiek, viac ozubených kolies, jednoducho viac prvkov – a teda vyššia šanca na poruchu. A tie sa naozaj rozpadnú. A budú sa rozpadávať častejšie. Jednoduchý príklad: povedzme, že máme nejaký web, s PHP, MySQL. A jeho je naliehavo potrebné zálohovať.
Takže (c) Berieme druhú platformu, budujeme identický systém… Zložitosti je dvakrát viac — máme dve entity. A navyše pridávame určitú logiku prenášania údajov z jednej platformy na druhú — teda replikácia údajov, kopírovanie statického obsahu a tak ďalej. Takže logika replikácie — tá je zvyčajne veľmi zložitá, a teda celková zložitosti systému môže byť nie 2, ale 3, 5, 10-krát väčšia.
Druhá pasca: keď budujeme naozaj veľké zložité systémy, fantazírujeme, čo vlastne chceme dosiahnuť. Voilà: chceme získať superspoľahlivý systém, ktorý funguje úplne bez prestojov, prepína sa za pol sekundy (alebo ešte lepšie okamžite), a začíname pretvárať naše sny na realitu. Ale tu je aj nuansa: čím kratší je želaný čas prepínania, tým zložitejšia sa stáva logika systému. Čím zložitejšie musíme túto logiku navrhnúť, tým častejšie sa systém porušuje. A môžeme sa ocitnúť v veľmi nepríjemnej situácii: snažíme sa za každú cenu znížiť čas prestoja, ale v skutočnosti to všetko len komplikujeme, a keď niečo nejde podľa plánu, čas prestoja nakoniec bude väčší. Tu sa často chytáme na myšlienke: radšej by sme nerobili záložný systém. Radšej by to malo fungovať jedno ako tak a s jasným časom prestoja.
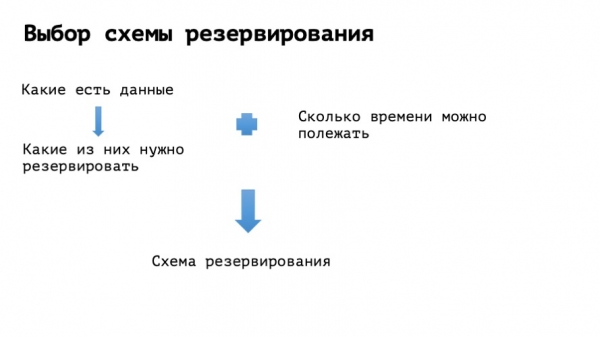
Ako sa s tým dá vyrovnať? Musíme prestať si klamať, prestať sa sebou lichotiť, že teraz budeme stavať vesmírnu loď, ale adekvátne si uvedomiť, koľko času môže projekt potrebovať. A na základe tohto maximálneho času vyberieme, akými vlastne metódami zvýšime spoľahlivosť nášho systému.
Je čas na „príbehy zo života“… samozrejme.
Príklad číslo jeden
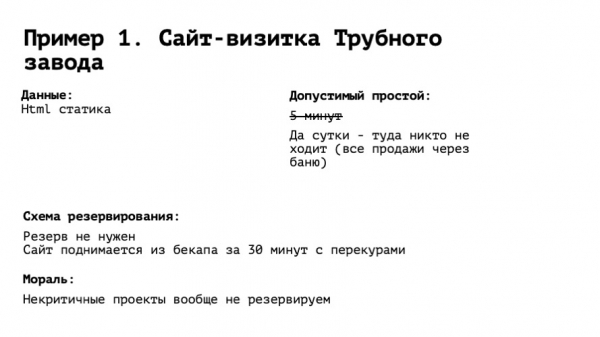
Predstavte si webovú stránku vizitku pre výrobňu rúrok č. 1 v meste N. Na nej je napísané obrovskými písmenami – VÝROBA RÚROK Č. 1. Trochu nižšie je slogan: „Naše rúry sú najkrajšie rúry v N“. A dole telefónne číslo generálneho riaditeľa a jeho meno. Rozumieme, že je potrebné rezervovať – je to veľmi dôležité! Začíname zisťovať, z čoho sa skladá. Html statika – teda pár obrázkov, kde generálny riaditeľ vlastne sedí za stolom v saune so svojím partnerom a diskutujú nejakú ďalšiu dohodu. Začíname premýšľať o dobe nečinnosti. Napadne nám: ležať tam treba päť minút, maximálne. A tu je otázka: koľko predajov bolo z našej stránky vôbec? Koľko-koľko? Čo znamená „nula“? A znamená to, že všetky štyri dohody za minulý rok generálny riaditeľ urobil za tým istým stolom, s tými istými ľuďmi, s ktorými chodia do sauny a sedia za stolom. A chápeme, že aj keby deň ležal web – nič strašného sa nestane.
Na základe vstupných informácií máme deň na to, aby sme túto históriu pozdvihli. Začínáme rozmýšľať nad schémou rezervácie. A vyberáme najideálnejšiu schému pre rezerváciu pre tento prípad: rezerváciu nepoužívame. Celá táto vec sa zdvihne akýmkoľvek administrátorom za pol hodiny s prestávkami. Nainštalovať webový server, preniesť súbory – hotovo. Bude to fungovať. Nieto sledovať, ničomu sa netreba osobitne venovať. To znamená, že výsledok z príkladu číslo jedna je celkom očividný: služby, ktoré nie je potrebné rezervovať – rezervovať nie je potrebné.
Príklad číslo dva
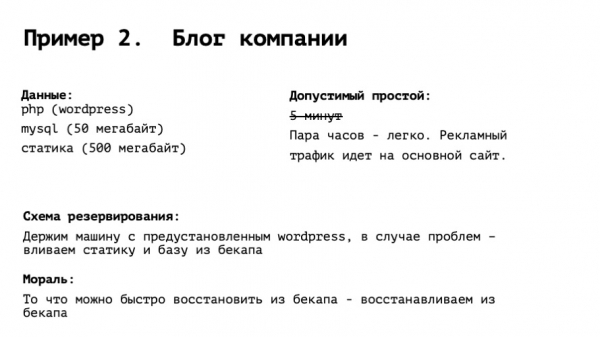
Blog spoločnosti: špeciálne vyškolení napíšu správy, že sme sa zúčastnili takej a takej výstavy, alebo že sme vydali nový produkt a tak ďalej. Povedzme, že ide o štandardný PHP s WordPressom, malú databázu a trochu statického obsahu. Samozrejme, že mi opäť napadne, že ležať v žiadnom prípade nemôžeme — „nie viac ako päť minút!“, a tak ďalej. Ale zamyslime sa ďalej. Čo tento blog robí? Získava návštevnosť z Yandexu a Googlu na základe určitých dopytov, organicky. Super. A sú predaje s tým nejako prepojené? Osvietenie: nie veľmi. Reklamný traffic ide na hlavnú stránku, ktorá je na inom serveri. Začneme premýšľať o schéme zálohovania blogu. Správne by sa mal v priebehu pár hodín postaviť a bolo by dobré sa na to pripraviť. Rozumné by bolo vziať stroj v inom dátovom centre, nainštalovať naň prostredie, teda webový server, PHP, WordPress, MySQL a nechať to ležať neaktívne. V momente, keď pochopíme, že všetko sa pokazilo, potrebujeme urobiť dve veci — obnoviť dump MySQL na 50 MB, ktorý prebehne za minútu, a obnoviť nejaké množstvo obrázkov z backupu. To tiež nie je taká veľká námaha. Takto sa za polhodinu celá vec postaví. Žiadne replikácie, alebo, chráň Boh, automatický failover. Záver: to, čo môžeme rýchlo obnoviť z backupu — netreba rezervovať.
Príklad číslo tri, zložitejší
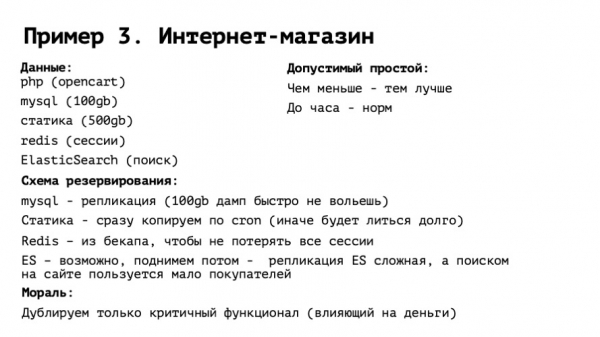
Internetový obchod. PHP s mierne upraveným open heart, MySQL so solídnou databázou. Pomerne veľa statického obsahu (veď v internetovom obchode sú krásne HD obrázky a všetko okolo toho), Redis na relácie a Elasticsearch na vyhľadávanie. Začneme premýšľať o čase nečinnosti. A tu je samozrejme jasné, že deň bezbolestne internetový obchod nemôže ležať. Veď čím dlhšie je offline, tým viac peňazí strácame. Je potrebné urýchliť proces. A ako veľmi? Myslím si, že ak budeme ležať hodinu, nikto z toho nezblbne. Áno, niečo stratíme, ale ak začneme usilovne pracovať — bude to len horšie. Určujeme schému nečinnosti, ktorá je akceptovateľná za hodinu.
Ako sa dá toto všetko rezervovať? Stroj je potrebný v každom prípade: hodina času — to naozaj nie je veľa. Mysql: tu už potrebujeme replikáciu, živú replikáciu, pretože za hodinu 100 GB do dumpu pravdepodobne nevojde. Statika, obrázky: opäť, za hodinu 500 GB sa môže nestihnúť nahrnúť. Tak teda, je lepšie obrázky ihneď kopírovať. Redis: tu to je zaujímavejšie. V Redis sú uložené relácie — jednoducho ho nemôžeme vziať a zničiť. Pretože to nebude veľmi dobré: všetci používatelia by sa odhlásili, nákupné košíky by boli vyprázdnené a tak ďalej. Ľudia by boli nútení znovu zadať svoje prihlasovacie meno a heslo, a veľa z nich by sa mohlo odpojiť a nákup nedokončiť. Opäť, konverzia klesne. Na druhej strane, Redis je priamo aktuálny, s poslednými prihlásenými používateľmi, asi tiež nie je potrebný. A dobrý kompromis — zobrať Redis a obnoviť ho z backupu, včerajšieho, alebo, ak sa robí každý hodinu, - hodinového. Našťastie obnova z backupu je kopírovanie jedného súboru. A najzaujímavejšia situácia — to je Elasticsearch. Kto už niekedy zdvíhal replikáciu MySQL? Kto niekedy zdvíhal replikáciu Elasticsearch? A u koho to potom normálne fungovalo? Na čo chcem poukázať: vidíme v našom systéme určitú entitu. Zdá sa, že je užitočná — ale je zložitá.
Zložitá v tom smysle, že naši kolegové inženýři nemají s tímto zkušenosti. Buď mají negativní zkušenost, nebo si uvědomujeme, že technologie je stále poměrně nová s nuancemi či nedokonalostmi. Přemýšlíme... Sakra, elastic je taky velký, jeho obnova z zálohy trvá dlouho, co dělat? Uvědomujeme si, že elastic v našem případě slouží pro hledání. A jak prodává náš internetový obchod? Jdeme za marketingovými specialisty, ptáme se, odkud lidé přicházejí. Odpovídají: „90 % přichází přímo z Yandex-Marketu na stránku produktu.“ A buď nakoupí, nebo ne. Hledání tedy potřebuje 10 % uživatelů. A udržovat replikaci elasticu, obzvlášť mezi různými datovými centry v různých zónách, to má opravdu spoustu nuancí. Jaké je řešení? Bereme elastic na rezervované platformě a nic s ním neděláme. Pokud se záležitost zpozdí, tak ho někdy potom možná zvedneme, ale to není jisté. Vlastně, závěr je plus mínus stejný: služby, které nemají vliv na finance, opět nezálohujeme. Aby schéma zůstalo jednodušší.
Příklad číslo čtyři, ještě složitější.
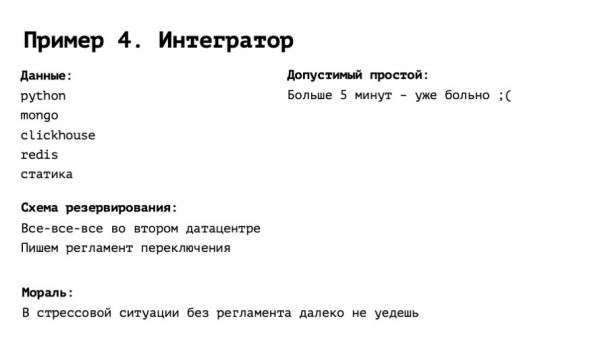
Integrátor: prodej květin, objednávání taxi, prodej zboží, vlastně cokoliv. Seriózní záležitost, která funguje 24/7 pro velké množství uživatelů. S plnohodnotným zajímavým stackem, kde jsou zajímavé databáze, řešení, vysoké zatížení a především, pokud leží déle než 5 minut, je to bolestivé. Nejen a ne tolik proto, že lidé nekoupí, ale proto, že lidé uvidí, že to nefunguje, zklamou se a mohou se už vůbec nevrátit.
OK. Pět minut. Co s tím uděláme? V tomto případě my, dospěláckým způsobem, investujeme všechny peníze do skutečné záložní platformy, s replikací všeho a možná dokonce automatizujeme co nejvíce přepnutí na tuto platformu. A vedle toho nesmíme zapomenout udělat jednu důležitou věc: napsat vlastní postup pro přepínání. Postup, i když máte všechno a všechno automatizováno, může být velmi jednoduchý. Něco jako „spustit takový scénář ansible“, „v route 53 zaškrtnout tuto volbu“ a tak dále — ale to musí být nějaký přesný seznam úkonů.
A zdá sa, že všetko je jasné. Prepnúť replikáciu je triviálna úloha, alebo sa prepne sama. Prepísať doménové meno v dns je z tej istej kategórie. Problém je v tom, že keď taký projekt spadne, nastáva panika, a aj tí najsilnejší, ostrieľaní administrátori môžu byť ňou ovplyvnení. Bez jasného pokynu „otvor terminál, choď sem, adresa našich serverov je stále takáto“ je 5-minútový čas na záchranu veľmi ťažko dodržateľný. A navyše, keď používame tento predpis, je ľahké zaznamenať niektoré zmeny v infraštruktúre a prípadne zmeniť predpis.
No, ak je systém zálohovania naozaj zložitý a v určitom momente urobíme chybu, môžeme zničiť aj našu záložnú lokalitu, a navyše, dáta môžeme premeniť na tekvicu na oboch lokalitách — to bude naozaj smutné.
Príklad číslo päť, úplný hardcore
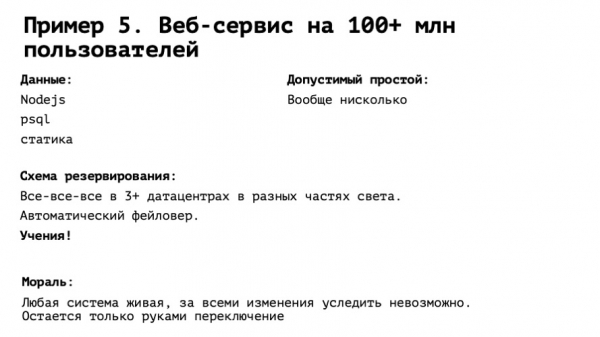
Medzinárodná služba s hundred million users around the world. Všetky časové pásma, ktoré existujú, highload na maximum, neexistuje žiadna možnosť pádu. Minúta — a bude smutno. Čo robiť? Zálohovať, zase naplno. Urobili sme všetko, čo som povedal v predchádzajúcom príklade, a ešte o čosi viac. Ideálny svet a naša infraštruktúra — je vo všetkých ohľadoch devops IaaC. Teda všetko je vôbec v gite, stačí len stlačiť tlačidlo.
Čo chýba? Jedno — cvičenia. Bez nich to nejde. Zdá sa, že všetko je dokonalé, všetko máme pod kontrolou. Stlačíme tlačidlo, všetko sa deje. Aj keď to tak je — a chápeme, že to tak nie je — náš systém interaguje s inými systémami. Napríklad, to je dns od route 53, s3 úložiská, integrácia s nejakými api. Všetko predpokladať v tomto hypotetickom experimente nebudeme schopní. A pokým naozaj neodpíname vypínač — nezistíme, či to funguje alebo nie.
Na tomto asi všetko. Nezabudnite a nepreháňajte to. A nech s vami zostane uptime!
Zdroj: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish