

V súčasnosti si ťažko dokážeme predstaviť projekt založený na Kubernetes bez ELK stacku, pomocou ktorého sú uchovávané logy aplikácií aj systémových komponentov klastra. V našej praxi používame stack EFK s Fluentd namiesto Logstash.
Fluentd je moderný univerzálny zberateľ logov, ktorý získava čoraz väčšiu popularitu a pridal sa k Cloud Native Computing Foundation, čo nasmerovalo jeho vývoj na spoluprácu s Kubernetes.
Skutočnosť, že používame Fluentd namiesto Logstash, nemení celkovú podstatu softvérového balíka, avšak Fluentd má svoje špecifické nuance vyplývajúce z jeho multifunkčnosti.
Napríklad, keď sme začali používať EFK v zaťaženom projekte s vysokou intenzitou zapisovania logov, stretli sme sa s problémom, že v Kibana sa niektoré správy zobrazujú opakovane viackrát. V tomto článku vám vysvetlíme príčinu tohto javu a ako problém vyriešiť.
Problém duplicity dokumentov
V našich projektoch je Fluentd nasadený ako DaemonSet (automaticky sa spúšťa v jednom exemplári na každom uzle klastra Kubernetes) a sleduje stdout logy kontajnerov v /var/log/containers. Po zhromaždení a spracovaní logy vo forme JSON dokumentov prichádzajú do ElasticSearch, ktorý je nasadený buď v klastrovom, alebo samostatnom režime, v závislosti od veľkosti projektu a požiadaviek na výkon a dostupnosť. Ako grafické rozhranie používame Kibana.
Pri používaní Fluentd s bufferovacím pluginom na výstupe sme sa stretli so situáciou, keď niektoré dokumenty v ElasticSearch majú úplne rovnaký obsah a líšia sa len identifikátorom. Overiť, že ide naozaj o opakovanie správy, môžeme na príklade logu Nginx. V logovom súbore existuje táto správa v jediném exemplári:
127.0.0.1 192.168.0.1 - [28/Feb/2013:12:00:00 +0900] "GET / HTTP/1.1" 200 777 "-" "Opera/12.0" -Avšak v ElasticSearch existuje niekoľko dokumentov obsahujúcich túto správu:
{
  "_index": "test-custom-prod-example-2020.01.02",
  "_type": "_doc",
  "_id": "HgGl_nIBR8C-2_33RlQV",
  "_version": 1,
  "_score": 0,
  "_source": {
    "service": "test-custom-prod-example",
    "container_name": "nginx",
    "namespace": "test-prod",
    "@timestamp": "2020-01-14T05:29:47.599052886 00:00",
    "log": "127.0.0.1 192.168.0.1 - [28\/Feb\/2013:12:00:00  0900] "GET \/ HTTP\/1.1" 200 777 "-" "Opera\/12.0" -",
    "tag": "custom-log"
  }
}

{
  "_index": "test-custom-prod-example-2020.01.02",
  "_type": "_doc",
  "_id": "IgGm_nIBR8C-2_33e2ST",
  "_version": 1,
  "_score": 0,
  "_source": {
    "service": "test-custom-prod-example",
    "container_name": "nginx",
    "namespace": "test-prod",
    "@timestamp": "2020-01-14T05:29:47.599052886 00:00",
    "log": "127.0.0.1 192.168.0.1 - [28\/Feb\/2013:12:00:00  0900] "GET \/ HTTP\/1.1" 200 777 "-" "Opera\/12.0" -",
    "tag": "custom-log"
  }
}
Opakovania môžu byť viac ako dve.
Počas zaznamenávania tejto problémy v logoch Fluentd vidíme množstvo varovaní nasledujúceho znenia:
2020-01-16 01:46:46 +0000 [warn]: [test-prod] zlyhalo odoslanie vyrovnávacej pamäte. retry_time=4 next_retry_seconds=2020-01-16 01:46:53 +0000 chunk="59c37fc3fb320608692c352802b973ce" error_class=Fluent::Plugin::ElasticsearchOutput::RecoverableRequestFailure error="nebolo možné odoslať logy do klastru Elasticsearch ({:host=>"elasticsearch", :port=>9200, :scheme=>"http", :user=>"elastic", :password=>"obfuscated"}): dosiahnutý časový limit čítania"Tieto varovania sa objavujú, keď ElasticSearch nedokáže vrátiť odpoveď na požiadavku v stanovenom čase request_timeout, čo znemožňuje vymazať odoslaný fragment vyrovnávacej pamäte. Potom sa Fluentd snaží znovu odoslať fragment vyrovnávacej pamäte do ElasticSearch a po niekoľkých pokusoch operácia úspešne skončí:
2020-01-16 01:47:05 +0000 [warn]: [test-prod] opakovanie bolo úspešné. chunk_id="59c37fc3fb320608692c352802b973ce"
2020-01-16 01:47:05 +0000 [warn]: [test-prod] opakovanie bolo úspešné. chunk_id="59c37fad241ab300518b936e27200747"
2020-01-16 01:47:05 +0000 [warn]: [test-dev] opakovanie bolo úspešné. chunk_id="59c37fc11f7ab707ca5de72a88321cc2"
2020-01-16 01:47:05 +0000 [warn]: [test-dev] opakovanie bolo úspešné. chunk_id="59c37fb5adb70c06e649d8c108318c9b"
2020-01-16 01:47:15 +0000 [warn]: [kube-system] opakovanie bolo úspešné. chunk_id="59c37f63a9046e6dff7e9987729be66f"
Avšak, ElasticSearch považuje každý z odoslaných fragmentov vyrovnávacej pamäte za jedinečný a priraďuje im jedinečné hodnoty do polí _id pri indexovaní. Takto vznikajú kópie správ.
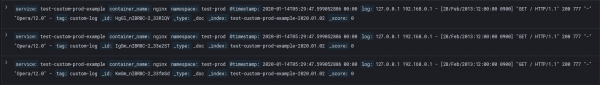
V Kibane to vyzerá takto:
Riešenie problému
Existuje niekoľko možností, ako riešiť tento problém. Jednou z nich je mechanizmus generovania jedinečného hash kódu pre každý dokument, ktorý je integrovaný v plugine fluent-plugin-elasticsearch. Ak sa tento mechanizmus využije, ElasticSearch rozpozná duplicitné záznamy počas prenosu a zabráni duplicite dokumentov. Treba však pamätať na to, že tento spôsob riešenia problému sa zaoberá následkom a neodstráni chybu nedostatku časového limitu, a preto sme sa rozhodli ho nepoužiť.
Používame vyrovnávací plugin na výstupu Fluentd, aby sme zabránili strate logov v prípade krátkodobých problémov so sieťou alebo zvýšenej intenzity zápisu logov. Ak z nejakého dôvodu ElasticSearch nemôže okamžite zapísať dokument do indexu, dokument sa dostane do fronty, ktorá sa uloží na disku. Preto, aby sme odstránili zdroj problému, ktorý spôsobuje vznik vyššie uvedenej chyby, je potrebné nastaviť správne hodnoty vyrovnávacích parametrov, pri ktorých bude výstupný vyrovnávací priestor Fluentd dostatočne veľký a zároveň sa stihne vyčistiť v stanovenom čase.
Je potrebné poznamenať, že hodnoty parametrov, o ktorých sa bude diskutovať nižšie, sú individuálne pre každý konkrétny prípad používania vyrovnávania v výstupných pluginoch, pretože závisia od množstva faktorov: intenzity zápisu log správami služieb, výkonu diskového systému, zaťaženia sieťového kanála a jeho priepustnosti. Preto, aby sme získali vhodné a nie nadmerné nastavenia vyrovnávacieho bufferu pre každý jednotlivý prípad, a vyhli sa dlhému slepému prehľadávaniu, môžeme využiť ladacie informácie, ktoré Fluentd zapisuje do svojho logu počas práce a relatívne rýchlo získať správne hodnoty.
V čase zaznamenania problému mala konfigurácia nasledujúcu podobu:
 @type file
        path /var/log/fluentd-buffers/kubernetes.test.buffer
        flush_mode interval
        retry_type exponential_backoff
        flush_thread_count 2
        flush_interval 5s
        retry_forever
        retry_max_interval 30
        chunk_limit_size 8M
        queue_limit_length 8
        overflow_action block
Pri riešení problému boli manuálne nastavované hodnoty nasledujúcich parametrov:
chunk_limit_size — veľkosť chunkov, na ktoré sa delia správy vo vyrovnávači.
- flush_interval — interval času, po ktorom sa vyčistí vyrovnávacia pamäť.
- queue_limit_length — maximálny počet chunkov v fronte.
- request_timeout — čas, počas ktorého je nadviazané spojenie medzi Fluentd a ElasticSearch.
Celkovú veľkosť vyrovnávacej pamäte je možné vypočítať vynásobením parametrov queue_limit_length a chunk_limit_size, čo možno chápať ako "maximálny počet chunkov vo fronte, z ktorých každý má určený objem". Pri nedostatočnej veľkosti vyrovnávacej pamäti sa v logoch objaví nasledujúce upozornenie:
2020-01-21 10:22:57 +0000 [warn]: [test-prod] neúspešne napísal údaje do vyrovnávacej pamäti z dôvodu pretečenia vyrovnávacej pamäte action=:blockTo znamená, že vyrovnávacia pamäť nemá čas na vyčistenie v pridelenom čase a údaje, ktoré prichádzajú do zaplnenej vyrovnávacej pamäti, sú zablokované, čo vedie k strate časti logov.
Vyrovnávaciu pamäť je možné zvýšiť dvoma spôsobmi: zvýšením buď veľkosti každého chunku vo fronte, alebo počtu chunkov, ktoré môžu byť vo fronte.
Ak nastavíte veľkosť chunku chunk_limit_size na viac ako 32 megabajtov, ElasticSearch ho neprijme, pretože prichádzajúci balík bude príliš veľký. Preto, ak je potrebné vyrovnávaciu pamäť ďalej zvýšiť, je lepšie zvyšovať maximálnu dĺžku frontu queue_limit_length.
Keď sa vyrovnávacia pamäť prestane preplňovať a zostane iba správa o nedostatku časového limitu, môžete pristúpiť k zvýšeniu parametra request_timeout. Avšak, pri nastavení hodnoty nad 20 sekúnd sa v logoch Fluentd začnú objavovať nasledujúce upozornenia:
2020-01-21 09:55:33 +0000 [warn]: [test-dev] flush vyrovnávacej pamäte trval dlhšie ako slow_flush_log_threshold: elapsed_time=20.85753920301795 slow_flush_log_threshold=20.0 plugin_id="postgresql-dev" Táto správa nijako neovplyvňuje činnosť systému a znamená, že čas na vyčistenie vyrovnávacej pamäte trval dlhšie, ako stanovuje parameter slow_flush_log_threshold. Toto je ladenie informácia a používame ju pri nastavovaní hodnoty parametra request_timeout.
Zhrnutý algoritmus nastavenia vyzerá nasledovne:
- Nastavte hodnotu request_timeout s garantovane vyššou, ako je potrebné (stovky sekúnd). Počas nastavovania bude hlavným kritériom správnosti nastavenia tohto parametra zmiznutie upozornení na nedostatok časového limitu.
- Čakajte na správy o prekročení prahu slow_flush_log_threshold. V texte upozornenia v poli elapsed_time bude uvedený skutočný čas vyčistenia vyrovnávacej pamäte.
- Nastavte hodnotu request_timeout vyššiu než maximálna hodnota elapsed_time získaná počas pozorovania. Vypočítavame hodnotu request_timeout ako elapsed_time + 50%.
- Aby ste odstránili z logu varovania o dlhom vyprázdňovaní vyrovnávacej pamäte, môžete zvýšiť hodnotu slow_flush_log_threshold. Vypočítavame túto hodnotu ako elapsed_time + 25%.
Konečné hodnoty týchto parametrov, ako sme spomenuli predtým, sú individuálne pre každý prípad. Nasledovaním vyššie uvedeného algoritmu zabezpečujeme odstranenie chyby, ktorá vedie k opakovaniu správ.
V tabuľke nižšie sú zobrazené zmeny počtu chýb za deň, ktoré vedú k duplikovaniu správ, počas hľadania hodnôt uvedených vyššie:
node-1
node-2
node-3
node-4
Pred/Po
Pred/Po
Pred/Po
Pred/Po
nepodarilo sa vyprázdniť vyrovnávaciu pamäť
1749/2
694/2
47/0
1121/2
opakovanie úspešné
410/2
205/1
24/0
241/2
Je potrebné ďalej poznamenať, že získané nastavenia môžu stratiť svoju aktuálnosť počas rastu projektu a, samozrejme, zvyšovania počtu logov. Prvým znakom nedostatku nastaveného časového limitu je vrátenie správ do logu Fluentd o dlhom vyprázdňovaní vyrovnávacej pamäte, teda prekročenie prahu slow_flush_log_threshold. Od tohto bodu je ešte malá rezerva pred prekročením parametra request_timeout, preto je potrebné včas zaznamenať tieto správy a znova vykonať proces hľadania optimálnych nastavení uvedený vyššie.
Záver
Ladenie výstupnej vyrovnávacej pamäte Fluentd je jedným z hlavných krokov pri nastavovaní EFK stacku, ktorý určuje stabilitu jeho práce a správnosť umiestňovania dokumentov v indexoch. Orientovaním sa na popísaný algoritmus nastavenia si môžete byť istí, že všetky logy budú zaznamenané do indexu ElasticSearch v správnom poradí, bez opakovaní a strát.
Čítajte tiež ďalšie články na našom blogu:
Zdroj: habr.com
