

Téma veľkých havárií v moderných DC vyvoláva otázky, na ktoré v prvom článku nebolo odpovedí — rozhodli sme sa ju rozvinúť.
Ak veríme štatistike Uptime Institute, väčšina incidentov v dátových centrách sa týka zlyhaní systému napájania — na ich podiel pripadá 39 % všetkých udalostí. Nasleduje ľudský faktor — to je ďalších 24 % havárií. Treťou najvýznamnejšou (15 %) príčinou boli zlyhania klimatizačného systému, zatiaľ čo na štvrtom mieste (12 %) sa ocitli prírodné katastrofy. Celkový podiel ostatných nepríjemností predstavuje len 10 %. Bez pochybností o údajoch rešpektovanej organizácie zdôraznime niečo spoločné v rôznych haváriách a pokúsime sa pochopiť, či ich bolo možné zabrániť. Spoilery: vo väčšine prípadov áno.
Veda o kontaktoch
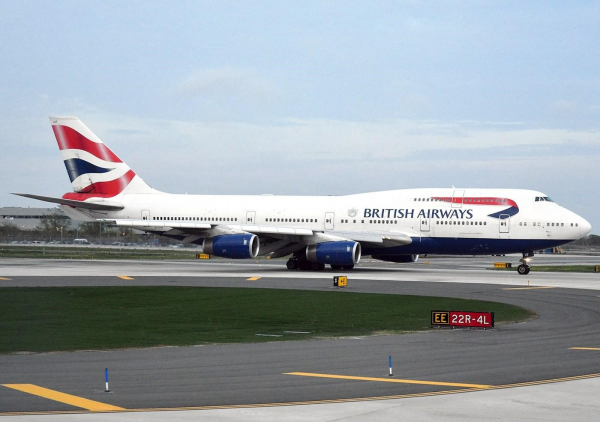
Zjednodušene povedané, pri napájaní bývajú len dva problémy: buď nie je kontakt tam, kde by mal byť, alebo je tam, kde by nemal byť. Môžeme dlho polemizovať o spoľahlivosti moderných systémov nepřerušovaného napájania, ale nezachraňujú vždy. Vezmime si napríklad oznamovaný prípad so dátovým centrom British Airways, ktoré patrí materskej spoločnosti International Airlines Group. Neďaleko letiska Heathrow sa nachádzajú dva také objekty — Boadicea House a Comet House. V prvom z nich 27. mája 2017 došlo k náhodnému vypnutiu napájania, ktoré viedlo k preťaženiu a zlyhaniu systému UPS. V dôsledku toho bola časť IT zariadenia fyzicky poškodená, a na odstránenie poslednej havárie sa minuli tri dni.
Letecké spoločnosti museli zrušiť alebo presunúť viac ako tisíc letov, približne 75 tisíc pasažierov sa nemohlo včas odletieť – na vyplatenie odškodnení sa minulo 128 miliónov dolárov, bez zohľadnenia nákladov na obnovenie funkčnosti dátových centier. Príčiny blackout sa zdajú byť nejasné. Ak sa dá veriť výsledkom interného vyšetrenia, ktoré oznámil generálny riaditeľ International Airlines Group Willie Walsh, k udalosti došlo v dôsledku chyby inžinierov. Napriek tomu mala systémová záložná elektrická energia odolať takémuto výpadku – práve na to je navrhnutá. Dátové centrá spravovali odborníci z outsourcingovej spoločnosti CBRE Managed Services, preto sa British Airways pokúsila získať odškodnenie prostredníctvom súdu v Londýne.
Výpadky elektrickej energie sa odohrávajú podľa podobných scénarov: najprv dôjde k výpadku z viny dodávateľa elektriny, niekedy kvôli zlému počasiu alebo interným problémom (vrátane chýb personálu), a potom systém záložného napájania nezvláda záťaž alebo krátkodobé prerušenie sínusoidy spôsobí zlyhania mnohých služieb, na obnovenie ktorých je potrebné veľa času a peňazí. Dá sa predísť podobným výpadkom? Určite. Ak navrhneme systém správne, avšak chyby sa nevyhnú ani tvorcom veľkých dátových centier.
Ľudský faktor
Keď sa bezprostrednou príčinou incidentu stávajú nesprávne kroky personálu dátového centra, problémy sa najčastejšie (ale nielen) týkajú softvérovej časti IT infraštruktúry. Takéto havárie sa vyskytujú aj vo veľkých korporáciách. V februári 2017 bola kvôli nesprávne zadanému príkazu členom tímu technickej údržby jedného z dátových centier odpojená časť serverov Amazon Web Services. Chyba nastala počas ladenia procesu fakturácie zákazníkom cloudového úložiska Amazon Simple Storage Service (S3). Zamestnanec sa snažil odstrániť niekoľko virtuálnych serverov používaných fakturačným systémom, ale zasiahol väčšiu skupinu.
V dôsledku chyby inžiniera sa vymazali servery, na ktorých boli spustené dôležité programové moduly cloudového úložiska Amazon. Najprv bola postihnutá subsystém indexovania, ktorý obsahoval informácie o metadátach a umiestnení všetkých objektov S3 v americkom regióne US-EAST-1. Incident sa dotkol aj subsystému, ktorý sa používal na ukladanie dát a správu dostupného priestoru na ukladanie. Po vymazaní virtuálnych strojov si tieto dva subsystémy vyžiadali úplný reštart, a inžinierov Amazon čakal prekvapenie — počas dlhého obdobia verejné cloudové úložisko nedokázalo spracovávať požiadavky zákazníkov.
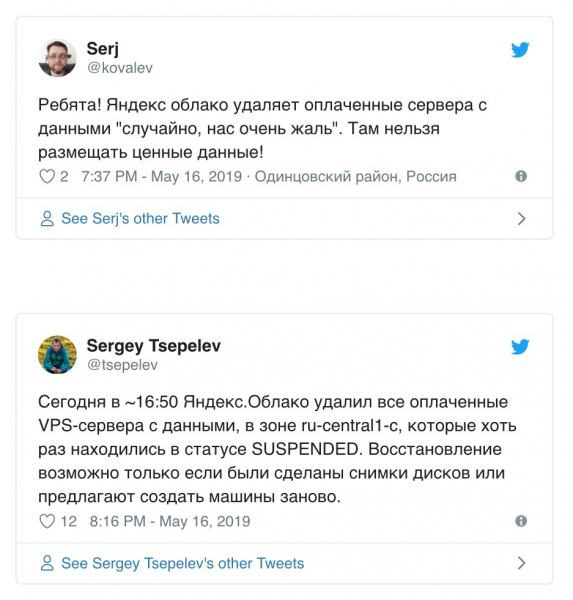
Efekt bol rozsiahly, pretože mnohé veľké zdroje používajú Amazon S3. Výpadky ovplyvnili Trello, Coursera, IFTTT a, čo je najnepríjemnejšie, služby veľkých partnerov Amazon zo zoznamu S&P 500. Škodu v takýchto prípadoch je ťažké vyčísliť, ale jej rozsah sa pohybuje v rádoch stoviek miliónov dolárov. Ako vidíte, na to, aby sa porušil servis najväčšej cloudovej platformy, stačí jedna nesprávna príkaz. Nie je to ojedinelý prípad; 16. mája 2019, počas preventívnych prác, služba Yandex.Cloud virtuálne stroje používateľov v oblasti ru-central1-c, ktoré boli aspoň raz v stave SUSPENDED. Tu už boli postihnuté údaje zákazníkov, z ktorých niektoré sa beznádejne stratili. Samozrejme, ľudia nie sú dokonalí, ale moderné informačné bezpečnostné systémy už dávno dokážu kontrolovať činnosti privilegovaných používateľov pred vykonaním zadaných príkazov. Ak by sa do Yandexu alebo Amazonu implementovali takéto riešenia, podobným incidentom by sa dalo predísť.
Zamrznuté chladenie
V januári 2017 sa v dátovom centre spoločnosti „MegaFon“ v Dmitrove stala vážna havária. Teplota v moskovskom regióne klesla na -35 °C, čo viedlo k poruche chladenia zariadenia. Tlačová služba operátora sa o príčinách incidentu veľmi nezmieňovala — ruské spoločnosti veľmi nerady hovoria o haváriách vo vlastných zariadeniach, pokiaľ ide o verejné informovanie, značne zaostávame za Západom. Na sociálnych sieťach sa objavila verzia o zamrznutí chladiacej kvapaliny v potrubiach položených po ulici a úniku etylénglykolu. Ak je tomu tak, prevádzková služba nemohla kvôli dlhým sviatkom rýchlo získať 30 ton chladiva a improvizovala s použitím dostupných prostriedkov, pričom zorganizovala improvizované chladenie s porušením pravidiel prevádzky systému. Silné mrazy problém ešte zhoršili — v januári v Rusku náhle nastala zima, aj keď ju nikto nečakal. Nakoniec bolo potrebné odpojiť časť serverových stojanov, čo spôsobilo, že niektoré služby operátora boli dva dni nedostupné.
Možno sa tu dá hovoriť aj o poveternostnej anomálii, ale takéto mrazy nie sú pre hlavné mesto nič nezvyčajné. Teplota v zime v Moskovskej oblasti môže klesnúť aj na nižšie hodnoty, preto sa dátové centrá stavajú s ohľadom na stabilnú prevádzku pri -42 °C. Najčastejšie zlyhávajú chladenia v mraze z dôvodu nedostatočne vysokej koncentrácie glykolov a nadbytku vody v chladiacom roztoku. Môžu sa vyskytnúť aj problémy s inštaláciou potrubí alebo s chybami v projektovaní a testovaní systému, ktoré sú väčšinou spojené s túžbou ušetriť. Nakoniec sa na rovnom mieste stane vážna havária, ktorej sa dalo s ľahkosťou predísť.
Prírodné katastrofy
Najčastejšie búrky a/alebo hurikány narušujú prevádzku inžinierskej infraštruktúry dátového centra, čo vedie k zastaveniu služieb a/alebo k fyzickému poškodeniu zariadenia. Incidenty spôsobené zlým počasím sa vyskytujú celkom často. V roku 2012 prešiel po západnom pobreží USA hurikán Sandy so silným dažďom. Dátové centrum Peer 1 umiestnené v výškovej budove na Dolnom Manhattane , po tom, čo slaná morská voda zaplnila pivnice. Núdzové generátory objektu boli umiestnené na 18. poschodí a zásoby paliva pre ne boli obmedzené — pravidlá zavedené v New Yorku po teroristických útokoch z 11. septembra zakazujú uchovávať veľké množstvo paliva na vyšších poschodiach.
Palivové čerpadlo sa tiež pokazilo, takže personál na niekoľko dní nosil naftu pre generátory ručne. Heroizmus tímu zachránil dátové centrum pred vážnou haváriou, ale bolo to naozaj potrebné? Žijeme na planéte s atmosférou bohatou na dusík a kyslík a veľkým množstvom vody. Búrky a hurikány sú tu bežné (najmä v pobrežných oblastiach). Projektantom by pravdepodobne malo stáť za zváženie riziko s nimi spojené a vybudovať zodpovedajúci systém neprerušovaného napájania. Alebo aspoň zvoliť pre dátové centrum vhodnejšie miesto ako výškovú budovu na ostrove.
Všetko ostatné
Do tejto kategórie Uptime Institute zaraďuje rôzne incidenty, v ktorých je ťažké vybrať typický. Krádeže medených káblov, vnikajúce do DCD, stĺpy vysokého napätia a transformačné stanice, autá, požiare, poškodzujúce optiku, bagristi, hlodavce (potkany, králiky a dokonca aj wombaty, ktoré patriť k vačkovcom), ako aj nadšenci, ktorí si chcú trénovať streľbu do drôtov — ponuka je rozsiahla. Výpadky napájania môže spôsobiť aj elektrina z nelegálnej plantáže marihuany. V mnohých prípadoch sú vinníkmi incidentu konkrétni ľudia, t. j. opäť sa zaoberáme ľudským faktorom, keď má problém meno a priezvisko. Aj keď sa na prvý pohľad havária zdá súvisieť s technickou poruchou alebo prírodnými katastrofami, dá sa jej predísť za predpokladu správneho projektovania objektu a jeho správnej prevádzky. Výnimkou sú azda len prípady kritického poškodenia infraštruktúry DCD alebo zničenia budov a stavieb v dôsledku prírodnej katastrofy. To sú naozaj mimoriadne okolnosti, a všetky ostatné problémy sú spôsobené zasadením medzi počítač a stoličku — pravdepodobne najnedôveryhodnejšia časť každej zložitej sústavy.
Zdroj: habr.com
