

Odporúčam vám oboznámiť sa s prehľadom správy z konca roka 2019 od Alexandra Valjalkina "Optimalizácie Go vo VictoriaMetrics"
— rýchly a škálovateľný DBMS na ukladanie a spracovanie údajov vo forme časových rádov (záznam vytvára čas a súbor hodnoty súvisiaceho s týmto časom, napríklad získané pravidelným zisťovaním stavu senzorov alebo zbieraním metrík).
Tu je odkaz na video tejto správy —
Povieme si niečo o mne. Ja som Alexander Valjalkin. Tu je . Zaujímam sa o Go a optimalizáciu výkonu. Napísal som veľa rôznych užitočných a menej užitočných knižníc. Začínajú buď s fast, alebo s quick prefixom.
V súčasnosti pracujem na VictoriaMetrics. Čo to je a čo tam robím? O tom vám poviem v tejto prezentácii.
Plán prezentácie je taký:
- Na začiatku vám poviem, čo je VictoriaMetrics.
- Potom vám poviem, čo sú časové rady.
- Potom vám vysvetlím, ako funguje databáza časových rád.
- Potom vám poviem o architektúre databázy: z čoho je zložená.
- A potom prejdeme k optimalizáciám, ktoré existujú vo VictoriaMetrics. To je optimalizácia inverzného indexu a optimalizácia realizácie bitset na Go.
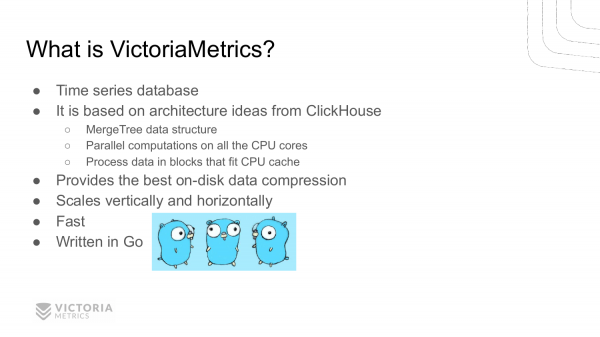
Vie niekto v publiku, čo je VictoriaMetrics? Nič si, už veľa ľudí to vie. To je dobrá správa. Pre tých, ktorí nevedia – je to databáza pre časové rady. Je postavená na architektúre ClickHouse, na niektorých detailoch implementácie ClickHouse. Napríklad na takých, ako: MergeTree, paralelné výpočty na všetkých dostupných jadrách procesora a optimalizácia výkonu prostredníctvom práce s blokmi údajov, ktoré sa umiestňujú do cache procesora.
VictoriaMetrics poskytuje najlepšie kompresie údajov v porovnaní s inými databázami pre časové rady.
Škálovanie je vertikálne — t. j. môžete pridať viac procesorov, viac operačnej pamäte na jednom počítači. VictoriaMetrics úspešne využije tieto dostupné zdroje a zvýši lineárny výkon.
VictoriaMetrics sa tiež horizontálne škáluje — t. j. môžete pridať ďalšie uzly do klastrov VictoriaMetrics, a jej výkon sa takmer lineárne zvyšuje.
Ako ste sa zhodli, VictoriaMetrics je rýchla databáza, pretože o iných nemôžem písať. A je napísaná v Go, takže o nej hovorím na tomto meetupe.
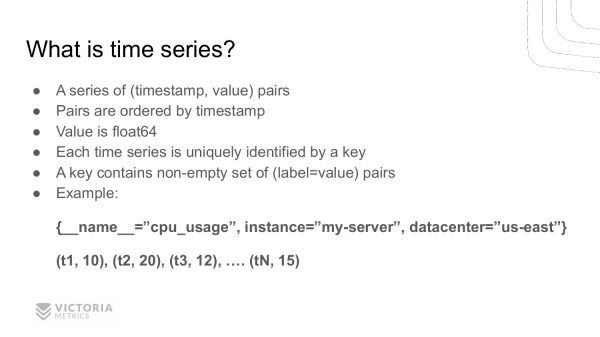
Kto vie, čo je časová rada? Veľa ľudí to vie. Časová rada je séria pár (časová značka, hodnota), kde sú tieto páry zoradené podľa času. Hodnota predstavuje číslo s plávajúcou desatinnou čiarkou – float64.
Každá časová rada je jedinečne identifikovaná kľúčom. Z čoho sa skladá tento kľúč? Skladá sa z neprázdnej množiny párov kľúč-hodnota.
Tu je príklad časovej rady. Kľúčom tejto rady je zoznam párov: __name__="cpu_usage" – to je názov metriky, instance="my-server" — to je počítač, na ktorom bola táto metrika zhromaždená, datacenter="us-east" — to je dátové centrum, kde sa nachádza tento počítač.
Máme meno časovej rady, ktoré pozostáva z troch párov kľúč-hodnota. Tomuto kľúču zodpovedá zoznam párov (timestamp, value). t1, t3, t3, ..., tN — to sú časové pečiatky, 10, 20, 12, ..., 15 — zodpovedajúce hodnoty. Toto je cpu-usage v danom okamihu pre danú radu.
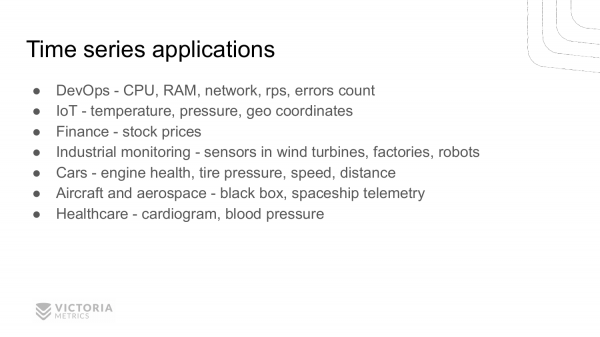
Kde môžu byť použité časové rady? Má niekto nejaké nápady?
- V DevOps môžeme merať zaťaženie CPU, RAM, siete, rps, počet chýb a pod.
- IoT – môžeme merať teplotu, tlak, geografické súradnice a ďalšie.
- Rovnako vo financiách – môžeme monitorovať ceny rôznych akcií a mien.
- Okrem toho môžu byť časové rady použité na monitorovanie výrobných procesov vo fabrikách. Máme používateľov, ktorí používajú VictoriaMetrics na sledovanie veterných turbín, pre roboty.
- Časové rady sú tiež užitočné na zhromažďovanie informácií zo senzorov rôznych zariadení. Napríklad pre motor; na meranie tlaku v pneumatikách; na meranie rýchlosti, vzdialenosti; na meranie spotreby benzínu a pod.
- Časové rady sa môžu tiež používať na monitorovanie lietadiel. V každom lietadle je čierna skrinka, ktorá zhromažďuje časové rady pre rôzne parametre zdravia lietadla. Časové rady sa tiež používajú v leteckom priemysle.
- Zdravotná starostlivosť – to sú krvný tlak, pulz atď.
Možno existujú ešte iné aplikácie, na ktoré som zabudol, ale dúfam, že ste pochopili, že časové rady sú aktívne využívané v modernej dobe. A objem ich používania každým rokom rastie.
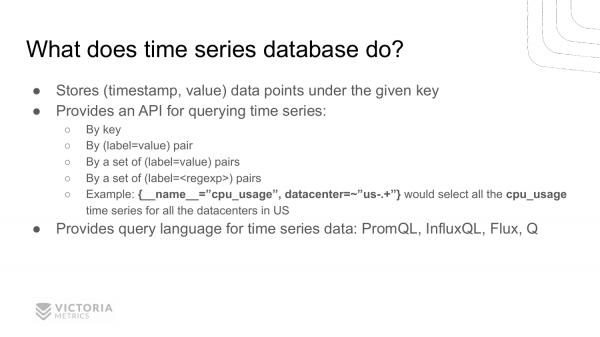
Na čo slúži databáza pre časové rady? Prečo nie je možné použiť bežnú relačnú databázu na uchovávanie časových rádov?
Pretože v časových radoch zvyčajne existuje veľké množstvo informácií, ktoré je ťažké uchovávať a spracovávať v bežných databázach. Preto vznikli špecializované databázy pre časové rady. Tieto databázy efektívne ukladajú body (timestamp, value) s daným kľúčom. Poskytujú API na čítanie uložených údajov podľa kľúča, jednotlivých párov kľúč-hodnota, alebo podľa niekoľkých takých párov, alebo podľa regexp. Napríklad, ak chcete nájsť zaťaženie procesora všetkých vašich služieb v dátovom centre v Amerike, potrebujete použiť takýto pseudo-dotaz.
Špecializované databázy pre časové rady zvyčajne ponúkajú špecializované dotazovacie jazyky, pretože SQL pre časové rady nie je veľmi vhodný. Aj keď existujú databázy, ktoré podporujú SQL, nie je to ideálne. Lepšie sa hodia také dotazovacie jazyky, ako sú , , , . Dúfam, že niekto počul aspoň o jednom z týchto jazykov. O PromQL určite počulo mnoho ľudí. To je dotazovací jazyk pre Prometheus.
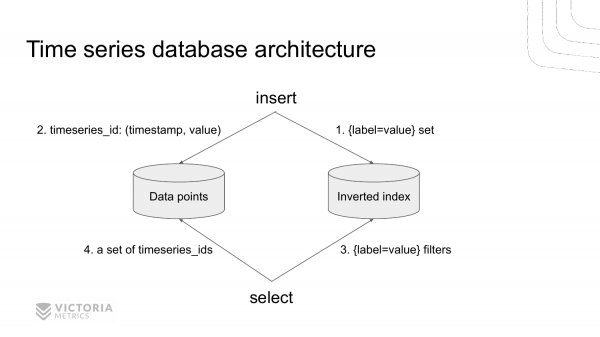
Takto vyzerá architektúra modernej databázy pre časové rady na príklade VictoriaMetrics.
Skladá sa z dvoch častí. Je to úložisko pre inverzovaný index a úložisko pre hodnoty časových rádov. Tieto úložiská sú oddelené.
Keď príde nový záznam do databázy, najprv sa obraciame na inverzovaný index, aby sme našli identifikátor časového radu podľa daného súboru label=value pre túto metriku. Nájdeme tento identifikátor a uložíme hodnotu do úložiska údajov.
Keď príde nejaký dopyt na výber údajov z TSDB, v prvom rade sa ponoríme do inverzovaného indexu. Získame všetky timeseries_ids záznamy, ktoré zodpovedajú danému súboru label=value. A potom získame všetky potrebné údaje z úložiska údajov, indexovaného podľa timeseries_ids.
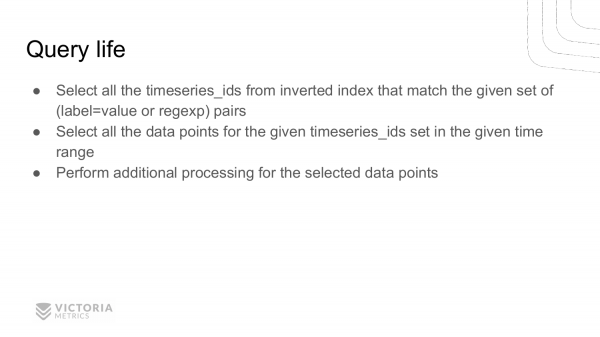
Zvážme príklad, ako databáza pre časové rady spracováva prichádzajúci select-dotaz.
- V prvom rade získa všetky
timeseries_idsz inverzovaného indexu, ktoré obsahujú dané párylabel=value, alebo spĺňajú dané regulárne výrazy. - Potom získa všetky data points z úložiska údajov na danom časovom intervale pre nájdené
timeseries_ids. - Po tomto databáza vykonáva nejaké výpočty nad týmito dátovými bodmi podľa požiadavky používateľa. A potom vracia odpoveď.
V tejto prezentácii vám poviem o prvej časti. Je to vyhľadávanie timeseries_ids podľa invertovaného indexu. O druhej a tretej časti si môžete neskôr pozrieť , alebo počkať, kým pripravím ďalšie prednášky 🙂
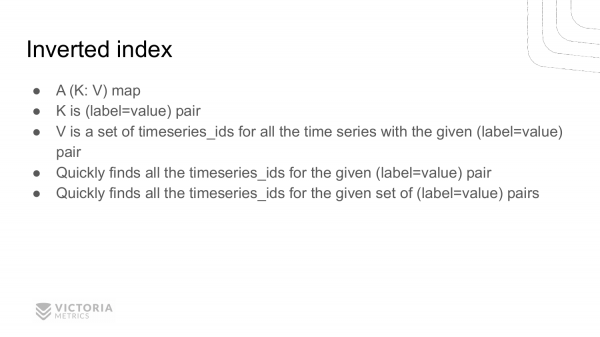
Prejdeme k invertovanému indexu. Mnohým sa to môže zdať jednoduché. Kto vie, čo je invertovaný index a ako funguje? O, už nie je tak veľa ľudí. Pokúsme sa pochopiť, čo to je.
Na prvý pohľad je to jednoduché. Je to len slovník, ktorý zobrazuje kľúč na hodnotu. Čo je to kľúč? Tento pár label=value, kde label a value je reťazec. A hodnoty sú súbor timeseries_ids, ktorý obsahuje daný pár label=value.
Invertovaný index umožňuje rýchlo nájsť všetky timeseries_ids, ktoré obsahujú dané label=value.
A takisto umožňuje rýchlo nájsť timeseries_ids časové rady pre viacero párov label=value, alebo pre páry label=regexp. Ako to funguje? Pomocou zisťovania prieniku množiny timeseries_ids pre každý pár label=value.
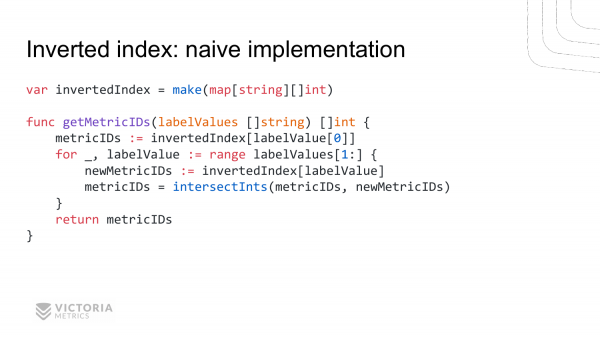
Pozrime sa na rôzne implementácie invertovaného indexu. Začneme s najjednoduchšou naivnou implementáciou. Vyzerá to takto.
Funkcia getMetricIDs získava zoznam reťazcov. Každý reťazec obsahuje label=value. Táto funkcia vracia zoznam metricIDs.
Ako to funguje? Tu máme globálnu premennú, ktorá sa volá invertedIndex. Je to bežný slovník (map), ktorý zobrazuje reťazec na slice int-ov. Reťazec obsahuje label=value.
Implementácia funkcie: vyberáme metricIDs pre prvý label=value, potom prechádzame všetkými ostatnými label=value, vyberáme metricIDs pre nich. A voláme funkciu intersectInts, o ktorej sa bude hovoriť neskôr. A táto funkcia vráti prienik týchto zoznamov.
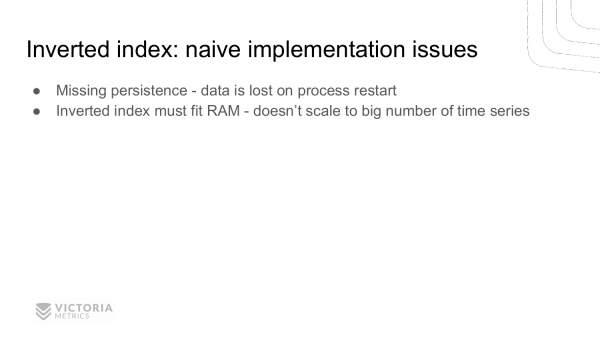
Ako vidíte, implementácia invertovaného indexu nie je veľmi zložitá. Ale je to naivná implementácia. Aké má nevýhody? Hlavná nevýhoda naivnej implementácie je v tom, že taký invertovaný index máme uložený v operačnej pamäti. Po reštarte aplikácie tento index stratíme. Nie je žiadne uloženie tohto indexu na disk. Pre databázu taký invertovaný index asi ťažko vyhovuje.
Druhý nedostatok súvisí taktiež s pamäťou. Inverzný index musí byť uložený v RAM. Ak presiahne veľkosť operačnej pamäte, je jasné, že dostaneme - chyba nedostatku pamäte. A program nebude fungovať.
Tento problém je možné vyriešiť pomocou hotových riešení, ako sú , alebo .
Ak to zhrnieme, potrebujeme databázu, ktorá umožňuje rýchlo vykonať tri operácie.
- Prvá operácia – to je zápis
kľúč-hodnotado tejto databázy. Robí to veľmi rýchlo, kdekľúč-hodnota– to sú ľubovoľné reťazce. - Druhá operácia – to je rýchle vyhľadávanie hodnoty podľa zadaného kľúča.
- A tretia operácia – to je rýchle vyhľadávanie všetkých hodnôt podľa zadaného prefixu.
LevelDB a RocksDB – tieto databázy vyvinuli Google a Facebook. Najprv sa objavila LevelDB. Potom chalani z Facebooku vzali LevelDB a začali ju vylepšovať, vytvorili RocksDB. Teraz na RocksDB vo Facebooku pracujú takmer všetky interné databázy, vrátane toho, že prešli na RocksDB aj MySQL. Nazvali to .
Inverzný index je možné realizovať pomocou LevelDB. Ako to urobíme? Uložíme ako kľúč label=value. A ako hodnotu – identifikátor časovej rady, kde je prítomný pár label=value.
Ak máme veľa časových rád s daným párom label=value, bude v tejto databáze veľa riadkov so zhodným kľúčom a rôznymi timeseries_ids. Aby sme získali zoznam všetkých timeseries_ids, ktoré začínajú na daný label=prefix, urobíme range scan, na ktorý je táto databáza optimalizovaná. T. j. vyberieme všetky riadky, ktoré začínajú s label=prefix a získame potrebné timeseries_ids.
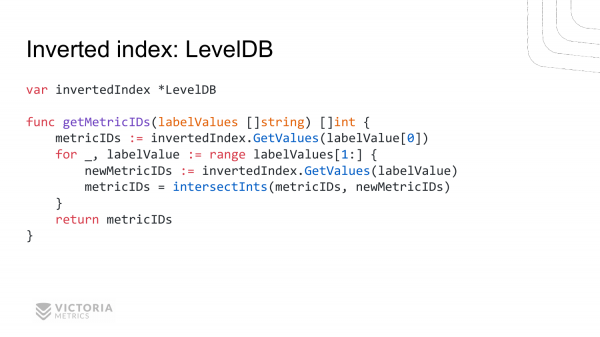
Toto je približná realizácia, ako by vyzerala v Go. Máme inverzný index. Toto je LevelDB.
Funkcia je rovnaká ako pri naivnej realizácii. Takmer riadok za riadkom opakuje naivnú realizáciu. Jediná vec je, že namiesto prístupu k map pristupujeme k inverznému indexu. Získavame všetky hodnoty pre prvý label=value. Potom prechádzame všetkými zostávajúcimi pármi label=value a získavame zodpovedajúce súpravy metricIDs pre ne. Následne nachádzame prienik.
Zdalo by sa, že je všetko v poriadku, ale v tomto riešení sú nedostatky. VictoriaMetrics najprv realizovala inverzný index na základe LevelDB. Ale nakoniec sa musela tohto prístupu vzdať.
Prečo? Pretože LevelDB je pomalší ako naivná realizácia. Pri naivnej realizácii podľa zadaného kľúča získavame hneď celý slice. metricIDs. Tento veľmi rýchly proces – celý slice je pripravený na použitie.
V LevelDB sa pri každom zavolaní funkcie GetValues musíte prejsť všetky riadky, ktoré začínajú na label=value. A pre každý riadok získať hodnotu timeseries_ids. Z takýchto timeseries_ids zhromaždiť slice týchto timeseries_ids. Je jasné, že je to oveľa pomalšie ako jednoduché odvolanie na bežný map podľa kľúča.
Druhý nedostatok je, že LevelDB je napísaný v C. Volanie C-funkcií z Go nie je veľmi rýchle. Trvá to stovky nanosekúnd. Nie je to veľmi rýchle, pretože v porovnaní s bežným volaním funkcie napísanej v Go, ktorá trvá 1-5 nanosekúnd, je rozdiel v výkonnosti v desiatkach násobkov. Pre VictoriaMetrics to bol fatálny nedostatok 🙂
Preto som napísal vlastnú implementáciu inverzného indexu. A nazval ju .
Mergeset je založený na dátovej štruktúre MergeTree. Táto dátová štruktúra je prevzatá z ClickHouse. Je zrejmé, že mergeset musí byť optimalizovaný pre rýchle vyhľadávanie timeseries_ids podľa zadaného kľúča. Mergeset je napísaný celý v Go. Môžete si pozrieť . Implementácia mergeset sa nachádza v priečinku . Môžete sa pokúsiť zistiť, čo sa tam deje.
API mergeset je veľmi podobné LevelDB a RocksDB. To znamená, že umožňuje rýchlo uložiť nové záznamy a rýchlo vybrať záznamy podľa zadaného prefixu.
O nedostatkoch mergeset si povieme neskôr. Teraz sa porozprávame o tom, aké problémy vznikli s VictoriaMetrics v produkcii pri implementácii inverzného indexu.
Prečo vznikli?
Prvá príčina – je vysoká miera churn. V preklade do slovenčiny – to je častá zmena časových radov. To sa stane, keď časový rad končí a začína nový rad, alebo začína veľa nových časových radov. A to sa deje často.
Druhá príčina – je veľké množstvo časových radov. Na začiatku, keď monitorovanie naberalo na popularite, počet časových radov bol malý. Napríklad, pre každý počítač je potrebné monitorovať zaťaženie procesora, pamäte, siete a disku. 4 časové rady na každý počítač. Máte napríklad 100 počítačov a 400 časových radov. To je veľmi málo.
V priebehu času si ľudia vymysleli, že je možné merať podrobnejšie informácie. Napríklad merať zaťaženie nie celého procesora, ale jednotlivých procesorových jadier. Ak máte 40 procesorových jadier, dostanete tak 40-krát viac časových radov na meranie zaťaženia procesora.
Ale to ešte nie je všetko. Každé procesorové jadro môže mať niekoľko stavov, ako je idle, keď nepracuje. Takisto môže pracovať v užívateľskom prostredí, v jadre a v iných stavoch. A každý takýto stav sa dá tiež merať ako samostatný časový rad. To dodatočne zvyšuje počet radov 7-8-krát.
Z jednej metriky sme dostali 40 x 8 = 320 metrík len pre jeden počítač. Násobíme to 100 a dostaneme 32 000 namiesto 400.
Potom sa objavil Kubernetes. A situácia sa ešte zhoršila, pretože v Kubernetes môže hostiť veľa rôznych služieb. Každá služba v Kubernetes sa skladá z mnohých podov. A to všetko je potrebné monitorovať. Okrem toho máme neustály deployment nových verzií vašich služieb. Pre každú novú verziu je potrebné vytvoriť nové časové rady. Nakoniec počet časových radov exponenciálne rastie a čelíme problému vysokého kardinálneho množstva časových radov. VictoriaMetrics s ním úspešne bojuje v porovnaní s inými databázami pre časové rady.
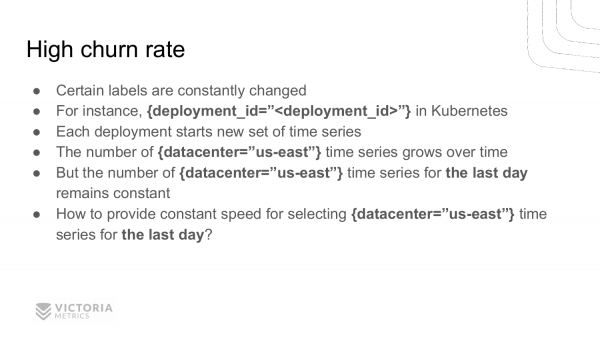
Poďme sa podrobnejšie pozrieť na vysokú miera obratu. Čo spôsobuje vysokú mieru obratu v produkcii? Pretože niektoré hodnoty značiek a tagov sa neustále menia.
Napríklad vezmeme Kubernetes, v ktorom existuje pojem deployment, teda keď sa nasadzuje nová verzia vašej aplikácie. Vývojári Kubernetes sa rozhodli z nejakého dôvodu pridať ID nasadenia do značky.
K čo vedlo? K tomu, že pri každom novom nasadení sa všetky staré časové rady preruší a namiesto nich začínajú nové časové rady s novou hodnotou značky deployment_id. Takých radov môže byť stovky tisíc a dokonca milióny.
Dôležitou vlastnosťou tohto všetkého je to, že celkový počet časových radov rastie, ale počet časových radov, ktoré sú v danom okamihu aktívne a na ktoré prichádzajú dáta, zostáva konštantný. Tento stav sa nazýva – vysoká miera obratu.
Hlavný problém vysokého churn rate spočíva v zabezpečení nepretržitej rýchlosti vyhľadávania všetkých časových radov podľa zadaného súboru štítkov za určitý časový interval. Zvyčajne ide o časový interval za poslednú hodinu alebo za posledný deň.
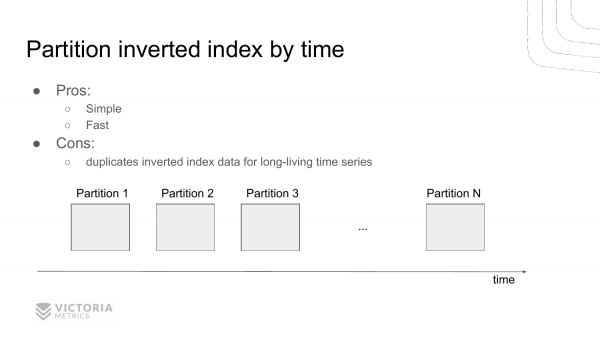
Ako tento problém vyriešiť? Tu je prvá možnosť. Rozdeliť invertovaný index na nezávislé časti podľa času. T.j. prejde určitý časový interval, prestaneme pracovať s aktuálnym invertovaným indexom a vytvoríme nový invertovaný index. Prejde ďalší časový interval, vytvoríme ďalší a ešte jeden.
A pri dotaze z týchto invertovaných indexov nájdeme súbor invertovaných indexov, ktoré sa nachádzajú v zadanom intervale. A odtiaľ vyberieme id časových radov.
To umožňuje ušetriť zdroje, pretože nemusíme prehliadať časti, ktoré nespadnú do zadaného intervalu. T.j. zvyčajne, ak vyberáme údaje za poslednú hodinu, pre predchádzajúce časové intervaly prehliadame požiadavky.
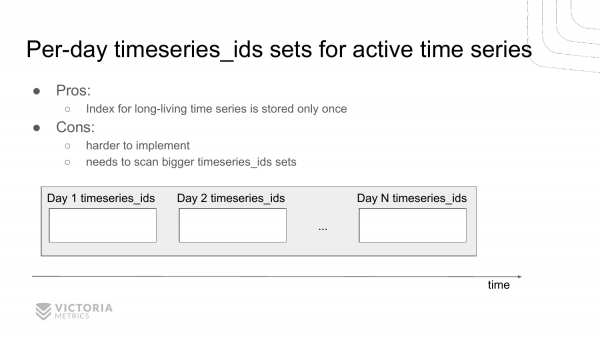
Existuje ďalšia možnosť riešenia tohto problému. Uložiť pre každý deň samostatný zoznam id časových radov, ktoré sa za tento deň vyskytli.
Výhodou tohto riešenia v porovnaní s predchádzajúcim je, že neduplikuje informácie o časových radoch, ktoré nezmiznú s časom. Neustále existujú a nemenia sa.
Nevýhodou je, že takéto riešenie je zložitejšie na implementáciu a ťažšie na ladění. A VictoriaMetrics si vybrala toto riešenie. Historicky sa to tak vyvinulo. Toto riešenie sa tiež ukazuje dobre, v porovnaní s predchádzajúcim. Pretože toto riešenie nebolo implementované kvôli tomu, že musíme duplikovať údaje v každom partition pre časové rady, ktoré sa nemenia, t.j. ktoré nezmiznú s časom. VictoriaMetrics bola najprv optimalizovaná pre spotrebu diskového priestoru, a predchádzajúca implementácia zhoršovala spotrebu diskového priestoru. A toto riešenie je lepšie prispôsobené na minimalizáciu spotreby diskového priestoru, preto bolo vybrané.
Museli sme s ňou bojovať. Boj spočíval v tom, že v tejto implementácii je stále potrebné vyberať oveľa väčšie množstvo timeseries_ids pre údaje, ako keď je invertovaný index rozdelený podľa času.
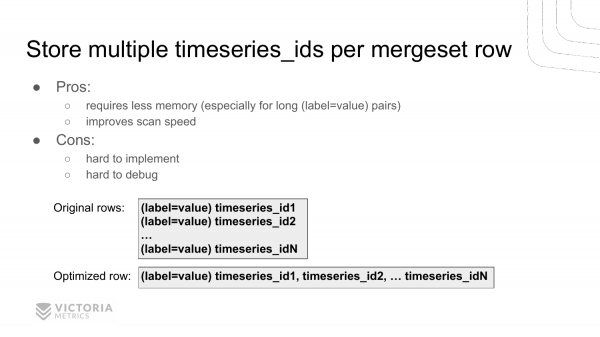
Ako sme vyriešili tento problém? Riešili sme ho originálnym spôsobom - uložením niekoľkých identifikátorov časových radov v každom zápise invertovaného indexu namiesto jedného identifikátora. T. j. máme kľúč label=value, ktorý sa vyskytuje v každom časovom rade. A teraz uchovávame niekoľko timeseries_ids v jednom zápise.
Toto je príklad. Predtým sme mali N záznamov, a teraz máme jeden záznam, ktorého prefix je rovnaký ako u všetkých ostatných. Predchádzajúci záznam obsahoval všetky id časových radov.
To umožnilo zvýšiť rýchlosť skenovania takého invertovaného indexu až desiatkrát. A umožnilo znížiť spotrebu pamäte pre cache, pretože teraz uchovávame reťazec label=value iba raz v cache spolu s N-krát. A tento reťazec môže byť veľký, ak máte v tagoch a labels dlhé reťazce, ktoré tam rád vkladá Kubernetes.
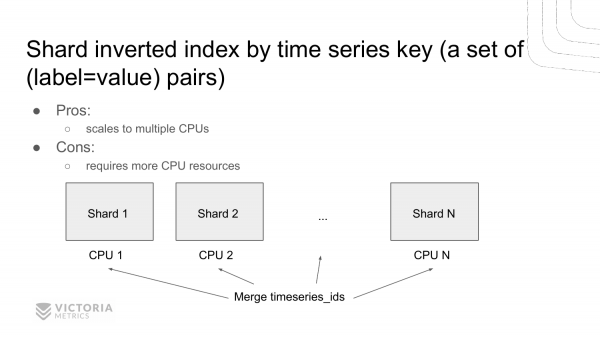
Ďalší spôsob, ako urýchliť vyhľadávanie v invertovanom indexe, je sharding. Vytvorenie niekoľkých invertovaných indexov namiesto jedného a shardovanie dát medzi nimi podľa kľúča. To je súbor key=value párov. T. j. získame niekoľko nezávislých invertovaných indexov, ktoré môžeme paralelne vyhľadávať na viacerých procesoroch. Predchádzajúce implementácie umožnili pracovať iba v jednoprocesorovom režime, t. j. skenovať dáta iba na jednom jadre. Toto riešenie umožňuje skenovať dáta okamžite na niekoľkých jadrách, ako to rád robí ClickHouse. To plánujeme realizovať.
A teraz sa vráťme k našim baranom - k funkcii prieniku timeseries_ids. Pozrime sa, aké môžu byť implementácie. Táto funkcia umožňuje nájsť timeseries_ids pre danú sadu label=value.
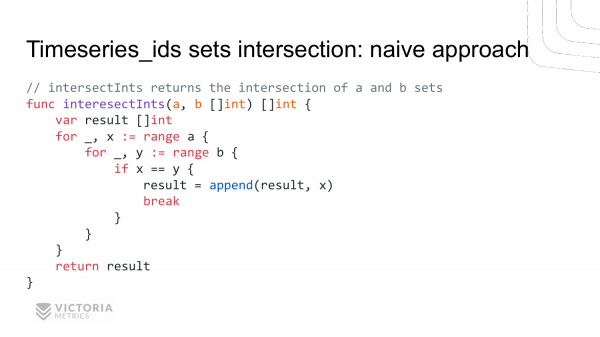
Prvá možnosť je naivná implementácia. Dva vnorené cykly. Takto získavame ako vstup pre funkciu intersectInts dve slices - a a b. Na výstupe by mal vrátiť prienik týchto slices.
Naivná implementácia vyzerá takto. Prejdeme všetkými hodnotami zo slice a, vnútri tohto cyklu prejdeme všetkými hodnotami slice b. A porovnáme ich. Ak sa zhodujú, znamená to, že sme našli prienik. A uložíme ho do result.
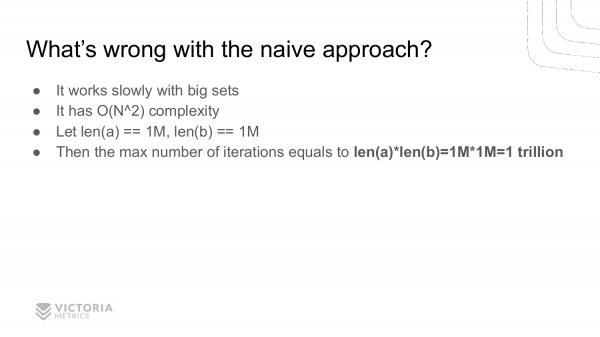
Aké sú nevýhody? Kvádratická zložitosť - to je jej hlavná nevýhoda. Napríklad, ak máte veľkosti slice a a b ak sa vrátite k jednému miliónu, táto funkcia vám nikdy nevráti odpoveď. Pretože bude musieť vykonať jeden bilión iterácií, čo je veľmi veľa aj pre moderné počítače.
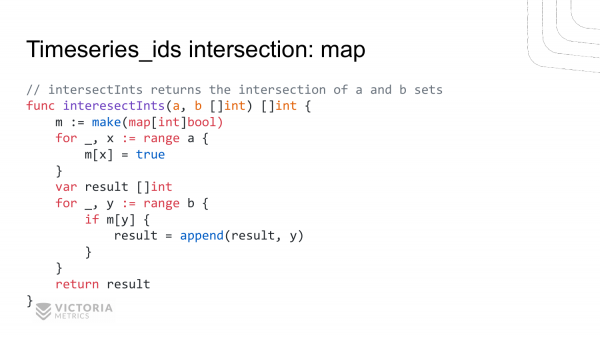
Druhá implementácia je založená na mape. Vytvoríme mapu. Uložíme do tejto mapy všetky hodnoty zo slice. a. Potom prejdeme samostatným cyklom cez slice. b. A kontrolujeme, či táto hodnota zo slice b existuje v mape. Ak áno, pridáme ju do výsledku.
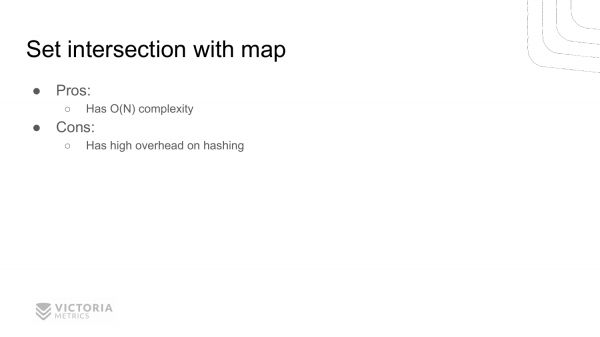
Aké sú výhody? Výhoda je v tom, že tu je len lineárna zložitosti. T. j. funkcia sa vykoná omnoho rýchlejšie pre veľké veľkosti slices. Pre miliónovú veľkosť slice sa táto funkcia vykoná za 2 milióny iterácií, na rozdiel od bilióna iterácií, ako v predchádzajúcej funkcii.
A nevýhodou je, že táto funkcia vyžaduje viac pamäte na vytvorenie tejto mapy.
Druhá nevýhoda – to je veľký overhead pri hashovaní. Táto nevýhoda nie je veľmi zrejmá. A pre nás to tiež nebolo veľmi zrejmé, pretože na začiatku v VictoriaMetrics bola implementácia intersection cez mapu. Ale potom profilovanie ukázalo, že väčšina procesorového času sa trávi na zapisovaní do mapy a na kontrole prítomnosti hodnoty v tejto mape.
Prečo sa na týchto miestach trávi procesorový čas? Pretože v týchto riadkoch Go vykonáva operáciu hashovania. T. j. počíta hash z kľúča, aby sa mohol potom odkazovať na daný index v HashMap. Operácia výpočtu hashu sa vykonáva za desatiny nanosekúnd. To je pomalé pre VictoriaMetrics.
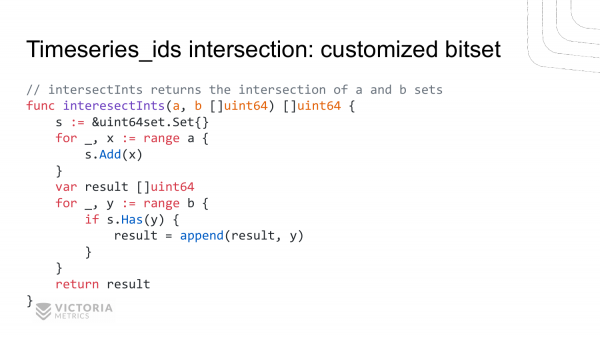
Rozhodol som sa implementovať bitset, optimalizovaný špeciálne pre tento prípad. Takto teraz vyzerá prekrývanie dvoch slices. Tu vytvoríme bitset. Pridáme do neho prvky z prvého slice. Potom kontrolujeme prítomnosť týchto prvkov v druhom slice. A pridávame ich do výsledku. T. j. takmer sa to nelíši od predchádzajúceho príkladu. Jediné, čo sme tu nahradili, je prístup k mape vlastnými funkciami add a has.
Na prvý pohľad sa zdá, že to musí byť pomalšie, ak predtým bola použitá štandardná mapa a teraz sa volajú nejaké funkcie, ale profilovanie ukazuje, že táto vec pracuje 10-krát rýchlejšie ako štandardná mapa pre prípad s VictoriaMetrics.
Okrem toho využíva oveľa menej pamäte v porovnaní s implementáciou na mape. Pretože tu uchovávame bity namiesto osembajtových hodnôt.
Nevýhodou takejto realizácie je, že nie je taká zrejmá, nie triviálna.
Ďalšia nevýhoda, ktorú si mnohí nemusia všimnúť – je to, že táto realizácia môže zle fungovať v niektorých prípadoch. T. j. je optimalizovaná pre konkrétny prípad, pre tento prípad prekrývania ids časových radov VictoriaMetrics. To neznamená, že bude vyhovovať všetkým prípadom. Ak sa použije nesprávne, môžeme získať nie nárast výkonu, ale out of memory error a spomalenie výkonu.
Zvážme realizáciu tejto štruktúry. Ak chcete nazrieť, nachádza sa v zdrojových kódoch VictoriaMetrics, v priečinku . Je optimalizovaná presne pre prípad VictoriaMetrics, kde timeseries_id je 64-bitová hodnota, kde prvých 32 bitov je väčšinou konštantných a menia sa len posledné 32 bity.
Táto dátová štruktúra sa neukladá na disk, pracuje len v pamäti.
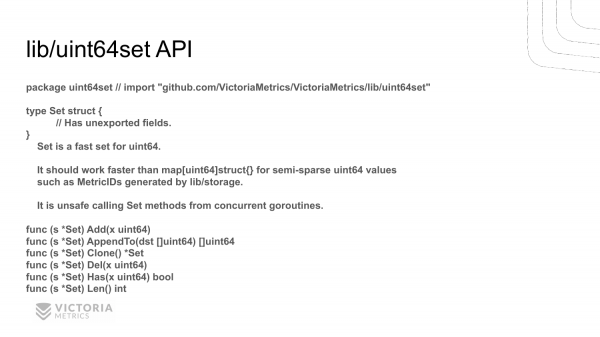
Tu je jej API. Nie je veľmi zložitá. API je prispôsobené presne pre konkrétny príklad použitia VictoriaMetrics. T. j. tu nie sú zbytočné funkcie. Tu sú funkcie, ktoré jasne používa VictoriaMetrics.
Sú tu funkcie add, ktorá pridáva nové hodnoty. Je tu funkcia has, ktorá kontroluje nové hodnoty. A je tu funkcia del, ktorá odstraňuje hodnoty. Je tu pomocná funkcia len, ktorá vracia veľkosť množiny. Funkcia klon klonuje množinu. A funkcia appendto prevádza túto množinu na slice timeseries_ids.
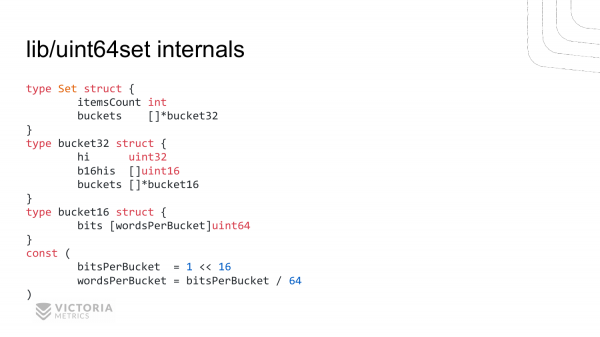
Tu je, ako vyzerá realizácia tejto dátovej štruktúry. V set je dva prvky:
ItemsCount– je to pomocné pole, aby rýchlo vrátil počet prvkov v set. Mohli by sme sa bez tohto pomocného poľa obísť, ale museli sme ho pridať, pretože VictoriaMetrics často zisťuje v svojich algoritmoch dĺžku bitset.Druhé pole – je to
buckets. To je slice zo štruktúrybucket32. V každej štruktúre sa uchovávahipole. To sú horné 32 bity. A dva slice –b16hisabucketszbucket16štruktúr.
Toto uchováva horných 16 bitov druhej časti 64-bitovej štruktúry. A tu sú bitsety pre mladších 16 bitov každého bajtu.
Bucket64 sa skladá z poľa uint64. Dĺžka sa vypočíta pomocou týchto konštánt. V jednom bucket16 maximálne môže byť uložených 2^16=65536 bitov. Ak to vydelíme 8, je to 8 kilobajtov. Ak to vydelíme znova 8, je to 1000 uint64 hodnotu. T. j. Bucket16 – to je pre nás 8-kilobajtová štruktúra.
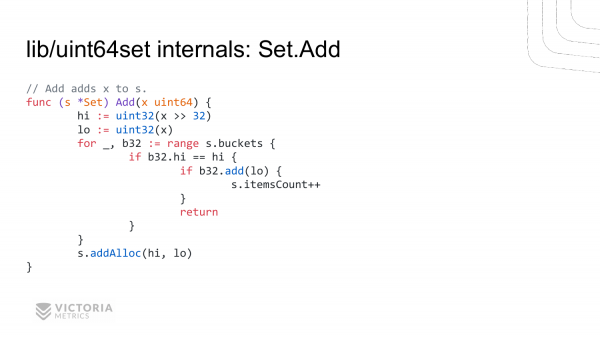
Pozrime sa, ako je implementovaná jedna z metód štruktúry na pridanie novej hodnoty.
Všetko začína s uint64 hodnotou. Vypočítame horných 32 bitov, vypočítame dolných 32 bitov. Prejdeme všetkými buckets. Porovnáme horných 32 bitov v každom bucket s pridávanou hodnotou. A ak sa zhodujú, zavoláme funkciu add v štruktúre b32 buckets. A pridáme tam dolných 32 bitov. A ak to vrátilo true, znamená to, že sme pridali takú hodnotu a takú hodnotu sme ešte nemali. Ak vráti nepravda, taká hodnota už existovala. Potom zvýšime počet prvkov v štruktúre.
Ak sme nenašli potrebný bucket s potrebným hi-hodnotou, potom zavoláme funkciu addAlloc, ktorá pridelení nový bucket, pridávajúc ho do bucket-štruktúry.
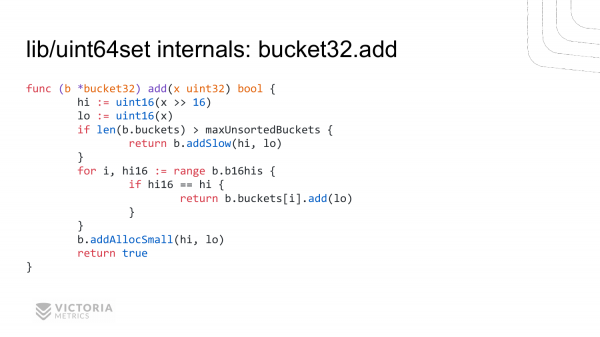
Toto je implementácia funkcie b32.add. Je podobná predchádzajúcej implementácii. Vypočítame horných 16 bitov, dolných 16 bitov.
Potom prejdeme všetkými hornými 16 bitmi. Nájdeme zhody. A pri zhodách zavoláme metódu add, ktorú preskúmame na nasledujúcej stránke pre bucket16.
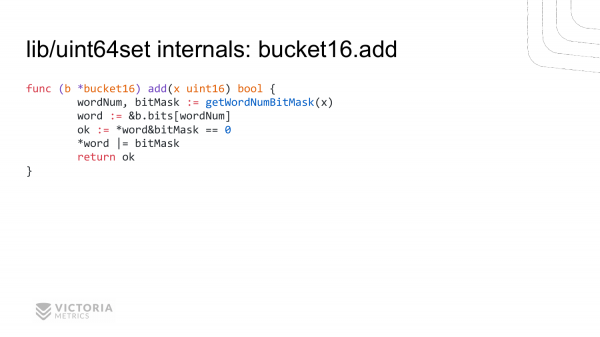
A tu je najnižšia úroveň, ktorá musí byť maximálne optimalizovaná. Vypočítavame pre uint64 id hodnotu v slice biti, ako aj bitmask. Toto je maska pre danú 64-bitovú hodnotu, podľa ktorej môžeme skontrolovať prítomnosť tohto bitu, alebo ho nastaviť. Kontrolujeme prítomnosť tohto bitu, ak je nastavený, nastavujeme ho a vraciame prítomnosť. Takáto realizácia nám umožnila zrýchliť operáciu prieniku ids časových radov 10-násobne v porovnaní s bežnými mapami.
Vo VictoriaMetrics okrem tejto optimalizácie existuje množstvo ďalších optimalizácií. Väčšina z týchto optimalizácií bola pridaná nie náhodne, ale po profilovaní kódu v produkcii.
Toto je hlavné pravidlo optimalizácie – nepridávať optimalizáciu, predpokladajúc, že tu bude úzke miesto, pretože sa môže ukázať, že tam úzke miesto nie je. Optimalizácia zvyčajne zhoršuje kvalitu kódu. Preto je dobré optimalizovať len po profilovaní a ideálne v produkcii, aby to boli reálne dáta. Kto má záujem, môže sa pozrieť na zdroje VictoriaMetrics a preskúmať ďalšie optimalizácie, ktoré tam sú.
Mám otázku o bitset. Veľmi to pripomína implementáciu C++ vector bool, optimalizovaný bitset. Vzali ste implementáciu odtiaľ?
Nie, to nie je odtiaľ. Pri realizácii tohto bitsetu som sa orientoval na znalosti štruktúry týchto ids timeseries, ktoré sa používajú vo VictoriaMetrics. Ich štruktúra je taká, že horných 32 bitov je väčšinou konštantných. Dolných 32 bitov sa môže meniť. Čím nižší bit, tým častejšie sa môže meniť. Preto je táto implementácia optimalizovaná práve pre túto štruktúru dát. Implementácia v C++, pokiaľ viem, je optimalizovaná pre všeobecný prípad. Ak sa robí optimalizácia pre všeobecný prípad, znamená to, že nebude najoptimálnejšia pre konkrétny prípad.
Odporúčam vám pozrieť si tiež prednášku Alexeja Milovida. Pred mesiacom hovoril o optimalizáciách v ClickHouse pre konkrétne špecializácie. Hovorí, že v bežnom prípade je implementácia v C++ alebo iná implementácia zameraná na dobrú prácu v priemere. Môže fungovať horšie ako špecializovaná implementácia pre konkrétne znalosti, ako máme my, keď vieme, že horných 32 bitov je väčšinou konštantných.
Mám druhú otázku. Aký je zásadný rozdiel od InfluxDB?
Zásadných rozdielov je mnoho. Ak hovoríme o výkonne a spotrebe pamäte, InfluxDB v testoch ukazuje desaťnásobne vyššiu spotrebu pamäte pre high cardinality časové rady, keď ich máte veľa, napríklad milióny. Napríklad, VictoriaMetrics spotrebuje 1 GB na milión aktívnych radov, zatiaľ čo InfluxDB pritom spotrebuje 10 Gb. A to je veľký rozdiel.
Druhý zásadný rozdiel spočíva v tom, že InfluxDB má zvláštne jazyky dopytov – Flux a InfluxQL. Nie sú príliš pohodlné na prácu s časovými radmi v porovnaní s , ktorý je podporovaný vo VictoriaMetrics. PromQL je jazyk dopytov z Prometheus.
A ešte jeden rozdiel – InfluxDB má trochu zvláštny model dát, kde v každom riadku môže byť uložených niekoľko fields s rôznymi sadami tagov. Tieto riadky sú ešte rozdelené na rôzne tabuľky. Tieto ďalšie zložitosti komplikujú následnú prácu s touto databázou. Je ťažké ju udržiavať a chápať.
Vo VictoriaMetrics je všetko oveľa jednoduchšie. Každý časový rad predstavuje kľúč-hodnota. Hodnota je súbor bodov – (timestamp, value), a kľúč je súbor label=value. Neexistuje žiadne rozdelenie na fields a measurements. To vám umožňuje vybrať akékoľvek údaje a následne ich kombinovať, sčítavať, odčítať, násobiť, deliť, na rozdiel od InfluxDB, kde výpočty medzi rôznymi radmi zatiaľ neboli implementované, pokiaľ viem. Ak boli implementované, sú zložité a treba napísať veľa kódu.
Mám doplňujúcu otázku. Správne som pochopil, že bola nejaká problém, o ktorom ste hovorili, že tento inverzný index sa nezmestí do pamäte, preto je tam partitioning?
Na začiatku som ukázal naivnú implementáciu inverzného indexu na štandardnej Go mape. Takáto implementácia nie je vhodná pre databázy, pretože tento inverzný index sa neukladá na disk, a databáza by mala ukladať na disk, aby tieto údaje zostali prístupné po reštarte. V tejto implementácii sa pri reštarte aplikácie váš inverzný index stratí. A prídete o prístup ku všetkým údajom, pretože ich nebudete schopní nájsť.
Dobrý deň! Ďakujem za prednášku! Volám sa Pavel. Som zo spoločnosti Wildberries. Mám na vás niekoľko otázok. Prvá otázka. Myslíte si, že keby ste si vybrali iný princíp pri budovaní architektúry vašej aplikácie a partitionovali údaje podľa času, tak by ste mohli robiť priesečné vyhľadávanie údajov, založené len na tom, že v jednej partition sú údaje za jeden časový úsek, t.j. za jeden časový interval a nemuseli by ste sa obávať, že máte kúsky roztrúsené rôzne? Druhá otázka — keďže implementujete takýto algoritmus s bitsetom a všetkým ostatným, možno ste sa snažili použiť inštrukcie procesora? Možno ste skúšali také optimalizácie?
Na druhú rovno odpoviem. Ešte sme sa k tomu nedostali. Ale ak to bude potrebné, dostaneme sa. A prvá otázka, aká bola?
Diskutovali ste o dvoch scenároch. A povedali ste, že ste si vybrali druhý s komplikovanejšou implementáciou. A neuprednostnili ste prvý, kde sú údaje partitionované podľa času.
Áno. V prvom prípade by bol celkový objem indexu väčší, pretože v každej partition by sme museli uchovávať duplicity údajov pre tie časové rady, ktoré prebiehajú cez všetky tieto partition. A ak máte nízku churn rate časových radov, t. j. neustále sa používajú rovnaké rady, v prvom prípade by sme oveľa viac stratili na obsadení diskového priestoru v porovnaní s druhým prípadom.
Takže – áno, časové partitionovanie je dobrá možnosť. Používa to aj Prometheus. Ale Prometheus má inú nevýhodu. Pri zlúčení týchto kusov údajov potrebujú uchovávať v pamäti meta-informácie o všetkých labeloch a časových radoch. Preto, ak sú kusy údajov veľké, ktoré zlúči, pamäťová spotreba pri zlúčení veľmi rastie, na rozdiel od VictoriaMetrics. Pri zlúčení VictoriaMetrics vôbec nepoužíva pamäť, tam sa spotrebováva len niekoľko kilobajtov, nezávisle od veľkostí zlúčených kusov údajov.
Algoritmus, ktorý máte, využíva pamäť. V nej sa označujú timeseries-štítky, na ktorých sú hodnoty. A takto kontrolujete prítomnosť v jednom dátovom poli a v druhom. A chápete – došlo k prieniku alebo nie. Zvyčajne v databázach implementujú kurzory, iterátory, ktoré uchovávajú svoj aktuálny stav a prechádzajú triedenými údajmi, čím máte jednoduchú zložitost' takýchto operácií.
Prečo nepoužívame kurzory na prienik údajov?
Áno.
Máme v LevelDB alebo v mergeset práve usporiadané riadky. Môžeme ísť kurzorom a nájsť prienik. A prečo ich nepoužívame? Pretože – je to pomalé. Pretože kurzory predpokladajú, že na každý riadok treba zavolať funkciu. Zavolanie funkcie trvá 5 nanosekúnd. A ak máte 100 000 000 riadkov, tak strácame pol sekundy len na volanie funkcie.
Takéto niečo existuje, áno. A moja posledná otázka. Otázka, možno, znie trochu čudne. Prečo v momente prichádzania údajov nie je možné počítať všetky potrebné agregáty a uchovávať ich v požadovanej forme? Prečo uchovávať obrovské objemy v nejakých systémoch ako VictoriaMetrics, ClickHouse a podobne, aby sme potom míňali veľa času na ne?
Príklad, ktorý objasní veci. Povedzme, ako funguje malý hračkársky rýchlomer? Zaznamenáva vzdialenosť, ktorú ste prešli, neustále ju sčíta s jednou hodnotou, druhou - časom. A delí. A dostáva priemernú rýchlosť. Robiť sa to dá podobne. Sčítať na cestách všetky potrebné fakty.
Dobre, rozumiem otázke. Váš príklad má svoje opodstatnenie. Ak viete, aké agregáty potrebujete, je to najlepšia realizácia. Problém je v tom, že ľudia ukladajú tieto metriky, nejaké dáta do ClickHouse a nevedia, ako ich v budúcnosti budú agregovať, filtrovať, preto musia uchovávať všetky surové dáta. Ale ak viete, že potrebujete vypočítať niečo priemerné, prečo to nevypočítať, namiesto toho, aby ste tam ukladali hromadu surových hodnôt? Ale len v prípade, že presne viete, čo potrebujete.
Mimochodom, databázy na uchovávanie časových radov podporujú počítanie agregátov. Napríklad, Prometheus podporuje . T. j. to sa dá urobiť, ak viete, aké agregáty budete potrebovať. V VictoriaMetrics to zatiaľ nie je, ale pred ňou sa zvyčajne inštaluje Prometheus, v ktorom to môžete urobiť v registračných pravidlách.
Napríklad, na predchádzajúcej práci sme potrebovali počítať počet udalostí v posúvacom okne za poslednú hodinu. Problém bol v tom, že sme museli vytvoriť vlastnú realizáciu v Go, t. j. službu na počítanie tejto veci. Táto služba bola nakoniec zložitá, pretože je ťažké to počítať. Realizácia môže byť jednoduchá, ak potrebujete počítať nejaké agregáty na pevných časových intervaloch. Ak chcete počítať udalosti v posúvacom okne, nie je to také jednoduché, ako sa zdá. Myslím, že to stále nie je implementované v ClickHouse alebo v bazách časových radov, pretože je to zložitá realizácia.
A ešte jedna otázka. Teraz sme hovorili o priemerní a spomenul som si, že kedysi existoval taký systém ako Graphite s backendom Carbon. A ten dokázal staré dáta zriediť, t. j. nechať jeden bod za minútu, jeden bod za hodinu atď. V podstate je to dosť praktické, ak potrebujeme surové dáta, povedzme za mesiac, a všetko ostatné môžeme riediť. Ale Prometheus a VictoriaMetrics túto funkčnosť nepodporujú. Je plánované jej zavedenie? Ak nie, prečo?
Ďakujeme za otázku. Naši používatelia sa často pýtajú, kedy pridáme podporu downsamplingu. Existuje niekoľko problémov. Po prvé, každý používateľ má na mysli downsampling niečo iné: niekto chce získať akýkoľvek bod v danom intervale, niekto chce maximálne, minimálne alebo priemerné hodnoty. Ak do vašej databázy ukladajú údaje rôzne systémy, nemožno ich spracovať rovnakým spôsobom. Môže sa stať, že pre každý systém bude potrebné použiť odlišný downsampling. A to je zložitá realizácia.
A druhá vec – VictoriaMetrics, rovnako ako ClickHouse, je optimalizovaná na prácu s veľkými objemami surových dát, takže dokáže spracovať miliardu riadkov za menej ako sekundu, ak máte vo svojom systéme veľa jadier. Skenovanie časových bodov vo VictoriaMetrics – 50 000 000 bodov za sekundu na jedno jadro. A táto výkonnosť sa škáluje na dostupné jadrá. T. j. ak máte 20 jadier, napríklad, skenovanie miliardy bodov za sekundu je možné. A táto vlastnosť VictoriaMetrics a ClickHouse znižuje potrebu downsamplingu.
Ďalšou vlastnosťou je, že VictoriaMetrics efektívne komprimuje tieto dáta. Priemerne dosiahne kompresiu od 0,4 do 0,8 bajtov na bod. Každý bod pozostáva z časovej pečiatky + hodnoty. A je komprimovaný na menej ako jeden bajt priemerne.
Sergej. Mám otázku. Aký je minimálny časový kvant zápisu?
Jedna milisekunda. Nedávno sme mali rozhovor s inými vývojármi databáz pre časové rady. Ich minimálny časový kvant je jedna sekunda. V Graphite, napríklad, tiež jedna sekunda. V OpenTSDB tiež jedna sekunda. V InfluxDB je presnosť na nanosekundu. Vo VictoriaMetrics je to jedna milisekunda, pretože v Prometheus je jedna milisekunda. A VictoriaMetrics bola vyvinutá ako externé úložisko pre Prometheus pôvodne. Ale teraz môže ukladať dáta aj z iných systémov.
Človek, s ktorým som hovoril, povedal, že ich presnosť je sekundová — to im stačí, pretože to závisí od typu údajov, ktoré sa ukladajú do databázy časových rád. Ak ide o DevOps údaje alebo údaje z infraštruktúry, kde ich zbierate s intervalom 30 sekúnd, za minútu, tak tam je sekundová presnosť dostatočná, menej už netreba. Ak však zbierate tieto údaje z high frequency trading systems, tam je potrebná presnosť na nanosekundu.
Milisekundová presnosť vo VictoriaMetrics je vhodná nielen pre DevOps prípady, ale môže byť vhodná aj pre väčšinu prípadov, ktoré som spomenul na začiatku prezentácie. Jediná vec, pre ktorú nemusí byť vhodná, sú systémy na obchodovanie s vysokou frekvenciou.
Ďakujem! A ešte jedna otázka. Aká je kompatibilita s PromQL?
Úplná spätná kompatibilita. VictoriaMetrics plne podporuje PromQL. Okrem toho pridáva aj ďalšiu rozšírenú funkčnosť do PromQL, ktorá sa nazýva . Čo sa týka tejto rozšírenej funkčnosti, existuje prezentácia na YouTube. O tom som rozprával na Monitoring Meetup na jar v Petrohrade.
Telegram kanál .
Len registrovaní používatelia sa môžu zúčastniť prieskumu. , prosím.
Čo vám bráni prejsť na VictoriaMetrics ako dlhodobé úložisko pre Prometheus? (Napíšte do komentárov, pridám to do prieskumu))
71,4%Nepoužívam Prometheus5
28,6%Nevedel som o VictoriaMetrics2
Hlasovalo 7 používateľov. Zdržalo sa 12 používateľov.
Zdroj: habr.com
