

Ahojte, Habráci. Tradične pokračujeme v zdieľaní zaujímavého materiálu pred začiatkom nových kurzov. Dnes sme pre vás posunuli článok o Google Cloud Spanner, ktorý súvisí so spustením kurzu. .
Pôvodne publikované na .
Ako spoločnosť, ktorá ponúka množstvo cloudových POS riešení pre maloobchodníkov, reštaurátorov a online predajcov po celom svete, Lightspeed používa niekoľko rôznych typov databázových platforiem pre množstvo transakčných, analytických a vyhľadávacích prípadov. Každá z týchto databázových platforiem má svoje silné a slabé stránky. Keď Google predstavil Cloud Spanner na trhu — s sľubnými funkciami, aké sme v oblasti relačných databáz ešte nevideli, ako takmer neobmedzená horizontálna škálovateľnosť a zmluva o úrovni služieb (SLA) na úrovni 99,999 % — nemohli sme si nechať ujsť príležitosť získať ho do našich rúk!
Aby sme poskytli komplexný prehľad našich skúseností s Cloud Spannerom, ako aj hodnotiacich kritérií, ktoré sme použili, pozrieme sa na nasledujúce témy:
- Naše kritériá hodnotenia
- Cloud Spanner v skratke
- Naša hodnotenie
- Naše závery
1. Naše kritériá hodnotenia
Predtým, ako sa podrobne zaoberáme funkciami Cloud Spanneru, jeho podobnosťami a rozdielmi s inými riešeniami na trhu, poďme najprv hovoriť o hlavných prípadoch použitia, ktoré sme zvažovali pri otázke, kde nasadiť Cloud Spanner v našej infraštruktúre:
- Ako náhrada (dominantného) tradičného riešenia databázy SQL
- Ako OLTP riešenie s podporou OLAP
Poznámka: Pre jednoduchosť a pohodlie porovnania, tento článok porovnáva Cloud Spanner s variantmi MySQL rodiny riešení GCP Cloud SQL a Amazon AWS RDS.
Používanie Cloud Spanner ako náhrady tradičného riešenia databázy SQL
V prostredí tradičných databáz, keď doba odozvy na dotaz v databáze prichádza blízko alebo dokonca presahuje predtým stanovené prahové hodnoty aplikácie (predovšetkým kvôli nárastu počtu používateľov a/alebo dopytov), existuje niekoľko spôsobov, ako znížiť dobu odozvy na prijateľné úrovne. Väčšina týchto riešení však zahŕňa manuálny zásah.
Napríklad, prvý krok, ktorý je potrebné urobiť, je pozrieť sa na rôzne parametre databázy súvisiace s výkonom a nastaviť ich tak, aby najlepšie vyhovovali vzorom používania aplikácií. Ak to nebude stačiť, môžete zvoliť vertikálne alebo horizontálne škálovanie databázy.
Vertikálne škálovanie aplikácie spočíva v aktualizácii inštancie servera, zvyčajne pridaním väčšieho počtu procesorov/jadier, väčšieho množstva operačnej pamäte, rýchlejšieho úložiska atď. Pridanie väčšieho množstva hardvérových zdrojov vedie k zvýšeniu výkonu databázy, ktorý sa meria najmä v transakciách za sekundu a oneskorení transakcií pre systémy OLTP. Systémy relačných databáz (ktoré používajú viacvláknový prístup), ako MySQL, sa dobre škálujú vertikálne.
Tento prístup má niekoľko nevýhod, ale najobviousnejšou je maximálna veľkosť servera na trhu. Akonáhle sa dosiahne limit najväčšej inštancie servera, ostáva jediná cesta: horizontálne škálovanie.
Horizontálne škálovanie je prístup, pri ktorom sa do klastra pridáva viac serverov, aby sa ideálne lineárne zvyšoval výkon s pridaním počtu serverov. Väčšina tradičných systémov databáz sa zle škáluje horizontálne alebo vôbec nie škáluje. Napríklad MySQL môže horizontálne škálovať pre operácie čítania pridaním slave-čitateľov, ale nemôže horizontálne škálovať pre operácie zápisu.
Na druhej strane, vďaka svojej povahe Cloud Spanner môže ľahko horizontálne škálovať s minimálnym zásahom.
Plne funkčný DBMS ako služba by mala byť hodnotená z rôznych uhlov. Ako základ sme vzali najpopulárnejšiu DBMS v cloude – pre Google, GCP Cloud SQL a pre Amazon, AWS RDS. V našej hodnotení sme sa zamerali na nasledujúce kategórie:
- Porovnanie vlastností: extensia SQL, DDL, DML; knižnice pripojení/konektory, podpora transakcií a tak ďalej.
- Podpora vývoja: jednoduchosť vývoja a testovania.
- Podpora správy: správa inštancií – napríklad škálovanie nahor/dolu a vylepšenie inštancií; SLA, zálohovanie a obnova; bezpečnosť/kontrola prístupu.
Použitie Cloud Spanner ako OLTP riešenia s podporou OLAP.
Hoci Google jasne neuvádza, že Cloud Spanner je určený na analytické spracovanie, delí sa o niektoré atribúty s inými mechanizmami, ako sú Apache Impala & Kudu a YugaByte, ktoré sú určené na OLAP pracovné zaťaženia.
Aj keby existovala len malá pravdepodobnosť, že Cloud Spanner obsahuje súladne horizontálne škálovateľný motor HTAP (hybridného transakčno/analytického spracovania) s (viac-menej) použiteľným setom funkcií OLAP, myslíme si, že by to stálo za našu pozornosť.
S týmto na pamäti sme zvážili nasledujúce kategórie:
- Načítanie dát, indexy a podpora partionovania.
- Výkon dotazov a DML.
2. Cloud Spanner v skratke.
Google Spanner je klastra systém riadenia relačných databáz (RDBMS), ktorý Google používa pre niektoré svoje vlastné služby. Google ho sprístupnil verejnosti pre používateľov Google Cloud Platform na začiatku roka 2017.
Tu sú niektoré z atribútov Cloud Spanner:
- Silne súladný škálovateľný klaster RDBMS: používa hardvérovú synchronizáciu času na zabezpečenie konzistencie dát.
- Podpora transakcií pre viaceré tabuľky: transakcie môžu pokrývať viacero tabuliek – nie sú obmedzené len na jednu tabuľku (na rozdiel od Apache HBase alebo Apache Kudu).
- Tabuľky na základe primárneho kľúča: všetky tabuľky musia mať deklarovaný primárny kľúč (PK), ktorý môže pozostávať z viacerých stĺpcov tabuľky. Tabuľkové dáta sú uložené v poradí PK, čo ich robí veľmi efektívnymi a rýchlymi na vyhľadávanie podľa PK. Rovnako ako iné systémy na báze PK, implementácia musí byť modelovaná s ohľadom na predom premyslené use-cases pre dosiahnutie .
- Striedavé tabuľky: tabuľky môžu mať fyzické závislosti jedna od druhej. Riadky podriadenej tabuľky môžu byť priradené k riadkom rodičovskej tabuľky. Tento prístup urýchľuje vyhľadávanie vzťahov, ktoré môžu byť definované počas fázy modelovania dát, napríklad pri spoločnom umiestnení klientov a ich faktúr.
- Indexy: Cloud Spanner podporuje sekundárne indexy. Index sa skladá z indexovaných stĺpcov a všetkých stĺpcov PK. Ak si to prajete, index môže tiež obsahovať iné neinexované stĺpce. Index môže byť striedavý s rodičovskou tabuľkou na urýchlenie dopytov. Na indexy sa vzťahuje niekoľko obmedzení, ako napríklad maximálny počet ďalších stĺpcov, ktoré sa uchovávajú v indexe. Tiež dopyty cez indexy nemusia byť také priamočiare ako v iných RDBMS.
„Cloud Spanner automaticky vyberá index iba vo zriedkavých prípadoch. Najmä Cloud Spanner automaticky nevyberá sekundárny index, ak dopyt požaduje akékoľvek stĺpce, ktoré nie sú uložené v ».
- Služobná úroveň zmluvy (SLA): nasadenie v jednom regióne so SLA 99,99%; viacregionálne nasadenia so SLA 99,999%. Hoci samotná služobná úroveň zmluvy je len dohodou, nie zárukou, verím, že zamestnanci Googlu majú skutočne presné údaje, aby mohli urobiť také vážne tvrdenie. (Pre referenciu, 99,999% znamená 26,3 sekundy nedostupnosti služby mesačne.)
- Viac:
Poznámka: Projekt Apache Tephra pridáva rozšírenú podporu transakcií v Apache HBase (teraz je implementovaný aj v Apache Phoenix ako beta verzia).
Naša predpoveď
Čítali sme všetky vyhlásenia Googlu o výhodách Cloud Spanner — prakticky neobmedzené horizontálne škálovanie pri zachovaní vysokej konzistencie a veľmi vysokého SLA. Hoci tieto požiadavky sú vo všetkých prípadoch mimoriadne ťažké dosiahnuť, naším cieľom nebolo ich vyvrátiť. Namiesto toho sa zamerajme na iné veci, ktoré znepokojujú väčšinu používateľov databáz: presnosť a použiteľnosť.
Ohodnotili sme Cloud Spanner ako náhradu za Sharded MySQL
Google Cloud SQL a Amazon AWS RDS, dve najpopulárnejšie OLTP DBMS na cloudovom trhu, majú veľmi širokú škálu funkcií. Ak však chcete škálovať tieto databázy za hranice jedného uzla, musíte vykonávať rozdelenie aplikácií. Tento prístup vytvára dodatočnú zložitost ako pre aplikácie, tak aj pre administratívu. Prezreli sme si, ako sa Spanner zapadá do scenára kombinovania niekoľkých segmentov do jedného inštancie a aké funkcie (ak existujú) možno bude potrebné obetovať.
Podpora SQL, DML a DDL, ako aj konektor a knižnice?
Po prvé, pri spúšťaní s akoukoľvek databázou je potrebné vytvoriť model údajov. Ak si myslíte, že môžete pripojiť JDBC Spanner k svojmu obľúbenému nástroju SQL, zistíte, že môžete dotazovať svoje údaje pomocou neho, ale nemôžete ho použiť na vytváranie tabuliek alebo na zmeny (DDL) alebo akékoľvek operácie vkladania/aktualizovania/odstraňovania (DML). Oficiálny JDBC od Google nepodporuje ani to, ani to.
„V súčasnosti ovládače nepodporujú príkazy DML ani DDL.“
Dokumentácia Spanner
So systémom GCP to nie je lepšie — môžete posielať len SELECT dotazy. Našťastie existuje JDBC ovládač s podporou DML a DDL od komunity, vrátane transakcií. . Hoci je tento ovládač mimoriadne užitočný, absencia vlastného JDBC ovládača od Google prekvapuje. Našťastie Google ponúka pomerne širokú podporu klientskych knižníc (na báze gRPC): C#, Go, Java, node.js, PHP, Python a Ruby.
Takmer povinné používanie vlastných API Cloud Spanner (kvôli absencii DDL a DML v JDBC) vedie k určitým obmedzeniam pre príbuzné oblasti kódu, ako sú pooly pripojení alebo rámce na prepojenie databází (napr. Spring MVC). Vo všeobecnosti pri používaní JDBC môžete voľne vyberať svoj obľúbený pool pripojení (napr. HikariCP, DBCP, C3PO atď.), ktorý bol testovaný a funguje dobre. V prípade vlastných API Spanner musíme spoliehať na rámce/pooly na prepojenie/sesie, ktoré sme vytvorili sami.
Konštrukcia zameraná na primárny kľúč (PK) umožňuje Cloud Spanner veľmi rýchly prístup k údajom prostredníctvom PK, ale vedie aj k určitým problémom s dotazmi.
- Nemôžete aktualizovať hodnotu primárneho kľúča; najskôr musíte odstrániť záznam s pôvodným PK a znova ho vložiť s novou hodnotou. (To je podobné iným databázam orientovaným na PK/úložným mechanizmom.)
- Akékoľvek operácie UPDATE a DELETE musia uvádzať PK v WHERE, preto nemôžu byť prázdne operátory DELETE all — vždy musí byť poddotaz, napríklad: UPDATE xxx WHERE id IN (SELECT id FROM table1)
- Chýbajúca možnosť auto-increment alebo niečo podobné, čo určuje sekvenciu pre pole PK. Aby to fungovalo, príslušná hodnota musí byť vytvorená na strane aplikácie.
Sekundárne indexy?
Google Cloud Spanner má zabudovanú podporu sekundárnych indexov. Je to veľmi príjemná vlastnosť, ktorá nie vždy prichádza v iných technológiách. Apache Kudu v súčasnosti vo všeobecnosti nepodporuje sekundárne indexy a Apache HBase ich nepodporuje priamo, ale môže ich pridávať prostredníctvom Apache Phoenix.
Indexy v Kudu a HBase môžu byť modelované ako samostatná tabuľka s rôznymi zložením primárnych kľúčov, avšak atómnosť operácií vykonaných s rodičovskou tabuľkou a prislúchajúcimi indexovými tabuľkami musí byť vykonávaná na úrovni aplikácie a nie je triviálna v správnej implementácii.
Ako bolo uvedené v prehľade Cloud Spanner, jeho indexy sa môžu líšiť od indexov MySQL. Preto je potrebné zachovať osobitnú opatrnosť pri zostavovaní dopytov a profilovaní, aby sa zabezpečilo využitie správneho indexu tam, kde je to potrebné.
Pohľady?
Veľmi populárny a užitočný objekt v databáze — pohľady. Môžu byť užitočné pre množstvo prípady použitia; dva moje obľúbené sú úroveň logickej abstrakcie a úroveň bezpečnosti. Bohužiaľ, Cloud Spanner NEpodporuje pohľady. To však nás len čiastočne obmedzuje, pretože na úroveň prístupových práv nie je podrobnosť na úrovni stĺpcov, kde by mohli byť pohľady prijateľným riešením.
V dokumentácii Cloud Spanner v časti, ktorá podrobne popisuje kvóty a obmedzenia (), existuje jedna, která může být problémová pro některé aplikace: Cloud Spanner má z výroby omezení na maximálně 100 databází na instance. To může být vážnou překážkou pro databázi, která má být škálována na více než 100 databází. Naštěstí jsme po rozhovoru s naším technickým zástupcem Google zjistili, že tento limit může být prakticky zvýšen na jakoukoli hodnotu prostřednictvím podpory Google.
Podpora vývoje?
Cloud Spanner nabízí docela slušnou podporu programovacích jazyků pro práci s jeho API. Oficiálně podporované knihovny zahrnují C#, Go, Java, node.js, PHP, Python a Ruby. Dokumentace je dostatečně podrobná, ale jako u jiných pokročilých technologií je komunita poměrně malá ve srovnání s nejoblíbenějšími databázovými technologiemi, což může vést ke zvýšení času stráveného řešením méně běžných případů použití nebo problémů.
Jak je to ale s podporou lokálního vývoje?
Nenašli jsme způsob, jak vytvořit instance Cloud Spanner v lokálním prostředí. To nejblíže, co jsme dostali — Docker obraz, , což je v zásadě podobné, ale v praxi se velmi liší. Například CockroachDB může používat PostgreSQL JDBC. Protože by mělo být vývojové prostředí co nejblíže pracovnímu prostředí, Cloud Spanner není ideální, protože se musí spoléhat na plnou instanci Spanner. Pro snížení nákladů můžete zvolit instanci pro jeden region.
Podpora správy?
Vytvoření instance Cloud Spanner je velmi jednoduché. Stačí si vybrat mezi vytvořením multiregionální nebo instance pro jeden region, uvést region(y) a počet uzlů. Během méně než minuty bude instance spuštěna a připravena k práci.
Některé základní metriky jsou přímo dostupné na stránce Spanner v konzoli Google. Podrobnější pohledy jsou dostupné prostřednictvím Stackdriveru, kde si také můžete nastavit prahové hodnoty metrik a pravidla upozornění.
Přístup k prostředkům?
MySQL ponúka rozsiahle a veľmi podrobné nastavenia oprávnení/úloh používateľov. Prístup k určitej tabuľke alebo dokonca len k podmnožine jej stĺpcov je možné jednoduché nastaviť. Cloud Spanner používa nástroj Google Identity & Access Management (IAM), ktorý umožňuje nastavovanie politík a oprávnení len na veľmi vysokej úrovni. Najpodrobnejšou možnosťou je oprávnenie na úrovni databázy, ktoré sa nezapadá do väčšiny produkčných prípadov. Toto obmedzenie vás núti pridávať ďalšie bezpečnostné opatrenia do vášho kódu, infraštruktúry alebo oboch, aby ste predišli neoprávnenému používaniu zdrojov Spanner.
Zálohy?
Jednoducho povedané, zálohy v Cloud Spanner neexistujú. Hoci vysoké požiadavky Google SLA môžu zaručiť, že nestratíte žiadne dáta kvôli poruchám hardvéru alebo databázy, od ľudských chýb, defektov aplikácií atď. Všetci poznáme pravidlo: vysoká dostupnosť nenahrádza rozumnú stratégiu zálohovania. V súčasnosti je jediným spôsobom zálohovania dát softvérový prenos ich z databázy do samostatného úložiska.
Výkon dotazov?
Na načítanie dát a testovanie dotazov sme použili Yahoo! Cloud Serving Benchmark. V tabuľke nižšie je zobrazená pracovná záťaž B YCSB s pomerom čítania 95% a zápisu 5%.
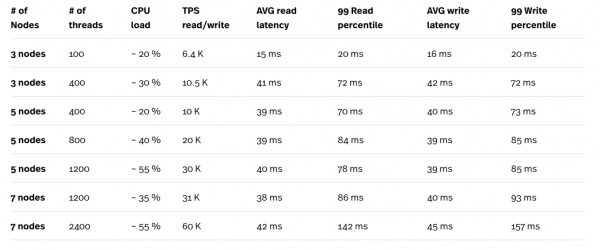
* Záťažový test bol vykonaný na výpočtovom engíne (CE) n1-standard-32 (32 vCPU, 120 GB pamäte) a testovací inštanc nikdy nebol úzkym miestom v testoch.
** Maximálny počet vlákien v jednom inštancii YCSB je 400. Celkovo bolo potrebné spustiť šesť paralelných inštancií YCSB testov, aby sa dosiahlo celkovo 2400 vlákien.
Pri pohľade na výsledky testovania, najmä kombináciu zaťaženia procesora a TPS, jasne vidíme, že Cloud Spanner sa dobre škáluje. Vysoké zaťaženie vytvorené množstvom vlákien je vyvážené vysokým počtom uzlov v clustri Cloud Spanner. Hoci oneskorenie sa zdá byť pomerne vysoké, najmä pri práci s 2400 vláknami, na získanie presnejších čísel môže byť potrebné opakované testovanie s 6 menšími inštanciami výpočtového motora. Každá inštancia bude spúšťať jeden test YCSB namiesto jednej veľkej inštancie CE so 6 paralelnými testami. Takto bude jednoduchšie rozlíšiť oneskorenia požiadaviek Cloud Spanner a oneskorenia pridané sieťovým pripojením medzi Cloud Spanner a inštanciou CE, na ktorej sa test vykonáva.
Ako Cloud Spanner zvláda OLAP?
Partitioning?
Rozdelenie údajov na fyzicky a/alebo logicky nezávislé segmenty, nazývané partition, je veľmi populárny koncept, ktorý sa vyskytuje vo väčšine mechanizmov OLAP. Partitiony môžu výrazne zlepšiť výkon dotazov a udržiavateľnosť databázy. Podrobnejšie skúmanie partition by vyžadovalo samostatný článok, preto len spomenieme dôležitosť existencie schémy partition a sub-partition. Možnosť rozdeliť údaje na partition a ešte ďalej na subpartition je kľúčom k výkonu analytických dotazov.
Cloud Spanner nepodporuje partitiony ako také. Rozdeľuje údaje vo vnútri na tzv. split-y na základe rozsahov primárneho kľúča. Rozdelenie prebieha automaticky na vyváženie zaťaženia v clustri Cloud Spanner. Veľmi užitočná funkcia Cloud Spanner je rozdelenie základného zaťaženia rodičovskej tabuľky (tabuľky, ktorá sa nechá prekladať s inými). Spanner automaticky zistí, či obsahuje split údaje, ktoré sú čítané častejšie ako údaje v iných split-ách, a môže sa rozhodnúť o ďalšom rozdelení. Týmto spôsobom môže byť zapojených viac uzlov, čo takisto efektívne zvyšuje priepustnosť.
Nahrávanie údajov?
Spôsob Cloud Spanner pre objemné dáta je rovnaký ako pri bežnom nahrávaní. Pre dosiahnutie maximálneho výkonu je potrebné dodržiavať niektoré odporúčania, vrátane:
- Usporiadajte vaše dáta podľa primárneho kľúča.
- Rozdeľte ich na 10*počet uzlov samostatných sekcií.
- Vytvorte súbor pracovných úloh, ktoré nahrávajú dáta paralelne.
Pri takomto nahrávaní dát sa využívajú všetky uzly Cloud Spanner.
Použili sme záťaž A YCSB na generovanie súboru dát zo 10M riadkov.
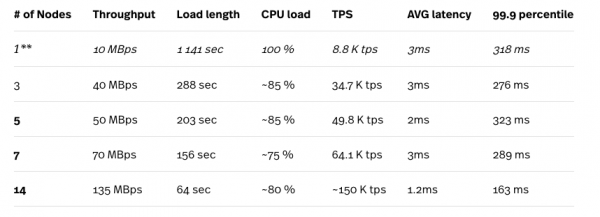
* Záťažový test bol vykonaný na výpočtovom engine n1-standard-32 (32 vCPU, 120 GB pamäte), a testovací inštancia nikdy nebola úzkym miestom v testoch.
** Nastavenie z 1 uzla sa neodporúča pre žiadnu produkčnú záťaž.
Ako bolo uvedené vyššie, Cloud Spanner automaticky spracováva rozdelenia v závislosti od ich zaťaženia, preto sa výsledky zlepšujú po niekoľkých po sebe idúcich opakovaniach testu. Výsledky uvedené tu sú najlepšie výsledky, ktoré sme získali. Pri pohľade na čísla vyššie, môžeme vidieť, ako Cloud Spanner (dobré) škáluje s rastúcim počtom uzlov v klastri. Čísla, ktoré vynikajú, predstavujú extrémne nízke priemerné latencie, ktoré kontrastujú s výsledkami zmiešaných pracovných záťaží (95 % na čítanie a 5 % na zápis), ako je popísané v predchádzajúcej časti.
Škálovanie?
Zvyšovanie a znižovanie počtu uzlov Cloud Spanner je úloha, ktorá sa vykonáva jedným kliknutím. Ak chcete rýchlo nahrávať dáta, môžete zvážiť zvyšovanie inštancie na maximum (v našom prípade to bolo 25 uzlov v regióne US-EAST), a potom znížiť počet uzlov na úroveň, ktorá vyhovuje vašej bežnej záťaži, po nahratí všetkých dát do databázy, pričom majte na pamäti obmedzenie 2 TB/uzol.
Dokonca sme si pripomenuli toto obmedzenie aj s oveľa menšou databázou. Po niekoľkých behaniach záťažových testov mala naša databáza veľkosť približne 155 GB, a pri znižovaní na inštanciu z 1 uzla sme dostali nasledujúcu chybu:
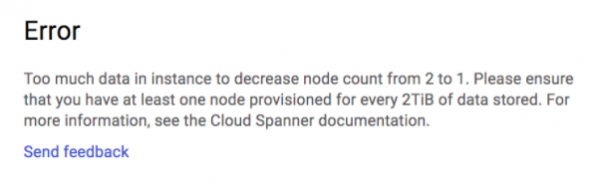
Podarilo sa nám znížiť škálu z 25 na 2 inštancie, ale uviazli sme pri dvoch uzloch.
Zvýšenie a zníženie počtu uzlov v clustre Cloud Spanner je možné automatizovať pomocou REST API. To môže byť obzvlášť užitočné na zníženie zvýšenej záťaže na systéme počas rušných hodín.
Výkon OLAP dotazov?
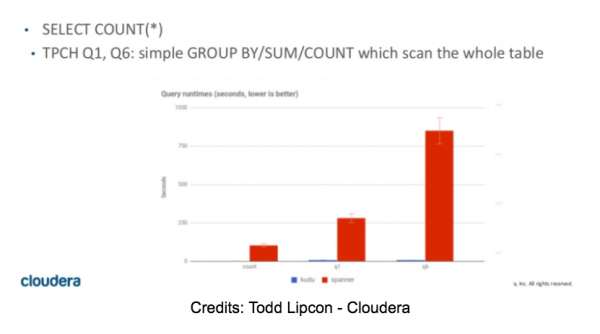
Pôvodne sme plánovali venovať značný čas našej hodnotení Spanneru tejto časti. Po niekoľkých SELECT COUNT sme okamžite pochopili, že testovanie bude krátke a že Spanner NIE JE vhodným OLAP motorom. Nezáleží na počte uzlov v clustre, jednoduchý výber počtu riadkov v tabuľke s 10M riadkami trval od 55 do 60 sekúnd. Okrem toho akýkoľvek dotaz, ktorý si vyžadoval väčší objem pamäte na ukladanie medzi výsledkov, skončil s chybou OOM.
SELECT COUNT(DISTINCT(field0)) FROM usertable; — (10M distinct values) -> SpoolingHashAggregateIterator vyčerpal pamäť počas nového riadku.
Niektoré čísla pre TPC-H dotazy možno nájsť v článku Todda Lipkóna , snímky 42 a 43. Tieto čísla sú v súlade s našimi vlastnými výsledkami (žiaľ).
4. Naše zistenia
Vzhľadom na súčasný stav funkcií Cloud Spanner je ťažké predstaviť si jeho jednoduchú náhradu za existujúce OLTP riešenie, najmä keď vaše potreby prevyšujú jeho možnosti. Bolo by potrebné vynaložiť značné množstvo času na vybudovanie riešenia zohľadňujúceho nedostatky Cloud Spanner.
Keď sme začali hodnotiť Cloud Spanner, očakávali sme, že jeho funkcie riadenia budú na úrovni alebo aspoň nie tak vzdialené od iných riešení Google SQL. Ale boli sme prekvapení úplným nedostatkom záloh a veľmi obmedzenou kontrolou prístupu k zdrojom. Nehovoriac o absencii pohľadov, absencii miestneho vývojového prostredia, nepodporovaných sekvenciách, JDBC bez podpory DML a DDL a tak ďalej.
Čo teda robiť, ak potrebujete škálovať transakčnú databázu? Zdá sa, že na trhu zatiaľ neexistuje jediné riešenie, ktoré by vyhovovalo všetkým možnostiam použitia. Existuje množstvo riešení s uzavretým a otvoreným zdrojovým kódom (niektoré z nich sú spomenuté v tomto článku), z ktorých každé má svoje silné a slabé stránky, ale žiadne z nich nenabízajú SaaS s SLA 99,999% a vysokou úrovňou konzistencie. Ak je vysoká úroveň SLA vaším hlavným cieľom a nie ste naklonení vybudovať vlastné riešenie pre viaceré cloudové prostredia, Cloud Spanner by mohlo byť riešením, ktoré hľadáte. Musíte však byť oboznámení so všetkými jeho obmedzeniami.
Na spravodlivosť treba poznamenať, že Cloud Spanner bol sprístupnený pre verejnosť iba na jar 2017, preto je rozumné očakávať, že niektoré jeho súčasné nedostatky by mohli nakoniec zmiznúť (dúfajme), a keď sa to stane, môže to zmeniť pravidlá hry. Napokon, Cloud Spanner nie je len vedľajší projekt pre Google. Google ho používa ako základ pre iné produkty Google. A keď Google nedávno nahradil Megastore v Google Cloud Storage Cloud Spannerom, umožnilo to Google Cloud Storage stať sa prísne konzistentným pre zoznamy objektov na celosvetovej úrovni (čo sa stále netýka ).
Takže nádej stále existuje… dúfame.
Na tomto konci. Rovnako ako autor článku, aj my naďalej dúfame, a čo si o tom myslíte vy? Napíšte do komentárov
Všetkých záujemcov srdečne pozývame na našu v rámci ktorej podrobne rozprávame o kurze od OTUS.
Zdroj: habr.com
