

Predslov alebo ako vznikla myšlienka sekcionovania
Začiatok príbehu je tu: Potom, čo boli takmer všetky zdroje na optimalizáciu dopytu, v tom čase, vyčerpané, sa objavila otázka — a čo ďalej? Tak sa zrodila myšlienka o sekcionovaní.
Lyrické odbočenie:
Práve „v tom čase“, pretože . Ďakujem a Habr !
Takže, ako ešte môžete spraviť zákazníka akoby šťastným a zároveň si zlepšiť svoje zručnosti?
Ak to všetko maximálne zjednodušíme, tak, možností, ako niečo radikálne zlepšiť v rýchlosti databázy, je len niekoľko:
1) Externý spôsob — zvyšujeme zdroje, meníme konfiguráciu;
2) Intenzívny spôsob — optimalizácia dopytov
Preto, opakujem, v tom čase už nebolo jasné, čo ešte zmeniť v dopyte na urýchlenie, bola zvolená cesta — zmien dizajnu tabuliek.
Takže — vzniká hlavná otázka — čo a ako budeme meniť?
Počiatočné podmienky
Po prvé, existuje takáto ERD (zobrazené podmienečne jednoducho):
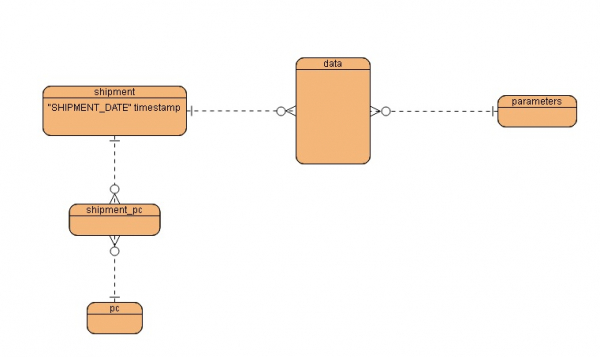
Hlavné vlastnosti:
- vzťahy „mnoho k mnohým“
- tabuľka už má potenciálny kľúč na sekcionovanie
Počiatočný dopyt:
SELECT
            p."PARAMETER_ID" as  parameter_id,
            pc."PC_NAME" AS pc_name,
            pc."CUSTOMER_PARTNUMBER" AS customer_partnumber,
            w."LASERMARK" AS lasermark,
            w."LOTID" AS lotid,
            w."REPORTED_VALUE" AS reported_value,
            w."LOWER_SPEC_LIMIT" AS lower_spec_limit,
            w."UPPER_SPEC_LIMIT" AS upper_spec_limit,
            p."TYPE_CALCUL" AS type_calcul,
            s."SHIPMENT_NAME" AS shipment_name,
            s."SHIPMENT_DATE" AS shipment_date,
            extract(year from s."SHIPMENT_DATE") AS year,
            extract(month from s."SHIPMENT_DATE") as month,
            s."REPORT_NAME" AS report_name,
            p."SPARAM_NAME" AS SPARAM_name,
            p."CUSTOMERPARAM_NAME" AS customerparam_name
        FROM data w INNER JOIN shipment s ON s."SHIPMENT_ID" = w."SHIPMENT_ID"
             INNER JOIN parameters p ON p."PARAMETER_ID" = w."PARAMETER_ID"
             INNER JOIN shipment_pc sp ON s."SHIPMENT_ID" = sp."SHIPMENT_ID"
             INNER JOIN pc pc ON pc."PC_ID" = sp."PC_ID"
             INNER JOIN ( SELECT w2."LASERMARK" , MAX(s2."SHIPMENT_DATE") AS "SHIPMENT_DATE"
                          FROM shipment s2 INNER JOIN data w2 ON s2."SHIPMENT_ID" = w2."SHIPMENT_ID"
                          GROUP BY w2."LASERMARK"
                         ) md ON md."SHIPMENT_DATE" = s."SHIPMENT_DATE" AND md."LASERMARK" = w."LASERMARK"
        WHERE
             s."SHIPMENT_DATE" >= '2018-07-01' AND s."SHIPMENT_DATE" <= '2018-09-30' ;
Výsledky vykonania na testovacej databáze:
Náklady : 502 997.55
Čas vykonania: 505 sekúnd.
Čo vidíme? Bežný dotaz na časovom reze.
Robíme najjednoduchšie logické predpoklady: ak existuje výber časového rezu, pomôže nám? Správne — sekcionovanie.
Čo sekcionovať?
Na prvý pohľad je výber zrejmý — deklaratívne sekcionovanie tabuľky „shipment“ podľa kľúča „SHIPMENT_DATE“ (prebiehajúc veľmi dopredu — nakoniec v produkcii to bolo trochu inak).
Ako sekcionovať?
Túto otázku nie je príliš ťažké zodpovedať. Navyše, v PostgreSQL 10 je teraz priateľský mechanizmus sekcionovania.
Takže:
- Uložíme dump pôvodnej tabuľky — pg_dump source_table
- Odstránime pôvodnú tabuľku — drop table source_table
- Vytvoríme rodičovskú tabuľku so sekcionovaním podľa rozsahu — create table source_table
- Vytvoríme sekcie — create table source_table, create index
- Importujeme dump vytvorený v kroku 1 — pg_restore
Skripty pre sekcionovanie
Pre jednoduchosť a pohodlie boli kroky 2,3,4 zjednotené do jedného skriptu.
Takže:
Uložíme dump pôvodnej tabuľky
pg_dump postgres --file=\/dump\/shipment.dmp --format=c --table=shipment --verbose > \/dump\/shipment.log 2>&1Odstránime pôvodnú tabuľku + Vytvoríme rodičovskú tabuľku so sekcionovaním podľa rozsahu + Vytvoríme sekcie
--create_partition_shipment.sql
do language plpgsql $$
declare
rec_shipment_date RECORD ;
partition_name varchar;
index_name varchar;
current_year varchar ;
current_month varchar ;
begin_year varchar ;
begin_month varchar ;
next_year varchar ;
next_month varchar ;
first_flag boolean ;
i integer ;
begin
  RAISE NOTICE 'VYTVÁŘENIE DOČASNÉ TABUĽKY PRE DÁTUM DODANIA';
  CREATE TEMP TABLE tmp_shipment_date as select distinct "SHIPMENT_DATE" from shipment order by "SHIPMENT_DATE" ;

  RAISE NOTICE 'ODSTRAŇTE TABUĽKU shipment';
  drop table shipment cascade ;

  CREATE TABLE public.shipment
  (
    "SHIPMENT_ID" integer NOT NULL DEFAULT nextval('shipment_shipment_id_seq'::regclass),
    "SHIPMENT_NAME" character varying(30) COLLATE pg_catalog."default",
    "SHIPMENT_DATE" timestamp without time zone,
    "REPORT_NAME" character varying(40) COLLATE pg_catalog."default"
  )
  PARTITION BY RANGE ("SHIPMENT_DATE")
  WITH (
      OIDS = FALSE
  )
  TABLESPACE pg_default;

  RAISE NOTICE 'TVORBA PARTÍCIÍ PRE TABUĽKU shipment';

  current_year:='0';
  current_month:='0';

  begin_year := '0' ;
  begin_month := '0'  ;
  next_year := '0' ;
  next_month := '0'  ;

  FOR rec_shipment_date IN SELECT * FROM tmp_shipment_date LOOP

      RAISE NOTICE 'SHIPMENT_DATE=%',rec_shipment_date."SHIPMENT_DATE";

      current_year := date_part('year' ,rec_shipment_date."SHIPMENT_DATE");
      current_month := date_part('month' ,rec_shipment_date."SHIPMENT_DATE") ;

      IF to_number(current_month,'99') = to_date( begin_year||'.'||begin_month, 'YYYY.MM') AND
         to_date( current_year||'.'||current_month, 'YYYY.MM') < to_date( next_year||'.'||next_month, 'YYYY.MM') AND
         NOT first_flag
      THEN
         CONTINUE ;
      ELSE
       --NOVÉ hranice iba pre druhý a ďalšíkrát
       begin_year := current_year ;
       begin_month := current_month ;

        IF current_month = '12' THEN
          next_year := date_part('year' ,rec_shipment_date."SHIPMENT_DATE" + interval '1 year') ;
        ELSE
          next_year := current_year ;
        END IF;

       next_month := date_part('month' ,rec_shipment_date."SHIPMENT_DATE" + interval '1 month') ;

      END IF;

      partition_name := 'shipment_shipment_date_'||begin_year||'-'||begin_month||'-01-'|| next_year||'-'||next_month||'-01'  ;

     EXECUTE format('CREATE TABLE ' || quote_ident(partition_name) || ' PARTITION OF shipment FOR VALUES FROM ( %L ) TO ( %L )  ' , current_year||'-'||current_month||'-01' , next_year||'-'||next_month||'-01'  ) ;

      index_name := partition_name||'_shipment_id_idx';
      RAISE NOTICE 'NÁZOV INDEXU =%',index_name;
      EXECUTE format('CREATE INDEX ' || quote_ident(index_name) || ' ON '|| quote_ident(partition_name) ||' USING btree ("SHIPMENT_ID") TABLESPACE pg_default ' ) ;

      --Zrušiť vlajku prvého času
      first_flag := false ;

  END LOOP;

end
$$;
Importujeme dump
pg_restore -d postgres --data-only --format=c --table=shipment --verbose shipment.dmp > /tmp/data_dump/shipment_restore.log 2>&1Kontrolujeme výsledky sekvenovania
Čo teda máme ako výsledok? Úplný text plánu vykonania je dlhý a nudný, a preto stačí obmedziť sa na konečné čísla.
Bolo
Náklady: 502 997.55
Čas vykonania: 505 sekúnd.
Stalo
Náklady: 77 872.36
Čas vykonania: 79 sekúnd.
Celkom dobrý výsledok. Znížili sme náklady a čas vykonania. Takže používanie sekcionovania prináša očakávaný efekt a celkovo — bez prekvapení.
Potešiť zákazníka
Výsledky testovania boli predložené zákazníkovi na posúdenie. A po oboznámení im bol vydaný niekoľko prekvapivý verdikt: „Vynikajúco, sekcionujte tabuľku ‚data‘.“
Áno, ale my sme skúmali úplne inú tabuľku ‚shipment‘, tabuľka ‚data‘ nemá pole ‚SHIPMENT_DATE‘.
Nie je problém, pridávajte, menťe. Hlavné je, aby zákazníka uspokojilo, čo výsledok prinesie, detaily realizácie nie sú až tak dôležité.
Sekcionujeme hlavnú tabuľku ‚data‘
V podstate nevznikli žiadne zvláštne ťažkosti. Aj keď sa algoritmus sekcionovania síce trochu zmenil.
Pridávame stĺpec ‚SHIPMENT_DATA‘ do tabuľky ‚data‘
psql -h host -U databáza -d užívateľ
=> ALTER TABLE data ADD COLUMN "SHIPMENT_DATE" timestamp without time zone ;
Vyplníme hodnoty stĺpca ‚SHIPMENT_DATA‘ v tabuľke ‚data‘ hodnotami rovnomenného stĺpca z tabuľky ‚shipment‘
-----------------------------
--update_data.sql
--aktualizácia pre upravenú tabuľku ‚data‘ na hodnoty ‚shipment_data‘ z tabuľky ‚shipment‘
--verzia 1.0
do language plpgsql $$
declare
rec_shipment_data RECORD ;
shipment_date timestamp without time zone ;
row_count integer ;
total_rows integer ;
begin

  select count(*) into total_rows from shipment ;
  RAISE NOTICE 'Celkový %',total_rows;
  row_count:= 0 ;

  FOR rec_shipment_data IN SELECT * FROM shipment LOOP

   update data set "SHIPMENT_DATE" = rec_shipment_data."SHIPMENT_DATE" where "SHIPMENT_ID" = rec_shipment_data."SHIPMENT_ID";

   row_count:=  row_count +1 ;
   RAISE NOTICE 'počet riadkov = % , z %',row_count,total_rows;
  END LOOP;

end
$$;
Ukladáme dump tabuľky ‚data‘
pg_dump postgres --file=\/dump\/data.dmp --format=c --table=data --verbose > \/dump\/data.log 2>&1<\/sourceZnovu vytvárame sekcionovanú tabuľku ‚data‘
--create_partition_data.sql
--vytvoriť partition pre tabuľku "wafer data" podľa rozsahu stĺpca "shipment_data" s trvaním jeden mesiac
--verzia 1.0
do language plpgsql $$
declare
rec_shipment_date RECORD ;
partition_name varchar;
index_name varchar;
current_year varchar ;
current_month varchar ;
begin_year varchar ;
begin_month varchar ;
next_year varchar ;
next_month varchar ;
first_flag boolean ;
i integer ;

begin

  RAISE NOTICE 'VYTVORTE DOČASNÚ TABUĽKU PRE SHIPMENT_DATE';
  CREATE TEMP TABLE tmp_shipment_date as select distinct "SHIPMENT_DATE" from shipment order by "SHIPMENT_DATE" ;

  RAISE NOTICE 'ZMAZAŤ TABUĽKU data';
  drop table data cascade ;

  RAISE NOTICE 'VYTVORIŤ PARTITIONOVANÚ TABUĽKU data';

  CREATE TABLE public.data
  (
    "RUN_ID" integer,
    "LASERMARK" character varying(20) COLLATE pg_catalog."default" NOT NULL,
    "LOTID" character varying(80) COLLATE pg_catalog."default",
    "SHIPMENT_ID" integer NOT NULL,
    "PARAMETER_ID" integer NOT NULL,
    "INTERNAL_VALUE" character varying(75) COLLATE pg_catalog."default",
    "REPORTED_VALUE" character varying(75) COLLATE pg_catalog."default",
    "LOWER_SPEC_LIMIT" numeric,
    "UPPER_SPEC_LIMIT" numeric ,
    "SHIPMENT_DATE" timestamp without time zone
  )
  PARTITION BY RANGE ("SHIPMENT_DATE")
  WITH (
    OIDS = FALSE
  )
  TABLESPACE pg_default ;

  RAISE NOTICE 'VYTVORIŤ PARTÍCIE PRE TABUĽKU data';

  current_year:='0';
  current_month:='0';

  begin_year := '0' ;
  begin_month := '0'  ;
  next_year := '0' ;
  next_month := '0'  ;
  i := 1;

  FOR rec_shipment_date IN SELECT * FROM tmp_shipment_date LOOP

      RAISE NOTICE 'SHIPMENT_DATE=%',rec_shipment_date."SHIPMENT_DATE";

      current_year := date_part('year' ,rec_shipment_date."SHIPMENT_DATE");
      current_month := date_part('month' ,rec_shipment_date."SHIPMENT_DATE") ;

      --Inicializovať hranice
      IF   begin_year = '0' THEN
       RAISE NOTICE '***Inicializovať hranice';
       first_flag := true ; --prvýkrát flag
       begin_year := current_year ;
       begin_month := current_month ;

        IF current_month = '12' THEN
          next_year := date_part('year' ,rec_shipment_date."SHIPMENT_DATE" + interval '1 year') ;
        ELSE
          next_year := current_year ;
        END IF;

       next_month := date_part('month' ,rec_shipment_date."SHIPMENT_DATE" + interval '1 month') ;

      END IF;

      RAISE NOTICE 'Aktuálne dáta = %',to_char( to_date( current_year||'.'||current_month, 'YYYY.MM'), 'YYYY.MM');
      RAISE NOTICE 'Začínajúce dáta = %',to_char( to_date( begin_year||'.'||begin_month, 'YYYY.MM'), 'YYYY.MM');
      RAISE NOTICE 'Ďalšie dáta = %',to_char( to_date( next_year||'.'||next_month, 'YYYY.MM'), 'YYYY.MM');

      IF to_date( current_year||'.'||current_month, 'YYYY.MM') >= to_date( begin_year||'.'||begin_month, 'YYYY.MM') AND
         to_date( current_year||'.'||current_month, 'YYYY.MM') < to_date( next_year||'.'||next_month, 'YYYY.MM') AND
         NOT first_flag
      THEN
         RAISE NOTICE '***POKRAČOVAŤ';
         CONTINUE ;
      ELSE
       --NOVÉ hranice len pre druhý a ďalšíkrát
       RAISE NOTICE '***NOVÉ HRANICE';
       begin_year := current_year ;
       begin_month := current_month ;

        IF current_month = '12' THEN
          next_year := date_part('year' ,rec_shipment_date."SHIPMENT_DATE" + interval '1 year') ;
        ELSE
          next_year := current_year ;
        END IF;

       next_month := date_part('month' ,rec_shipment_date."SHIPMENT_DATE" + interval '1 month') ;

      END IF;

      IF to_number(current_month,'99') < 10 THEN
        current_month := '0'||current_month ;
      END IF ;

      IF to_number(begin_month,'99') < 10 THEN
        begin_month := '0'||begin_month ;
      END IF ;

      IF to_number(next_month,'99') < 10 THEN
        next_month := '0'||next_month ;
      END IF ;

      RAISE NOTICE 'current_year=% , current_month=% ',current_year,current_month;
      RAISE NOTICE 'begin_year=% , begin_month=% ',begin_year,begin_month;
      RAISE NOTICE 'next_year=% , next_month=% ',next_year,next_month;

      partition_name := 'data_'||begin_year||begin_month||'01_'||next_year||next_month||'01'  ;

      RAISE NOTICE 'ČÍSLO PARTÍCIE % , NÁZOV TABUĽKY =%',i , partition_name;

      EXECUTE format('VYTVORIŤ TABUĽKU ' || quote_ident(partition_name) || ' PARTITION OF data FOR VALUES FROM ( %L ) TO ( %L )  ' , begin_year||'-'||begin_month||'-01' , next_year||'-'||next_month||'-01'  ) ;

      index_name := partition_name||'_shipment_id_parameter_id_idx';
      RAISE NOTICE 'NÁZOV INDEXU =%',index_name;
      EXECUTE format('VYTVORIŤ INDEX ' || quote_ident(index_name) || ' ON '|| quote_ident(partition_name) ||' USING btree ("SHIPMENT_ID", "PARAMETER_ID") TABLESPACE pg_default ' ) ;

      index_name := partition_name||'_lasermark_idx';
      RAISE NOTICE 'NÁZOV INDEXU =%',index_name;
      EXECUTE format('VYTVORIŤ INDEX ' || quote_ident(index_name) || ' ON '|| quote_ident(partition_name) ||' USING btree ("LASERMARK" COLLATE pg_catalog."default") TABLESPACE pg_default ' ) ;

      index_name := partition_name||'_shipment_id_idx';
      RAISE NOTICE 'NÁZOV INDEXU =%',index_name;
      EXECUTE format('VYTVORIŤ INDEX ' || quote_ident(index_name) || ' ON '|| quote_ident(partition_name) ||' USING btree ("SHIPMENT_ID") TABLESPACE pg_default ' ) ;

      index_name := partition_name||'_parameter_id_idx';
      RAISE NOTICE 'NÁZOV INDEXU =%',index_name;
      EXECUTE format('VYTVORIŤ INDEX ' || quote_ident(index_name) || ' ON '|| quote_ident(partition_name) ||' USING btree ("PARAMETER_ID") TABLESPACE pg_default ' ) ;

      index_name := partition_name||'_shipment_date_idx';
      RAISE NOTICE 'NÁZOV INDEXU =%',index_name;
      EXECUTE format('VYTVORIŤ INDEX ' || quote_ident(index_name) || ' ON '|| quote_ident(partition_name) ||' USING btree ("SHIPMENT_DATE") TABLESPACE pg_default ' ) ;

      --Zrušiť prvýkrát flag
      first_flag := false ;

  END LOOP;
end
$$;
Nahrávame dump vytvorený v kroku 3.
pg_restore -h host -užívateľ -d databáza --data-only --format=c --table=data --verbose data.dmp > data_restore.log 2>&1Vytvárame samostatnú sekciu pre staré údaje
---------------------------------------------------
--create_partition_for_old_dates.sql
--vytvoriť oddiely na uchovávanie starých dát
--verzia 1.0
do language plpgsql $$
declare
rec_shipment_date RECORD;
partition_name varchar;
index_name varchar;

begin

      SELECT min("SHIPMENT_DATE") AS min_date INTO rec_shipment_date from data;

      RAISE NOTICE 'Starý dátum je %', rec_shipment_date.min_date;

      partition_name := 'data_old_dates';

      RAISE NOTICE 'NÁZOV ODDIELU JE %', partition_name;

      EXECUTE format('CREATE TABLE ' || quote_ident(partition_name) || ' PARTITION OF data FOR VALUES FROM ( %L ) TO ( %L )  ', '1900-01-01',
              to_char(rec_shipment_date.min_date, 'YYYY') || '-' || to_char(rec_shipment_date.min_date, 'MM') || '-01');

      index_name := partition_name || '_shipment_id_parameter_id_idx';
      EXECUTE format('CREATE INDEX ' || quote_ident(index_name) || ' ON ' || quote_ident(partition_name) || ' USING btree ("SHIPMENT_ID", "PARAMETER_ID") TABLESPACE pg_default');

      index_name := partition_name || '_lasermark_idx';
      EXECUTE format('CREATE INDEX ' || quote_ident(index_name) || ' ON ' || quote_ident(partition_name) || ' USING btree ("LASERMARK" COLLATE pg_catalog."default") TABLESPACE pg_default');

      index_name := partition_name || '_shipment_id_idx';
      EXECUTE format('CREATE INDEX ' || quote_ident(index_name) || ' ON ' || quote_ident(partition_name) || ' USING btree ("SHIPMENT_ID") TABLESPACE pg_default');

      index_name := partition_name || '_parameter_id_idx';
      EXECUTE format('CREATE INDEX ' || quote_ident(index_name) || ' ON ' || quote_ident(partition_name) || ' USING btree ("PARAMETER_ID") TABLESPACE pg_default');

      index_name := partition_name || '_shipment_date_idx';
      EXECUTE format('CREATE INDEX ' || quote_ident(index_name) || ' ON ' || quote_ident(partition_name) || ' USING btree ("SHIPMENT_DATE") TABLESPACE pg_default');

end
$$;
Konečné výsledky:
Bolo
Náklady: 502 997.55
Čas vykonania: 505 sekúnd.
Stalo
Náklady: 68 533.70
Čas vykonania: 69 sekúnd
Zaslúžené, úplne zaslúžené. A vzhľadom na to, že sa po ceste podarilo aspoň trocha zvládnuť mechanizmus rozdelenia v PostgreSQL 10 — Skvelý výsledok.
Lyrické odbočenie
Môžeme to ešte vylepšiť — ÁNO, MÔŽEME!Na to potrebujeme použiť MATERIALIZED VIEW.
CREATE MATERIALIZED VIEW LASERMARK_VIEW
CREATE MATERIALIZED VIEW LASERMARK_VIEW
AS
SELECT w."LASERMARK", MAX(s."SHIPMENT_DATE") AS "SHIPMENT_DATE"
FROM shipment s INNER JOIN data w ON s."SHIPMENT_ID" = w."SHIPMENT_ID"
GROUP BY w."LASERMARK";

CREATE INDEX lasermark_vw_shipment_date_ind on lasermark_view USING btree ("SHIPMENT_DATE") TABLESPACE pg_default;
analyze lasermark_view;
Opäť prepisujeme dotaz:
Dotaz s využitím materialized view
VYBERTE
            p."PARAMETER_ID" ako parameter_id,
            pc."PC_NAME" ako pc_name,
            pc."CUSTOMER_PARTNUMBER" ako customer_partnumber,
            w."LASERMARK" ako lasermark,
            w."LOTID" ako lotid,
            w."REPORTED_VALUE" ako reported_value,
            w."LOWER_SPEC_LIMIT" ako lower_spec_limit,
            w."UPPER_SPEC_LIMIT" ako upper_spec_limit,
            p."TYPE_CALCUL" ako type_calcul,
            s."SHIPMENT_NAME" ako shipment_name,
            s."SHIPMENT_DATE" ako shipment_date,
            extract(year from s."SHIPMENT_DATE") ako year,
            extract(month from s."SHIPMENT_DATE") ako month,
            s."REPORT_NAME" ako report_name,
            p."STC_NAME" ako STC_name,
            p."CUSTOMERPARAM_NAME" ako customerparam_name
        Z data w INNER JOIN shipment s NA s."SHIPMENT_ID" = w."SHIPMENT_ID"
             INNER JOIN parameters p NA p."PARAMETER_ID" = w."PARAMETER_ID"
             INNER JOIN shipment_pc sp NA s."SHIPMENT_ID" = sp."SHIPMENT_ID"
             INNER JOIN pc pc NA pc."PC_ID" = sp."PC_ID"
             INNER JOIN LASERMARK_VIEW md NA md."SHIPMENT_DATE" = s."SHIPMENT_DATE" A md."LASERMARK" = w."LASERMARK"
        KDE
              s."SHIPMENT_DATE" >= '2018-07-01' A s."SHIPMENT_DATE" <= '2018-09-30';
A dostávame ďalší výsledok:
Bolo
Náklady: 502 997.55
Čas vykonania: 505 sekúnd
Stalo
Náklady: 42 481.16
Čas vykonania: 43 sekundy.
Hoci samozrejme, tak prísľubný výsledok je zavádzajúci, predstavy treba obnoviť. Takže konečný čas na získanie dát predsa len veľmi nepomôže. Ale ako experiment je to celkom zaujímavé.
V skutočnosti sa ukázalo, že ešte raz ďakujem a Habr-u !-
Pósledok
Takže, zákazník je spokojný. A je potrebné využiť situáciu.
Nová úloha: Čo možno vymyslieť, aby sme sa prehĺbili a rozšírili?
A tu si spomínam — chlapci, veď nemáme monitorovanie našich databáz PostgreSQL.
S rúk na srdce, nejaké monitorovanie vo forme Cloud Watch na AWS predsa len existuje. Ale aký zmysel má toto monitorovanie pre DBA? V podstate žiadny.
Ak sa naskytla šanca urobiť niečo užitočné a zaujímavé aj pre seba, nemôžeš takúto šancu nevyužiť …
PRETO
Takto sme sa dostali k najzaujímavejšiemu:
3. decembra 2018.
Rozhodnutie o začiatku prác na preskúmaní dostupných možností monitorovania výkonu dopytov PostgreSQL.
Ale to už je úplne iný príbeh.
Pokračovanie, nasleduje…
Zdroj: habr.com
