

26. februára sme usporiadali meetup Apache Ignite GreenSource, kde vystupovali kontribútori open source projektu . Dôležitou udalosťou v živote tejto komunity bola prestavba komponentu , ktorý umožňuje nasadiť používateľské microservices priamo v klasteri Ignite. O tomto náročnom procese na meetupe hovoril , softvérový inžinier a už viac ako dva roky kontribútor Apache Ignite.
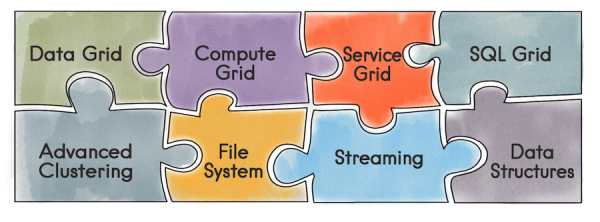
Začneme s tým, čo vlastne Apache Ignite je. Je to databáza, ktorá predstavuje distribuované Key/Value úložisko s podporou SQL, transakčnosti a caching. Okrem toho, Ignite umožňuje nasadiť používateľské služby priamo v klasteri Ignite. Vývojárovi sú k dispozícii všetky nástroje, ktoré Ignite ponúka — distribuované dátové štruktúry, Messaging, Streaming, Compute a Data Grid. Napríklad, pri použití Data Grid odpadá problém správy samostatnej infraštruktúry pre úložisko dát a, ako dôsledok, s tým spojené náklady.
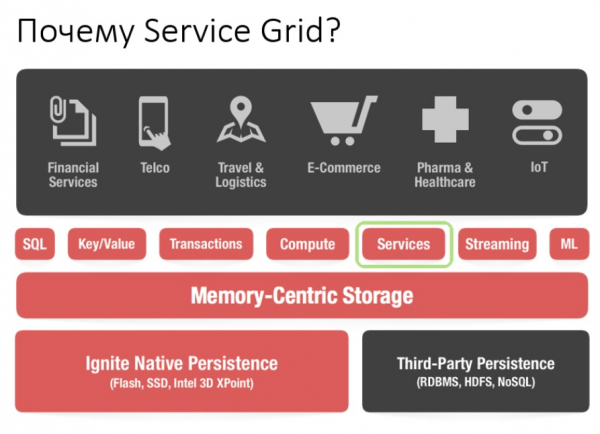
Použitím API Service Grid je možné nasadiť službu, ak jednoducho uvediete v konfigurácii schému nasadenia a, samozrejme, samotnú službu.
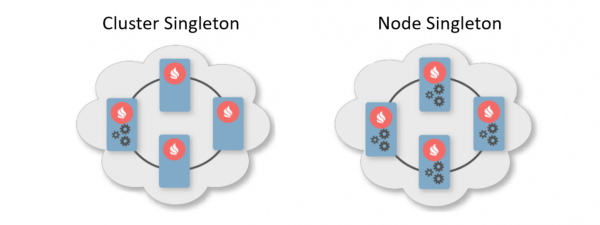
Obvykle je schéma nasadenia — to je určenie počtu inštancií, ktoré by mali byť nasadené na uzloch klastera. Existujú dve typické schémy nasadenia. Prvá — je Cluster Singleton: v akomkoľvek okamihu bude v klastere zaručene dostupný jeden exemplár používateľskej služby. Druhá — je Node Singleton: na každom uzle klastera je nasadený jeden exemplár služby.
Používateľ môže tiež určiť počet inštancií služby v celom klasteri a definovať predikát na filtrovanie vhodných uzlov. Pri takomto scenári Service Grid sám vypočíta optimálne rozdelenie pre nasadenie služieb.
Okrem toho existuje funkcia nazývaná Affinity Service. Affinity je funkcia, ktorá určuje vzťah medzi kľúčmi a partíciami a vzťah medzi partíciami a uzlami v topológii. Na základe kľúča je možné určiť primárny uzol, na ktorom sú uložené dáta. Takto je možné asociovať vašu vlastnú službu s kľúčom a cache affinity-funkcie. V prípade zmeny affinity-funkcie dôjde k automatickému redeployu. Služba bude vždy umiestnená blízko s dátami, s ktorými má manipulovať, a tým pádom zníži náklady na prístup k informáciám. Takýto model môžeme nazvať akýmsi kolokovaným výpočtom.
Teraz, keď sme rozobrali, v čom spočíva krása Service Grid, rozprávame o jeho histórii vývoja.
Čo bolo predtým
Predchádzajúca implementácia Service Grid bola založená na transakčne replikovanom systémovom cache Ignite. Pod slovom „cache“ v Ignite sa rozumie úložisko. To znamená, že to nie je nič dočasné, ako by sa mohlo zdať. Napriek tomu, že cache je replikovateľný a každý uzol obsahuje celý súbor dát, vo vnútri má cache partitioned zobrazenie. To súvisí s optimalizáciou úložísk.
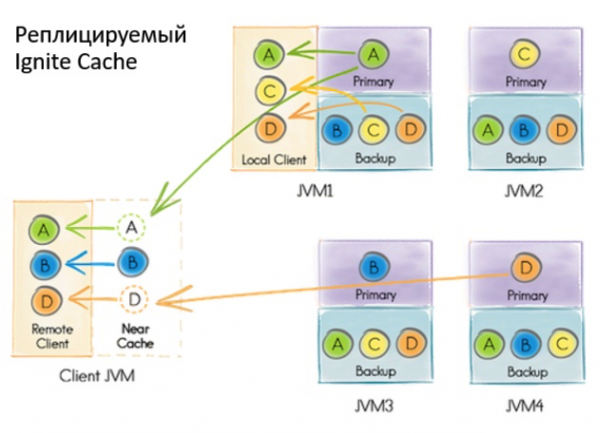
Čo sa stalo, keď chcel používateľ nasadiť službu?
- Všetky uzly v clustri sa prihlásili na aktualizáciu dát v úložisku prostredníctvom vstavaného mechanizmu Continuous Query.
- Uzol-initiátor pod read-committed transakciou vykonal v databáze zápis, ktorý obsahoval konfiguráciu služby, vrátane serializovanej inštancie.
- Pri prijatí oznámenia o novej zápise koordinátor vypočítal rozdelenie na základe konfigurácie. Získaný objekt bol zapísaný späť do databázy.
- Ak uzol vstupil do rozdelenia, koordinátor ho musel nasadiť.
Čo nás neuspokojovalo
V istom momente sme dospeli k záveru, že takto sa s službami pracovať nedá. Dôvodov bolo niekoľko.
Ak počas nasadenia došlo k nejakej chybe, mohla sa zistiť len z logov toho uzla, kde k tomu došlo. Existoval len asynchrónny deployment, takže po vrátení používateľskej kontroly od metódy deploymentu bolo potrebné nejaké dodatočné časové obdobie na štart služby — a v tomto čase používateľ nemohol nič spravovať. Aby sme mohli ďalej rozvíjať Service Grid, pridávať nové funkcie, priťahovať nových používateľov a zjednodušovať život všetkým, bolo potrebné niečo zmeniť.
Pri návrhu novej Service Grid sme predovšetkým chceli zabezpečiť záruku synchronného nasadenia: akonáhle sa používateľovi vráti kontrola od API, okamžite môže využívať služby. Taktiež sme chceli dať iniciátorovi možnosť spracovávať chyby nasadenia.
Okrem toho sme chceli zjednodušiť implementáciu, a to tak, aby sme sa vyhli transakciám a rebalance. Napriek tomu, že cache je replikovaná a vyváženie chýba, počas veľkého nasadenia s množstvom uzlov vznikali problémy. Pri zmene topológie musia uzly vymieňať informácie a pri veľkom nasadení môžu byť tieto dáta veľmi veľké.
Keď bola topológia nestabilná, koordinátor musel prepočítavať rozloženie služieb. A vo všeobecnosti, keď sa pracuje s transakciami v nestabilej topológii, môže to viesť k ťažko predvídateľným chybám.
Problémy
Aké globálne zmeny by boli bez sprievodných problémov? Prvým z nich bola zmena topológie. Je potrebné pochopiť, že v ktoromkoľvek momente, aj v čase nasadenia služby, môže uzol vstúpiť do klastru alebo z neho vystúpiť. Navyše, ak uzol vstúpi do klastru v čase nasadenia, bude potrebné konzistentne preniesť všetky informácie o službách do nového uzla. A hovoríme nielen o tom, čo už bolo nasadené, ale aj o aktuálnych a budúcich nasadeniach.
To je len jeden z problémov, ktoré môžeme zhromaždiť do samostatného zoznamu:
- Ako nasadiť staticky nakonfigurované služby pri štarte uzla?
- Vystúpenie uzla z klastru – čo robiť, ak uzol hostil služby?
- Čo robiť, ak sa zmenil koordinátor?
- Čo robiť, ak sa klient opätovne pripojil k klastru?
- Je potrebné spracovať požiadavky na aktiváciu/deaktiváciu a ako?
- A čo ak sa zavolá destrukcia cache, a máme na ňu naviazané affinity služby?
A to je rozhodne nie všetko.
Riešenie
Ako cieľový sme zvolili prístup Event Driven s implementáciou komunikácie procesov pomocou správ. V Ignite už sú implementované dva komponenty, ktoré umožňujú uzlom posielať správy medzi sebou – communication-spi a discovery-spi.
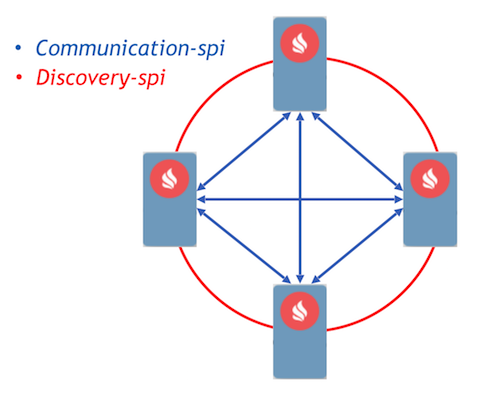
Komunikácia SPI umožňuje uzlom priamu výmenu a prenos správ. Je ideálny na prenos veľkého objemu dát. Discovery SPI umožňuje poslať správu všetkým uzlom v klastri. V štandardnej implementácii sa to robí v topológii „krúžok“. Existuje aj integrácia so Zookeeperom, pričom sa používa topológia „hviezda“. Dôležité je tiež poznamenať, že discovery SPI poskytuje záruky, že správa bude doručená v správnom poradí všetkým uzlom.
Pozrime sa na protokol nasadzovania. Všetky používateľské požiadavky na nasadenie a odnasadenie sa odosielajú cez discovery SPI. To poskytuje nasledujúce záruky:
- Požiadavka bude prijatá všetkými uzlami v klastri. To umožní pokračovať v spracovaní požiadavky pri zmene koordinátora. To tiež znamená, že každému uzlu budú k dispozícii všetky potrebné metadáta, ako je konfigurácia služby a jej serializovaný inštancia.
- Prísny poriadok doručovania správ umožňuje riešiť konflikty konfigurácií a konkurenčných požiadaviek.
- Keďže vstup uzla do topológie sa taktiež spracováva cez discovery SPI, nový uzol dostane všetky potrebné dáta na prácu so službami.
Pri prijatí požiadavky uzly v klastri overujú jej platnosť a formulujú úlohy na spracovanie. Tieto úlohy sa ukladajú do fronty a následne sa spracovávajú v inom vlákne samostatným pracovníkom. Je to realizované týmto spôsobom, pretože nasadenie môže trvať značný čas a oneskorenie cenného discovery toku je neprijateľné.
Všetky požiadavky z fronty spracováva manažér nasadenia. Má špeciálneho pracovníka, ktorý ťahá úlohu z tejto fronty a inicializuje ju, aby sa začalo nasadzovanie. Potom nasledujú tieto akcie:
- Každý uzol samostatne vypočíta rozdelenie pomocou novej deterministickej funkcie asignácie.
- Uzly vytvárajú správu s výsledkami nasadenia a posielajú ju koordinátorovi.
- Koordinátor agreguje všetky správy a formulár výsledok celého procesu nasadenia, ktorý sa posiela cez discovery SPI všetkým uzlom v klastri.
- Po prijatí výsledku sa proces nasadenia ukončí, po čom sa úloha vymaže z fronty.
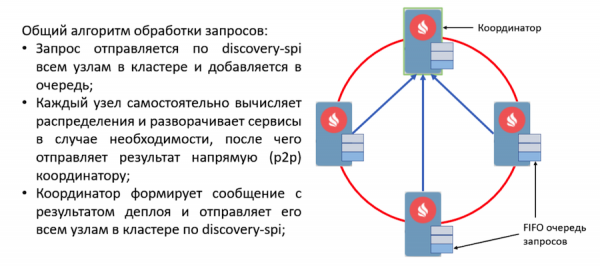
Nový event-driven dizajn: org.apache.ignite.internal.processors.service.IgniteServiceProcessor.java
Ak v čase nasadenia došlo k chybe, uzol okamžite zahrnie túto chybu do správy, ktorú posiela koordinátorovi. Po agregácii správ bude koordinátor mať informácie o všetkých chybách počas nasadenia a pošle túto správu prostredníctvom discovery-spi. Informácie o chybách budú k dispozícii na akomkoľvek uzle v klastru.
Podľa tohto algoritmu sa spracovávajú všetky dôležité udalosti v Service Grid. Napríklad zmena topológie je tiež správa prostredníctvom discovery-spi. A vo všeobecnosti, ak porovnáme to, čo bolo, protokol sa ukázal ako dosť ľahký a spoľahlivý. Tak, aby mohol spracovať akúkoľvek situáciu počas nasadenia.
Čo bude ďalej
Teraz k plánom. Akékoľvek veľké vylepšenie v projekte Ignite sa vykonáva ako iniciatíva na zlepšenie Ignite, takzvaný IEP. Pre redesign Service Grid tiež existuje IEP — s vtipným názvom „Výměna oleja v Service Gride“. Ale v skutočnosti sme nezmenili olej v motore, ale celú pohonnú jednotku.
Úlohy v IEP sme rozdelili na 2 fázy. Prvá — veľká fáza, ktorá spočíva v prepracovaní protokolu nasadenia. Tá už bola zlúčená do master, môžete vyskúšať nový Service Grid, ktorý sa objaví vo verzii 2.8. Druhá fáza zahŕňa množstvo ďalších úloh:
- Hotové redeploy
- Versionovanie služieb
- Zvýšenie odolnosti voči poruchám
- Tenký klient
- Nástroje na monitorovanie a sledovanie rôznych metrík
Na záver vám môžeme odporučiť Service Grid na budovanie systémov s vysokou dostupnosťou a odolnosťou voči poruchám. Takisto vás pozývame k nám na a podeliť sa so svojou skúsenosťou. Vaša skúsenosť je skutočne dôležitá pre komunitu, pomôže to pochopiť, kam sa posúvať ďalej a ako v budúcnosti rozvíjať tento komponent.
Zdroj: habr.com
