

Dostal som úlohu tohto typu. Je potrebné implementovať kontajner na ukladanie dát, ktorý zabezpečuje nasledujúcu funkcionalitu:
- vložiť nový prvok
- odstrániť prvok podľa poradia
- získať prvok podľa poradia
- dáta sú uchovávané v zoradenom stave
Dáta sa neustále pridávajú a odstraňujú, štruktúra by mala zabezpečiť rýchlu rýchlosť práce. Najprv som sa snažil implementovať niečo také pomocou štandardných kontajnerov z std. Tento prístup neuspel a prišlo pochopenie, že je potrebné implementovať niečo samostatne. Jediná vec, ktorá mi napadla, je použiť binárny vyhľadávací strom. Pretože vyhovuje požiadavkám na rýchle vkladanie, odstraňovanie a uchovávanie dát v zoradenom stave. Ostávalo len vymyslieť, ako indexovať všetky prvky a prepočítavať indexy, keď sa strom mení.
struct node_s {
    data_t data;

    uint64_t weight; // váha uzla

    node_t *left;
    node_t *right;

    node_t *parent;
};
V článku bude viac obrázkov a teórie ako kódu. Kód si bude možné pozrieť prostredníctvom odkazu nižšie.
Hmotnosť
Na tento účel bol strom podrobený malej modifikácii, pribudla dodatočná informácia o váhe uzla. Váha uzla je počet potomkov tohto uzla + 1 (váha jedného prvku).
Funkcia na získanie váhy uzla:
uint64_t bntree::get_child_weight(node_t *node) {
    if (node) {
        return node->weight;
    }

    return 0;
}
U listu je váha samozrejme 0.
Ďalej prejdeme k názornému zobrazeniu príkladu takého stromu. Čiernou farbou bude zobrazený kľúč uzla (hodnota zobrazená nebude, pretože na tom nie je potreba), červenou — váha uzla, zelenou — index uzla.
Keď je strom prázdny, jeho váha je 0. Pridáme doň koreňový prvok:
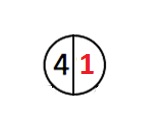
Váha stromu sa stáva 1, váha koreňového prvku 1. Váha koreňového prvku je váhou stromu.
Pridáme ešte niekoľko prvkov:
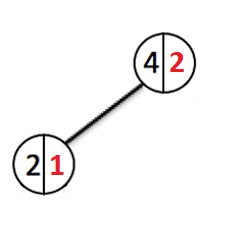
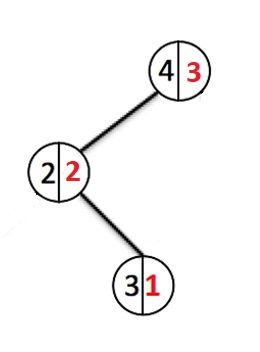
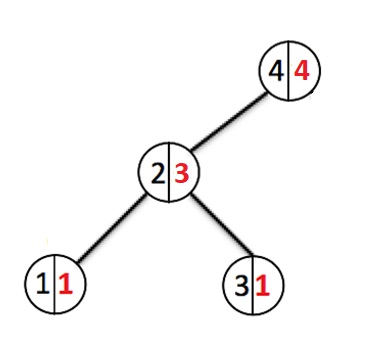
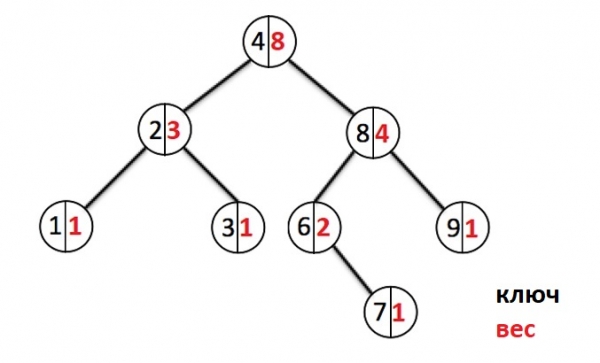
Pri každom pridaní nového prvku prechádzame uzlami nadol a zvyšujeme počítadlo váhy každého prechádzaného uzla. Pri vytváraní nového uzla mu nastavíme váhu 1. Ak uzol s takýmto kľúčom už existuje, prepíšeme hodnotu a pôjdeme späť k koreňu, pričom odcancelujeme zmeny váh všetkých uzlov, ktoré sme prešli.
Ak ide o odstránenie uzla, prechádzame nadol a dekrétujeme váhy prechádzajúcich uzlov.
Indexy
Teraz prejdeme k tomu, ako indexovať uzly. Uzly zjavne neuchovávajú svoj index, ten sa počíta na základe hmotnosti uzlov. Keby uchovávali svoj index, trvalo by to O(n) čas, aby sa aktualizovali indexy všetkých uzlov po každej zmene stromu.
Prejdime k názornému znázorneniu. Naše stromy sú prázdne, pridajme do neho prvý uzol:
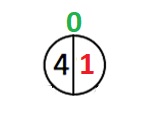
Prvý uzol má index 0, a teraz sú možné dva prípady. V prvom prípade sa index koreňového prvku zmení, v druhom nie.
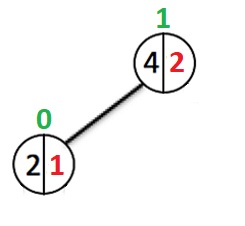
Koreňové ľavé podstrom má hmotnosť 1.
Druhý prípad:
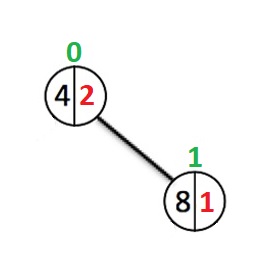
Index koreňa sa nezmenil, pretože hmotnosť jeho ľavého podstromu zostala 0.
Index uzla sa počíta ako hmotnosť jeho ľavého podstromu + číslo od rodiča. Čo to číslo je?, Je to čítač indexov, pôvodne je to 0, pretože koreň nemá rodiča. Ďalej závisí od toho, kam sa dostávame, k ľavému alebo pravému dieťaťu. Ak k ľavému, čítač sa nezvyšuje. Ak k pravému, pripočítavame index aktuálneho uzla.
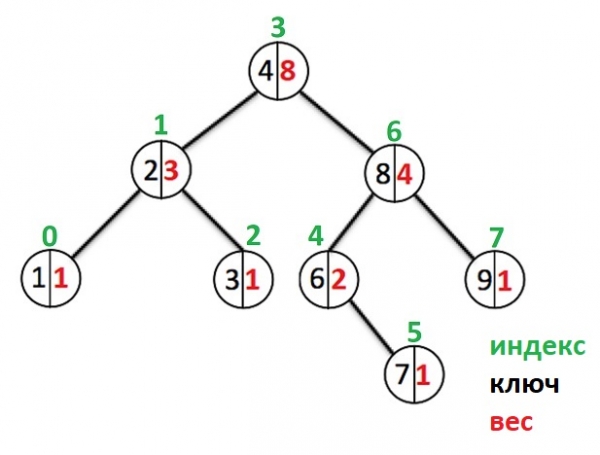
Napríklad, ako sa počíta index prvku s kľúčom 8 (pravé dieťa koreňa). Toto je „Index koreňa“ + „hmotnosť ľavého podstromu uzla s kľúčom 8“ + „1“ == 3 + 2 + 1 == 6
Indexom prvku s kľúčom 6 bude „Index koreňa“ + 1 == 3 + 1 == 4
Preto aby sme získali, odstránili prvok podľa indexu, potrebujeme čas O(log n), pretože aby sme získali požadovaný prvok, musíme ho najprv nájsť (dostať sa z koreňa k tomuto prvku).
Hĺbka
Na základe hmotnosti sa tiež dá vypočítať hĺbka stromu. Potrebná na vyváženie.
Na to treba hmotnosť aktuálneho uzla zaokrúhliť na prvé číslo v mocnine 2, ktoré je väčšie alebo rovné danej hmotnosti, a získať od neho binárny logaritmus. Takto získame hĺbku stromu, za predpokladu, že je vyvážený. Strom sa vyváži po vložení nového prvku. Teóriu o tom, ako vyvažovať stromy nebudem uvádzať. V pôvodných kódoch je uvedená funkcia na vyváženie.
Kód na prevod hmotnosti na hĺbku.
/*
 * Возвращает первое число в степени 2, которое больше или ровно x
 */
uint64_t bntree::cpl2(uint64_t x) {
    x = x - 1;
    x = x | (x >> 1);
    x = x | (x >> 2);
    x = x | (x >> 4);
    x = x | (x >> 8);
    x = x | (x >> 16);
    x = x | (x >> 32);

    return x + 1;
}

/*
 * Двоичный логарифм от числа
 */
long bntree::ilog2(long d) {
    int result;
    std::frexp(d, &result);
    return result - 1;
}

/*
 * Вес к глубине
 */
uint64_t bntree::weight_to_depth(node_t *p) {
    if (p == NULL) {
        return 0;
    }

    if (p->weight == 1) {
        return 1;
    } else if (p->weight == 2) {
        return 2;
    }

    return this->ilog2(this->cpl2(p->weight));
}
Zhrnutie
- vloženie nového prvku sa uskutočňuje za O(log n)
- odstránenie prvku podľa poradového čísla sa uskutočňuje za O(log n)
- získanie prvku podľa poradového čísla sa uskutočňuje za O(log n)
Rýchlosť O(log n) platíme za to, že všetky údaje sú uložené v usporiadanom tvare.
Neviem, kde by sa takáto štruktúra mohla uplatniť. Iba úloha, aby som sa znova dostal do problematiky fungovania stromov. Ďakujem za pozornosť.
Odkazy
Projekt obsahuje testovacie údaje na kontrolu rýchlosti výkonu. Strom sa vyplňuje 1000000 prvkov. A dochádza k postupnému odstraňovaniu, vkladaniu a získavaniu prvkov 1000000 raz. Čiže 3000000 operácií. Výsledok sa ukázal ako celkom dobrý ~ 8 sekúnd.
Zdroj: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish