

Ahojte. V tomto článku vám prezradím, prečo sme v Avite pred deviatimi mesiacmi zvolili Kafka, a čo vlastne predstavuje. Podelím sa o jeden z prípadov použitia – broker správ. Na záver sa porozprávame o tom, aké výhody sme získali z prístupu Kafka as a Service.
Problém
Na začiatok trochu kontextu. Pred nejakým časom sme začali odchádzať od monolitnej architektúry, a teraz má Avito už niekoľko stoviek rôznych služieb. Tieto služby majú svoje úložiská, svoj technologický stack a zodpovedajú za svoju časť biznisovej logiky.
Jedným z problémov s veľkým počtom služieb sú komunikácie. Služba A často chce získať informácie, ktoré má služba B. V tomto prípade sa služba A obracia na službu B prostredníctvom synchronného API. Služba V chce vedieť, čo sa deje so službami G a D, a tie, na druhej strane, sa zaujímajú o služby A a B. Keď počet takýchto „zvedavých“ služieb narastá, väzby medzi nimi sa menia na zložitú sieť.
Pri tom sa môže služba A kedykoľvek stať nedostupnou. A čo robiť v takom prípade službe B a všetkým ostatným závislým službám? A ak na uskutočnenie biznisovej operácie je potrebné vykonať reťazec postupných synchronných volaní, pravdepodobnosť zlyhania celej operácie sa ešte zvyšuje (a tým vyššia je, čím dlhší je tento reťazec).
Výber technológie
Dobre, problémy sú jasné. Môžeme ich vyriešiť vytvorením centralizovaného systému výmeny správ medzi službami. Teraz každá z služieb potrebuje vedieť iba o tomto systéme výmeny správ. Okrem toho by mal byť sám systém odolný voči zlyhaniu a horizontálne škálovateľný, ako aj v prípade nehody zhromažďovať vo svojom bufferi žiadosti pre následné spracovanie.
Teraz si vyberme technológiu, na ktorej sa bude realizovať dodávka správ. Najprv si ujasníme, čo od nej očakávame:
- správy medzi službami by nemali byť stratené;
- správy sa môžu duplicovať;
- správy môžeme uchovávať a čítať na dobu niekoľkých dní (perzistentný buffer);
- služby sa môžu prihlásiť k zaujímavým údajom;
- niekoľko služieb môže čítať rovnaké údaje;
- správy môžu obsahovať podrobný, objemný payload (event-carried state transfer);
- niekedy je potrebná záruka poradia správ.
Rovnako pre nás bolo kriticky dôležité vybrať maximálne škálovateľný a spoľahlivý systém s vysokou kapacitou (minimálne 100k správ pri niekoľkých kilobajtoch za sekundu).
V tejto fáze sme sa rozlúčili s RabbitMQ (ťažké udržiavať stabilitu pri vysokých rps), PGQ od SkyTools (nedostatočne rýchly a zle škálovateľný) a NSQ (nepersistenčný). Všetky tieto technológie sa u nás v spoločnosti používajú, ale na danú úlohu sa nehodili.
Potom sme začali skúmať nové technológie pre nás — Apache Kafka, Apache Pulsar a NATS Streaming.
Prvým sme vylúčili Pulsar. Rozhodli sme sa, že Kafka a Pulsar sú dosť podobné riešenia. A hoci je Pulsar preverovaný veľkými spoločnosťami, novší a ponúka teoreticky nižšiu latenciu, rozhodli sme sa z týchto dvoch ponechať Kafka ako de facto štandard pre takéto úlohy. Pravdepodobne sa v budúcnosti k Apache Pulsar vrátime.
A tak zostali dvaja kandidáti: NATS Streaming a Apache Kafka. Oba sme podrobne preskúmali a obidve vyhovovali našej úlohe. Nakoniec sme sa však obávali relatívnej mladosti NATS Streaming (a toho, že jeden z hlavných vývojárov, Tyler Treat, sa rozhodol odísť z projektu a začať svoj vlastný — Liftbridge). Okrem toho Clustering režim NATS Streaming neumožňoval výrazné horizontálne škálovanie (pravdepodobne už nie je problém po pridaní partitioning režimu v roku 2017).
Napriek tomu je NATS Streaming skvelá technológia, napísaná v Go a má podporu Cloud Native Computing Foundation. Na rozdiel od Apache Kafka, nepotrebuje Zookeeper na fungovanie (možno, ), pretože interne implementuje RAFT. NATS Streaming je zároveň jednoduchšia na administráciu. Nevyraďujeme, že sa v budúcnosti ešte vrátime k tejto technológii.
Napriek tomu sa náš dnešný víťaz stal Apache Kafka. V našich testoch sa ukázala byť dostatočne rýchla (viac ako milión správ za sekundu pri čítaní a písaní s objemom správ 1 kilobajt), dostatočne spoľahlivá, dobre škálovateľná a overená v produkcii veľkými spoločnosťami. Okrem toho Kafka podporuje aspoň niekoľko veľkých komerčných spoločností (napríklad používame Confluent verziu), a tiež má vybudovaný rozvinutý ekosystém.
Prehľad Kafka
Predtým, ako začneme, okamžite odporúčam vynikajúcu knihu — „Kafka: The Definitive Guide“ (existuje aj v slovenskom preklade, ale terminológia trochu zamieňa hlavu). V nej nájdete informácie potrebné na základné pochopenie Kafka a možno aj trochu viac. Samotná dokumentácia od Apache a blog od Confluent sú tiež výborne napísané a ľahko čitateľné.
Takže sa pozrime na to, ako je Kafka usporiadaná z vtáčej perspektívy. Základná topológia Kafka pozostáva z producer, consumer, broker a zookeeper.
Brokera
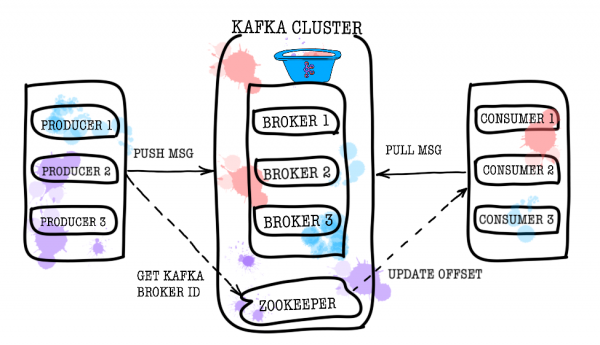
Za ukladanie vašich údajov zodpovedá broker (broker). Všetky údaje sú uložené v binárnej forme a broker má len málo informácií o tom, čo predstavujú a aká je ich štruktúra.
Každý logický typ udalostí sa zvyčajne nachádza v samostatnom topicu (topic). Napríklad, udalosť založenia inzerátu môže prísť do topicu item.created, zatiaľ čo udalosť jeho zmeny do item.changed. Témata je možné považovať za klasifikátory udalostí. Na úrovni topicu je možné nastaviť také konfiguračné parametre, ako sú:
- objem uchovávaných údajov a/alebo ich vek (retention.bytes, retention.ms);
- faktor redundancie údajov (replication factor);
- maximálna veľkosť jednej správy (max.message.bytes);
- minimálny počet synchronizovaných replik, pri ktorých je možné zapisovať údaje do topicu (min.insync.replicas);
- možnosť vykonať failover na nesynchronizovanú zaostávajúcu replikou s potenciálnou stratou údajov (unclean.leader.election.enable);
- a mnoho ďalších ().
Na druhej strane, každý topic sa delí na jednu alebo viac partícií (partition). Práve do partície nakoniec putujú udalosti. Ak je v klustre viac ako jeden broker, partície budú rovnomerne rozdelené medzi všetkých brokerov (ako to len bude možné), čo umožní škálovanie zaťaženia pri zápise a čítaní do jedného topicu na viacero brokerov naraz.
Na disku sú údaje pre každú partíciu uložené vo forme segmentových súborov, ktoré sú predvolene veľké jeden gigabajt (riadi sa cez log.segment.bytes). Dôležitá vlastnosť — odstraňovanie údajov z partícií (pri uplynutí retention) sa uskutočňuje práve po segmentoch (nie je možné odstrániť jednu udalosť z partície, možné je len odstrániť celý segment, a to iba neaktívny).
Zookeeper
Zookeeper funguje ako úložisko metadát a koordinátor. Je to on, kto dokáže povedať, či sú brokery živé (na to sa môžete pozrieť očami zookeepra cez zookeeper-shell príkazom ls /brokers/ids), ktorý z brokerov je kontrolór (get /controller), sú partície v synchronizovanom stave so svojimi replikami (get /brokers/topics/topic_name/partitions/partition_number/state). Taktiež práve do zookeepra najprv pôjdu producer a consumer, aby zistili, na ktorom brokeri sú uložené aké témy a partície. V prípadoch, keď je pre tému nastavený replication factor väčší ako 1, zookeeper určí, ktoré partície sú lídrami (do nich sa bude zapisovať a z nich sa bude čítať). V prípade pádu brokera sa práve v zookeepra zaznamená informácia o nových líderských partíciách (od verzie 1.1.0 asynchrónne, ).
V starších verziách Kafka zookeeper zodpovedal aj za ukladanie offsetov, ale teraz sú uložené v špeciálnej téme __consumer_offsets na brokeri (aj keď môžete na tieto účely stále používať zookeeper).
Najjednoduchší spôsob, ako premeniť vaše dáta na tekvicu, je práve strata informácií zo zookeepra. V takom scenári bude veľmi ťažké pochopiť, čo a odkial treba čítať.
Producer
Producer je najčastejšie služba, ktorá priamo zapisuje dáta do Apache Kafka. Producer vyberá tému, v ktorej budú uložené jeho tematické správy, a začína do nej zapisovať informácie. Napríklad, producerom môže byť služba na inzerovanie. V takom prípade bude odosielať do tematických tém také udalosti, ako sú "inzerát vytvorený", "inzerát aktualizovaný", "inzerát odstránený" a pod. Každá udalosť pritom predstavuje pár kľúč-hodnota.
Predvolene sa všetky udalosti rozdeľujú po partíciách témy round-robinom, ak nie je zadaný kľúč (stráca sa poradie), a prostredníctvom MurmurHash (kľúč), ak je kľúč prítomný (poradie v rámci jednej partície).
Tu sa hneď treba poznamenať, že Kafka zaručuje poradie udalostí iba v rámci jednej partície. Ale v skutočnosti to často nie je problém. Napríklad, všetky zmeny toho istého inzerátu je možné zabezpečiť pridaním do jednej partície (čím sa zachová poradie týchto zmien v rámci inzerátu). Taktiež je možné prenášať poradie čísla v jednom z polí udalosti.
Consumer
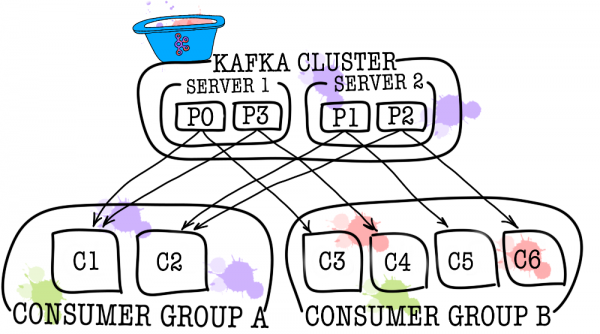
Consumer je zodpovedný za prijímanie údajov z Apache Kafka. Ak sa vrátime k uvedenému príkladu, consumerom môže byť služba moderovania. Táto služba bude prihlásená na tému služby inzerátov a pri objavení nového inzerátu ho dostane a analyzuje na súlad s niektorými stanovenými politikami.
Apache Kafka si pamätá, aké posledné udalosti prijal consumer (na tento účel sa používa pomocná téma __consumer__offsets), čím zaručuje, že ak sa úspešne prečíta, consumer nedostane tú istú správu dvakrát. Avšak, ak sa používa možnosť enable.auto.commit = true a celú prácu na sledovanie polohy consumera v téme prenecháme Kafke, môžeme . V produkčnom kóde sa zvyčajne poloha consumeru kontroluje manuálne (vývojár riadi okamih, kedy musí nevyhnutne dôjsť k commitnuti prečítanej udalosti).
V prípadoch, keď je jeden consumer nedostatočný (napríklad prúd nových udalostí je veľmi veľký), je možné pridať niekoľko ďalších consumerov a spojiť ich do consumer group. Consumer group logicky predstavuje presne takého istého consumer, ale s rozdelením údajov medzi účastníkov skupiny. To umožňuje každému z účastníkov vziať si svoju časť správ, čím sa zvyšuje rýchlosť čítania.
Výsledky testovania
Tu nebudem písať veľa vysvetľujúceho textu, len sa podelím o dosiahnuté výsledky. Testovanie prebiehalo na 3 fyzických strojoch (12 CPU, 384 GB RAM, 15k SAS DISK, 10 GBit/s Net), brokeri a zookeeper boli nasadení v lxc.
Testovanie výkonu
Počas testovania boli získané nasledujúce výsledky.
- Rýchlosť zápisu správ veľkosti 1 KB súčasne 9 producermi – 1 300 000 udalostí za sekundu.
- Rýchlosť čítania správ veľkosti 1 KB súčasne 9 consumerami – 1 500 000 udalostí za sekundu.
Testovanie odolnosti voči poruchám
Počas testovania boli získané nasledujúce výsledky (3 brokery, 3 zookeeperi).
- Neštandardné ukončenie jedného z brokerov nevedie k zastaveniu alebo nedostupnosti klastra. Práca pokračuje v normálnom režime, ale na zostávajúce brokery sa kladie väčšia záťaž.
- Nečakané ukončenie dvoch brokerov v prípade klastra z troch brokerov a min.isr = 2 vedie k nedostupnosti klastra pre zápis, ale dostupnosti na čítanie. V prípade, ak je min.isr = 1, klaster zostáva dostupný ako pre čítanie, tak aj pre zápis. Napriek tomu tento režim odporuje požiadavke na vysokú zachovanosť dát.
- Nečakané ukončenie jedného zo serverov Zookeeper nevedie k zastaveniu alebo nedostupnosti klastra. Práca pokračuje v normálnom režime.
- Nečakané ukončenie dvoch serverov Zookeeper vedie k nedostupnosti klastra do okamihu obnovenia činnosti aspoň jedného zo serverov Zookeeper. Toto tvrdenie platí pre klaster Zookeeper zo 3 serverov. V dôsledku výskumov sa rozhodlo zvýšiť klaster Zookeeper na 5 serverov na zvýšenie odolnosti voči poruchám.
Kafka ako služba
Ujasnili sme si, že Kafka je vynikajúca technológia, ktorá nám umožňuje vyriešiť predloženú úlohu (implementáciu brokeru správ). Napriek tomu sme sa rozhodli zakázať službám priamy prístup k Kafke a uzavreli sme ju nad službou data-bus. Prečo sme to urobili? V skutočnosti existuje niekoľko dôvodov.
Data-bus prevzal na seba všetky úlohy súvisiace s integráciou s Kafkou (implementácia a nastavenie konsumentov a producentov, monitoring, alerting, logovanie, škálovanie atď.). Takto je integrácia s brokerom správ maximálne jednoduchá.
Data-bus umožnil abstrahovať od konkrétneho jazyka alebo knižnice na prácu s Kafkou.
Data-bus umožnil iným službám abstrahovať od úložného priestoru. Možno, v nejakom okamihu vymeníme Kafku za Pulsar, a nikto si toho nič nevšimne (všetky služby poznajú len API data-bus).
Data-bus prevzal na seba validáciu schém udalostí.
S pomocou data-bus bola implementovaná autentifikácia.
Pod záštitou data-bus môžeme bez prestoja, nepozorovane aktualizovať verzie Kafky, centralizovane spravovať konfigurácie producentov, konsumentov, brokerov atď.
Data-bus nám umožnil pridávať potrebné funkcie, ktoré v Kafke nie sú (ako audit tém, kontrola anomálií v klastri, vytváranie DLQ atď.).
Data-bus umožňuje centralizovane realizovať failover pre všetky služby.
Na začiatku stačí pripojiť malú knižnicu do kódu svojho servisu pre začatie odosielania udalostí do správy. To je všetko. Získate možnosť písať, čítať a škálovať jediným riadkom kódu. Celá realizácia je skrytá, von sa dostáva len niekoľko ovládacích prvkov typu veľkosti dávky. Pod kapotou služba data-bus spúšťa v Kubernetes potrebný počet inštancií producerov a consumerov a poskytuje im potrebnú konfiguráciu, ale všetko to je pre váš servis transparentné.
Samozrejme, niet striebornej guľky a tento prístup má svoje obmedzenia.
- Data-bus je potrebné udržiavať svojpomocne, na rozdiel od externých knižníc.
- Data-bus zvyšuje počet interakcií medzi službami a brokerom správ, čo vedie k zníženiu efektivity v porovnaní s holou Kafka.
- Nie všetko sa dá tak jednoducho skryť pred službami, kopírovať funkčnosť KSQL alebo Kafka Streams do data-bus sa nám nechce, preto niekedy musíme povoliť službám ísť priamo.
V našom prípade prevažovali plusy nad minusmi a rozhodnutie skryť broker správ pod samostatnú službu sa ukázalo ako ospravedlniteľné. Po roku prevádzky sme nemali žiadne vážne havárie ani problémy.
P.S. Ďakujem svojej priateľke, Ekaterine Obaljajevovej, za skvelé obrázky k tomuto článku. Ak sa vám páčili, nájdete ešte viac ilustrácií.
Zdroj: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish