

Vitajte, Habr!
Kedyysi sme boli prvými, ktorí predstavili tému a naďalej sa na jej rozvoj. Konkrétne sa nám zdala zaujímavá téma interakcie medzi Kafka a . Prehľadná (a pomerne opatrná) na túto tému bola zverejnená na blogu spoločnosti Confluent ešte v októbri minulého roka autorky Gwen Shapiro. Dnes by sme vám chceli upriamiť pozornosť na novší, aprílový článok Johann Gyger, ktorý, hoci sa nevyhol otáznikovi v názve, posudzuje tému z konkrétnejšieho hľadiska, pričom text sprevádza zaujímavými odkazmi. Ospravedlňte nám prosím náš voľný preklad „chaos monkey“, ak môžete!
Úvod
Kubernetes je určený na prácu s nenasledovanými záťažami. Zvyčajne sú také pracovné zaťaženia reprezentované v podobe microservices architektúry, sú ľahké, dobre sa škálujú horizontálne, dodržiavajú princípy 12 faktorových aplikácií, umožňujú pracovať s automatickými vypínačmi (circuit breaker) a chaos opicami (chaos monkeys).
Kafka, umiestnená na druhej strane, v podstate vystupuje ako distribuovaná databáza. Tým pádom pri práci musíte brať do úvahy stav, a ten je oveľa ťažší ako microservice. Kubernetes podporuje stavy s trvalým uložením, ale, ako naznačuje Kelsey Hightower vo svojich dvoch tweetoch, s nimi by sa malo zaobchádzať opatrne:
Niektorým sa zdá, že ak nasadíte Kubernetes na stavovú záťaž, stane sa plne spravovanou databázou, schopnou konkurovať RDS. To nie je pravda. Možno, ak dosť pracujete, pripojíte ďalšie komponenty a zapojíte tím SRE inžinierov, môžete usporiadať RDS na vrchu Kubernetes.
Vždy všetkým odporúčam, aby zachovali mimoriadnu opatrnosť pri spúšťaní stavových záťaží na Kubernetes. Väčšina tých, ktorí sa zaujímajú, „môžem spúšťať stavové záťaže na Kubernetes“, nemá dostatočné skúsenosti s Kubernetes, a často ani so samotnou záťažou, o ktorej sa pýtajú.
Takže, má sa Kafka spúšťať na Kubernetes? Protiotázka: bude Kafka lepšie fungovať bez Kubernetes? Preto chcem v tomto článku zdôrazniť, ako sa Kafka a Kubernetes dopĺňajú a aké úskalia sa môžu objaviť pri ich kombinácii.
Čas vykonávania
Poďme sa porozprávať o základnej veci — runtime prostredí ako takom.
Proces
Brokery Kafka sú efektívne pri práci s CPU. TLS môže priniesť niektoré náklady. Klienti Kafka môžu zaťažovať CPU viac, ak používajú šifrovanie, avšak to neovplyvňuje brokerov.
Pamäť
Brokery Kafka spotrebovávajú pamäť. Veľkosť JVM hromady sa zvyčajne obmedzuje na 4–5 GB, ale budete tiež potrebovať veľa systémovej pamäte, pretože Kafka veľmi aktívne využíva stránkový cache. V Kubernetes zodpovedne nastavujte limity kontajnera na zdroje a požiadavky.
Úložisko dát
Úložisko dát v kontajneroch je efemérne – dáta sa strácajú pri reštarte. Pre údaje Kafka môžete použiť zväzok, emptyDir, a efekt bude rovnaký: dáta vášho brokera sa stratia po ukončení. Vaše správy môžu byť stále uchované na iných brokeroch ako repliky. Preto musí po reštarte nefunkčný broker najprv replikovať všetky dáta, na čo môže byť potrebný istý čas.
Preto je potrebné používať trvalé úložisko dát. Nech ide o remote trvalé úložisko s XFS filesystem alebo, presnejšie, ext4. Nepoužívajte NFS. Upozornil som vás. NFS verzií v3 alebo v4 nebude fungovať. Skrátka, broker Kafka skončí, ak nebude schopný odstrániť adresár s dátami z dôvodu problému s "hlúpymi premenovaniami", ktorý je aktuálny v NFS. Ak som vás doteraz nepresvedčil, veľmi pozorne . Úložisko dát by malo byť remote, aby Kubernetes mohol flexibilnejšie vybrať nový uzol po reštarte alebo relokácii.
Sieť
Ako pri väčšine distribuovaných systémov, výkon Kafka veľmi závisí od toho, aby boli latencie v sieti minimalizované a šírka pásma maximálna. Nepokúšajte sa umiestniť všetkých brokerov na rovnaký uzol, pretože by to znížilo dostupnosť. Ak zlyhá uzol Kubernetes, zlyhá aj celý klaster Kafka. Taktiež nerozmiestňujte klaster Kafka po celých dátových centrách. To isté platí pre klaster Kubernetes. Dobrý kompromis je zvoliť rôzne zóny dostupnosti.
Konfigurácia
Bežné manifesty
Na stránke Kubernetes je o tom, ako nastaviť ZooKeeper pomocou manifestov. Keďže ZooKeeper je súčasťou Kafka, je to ideálne miesto na začatie spoznávania konceptov Kubernetes, ktoré sú tu použiteľné. Po pochopení toho, budete môcť aplikovať tie isté koncepty aj na klaster Kafka.
- Pod: pod – to je minimálna nasaditeľná jednotka v Kubernetes. Pod obsahuje vašu pracovnú záťaž a samotný pod zodpovedá procesu vo vašom klastri. Pod obsahuje jeden alebo viac kontajnerov. Každý server ZooKeeper v súbore a každý broker v klastri Kafka budú pracovať v samostatnom pode.
- StatefulSet: StatefulSet – to je objekt Kubernetes, ktorý pracuje s viacerými pracovnými záťažami, ktoré udržujú stav a vyžadujú koordináciu. StatefulSet poskytujú záruky týkajúce sa usporiadania podov a ich jedinečnosti.
- Headless služby: Služby umožňujú oddeliť pod od klientov pomocou logického názvu. Kubernetes sa v tomto prípade postará o vyváženie záťaže. Avšak pri operáciách s pracovnými záťažami, ktoré udržujú stav, ako je to pri ZooKeeper a Kafka, musia klienti komunikovať s konkrétnym inštancom. Tu prichádzajú na pomoc headless služby: v tomto prípade bude mať klient aj naďalej logický názov, ale nebude potrebné sa priamo odkazovať na pod.
- Zásobník na trvalé ukladanie: takéto zásobníky sú potrebné na konfiguráciu nelokálneho blokového trvalého úložiska, ktoré bolo spomínané vyššie.
Na poskytuje komplexnú sadu manifestov, pomocou ktorých je jednoduché začať pracovať s Kafka na Kubernetes.
Helm diagramy
Helm je správca balíkov pre Kubernetes, ktorý môžeme porovnať so správcom balíkov pre operačné systémy, ako sú yum, apt, Homebrew alebo Chocolatey. S jeho pomocou je pohodlné inštalovať vopred definované softvérové balíky, ktoré sú popísané v diagramoch Helm. Dobre navrhnutý diagram Helm zjednodušuje zložitú úlohu: ako správne nakonfigurovať všetky parametre na používanie Kafka na Kubernetes. Existuje niekoľko diagramov Kafka: oficiálny sa nachádza , existuje jeden od , ďalší – od .
Operátory
Keďže Helm má určité nevýhody, získava čoraz väčšiu popularitu ďalší nástroj: operátori Kubernetes. Operátor nie len obaluje softvér pre Kubernetes, ale tiež vám umožňuje nasadiť tento softvér a spravovať ho.
V zozname sa spomínajú dvaja operátori pre Kafka. Jeden z nich je . S pomocou Strimzi nie je žiadny problém zriadiť klaster Kafka za pár minút. Prakticky nie je potrebné robiť žiadnu konfiguráciu, navyše samotný operátor poskytuje niektoré príjemné funkcie, ako napríklad šifrovanie TLS typu „point-to-point“ v rámci klastru. Confluent tiež ponúka .
Výkon
Je veľmi dôležité testovať výkon dodávaním kontrolných bodov vášmu nainštalovanému экземпляru Kafka. Tieto testy vám pomôžu odhaliť potenciálne úzke miesta, kým nenastanú problémy. Našťastie, v Kafka sú už k dispozícii dva nástroje na testovanie výkonu: kafka-producer-perf-test.sh a kafka-consumer-perf-test.sh. Aktívne ich využívajte. Na referenciu sa môžete porovnať s výsledkami opísanými v Džeja Krepca, alebo sa orientovať na Amazon MSK od Stéphane Maarek.
Operácie
Monitorovanie
Transparentnosť v systéme je veľmi dôležitá – inak nebudete chápať, čo sa v ňom deje. Dnes existuje solídny súbor nástrojov, ktoré poskytujú monitoring na základe metriky v štýle cloud-native. Dva populárne nástroje pre tento účel sú Prometheus a Grafana. Prometheus môže zhromažďovať metriky zo všetkých procesov Java (Kafka, Zookeeper, Kafka Connect) pomocou JMX exportéra – tým najjednoduchším spôsobom. Ak pridáte metriky cAdvisor, môžete mať lepšiu predstavu o tom, ako sa v Kubernetes využívajú zdroje.
Strimzi má veľmi užitočný príklad dashboardu Grafana pre Kafka. Vizuálne zobrazuje kľúčové metriky, napríklad o nedoreplikovaných sektoroch alebo tých, ktoré sú offline. Všetko je veľmi prehľadné. Tieto metriky sú doplnené informáciami o využití zdrojov a výkonnosti, ako aj indikátormi stability. Týmto spôsobom získate základný monitoring klastera Kafka úplne zadarmo!
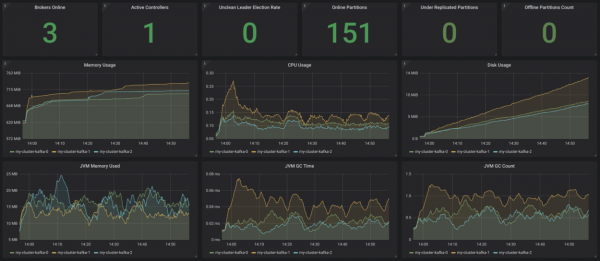
Zdroj:
Všetko by bolo dobre doplniť monitoringom klientov (metriky pre konzumentov a producentov) a tiež monitoringom oneskorenia (na to existuje ) a komplexným monitoringom – na to použite .
Logovanie
Logovanie je ďalšou veľmi dôležitou úlohou. Uistite sa, že všetky kontajnery vo vašej inštalácii Kafka sú logované v stdout a stderr, a tiež zabezpečte, aby váš klaster Kubernetes agregoval všetky logy do centrálnej logovacej infraštruktúry, napríklad do .
Kontrola dostupnosti
Kubernetes používa sondy ‚živosti‘ (liveness) a pripravenosti (readiness), aby skontroloval, či vaše pody fungujú normálne. Ak kontrola živosti zlyhá, Kubernetes zastaví tento kontajner a potom ho automaticky reštartuje, ak je politika reštartu nastavená správne. Ak kontrola pripravenosti zlyhá, Kubernetes tento pod izoluje od obsluhy požiadaviek. Takže v takýchto prípadoch sa už nevyžaduje manuálne zásah, čo je veľké plus.
Nasadzovanie aktualizácií
StatefulSet podporujú automatické aktualizácie: pri výbere stratégie RollingUpdate sa každý pod Kafka aktualizuje po jednom. Takto môžete minimalizovať dĺžku výpadkov na nulu.
Škálovanie
Škálovanie klastera Kafka je náročná úloha. Avšak v Kubernetes je veľmi jednoduché škálovať pody na určitý počet replík, čo znamená, že môžete deklaratívne definovať toľko brokerov Kafka, koľko chcete. Najnáročnejšie na tom je prepresovanie sektorov po škálovaní nahor alebo pred škálovaním nadol. Znovu, s touto úlohou vám pomôže Kubernetes.
Administrácia
Úlohy spojené s administráciou vášho klastre Kafka, najmä vytváranie tém a znovu priraďovanie sektorov, môžete vykonať pomocou existujúcich shell skriptov, otvorením rozhrania príkazového riadku vo vašich podoch. Avšak, toto riešenie nie je veľmi elegantné. Strimzi podporuje správu tém pomocou iného operátora. Je tu čo zlepšovať.
Zálohovanie a obnova
Teraz bude dostupnosť Kafka závisieť aj od dostupnosti Kubernetes. Ak vám padne klaster Kubernetes, v najhoršom prípade padne aj klaster Kafka. Podľa Murphyho zákona sa to určite stane a stratíte dáta. Aby ste znížili riziko takéhoto druhu, dobre navrhnite koncept zálohovania. Môžete využiť MirrorMaker, iná možnosť je využiť S3, ako je popísané v tomto od Zalando.
Záver
Pri práci s malými alebo strednými klastrami Kafka je určite rozumné používať Kubernetes, pretože poskytuje dodatočnú flexibilitu a zjednodušuje prácu s operátormi. Ak máte pred sebou veľmi vážne nefunkčné požiadavky týkajúce sa latencie a/alebo priepustnosti, možno by ste mali zvážiť nejakú inú možnosť nasadenia.
Zdroj: habr.com
