

Ahoj, Habr! Práve teraz je v OTUS otvorená registrácia na nový kurz V predvečer spustenia kurzu sme pre vás tradične pripravili preklad zaujímavého materiálu.
Každý deň navštívi Twitter viac ako sto miliónov ľudí, aby sa dozvedeli, čo sa deje vo svete, a diskutovali o tom. Každý tweet a každá iná akcia používateľa generujú udalosť, ktorá je dostupná na internú analýzu údajov v Twitteri. Stovky zamestnancov analyzujú a vizualizujú tieto údaje, pričom zlepšovanie ich skúsenosti je hlavným prioritou tímu Twitter Data Platform.
Veríme, že používatelia s širokým spektrom technických zručností by mali mať možnosť nájsť dáta a mať prístup k dobre fungujúcim nástrojom na analýzu a vizualizáciu na báze SQL. To by umožnilo celej novej skupine používateľov s menšími technickými zručnosťami, vrátane dátových analytikov a produktových manažérov, čerpať informácie z údajov, čo by im umožnilo lepšie rozumieť a využívať možnosti Twitteru. Takto demokratizujeme analýzu údajov v Twitteri.
S postupným zdokonaľovaním našich nástrojov a možností pre internú analýzu údajov sme boli svedkami zlepšenia služby Twitter. Napriek tomu je stále priestor na rast. Súčasné nástroje, ako Scalding, vyžadujú programátorské zručnosti. Nástroje na analýzu na báze SQL, ako Presto a Vertica, majú problémy s výkonom v veľkom meradle. Taktiež máme problém s distribúciou údajov medzi viacerými systémami bez trvalého prístupu k nim.
Minulý rok sme oznámili , v rámci ktorej prenášame časti našej na Google Cloud Platform (GCP). Dosiahli sme záver, že nástroje Google Cloud môžu pomôcť našim iniciatívam na demokratizáciu analýzy, vizualizácie a strojového učenia v Twitteri:
- : úložisko firemných údajov s SQL motorom na báze , ktorý je známy rýchlosťou, jednoduchosťou a zvláda .
- nástroj na vizualizáciu veľkých údajov s funkciami spolupráce, ako v Google Docs.
Z tohto článku sa dozviete o našich skúsenostiach s týmito nástrojmi: čo sme urobili, čomu sme sa naučili a čo budeme robiť ďalej. Teraz sa zameriame na dávkovú a interaktívnu analytiku. Analytiku v reálnom čase prediskutujeme v nasledujúcom článku.
História úložísk údajov v Twitteri
Predtým, než sa hlbšie ponoríme do BigQuery, stojí za to stručne zhrnúť históriu úložiska dát na Twitteri. V roku 2011 sa analýza dát na Twitteri vykonávala prostredníctvom Vertica a Hadoop. Na vytvorenie MapReduce úloh v Hadoop-e sme používali Pig. V roku 2012 sme nahradili Pig za Scalding, ktorý mal Scala API s výhodami, ako je možnosť vytvárať zložité pipelines a jednoduchosť testovania. Napriek tomu mnohým dátovým analytikom a produktovým manažérom, ktorí sa cítili pohodlnejšie pri práci s SQL, to bola dosť strmá krivka učenia. Približne v roku 2016 sme začali používať Presto ako SQL rozhranie pre dáta Hadoop. Spark ponúkal Python rozhranie, ktoré z neho robilo dobrú voľbu pre ad hoc analýzu dát a strojové učenie.
Od roku 2018 sme používali nasledujúce nástroje na analýzu a vizualizáciu dát:
- Scalding pre produkčné pipelines
- Scalding a Spark pre ad hoc analýzu dát a strojové učenie
- Vertica a Presto pre ad hoc a interaktívnu SQL analýzu
- Druid pre malú interaktívnu, experimentálnu a nízkolatenčnú prístup k metrikám časových radov
- Tableau, Zeppelin a Pivot pre vizualizáciu dát
Zistili sme, že hoci tieto nástroje ponúkajú veľmi silné možnosti, stretávali sme sa s problémami pri realizácii prístupnosti týchto možností pre širšie publikum na Twitteri. Expanding our platform through Google Cloud, we focus on simplifying our analytical tools for all of Twitter.
Úložisko dát BigQuery od Google
Niekoľko tímov na Twitteri už zahrnulo BigQuery do niektorých zo svojich produkčných pipelines. Využitím ich skúseností sme začali hodnotiť možnosti BigQuery pre všetky scenáre použitia Twitteru. Naším cieľom bolo ponúknuť BigQuery celej spoločnosti a zároveň ho štandardizovať a udržiavať v rámci súpravy nástrojov Data Platform. To bolo zložitou úlohou z mnohých dôvodov. Museli sme vyvinúť infraštruktúru na spoľahlivú akceptáciu veľkých objemov dát, podporiť správu dát na úrovni celej spoločnosti, zabezpečiť riadne riadenie prístupu a ochranu súkromia klientov. Taktiež sme museli vytvoriť systémy pre distribúciu zdrojov, monitorovanie a účtovanie, aby tímy mohli efektívne využívať BigQuery.
V novembri 2018 sme uviedli alfa verziu BigQuery a Data Studia pre celú spoločnosť. Zamestnancom Twitter sme ponúkli niektoré z našich najčastejšie používaných tabuliek s vyčistenými osobnými údajmi. BigQuery používalo viac ako 250 používateľov z rôznych tímov, vrátane inžinierstva, financií a marketingu. V poslednej dobe vykonávali približne 8 000 dopytov, spracovávajúc približne 100 PB mesačne, bez započítania naplánovaných dopytov. Získavši veľmi pozitívne spätné väzby, rozhodli sme sa pokračovať a ponúknuť BigQuery ako hlavný zdroj pre interakciu s dátami v Twittri.
Tu je schéma vysokoúrovňovej architektúry nášho úložiska dát Google BigQuery.
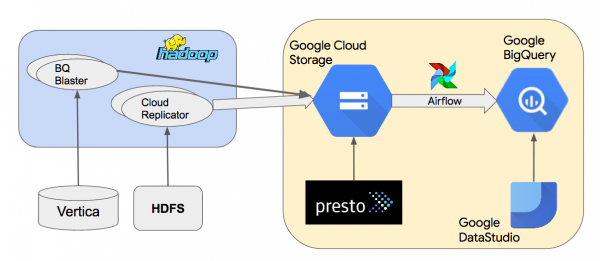
Kopírujeme dáta z lokálnych klastrov Hadoop do Google Cloud Storage (GCS) pomocou interného nástroja Cloud Replicator. Potom používame Apache Airflow na vytváranie potrubí, ktoré používajú „na načítanie dát z GCS do BigQuery. Používame Presto na dotazovanie súborov Parquet alebo Thrift-LZO v GCS. BQ Blaster je interný nástroj Scalding na načítanie súborov HDFS Vertica a Thrift-LZO do BigQuery.
V nasledujúcich sekciách budeme diskutovať o našom prístupe a poznatkoch v oblasti použiteľnosti, výkonu, správy dát, funkčnosti systému a nákladov.
Jednoduchosť používania
Zistili sme, že používateľom bolo ľahké začať s BigQuery, pretože nevyžadovalo inštaláciu softvéru a používatelia k nemu mohli pristupovať prostredníctvom intuitívneho webového rozhrania. Napriek tomu sa používatelia museli oboznámiť s niektorými funkciami GCP a jeho konceptami, vrátane takých zdrojov, ako sú projekty, súbory dát a tabuľky. Vyvinuli sme vzdelávacie materiály a tutoriály, aby sme pomohli používateľom začať. S nadobudnutím základného porozumenia sa používateľom stalo jednoduché navigovať v súboroch dát, prezerať schémy a dáta tabuliek, vykonávať jednoduché dopyty a vizualizovať výsledky v Data Studio.
Naším cieľom pri vkladaní dát do BigQuery bolo poskytnúť hladké načítanie súborov dát HDFS alebo GCS jedným kliknutím myši. Zvažovali sme (spravovaný Airflow), ale nemohli sme ho použiť kvôli našemu modelu bezpečnosti „Domain Restricted Sharing“ (viac informácií nájdete v sekcii „Správa dát“ nižšie). Experimentovali sme s Google Data Transfer Service (DTS) na organizovanie zaťažovacích úloh BigQuery. Zatiaľ čo DTS sa rýchlo nastavilo, nebolo flexibilné na vytváranie potrubí so závislosťami. Pre našu alfa verziu sme vytvorili vlastné prostredie Apache Airflow v GCE a pripravujeme ho na prevádzku v produkcii a na podporu viacerých zdrojov dát, ako je Vertica.
Na transformáciu dát v BigQuery používajú užívatelia jednoduché SQL dátové potrubia, pričom používajú naplánované dotazy. Pre zložité viaceré potrubia so závislosťami plánujeme použiť buď našu vlastnú infraštruktúru Airflow, alebo Cloud Composer spolu s .
Výkon
BigQuery je navrhnutý na SQL dotazy všeobecného použitia, ktoré spracovávajú veľké objemy dát. Nie je určený na dotazy s nízkou latenciou a vysokou priepustnosťou, ktoré sú potrebné pre transakčné databázy, ani na analýzu časových radov s nízkou latenciou, realizovanú . Pre interaktívne analytické dotazy naši užívatelia očakávajú dobu odozvy menšiu ako jednu minútu. Museli sme navrhnúť použitie BigQuery tak, aby spĺňalo tieto očakávania. Na zabezpečenie predvídateľného výkonu pre našich užívateľov sme využili funkčnosť BigQuery dostupnú pre klientov na fixnej platbe, ktorá umožňuje vlastníkom projektov rezervovať minimálne sloty pre svoje dotazy. BigQuery je jednotka výpočtovej sily potrebná na vykonávanie SQL dotazov.
Analyzovali sme viac ako 800 požiadaviek, ktoré spracovávajú približne 1 TB dát, a zistili sme, že priemerný čas spracovania bol 30 sekúnd. Taktiež sme zistili, že výkon silne závisí od využívania našich slotov v rôznych projektoch a úlohách. Museli sme jasne oddeliť naše produkčné a ad hoc rezervy slotov, aby sme udržali výkon pre výrobné scenáre použitia a interaktívnu analýzu. To malo výrazný vplyv na náš dizajn pre rezerváciu slotov a hierarchiu projektov.
O správe dát, funkčnosti a nákladoch systémov sa porozprávame už onedlho v druhej časti prekladu, a teraz pozývame všetkých, ktorí majú záujem, na , v rámci ktorého sa dozviete podrobnosti o kurze a budete mať možnosť klásť otázky nášmu expertovi — Egorovi Matešukovi (Senior Data Engineer, MaximaTelecom).
Čítať ďalej:
Zdroj: habr.com
