

V tomto článku sa dozviete, prečo a ako sme vyvinuli – mechanizmus, ktorý prenáša informácie medzi klientskými aplikáciami a servermi 1C:Enterprise – od stanovenia úlohy po premyslenie architektúry a detailov implementácie.
Systém Interakcie (ďalej – SI) – je distribuovaný, odolný voči chybám systém na výmenu správ s garantovanou dodávkou. SI bol navrhnutý ako vysoko zaťažená služba s vysokou škálovateľnosťou, je dostupný ako online služba (poskytovaná firmou 1C) a aj ako komerčný produkt, ktorý môžete nasadiť na vlastných serverových kapacitách.
SI využíva distribuované úložisko a vyhľadávací systém . Ešte sa budeme venovať Jave a tomu, ako horizontálne škálujeme PostgreSQL.
Stanovenie úlohy
Aby bolo jasné, prečo sme robili Systém Interakcie, poviem niečo o tom, ako sa vyvíjajú biznis aplikácie v 1C.
Najprv – trochu o nás pre tých, ktorí ešte nevedia, čomu sa venujeme :) Vyvíjame technologickú platformu „1C:Enterprise“. Platforma zahŕňa prostriedky na vývoj biznis aplikácií, ako aj runtime, ktorý umožňuje biznis aplikáciám fungovať v multiplatformovom prostredí.
Klient-serverová paradigma vývoja
Biznis aplikácie vytvorené na „1C:Enterprise“ fungujú v trojvrstvovej architektúre „DBMS – server aplikácií – klient“. Aplikačný kód napísaný v , môže bežať na serveri aplikácií alebo na klietne. Celá práca s aplikačnými objektmi (referenciami, dokumentmi atď.), ako aj čítanie a zápis do databázy sa vykonáva iba na serveri. Funkcionalita formulárov a príkazového rozhrania je tiež realizovaná na serveri. Na klietne prebieha získavanie, otváranie a zobrazovanie formulárov, „komunikácia“ s používateľom (upozornenia, otázky…), malé výpočty vo formulároch, ktoré vyžadujú rýchlu reakciu (napríklad násobenie ceny množstvom), práca s lokálnymi súbormi, práca s hardvérom.
V aplikačnom kóde je potrebné jasne uviesť, kde sa bude kód vykonávať — pomocou direktív &NaKliente / &NaServeri (&AtClient / &AtServer v anglickej verzii jazyka). Vývojári v 1C ma teraz opraví, povedia, že direktívy v skutočnosti , ale pre nás to teraz nie je podstatné.
Z klientského kódu je možné vyvolať serverový kód, avšak zo serverového kódu nie je možné vyvolať klientsky kód. Toto je fundamentálne obmedzenie, ktoré sme urobili z viacerých dôvodov. Predovšetkým preto, že serverový kód musí byť napísaný tak, aby sa vykonával rovnako, nech už je vyvolaný odkiaľkoľvek — z klienta alebo zo servera. A v prípade vyvolania serverového kódu z iného serverového kódu klient ako taký absentuje. A preto, že počas vykonávania serverového kódu mohol klient, ktorý ho vyvolal, zatvoriť aplikáciu, čím už nebude koho vyvolávať.

Kód, ktorý spracováva stlačenie tlačidla: vyvolanie serverovej procedúry z klienta sa aktivuje, vyvolanie klientskej procedúry zo servera — nie.
To znamená, že ak chceme zo servera odoslať nejakú správu do klientskej aplikácie, napríklad, že sa skončilo generovanie „dlhého“ reportu a report je možné si pozrieť — taký spôsob nemáme. Musíme sa uchýliť k obstrukciám, napríklad, aby klientský kód pravidelne dotazoval server. Ale taký prístup zaťažuje systém nadbytočnými volaniami a celkovo to nevyzerá veľmi elegantne.
A ešte existuje potreba, napríklad, pri prijatom telefonickom -zvoneskú informovať o tom klientskú aplikáciu, aby našla volajúceho v databáze kontrahentov a zobrazila používateľovi informácie o volajúcom kontrahentovi. Alebo, napríklad, pri prijatí objednávky na sklade upozorniť o tom klientskú aplikáciu objednávateľa. V skratke, existuje mnoho prípadov, kde by taký mechanizmus bol užitočný.
Vlastne formulácia
Vytvoriť mechanizmus výmeny správ. Rýchly, spoľahlivý, s garantovaným doručením a so schopnosťou flexibilného vyhľadávania správ. Na základe mechanizmu implementovať messenger (správy, videohovory), ktorý funguje v rámci aplikácií 1C.
Navrhnúť systém horizontálne škálovateľný. Narastajúca záťaž by mala byť eliminovaná zvýšením počtu uzlov.
Implementácia
Serverovú časť Služby (SV) sme sa rozhodli neimplementovať priamo do platformy 1C:Enterprise, ale realizovať ako samostatný produkt s API, ktoré je možné vyvolať z kódu aplikačných riešení 1C. Urobili sme to z viacerých dôvodov, pričom hlavným bolo umožniť výmenu správ medzi rôznymi aplikáciami 1C (napríklad medzi Riadením Obchodu a Účtovníctvom). Rôzne aplikácie 1C môžu bežať na rôznych verziách platformy 1C:Enterprise, nachádzať sa na rôznych serveroch a podobne. V takýchto podmienkach je realizácia SV ako samostatného produktu, ktorý je „vedľa“ inštalácií 1C, optimálnym riešením.
Takže sme sa rozhodli vytvoriť SV ako samostatný produkt. Malým spoločnostiam odporúčame využívať server SV, ktorý máme nainštalovaný v našom cloude (wss://1cdialog.com), aby sa predišlo nákladom spojeným s miestnou inštaláciou a nastavením servera. Veľkí klienti však môžu považovať za rozumné nainštalovať svoj vlastný server SV na svojich zdrojoch. Podobný prístup sme použili v našom cloudovom SaaS produkte. – vydáva sa ako sériový produkt na inštaláciu u klientov a tiež sa rozprestiera v našom cloude. .
Aplikácia
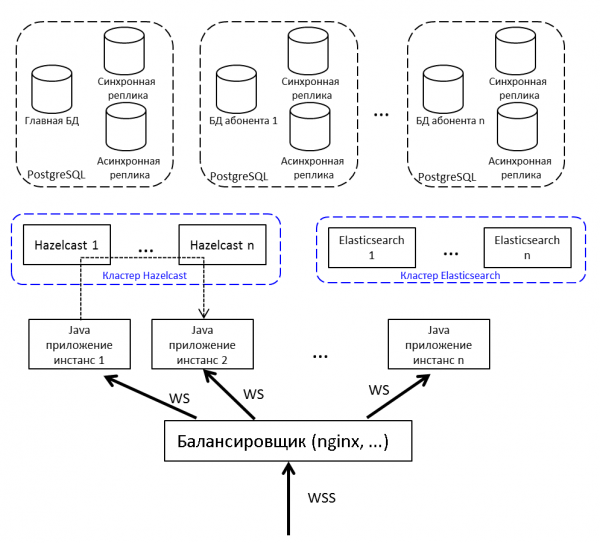
Na rozloženie záťaže a zaisťovanie odolnosti voči chybám nasadíme nie jedno, ale niekoľko Java aplikácií a pred nimi umiestnime vyrovnávač záťaže. Ak je potrebné preniesť správu z uzla na uzol, použijeme publish/subscribe v Hazelcast.
Komunikácia klienta so serverom bude prebiehať cez websocket. Ten je veľmi vhodný pre systémy v reálnom čase.
Distribuovaný cache
Vyberali sme medzi Redis, Hazelcast a Ehcache. Je rok 2015. Redis práve vydal nový klaster (príliš nový, obávame sa), existuje Sentinel s množstvom obmedzení. Ehcache nevie fungovať v clustroch (táto funkcia sa objavila neskôr). Rozhodli sme sa vyskúšať Hazelcast 3.4.
Hazelcast sa dá zoskupiť do clustra „z krabice“. V režime jedného uzla nie je veľmi užitočný a dá sa využiť len ako cache – nevie ukladať údaje na disk, ak stratíme jediný uzol – stratíme údaje. Nasadzujeme niekoľko Hazelcast-ov, medzi ktorými zálohujeme kritické údaje. Cache nezálohujeme – o ten nie je núdza.
Pre nás je Hazelcast:
- Úložisko používateľských relácií. Chodiť po reláciu do databázy je zdĺhavé, preto všetky relácie ukládame do Hazelcast.
- Cache. Hľadáš profil používateľa – skontroluj v cache. Napísal si novú správu – ulož do cache.
- Témy na komunikáciu inštancií aplikácie. Uzol generuje udalosť a umiestňuje ju do témy Hazelcast. Ostatné uzly aplikácie, ktoré sú prihlásené k tejto téme, prijímajú a spracúvajú udalosť.
- Klclusterové zámky. Napríklad vytvárame diskusiu na unikátny kľúč (diskusia-singlton v rámci databázy 1C):
conversationKeyChecker.check("BENZINOVÁ ČERPACIA STANICA");

      doInClusterLock("BENZINOVÁ ČERPACIA STANICA", () -> {

          conversationKeyChecker.check("BENZINOVÁ ČERPACIA STANICA");

          createChannel("BENZINOVÁ ČERPACIA STANICA");
      });
Skontrolovali sme, že kanál neexistuje. Zobrali sme zamknutie, opäť skontrolovali, vytvorili. Ak po získaní zamknutia nebudeme kontrolovať, existuje šanca, že iný vlákno v tomto okamihu tiež kontrolovalo a teraz sa pokúsi vytvoriť rovnakú diskusiu – a tá už existuje. Zamykanie cez synchronized alebo normálny java Lock nie je možné. Cez databázu – pomaly, a databázu je škoda, cez Hazelcast – to, čo potrebujeme.
Vyberáme DBMS
Máme rozsiahle a úspešné skúsenosti s PostgreSQL a spolupráce s vývojármi tejto DBMS.
S klastrom je s PostgreSQL zložitý – sú tu , , , ale celkovo to nie je noSQL, ktoré sa škálujú priamo z krabice. NoSQL ako hlavné úložisko sme nepovažovali, stačilo nám to, že používame Hazelcast, s ktorým sme predtým nepracovali.
Keďže je potrebné škálovať relačnú databázu – znamená to, . Ako viete, pri sharding delíme databázu na samostatné časti tak, aby každú z nich bolo možné previesť na samostatný server.
Prvá možnosť nášho sharding predpokladala možnosť rozdeliť každú z tabuliek našej aplikácie na rôzne servery v rôznych proporciách. Veľa správ na serveri A – prosím, poďme presunúť časť tejto tabuľky na server B. Takéto riešenie len volalo po predčasnej optimalizácii, takže sme sa rozhodli obmedziť na prístup multi-tenant.
O multi-tenant sa môžete dočítať napríklad na stránke .
V Systéme pre Virtuálne Databázy (SV) existujú pojmy aplikácie a predplatiteľa. Aplikácia je konkrétna inštalácia podnikovej aplikácie, napríklad ERP alebo Účtovníctva, so svojimi používateľmi a podnikový dátami. Predplatiteľ je organizácia alebo fyzická osoba, v mene ktorej sa vykonáva registrácia aplikácie na serveri SV. Predplatiteľ môže mať zaregistrovaných niekoľko aplikácií, a tieto aplikácie môžu medzi sebou vy exchanging správy. Predplatiteľ sa stal nájomcom (tenant) v našom systéme. Správy niekoľkých predplatiteľov môžu byť v jednej fyzickej databáze; ak vidíme, že nejaký predplatiteľ generuje veľa prevádzky – presúvame ho do samostatnej fyzickej databázy (alebo dokonca na samostatný server DB).
Máme hlavnú databázu, kde sa uchováva tabuľka smerovania s informáciami o umiestnení všetkých predplatiteľských databáz.
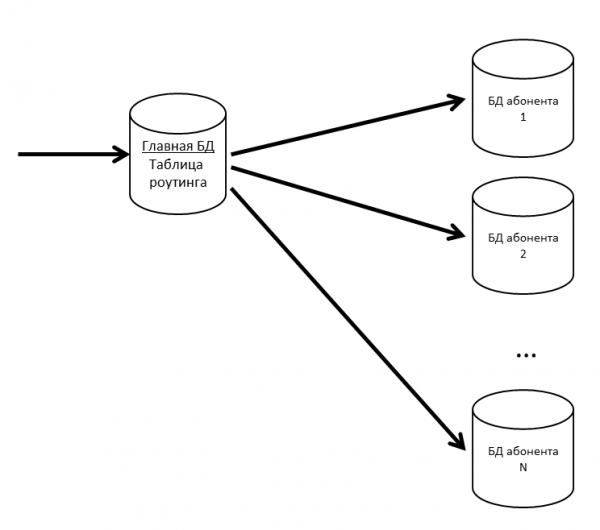
Aby hlavná databáza nebola úzkym miestom, tabuľku smerovania (a iné často požadované údaje) držíme v cache.
Ak začne databáza predplatiteľa spomaľovať, budeme ju vnútorné unikať do partitíc. V iných projektoch pre partitovanie veľkých tabuliek používame .
Keďže stratiť správy používateľov je zlé, podporujeme naše databázy replikami. Kombinácia synchronných a asynchronných replik umožňuje chrániť sa na prípad straty hlavnej databázy. Strata správy sa môže vyskytnúť iba v prípade súčasného zlyhania hlavnej databázy a jej synchronnej repliky.
Ak sa stratí synchronná replika, asynchronná replika sa stane synchronnou.
Ak sa stratí hlavná databáza – synchronná replika sa stane hlavnou databázou, asynchronná replika – synchronnou replikou.
Elasticsearch pre vyhľadávanie
Keďže, okrem iného, je SV aj messenger, je tu potrebné rýchle, pohodlné a flexibilné vyhľadávanie, zohľadňujúce morfológiu, pri nepresných zhody. Rozhodli sme sa nevymýšľať koleso a použiť bezplatný vyhľadávací systém Elasticsearch, vytvorený na základe knižnice . Elasticsearch tiež nasadzujeme v clustre (master – data – data), aby sme vylúčili problémy v prípade zlyhania uzlov aplikácie.
Na github sme našli pre Elasticsearch a používame ho. V indexe Elasticsearch uchovávame koreňové slová (ktoré určuje plugin) a N-gramy. Keď používateľ zadáva text na vyhľadávanie, hľadáme zadaný text medzi N-gramami. Pri ukladaní do indexu sa slovo „texty“ rozdelí na nasledujúce N-gramy:
[te, tek, text, texty, ek, eks, ekst, exty, ks, kst, ksty, st, sty, ty],
Rovnako bude uložený koreň slova „text“. Takýto prístup umožňuje hľadať nielen na začiatku, ale aj v strede a na konci slova.
Celkový obraz
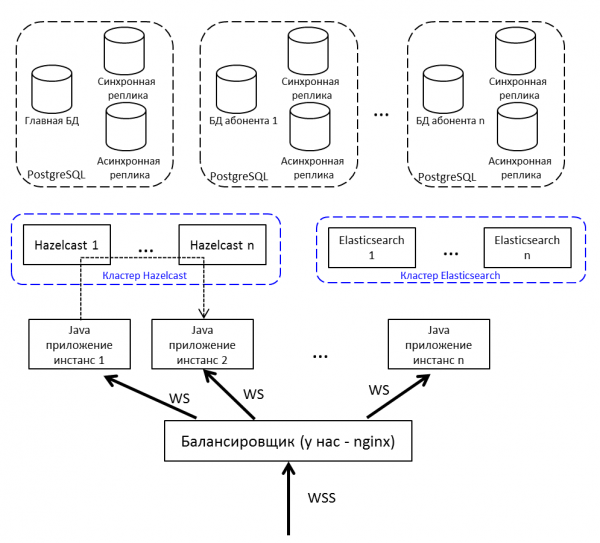
Opakovanie obrázku z úvodu článku, ale už so vysvetleniami:
- Vyvažovač umiestnený na internete; máme – nginx, môže to byť akékoľvek.
- Inštancie Java aplikácie komunikujú medzi sebou cez Hazelcast.
- Na prácu s webovým socketom používame .
- Java aplikácia je napísaná v Jave 8, pozostáva z balíkov . V plánoch – migrácia na Javu 10 a prechod na moduly.
Vývoj a testovanie
Počas vývoja a testovania Svi sme sa stretli s radom zaujímavých vlastností produktov, ktoré používame.
Záťažové testovanie a úniky pamäte
Každé vydanie Svi je záťažovým testovaním. Úspešne prebieha, keď:
- Test bežal niekoľko dní a nebolo žiadnych nedostatkov v službe
- Čas odozvy pre kľúčové operácie neprekročil príjemnú hranicu
- Zhoršenie výkonnosti v porovnaní s predchádzajúcou verziou je maximálne 10%
Testovaciu databázu plníme údajmi – na to získavame z produkčného servera informácie o najaktívnejšom predplatiteľovi, násobíme jeho čísla 5 (počet správ, diskusií, používateľov) a tak testujeme.
Záťažové testovanie systému interakcie vykonávame v troch konfiguráciách:
- Stresový test
- Iba pripojenia
- Registrácia predplatiteľov
Pri stresovom teste spúšťame niekoľko stoviek vlákien, ktoré neustále zaťažujú systém: píšu správy, vytvárajú diskusie, získavajú zoznam správ. Imitujeme činnosti bežných používateľov (získať zoznam mojich nepřečítaných správ, napísať niekomu) a programových riešení (poslať balík do inej konfigurácie, spracovať upozornenie).
Napríklad takto vyzerá časť stresového testu:
- Do systému vstupuje používateľ
- Žiada si svoje nepřečítané diskusie
- S 50% pravdepodobnosťou číta správy
- S 50% pravdepodobnosťou píše správy
- Ďalej používateľ:
- S 20% pravdepodobnosťou vytvára novú diskusiu
- Náhodne vyberá akúkoľvek z jeho diskusií
- Vstupuje dnu
- Požaduje správy, profily používateľov
- Vytvára päť správ adresovaných náhodným používateľom z tejto diskusie
- Odchádza z diskusie
- Opakuje 20-krát
- Odhlasuje sa, vracia sa späť na začiatok scenára
- Do systému sa prihlasuje chatbot (emuluje výmenu správ z kódu aplikačných riešení)
- S 50% pravdepodobnosťou vytvára nový kanál na výmenu údajov (špeciálna diskusia)
- S 50% pravdepodobnosťou píše správu do akéhokoľvek existujúceho kanála
Scenár „Iba pripojenia“ sa objavil nie náhodou. Môže nastal situácia, kedy používatelia pripojili systém, ale zatiaľ sa neangažovali. Každý používateľ si ráno o 09:00 zapne počítač, nadviaže spojenie so serverom a mlčí. Títo chlapci sú nebezpeční, je ich veľa – z paketov majú iba PING/PONG, ale spojenie so serverom udržujú (nemôžu ho prerušiť – čo ak príde nová správa). Test reprodukuje situáciu, keď sa v systéme snaží autentifikovať veľký počet takýchto používateľov za pol hodiny. Pripomína stresový test, ale jeho zameranie je práve na tomto prvom prihlásení – aby neboli odmietania (človek nepoužíva systém, a ten už padá – ťažko vymyslieť niečo horšie).
Scenár registrácie abonentov začína svoj pôvod od prvého spustenia. Urobili sme stresový test a boli sme si istí, že v komunikácii systém nezaostáva. Ale prišli používatelia a začala sa odmlčať registrácia kvôli timeoutu. Pri registrácii sme použili , ktorý je viazaný na entropiu systému. Server nestihol nazbierať dostatok entropie a pri požiadavke na nový SecureRandom zamrzol na desiatky sekúnd. Existuje mnoho spôsobov, ako túto situáciu vyriešiť, napríklad: prejsť na menej bezpečný /dev/urandom, nainštalovať špeciálnu dosku, ktorá vytvára entropiu, generovať náhodné čísla vopred a uchovávať ich v poole. Dočasne sme problém vyriešili pomocou poolu, ale odvtedy vykonávame samostatný test na registráciu nových abonentov.
Ako generátor záťaže používame . Pracovať s web socketom nevie, potrebný je plugin. Prvými výsledkami vo vyhľadávaní na požiadavku „jmeter websocket“ sú , v ktorých odporúčajú .
S tým sme sa rozhodli začať.
Takmer ihneď po začiatku vážneho testovania sme zistili, že v JMeter sa začali objavovať úniky pamäte.
Plugin je samostatný príbeh, má 176 hviezd a 132 forkov na github-e. Samotný autor do neho nekomitoval od roku 2015 (my sme ho vzali v 2015, vtedy to nevzbudilo podozrenie), niekoľko github issue ohľadom únikov pamäte, 7 nezavretých pull requestov.
Ak sa rozhodnete vykonávať záťažové testovanie pomocou tohto pluginu, venujte pozornosť nasledujúcim diskusiám:
- V multithreadovom prostredí bol použitý bežný LinkedList, nakoniec sme dostávali v behu. Rieši sa buď prechodom na ConcurrentLinkedDeque, alebo synchronized blokmi. My sme si vybrali prvú možnosť ().
- Únik pamäte, pri odpojení sa neodstraňuje informácia o pripojení ().
- V režime streamingu (keď sa websocket na konci vzorky neuzatvára, ale sa používa ďalej v pláne) nefungujú Response vzory ().
To je z tých na github-e. Čo sme urobili:
- Vzali sme (@elyrank) – v ňom sú opravené problémy 1 a 3
- Riešili sme problém 2
- Aktualizovali sme jetty z 9.2.14 na 9.3.12
- Ovinuli sme SimpleDateFormat do ThreadLocal; SimpleDateFormat nie je thread-safe, čo viedlo k NPE v behu
- Opravil sme ďalší únik pamäte (nesprávne sa zatváralo pripojenie pri odpojení)
A predsa tečie!
Pamäť sa vyčerpala nie za deň, ale za dva. Čas úplne neostal, rozhodli sme sa spustiť menej vláken, ale na štyroch agentoch. To by malo vystačiť aspoň na týždeň.
Už ubehli dva dni...
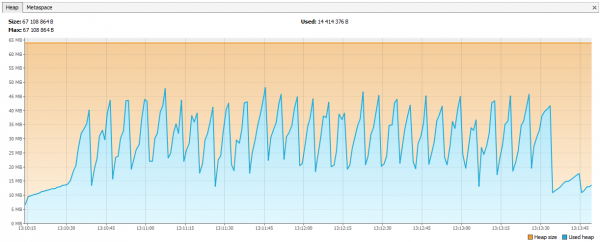
Teraz sa pamäť začala vyčerpávať u Hazelcastu. V logoch sme videli, že po pár dňoch testovania začína Hazelcast sťažovať na nedostatok pamäte a po niekoľkých minútach sa klaster rozpadáva a uzly pokračujú v zániku jeden po druhom. Pripojili sme JVisualVM k hazelcastu a videli sme 'stúpajúcu pílu' – pravidelne vyvolával GC, ale nemohol uvoľniť pamäť.
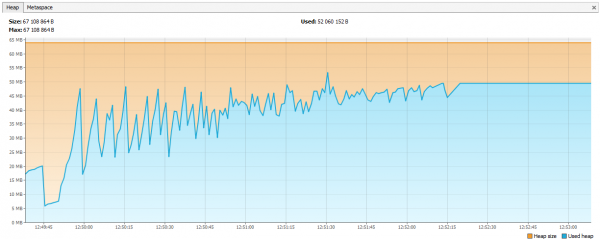
Začalo sa zistiť, že v hazelcast 3.4 pri odstránení mapy / multiMap (map.destroy()) sa pamäť neuvoľňuje úplne:
Teraz je chyba opravená v 3.5, ale vtedy to bola problematika. Vytvárali sme nové multiMap s dynamickými názvami a odstraňovali podľa našej logiky. Kód vyzeral približne takto:
public void join(Authentication auth, String sub) {
    MultiMap sessions = instance.getMultiMap(sub);
    sessions.put(auth.getUserId(), auth);
}

public void leave(Authentication auth, String sub) {
    MultiMap sessions = instance.getMultiMap(sub);
    sessions.remove(auth.getUserId(), auth);

    if (sessions.size() == 0) {
        sessions.destroy();
    }
}
Výzva:
service.join(auth1, "NOVÉ_OZNÁMENIA_V_DISKUSII_UUID1");
service.join(auth2, "NOVÉ_OZNÁMENIA_V_DISKUSII_UUID1");
multiMap sa vytváral pre každé predplatné a uvoľňoval, keď nebol potrebný. Rozhodli sme sa, že vytvoríme Map, kde kľúčom bude názov predplatného a hodnotami budú identifikátory relácií (podľa ktorých neskôr môžeme získať identifikátory používateľov, ak bude potrebné).
public void join(Authentication auth, String sub) {
    addValueToMap(sub, auth.getSessionId());
}

public void leave(Authentication auth, String sub) {
    removeValueFromMap(sub, auth.getSessionId());
}
Grafy sa vyrovnali.
Čo sme sa ešte naučili o záťažovom testovaní
- JSR223 treba písať v groovy a zapnúť compilation cache – je to omnoho rýchlejšie. .
- Grafy Jmeter-Plugins sú ľahšie pochopiteľné ako štandardné. .
O našich skúsenostiach s Hazelcast
Hazelcast bol pre nás nový produkt, začali sme s ním pracovať od verzie 3.4.1, aktuálne máme na našom produkčnom serveri verziu 3.9.2 (v čase písania článku bola posledná verzia Hazelcast – 3.10).
Generovanie ID
Začínali sme s celočíselnými identifikátormi. Predstavme si, že potrebujeme ďalší Long pre novú entitu. Sequence v DB nevyhovuje, tabuľky sa podieľajú na shardingu – výsledkom bude, že existuje správa ID=1 v DB1 a správa ID=1 v DB2, v Elasticsearch taký ID nedáš, ani v Hazelcast, ale najhoršie je, ak by ste chceli zlučovať údaje z dvoch DB do jednej (napríklad, ak sa rozhodnete, že jedna databáza stačí pre týchto predplatiteľov). Môže sa zaviesť v Hazelcast niekoľko AtomicLong a udržiavať čítač tam, takže výkon získania nového ID je – incrementAndGet plus čas na požiadavku do Hazelcast. Avšak v Hazelcast je niečo optimalizovanejšie – FlakeIdGenerator. Každému klientovi pri žiadosti sa pridelí rozsah ID, napríklad prvému – od 1 do 10 000, druhému – od 10 001 do 20 000 a tak ďalej. Teraz môže klient sami vydávať nové identifikátory, kým sa jeho pridelil rozsah neskončí. Funguje to rýchlo, ale po reštartovaní aplikácie (a klienta Hazelcast) začne nová sekvencia – odtiaľ pochádzajú vynechania atď. Okrem toho vývojárom nie je úplne jasné, prečo sú ID celočíselné, ale prichádzajú tak rôzne. Všetko sme zvážili a prešli sme na UUID.
Mimochodom, pre tých, ktorí chcú byť ako Twitter, existuje knižnica Snowcast – implementácia Snowflake nad Hazelcast. Môžete si ju pozrieť tu:
Ale my sme sa k tomu ešte nedostali.
TransactionalMap.replace
Ďalšie prekvapenie: TransactionalMap.replace nefunguje. Tu je taký test:
@Test
public void replaceInMap_putsAndGetsInsideTransaction() {

    hazelcastInstance.executeTransaction(context -> {
        HazelcastTransactionContextHolder.setContext(context);
        try {
            context.getMap("map").put("key", "oldValue");
            context.getMap("map").replace("key", "oldValue", "newValue");

            String value = (String) context.getMap("map").get("key");
            assertEquals("newValue", value);

            return null;
        } finally {
            HazelcastTransactionContextHolder.clearContext();
        }
    });
}

Očakávané : newValue
Skutočné : oldValue
Musel som napísať svoj vlastný replace, pričom som použil getForUpdate:
protected  boolean replaceInMap(String mapName, K key, V oldValue, V newValue) {
    TransactionalTaskContext context = HazelcastTransactionContextHolder.getContext();
    if (context != null) {
        log.trace("[CACHE] Nahrádzanie hodnoty v transakčnej mape");
        TransactionalMap map = context.getMap(mapName);
        V value = map.getForUpdate(key);
        if (oldValue.equals(value)) {
            map.put(key, newValue);
            return true;
        }

        return false;
    }
    log.trace("[CACHE] Nahrádzanie hodnoty v netransakčnej mape");
    IMap map = hazelcastInstance.getMap(mapName);
    return map.replace(key, oldValue, newValue);
}
Testujte nielen bežné dátové štruktúry, ale aj ich transakčné verzie. Niekedy IMap funguje, ale TransactionalMap už nie.
Nahrať nový JAR bez prestojov
Najprv sme sa rozhodli ukladať do Hazelcast objekty našich tried. Napríklad máme triedu Application, chceme ju uložiť a prečítať. Ukladáme:
IMap map = hazelcastInstance.getMap("application");
map.set(id, application);
Čítame:
IMap map = hazelcastInstance.getMap("application");
return map.get(id);
Všetko funguje. Potom sme sa rozhodli vytvoriť index v Hazelcast, aby sme mohli podľa neho vyhľadávať:
map.addIndex("subscriberId", false);A pri pridaní novej entity sme začali dostávať ClassNotFoundException. Hazelcast sa pokúšal doplniť index, ale nič nevedel o našej triede a chcel, aby sme mu dodali JAR s touto triedou. Urobili sme to, všetko sa rozbehlo, ale vznikol nový problém: ako aktualizovať JAR bez úplného zastavenia klastru? Hazelcast neberie nový JAR pri dodatočnej aktualizácii. V tom momente sme sa rozhodli, že môžeme žiť bez vyhľadávania podľa indexu. Veď ak použijeme Hazelcast ako úložisko typu kľúč-hodnota, malo by to fungovať, nie? Nie celkom. Tu opäť fungujú IMap a TransactionalMap rôzne. Kým IMap mu je to jedno, TransactionalMap vyhadzuje chybu.
IMap. Ukladáme 5000 objektov, čítame. Všetko je očakávané.
@Test
void get5000() {
    IMap map = hazelcastInstance.getMap("application");
    UUID subscriberId = UUID.randomUUID();

    for (int i = 0; i < 5000; i++) {
        UUID id = UUID.randomUUID();
        String title = RandomStringUtils.random(5);
        Application application = new Application(id, title, subscriberId);

        map.set(id, application);
        Application retrieved = map.get(id);
        assertEquals(id, retrieved.getId());
    }
}
A v transakcii to nefunguje, dostávame ClassNotFoundException:
@Test
void get_transaction() {
    IMap map = hazelcastInstance.getMap("application_t");
    UUID subscriberId = UUID.randomUUID();
    UUID id = UUID.randomUUID();

    Application application = new Application(id, "qwer", subscriberId);
    map.set(id, application);

    Application retrievedOutside = map.get(id);
    assertEquals(id, retrievedOutside.getId());

    hazelcastInstance.executeTransaction(context -> {
        HazelcastTransactionContextHolder.setContext(context);
        try {
            TransactionalMap transactionalMap = context.getMap("application_t");
            Application retrievedInside = transactionalMap.get(id);

            assertEquals(id, retrievedInside.getId());
            return null;
        } finally {
            HazelcastTransactionContextHolder.clearContext();
        }
    });
}
V 3.8 sa objavil mechanizmus User Class Deployment. Môžete priradiť jednu hlavnú uzol a aktualizovať JAR súbor na nej.
Teraz sme úplne zmenili prístup: sami serializujeme do JSON a ukladáme do Hazelcast. Hazelcast nepotrebuje poznať štruktúru našich tried, a môžeme sa aktualizovať bez prestoja. Verzionovanie doménových objektov spravuje aplikácia. Súčasne môžu byť spustené rôzne verzie aplikácie a môže nastať situácia, keď nová aplikácia zapisuje objekty s novými poľami, zatiaľ čo stará ešte o týchto poliach nevie. A zároveň nová aplikácia číta objekty, ktoré zapísala stará aplikácia, v ktorých nie sú nové polia. Takéto situácie spracovávame v rámci aplikácie, ale pre jednoduchosť nemeníme a neodstraňujeme polia, iba rozširujeme triedy pridaním nových polí.
Ako zabezpečujeme vysoký výkon
Štyri výlety do Hazelcast – dobre, dva do DB – zle
Chodiť po dátach v cache je vždy lepšie ako v databáze, ale nechceme ani uchovávať nepotrebné záznamy. Rozhodnutie o tom, čo cachovať, odkladáme na poslednú fázu vývoja. Keď je nová funkčnosť naprogramovaná, zapneme v PostgreSQL logovanie všetkých dopytov (log_min_duration_statement na 0) a spustíme záťažové testovanie na 20 minút. Z nazbieraných logov náradia ako pgFouine a pgBadger dokážu vytvárať analytické správy. V správach primárne hľadáme pomalé a časté dopyty. Pre pomalé dopyty vytvárame plán vykonávania (EXPLAIN) a posudzujeme, či je možné taký dopyt urýchliť. Časté dopyty so zhodnými vstupnými údajmi sa dobre uložia do cache. Dopyty sa snažíme udržiavať "ploché", s jednou tabuľkou v dopyte.
Prevádzkovanie
Systém Vzájomného Interakcie ako online služba bol spustený na prevádzku na jar 2017, ako samostatný produkt sa Systém Vzájomného Interakcie uviedol na trh v novembri 2017 (v tom čase v beta verzii).
Po viac ako roku prevádzkovania sa vážne problémy v práci online služby Systém Vzájomného Interakcie nevyskytli. Online službu monitorujeme cez , zbierame a nasadzujeme z .
Distribúcia servera Systém Vzájomného Interakcie sa dodáva vo forme natívnych balíkov: RPM, DEB, MSI. Navyše pre Windows poskytujeme jednotného inštalátora vo forme jedného EXE, ktorý inštaluje server, Hazelcast a Elasticsearch na jedno zariadenie. Pôvodne sme túto verziu inštalácie nazývali "demonštračná", ale teraz sa ukázalo, že to je najpopulárnejšia varianta nasadenia.
Zdroj: habr.com
