

Žijeme v úžasnej dobe, keď je možné rýchlo a jednoducho skombinovať niekoľko hotových otvorených nástrojov, nastaviť ich s „vypnutým vedomím“ podľa rád stackoverflow, bez toho, aby sme sa zaoberali „mnohými písmenami“, a spustiť ich do komerčnej prevádzky. A keď bude potrebné aktualizovať/rozširovať alebo niekto náhodou reštartuje pár serverov — uvedomiť si, že začal akýsi vnucujúci sa zlý sen, všetko sa náhle skomplikovalo do nepoznania, cesta späť nie je, budúcnosť je neistá a bezpečnejšie je, namiesto programovania, chovať včely a vyrábať syr.
Nie nadarmo skúsenejší kolegovia, s hlavy zasypanej chybami a z toho už šedivými vlasmi, pozorujúc neuveriteľne rýchle nasadenie balíkov „kontajnerov“ v „kockách“ na desiatkach serverov na „módnych jazykoch“ s vstavanou podporou asynchrónneho-neblokujúceho vstupu-výstupu — skromne sa usmievajú. A mlčky naďalej prečítavajú „man ps“, ponárajú sa do zdrojových kódov „nginx“ a píšu-píšu-píšu unit testy. Kolegovia vedia, že to najzaujímavejšie ich čaká vpred, keď sa „to všetko“ raz stane nočnou morou pod Nový rok. A pomôže im len hlboké chápanie podstaty unixu, zapamätaná tabuľka stavov TCP/IP a základné algoritmy triedenia a vyhľadávania. Aby pod úderom hodín ožili systém znova.
Ach áno, trochu som sa odklonil, ale dúfam, že sa mi podarilo preniesť stav očakávania.
Dnes chcem zdieľať naše skúsenosti s nasadením pohodlného a cenovo dostupného stacku pre DataLake, ktorý rieši väčšinu analytických úloh v spoločnosti pre úplne rôzne organizačné jednotky.
Nedávno sme prišli na to, že spoločnosti potrebujú čoraz viac plody ako produktovej, tak aj technickej analytiky (nepovediac o čerešničkách na torte v podobe machine learning) a na pochopenie trendov a rizík je potrebné zbierať a analyzovať čoraz viac metrik.
Základná technická analytika v „Bitrix24“
Pred niekoľkými rokmi, súčasne so spustením služby „Bitrix24“, sme aktívne investovali čas a zdroje do vytvorenia jednoduché a spoľahlivej analytickej platformy, ktorá by pomáhala rýchlo identifikovať problémy v infraštruktúre a naplánovať ďalšie kroky. Samozrejme, preferovali sme hotové nástroje, čo najjednoduchšie a najzrozumiteľnejšie. V dôsledku toho bol vybraný nagios na monitorovanie a munin na analýzu a vizualizáciu. Teraz máme tisíce kontrol v nagios, stovky grafov v munin a kolegovia ich každý deň úspešne využívajú. Metódy sú zrozumiteľné, grafy jasné, systém funguje spoľahlivo už niekoľko rokov a pravidelne sa pridávajú nové testy a grafy: uvedieme novú službu do prevádzky — pridáme niekoľko testov a grafov. Na zdravie.
Ruka na pulze — rozšírená technická analytika
Túžba získať informácie o problémoch „čo najskôr“ nás priviedla k aktívnym experimentom so jednoduchými a zrozumiteľnými nástrojmi — pinba a xhprof.
Pinba nám posielala v UDP paketoch štatistiky o rýchlosti fungovania častí webových stránok na PHP a bolo možné v reálnom čase vidieť v úložisku MySQL (s pinbou prichádza vlastný motor MySQL na rýchlu analýzu udalostí) krátky zoznam problémov a reagovať na ne. A xhprof v automatickom režime umožňoval zbierať grafy vykonávania najpomalších PHP stránok u klientov a analyzovať, čo to mohlo spôsobiť — pokojne, s šálkou čaju alebo niečo silnejšie.
Pred niekoľkými mesiacmi bol nástroj doplnený o ďalší dosť jednoduchý a zrozumiteľný motor založený na algoritme spätného indexovania, skvele realizovanom v legendárnej knižnici Lucene — Elastic/Kibana. Jednoduchá myšlienka viacerých vlákien na zápis dokumentov do inverzného indexu Lucene na základe udalostí v logoch a rýchle vyhľadávanie pomocou fasetného delenia sa ukázala byť naozaj užitočná.
Napriek dosť technickému vzhľadu vizualizácií v Kibana s „pretekaním hore“ nízkoúrovňových konceptov ako „bucket“ a znovu vynájdenému jazyku, ktorý ešte nie je zabudnutý — nástroj nám dobre pomáhal v nasledujúcich úlohách:
- Koľko chýb PHP malo klient z Bitrix24 na portáli p1 za poslednú hodinu a aké? Pochopiť, odpustiť a rýchlo opraviť.
- Koľko video-hovorov sa uskutočnilo na portáloch v Nemecku za predchádzajúcich 24 hodín, akú mali kvalitu a boli nejaké problémy s kanálom/sieťou?
- Aké je fungovanie systémovej funkcionality (náš rozšírenie na C pre PHP), skompilované z pôvodných zdrojov v poslednej aktualizácii služby a distribuované klientom? Nie sú tam žiadne segfaulty?
- Ukladajú sa údaje klientov do pamäte PHP? Nie sú tam chyby presahujúce vyhradenú pamäť procesov: „out of memory“? Nájdi a neutralizuj.
Tu je konkrétny príklad. Napriek dôkladnému a viacúrovňovému testovaniu sa u klienta pri veľmi netradičnom prípade a poškodených vstupných údajoch objavila nepríjemná a neočakávaná chyba, zaznela siréna a začal sa proces jej rýchlej opravy:
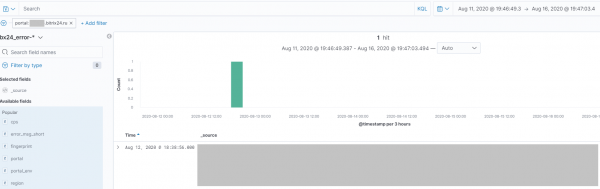
Okrem toho, kibana umožňuje organizovať upozornenia na vybrané udalosti a v krátkom čase sa tento nástroj stal v spoločnosti používaný desiatkami zamestnancov z rôznych oddelení – od technickej podpory a vývoja po QA.
Aktivitu akéhokoľvek oddelenia v rámci spoločnosti bolo možné pohodlne sledovať a merať – namiesto ručného analýzy logov na serveroch stačilo raz nastaviť parsovanie logov a ich odoslanie do klastru elastic, aby ste si mohli vychutnávať, napríklad, pohľad na dashboarde kibana so stovkami predaných dvojhlavých mačiatok, vytlačených na 3D tlačiarni za minulý lunárny mesiac.
Základná obchodná analýza
Všetci vedia, že obchodná analýza vo firmách často začína extrémne aktívnym využívaním, áno, áno, Excelu. Ale najdôležitejšie je, aby tam neskončila. Olej do ohňa ešte dobre prilieva cloudový Google Analytics – na dobré sa rýchlo zvyká.
V našej, harmonicky sa rozvíjajúcej spoločnosti, sa tu a tam objavovali „proroci“ intenzívnejšej práce s väčšími údajmi. Pravidelne sa objavovali požiadavky na hlbšie a komplexnejšie správy a úsilím chalanov z rôznych oddelení bolo pred niekoľkými mesiacmi zorganizované jednoduché a praktické riešenie – prepojenie ClickHouse a PowerBI.
Celkom dlhý čas toto flexibilné riešenie vynikajúco pomáhalo, ale postupne sa začalo chápať, že ClickHouse nie je gumený a nemôžeme sa ním tak zle zaobchádzať.
Tu je dôležité dobre pochopiť, že ClickHouse, rovnako ako Druid, Vertica a Amazon RedShift (ktorý je založený na Postgres), sú analytické enginy optimalizované na pomerne pohodlnú analytiku (súhrny, agregácie, minimum maximum v stĺpci a len niekoľko spojení), pretože sú organizované na efektívne uloženie stĺpcov relačných tabuliek, na rozdiel od známeho MySQL a ďalších (báz orientovaných na riadky).
V podstate je ClickHouse len priestrannejšia 'baza' dát, s nie veľmi pohodlným bodovým vkladom (tak to bolo zamýšľané, všetko v poriadku), ale s príjemnou analytikou a zaujímavou sadou mocných funkcií na prácu s dátami. Áno, môžete dokonca vytvoriť klaster — ale, chápete, že zatĺkať klince mikroskopom nie je úplne správne, a začali sme hľadať iné riešenia.
Dopyt po Pythone a analytikoch
V našej spoločnosti je veľa vývojárov, ktorí píšu kód takmer každý deň už 10-20 rokov v PHP, JavaScripte, C#, C/C++, Jave, Go, Rust, Pythone, Bashi. Taktiež máme mnoho skúsených systémových administrátorov, ktorí prežili nie jednu úplne neuveriteľnú katastrofu, ktorá sa nezmestila do zákonov štatistiky (napríklad, keď je zničená väčšina diskov v raid-10 pri silnom údere blesku). V takých podmienkach dlho nebolo jasné, čo to vlastne znamená 'analytik na Pythone'. Python je predsa len ako PHP, iba názov je o niečo dlhší a stopy látok, ktoré menia vedomie, v zdrojovom kóde interpretera je o niečo menej. Avšak s pribúdajúcimi analytickými správami sa skúsení vývojári čoraz hlbšie zamýšľali nad dôležitosťou úzkej špecializácie v nástrojoch ako numpy, pandas, matplotlib a seaborn.
Rozhodujúcu úlohu, pravdepodobne, hrali náhle mdloby zamestnancov od kombinácie slov 'logistická regresia' a prezentácia efektívneho zostavovania správ z objemových dát pomocou áno, áno, pyspark.
Apache Spark, jeho funkčná paradigma, na ktorú skvele zapadá relačná algebra a možnosti zapôsobila na vývojárov zvyknutých na MySQL tak, že potreba posilniť bojové rady skúsenými analytikmi sa stala jasnou ako deň.
Ďalšie pokusy Apache Spark/Hadoop vzlietnuť a čo nešlo celkom podľa plánu
Avšak čoskoro sa ukázalo, že so Sparkom je zrejme niečo systémovo nesprávne, alebo je potrebné lepšie si umývať ruky. Kým stack Hadoop/MapReduce/Lucene vytvárali dostatočne skúsení programátori, čo je očividné, ak sa pozrieme na zdrojové kódy v Jave alebo myšlienky Duga Cuttinga v Lucene, Spark je náhle napísaný v veľmi kontroverznom jazyku Scala, z praktického hľadiska nezrozumiteľnom a momentálne sa nerozvíjajúcom. Zosúladené výpočty v klastri Spark, kvôli nelogickej a nie veľmi jasnej práci s alokáciu pamäte pre operácie reduce (prichádza hneď veľa kľúčov) — vytvorilo okolo neho aureolu niečoho, čo má kam rásť. Ďalšie zhoršovanie situácie spôsobovalo množstvo podivných otvorených portov, dočasných súborov rastúcich na tých najnenápadnejších miestach a administrácie jar-závislostí — čo vyvolávalo u systémových administrátorov jedno známe detstvo pocit: nepriateľskú nenávisť (a možno bolo potrebné umyť si ruky mydlom).
My sme, v dôsledku toho, "prežili" niekoľko interných analytických projektov, ktoré aktívne používali Apache Spark (vrátane Spark Streaming, Spark SQL) a ekosystém Hadoop (a ďalšie a ďalšie). Napriek tomu, že sme sa v priebehu času naučili "to" celkom dobre pripravovať a monitorovať a "predmet" prakticky prestal náhle padať kvôli zmene charakteru údajov a nevyváženosti rovnomerného hashovania RDD, túžba získať niečo už hotové, aktualizované a spravované niekde v cloude sa stále viac a viac zintenzívnila. Presne v tomto čase sme sa pokúsili využiť hotové cloudové riešenie Amazon Web Services — a neskôr sme sa snažili už riešiť úlohy na ňom. EMR je pripravený Amazonom Apache Spark s dodatočným softvérom z ekosystému, približne ako Cloudera/Hortonworks zostavy.
"Gumové" úložisko pre analytiku — naliehavá potreba
Skúsenosť so "prípravou" Hadoop/Spark s popáleninami rôznych častí tela neprešla nadarmo. Začala sa zreteľnejšie vykresľovať potreba vytvorenia jednotného, lacného a spoľahlivého úložiska súborov, ktoré by odolávalo hardvérovým haváriám a v ktorom by bolo možné ukladať súbory v rôznych formátoch z rôznych systémov a robiť efektívne a v rozumnom čase vykonávané výbery pre správy.
Rádi bychom, aby aktualizace softwaru na této platformě nebyla noční můrou, kdy bychom museli číst 20stránkové Java stack trace a analyzovat kilometry podrobného logování provozu clusteru pomocí Spark History Server a lupy se zvýrazněním. Chtěli bychom mít jednoduchý a transparentní nástroj, který nevyžaduje pravidelné nahlížení pod kapotu, kdyby u vývojáře přestala fungovat standardní MapReduce dotaz při vyběhnutí z paměti pracovníka reduce dat kvůli špatně zvolenému algoritmu partitionování původních dat.
Je Amazon S3 uchazečem o DataLake?
Zkušenosti s Hadoop/MapReduce mě naučily, že je potřebné mít také škálovatelný a spolehlivý souborový systém a nad ním škálovatelné pracovníky, kteří přicházejí co nejblíž k datům, aby nebylo nutné posílat data přes síť. Pracovníci by měli být schopni číst data v různých formátech, ale ideálně by neměli číst zbytečné informace a mělo by být možné předem ukládat data v pracovníky pohodlných formátech.
Ještě jednou — hlavní myšlenka. Nemáme zájem "nahrávat" velká data do jednoho clusterového analytického stroje, který se nakonec stejně utopí a budeme ho muset nehezky shardovat. Chceme ukládat soubory, prostě soubory, v srozumitelného formátu a provádět na nich efektivní analytické dotazy různými, ale srozumitelnými nástroji. A souborů v různých formátech bude stále více. A lépe shardovat ne stroj, ale původní data. Potřebujeme rozšiřitelný a univerzální DataLake, rozhodli jsme se…
A co kdybychom ukládali soubory v tradičním a mnoha lidem známém škálovatelném cloudovém úložišti Amazon S3, aniž bychom se museli zabývat přípravou "odříznutých" variant z Hadoop?
Jasně, osobní údaje "nepřichází v úvahu", ale co ostatní data, pokud by se tam přesunula a "efektivně poháněla"?
Klastrový big data analytický ekosystém Amazon Web Services — velmi jednoduše řečeno
Podle našich zkušeností s AWS se tam už dlouho a aktivně používá Apache Hadoop/MapReduce pod různými omáčkami, například v službě DataPipeline (závidím kolegům, naučili se ho správně připravovat). Tady jsme nastavili zálohy z různých služeb z tabulek DynamoDB:
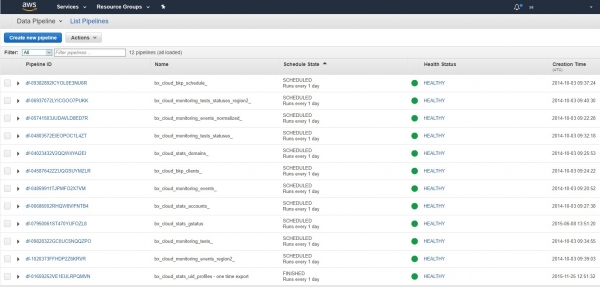
A pravidelně se provádějí na vestavěných clusterech Hadoop/MapReduce jako hodinky už několik let. "Nastavit a zapomenout":
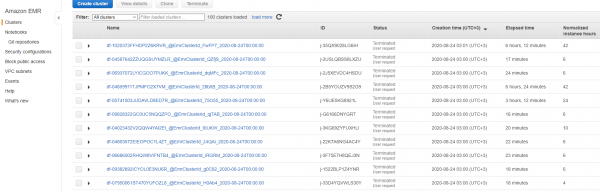
Taktiež je možné efektívne sa zaoberať dátovým satanizmom, spustiť pre analytikov Jupiter-notebooky v cloude a využiť na učenie a nasadenie modelov AI službu AWS SageMaker. Takto to vyzerá u nás:
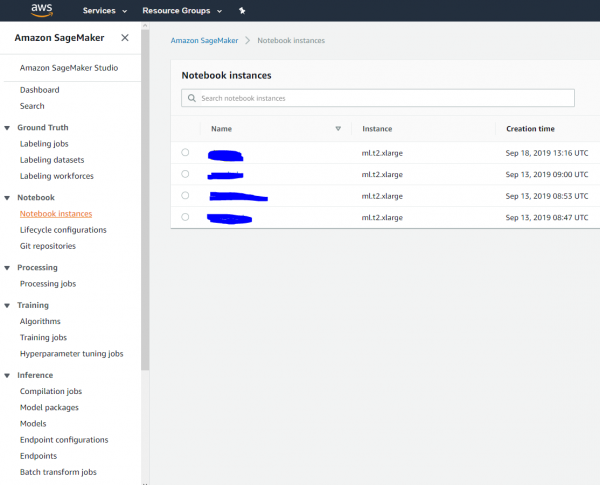
A áno, môžete si spustiť notebook v cloude alebo pre analytiku a pripojiť ho k Hadoop/Spark klastru, vypočítať a potom všetko „pribiť“:
Naozaj pohodlné pre jednotlivé analytické projekty a pre niektoré sme úspešne použili službu EMR na rozsiahle prepočty a analýzy. A čo systémové riešenie pre DataLake, bude to fungovať? V tom momente sme boli na pokraji nádeje a beznádeje a pokračovali sme v hľadaní.
AWS Glue – elegantne zabalený Apache Spark „na sternády“
Ukázalo sa, že AWS má „svoju“ verziu stacku „Hive/Pig/Spark“. Rolu Hive, t.j. katalóg súborov a ich typov v DataLake, plní služba „Data catalog“, ktorá sa ani neskrýva o svojej kompatibilite s formátom Apache Hive. Do tejto služby treba pridať informácie o tom, kde sú vaše súbory a v akom sú formáte. Údaje môžu byť nielen v s3, ale aj v databáze, ale o tom nie je tento príspevok. Takto je u nás organizovaný katalóg dát DataLake:
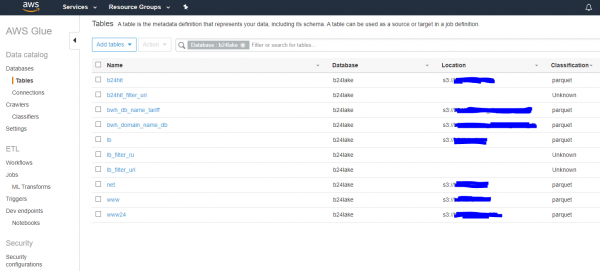
Súbory sú registrované, výborne. Ak sa súbory aktualizovali – spúšťame buď manuálne alebo podľa rozvrhu crawlers, ktoré aktualizujú informácie o nich z jazera a uložia. Potom je možné údaje z jazera spracovávať a výsledky niekam exportovať. V najjednoduchšom prípade – exportujeme tiež do s3. Spracovanie údajov je možné robiť kdekoľvek, ale odporúča sa nastaviť proces spracovania na klastri Apache Spark s využitím rozšírených funkcií prostredníctvom API AWS Glue. V podstate je možné vziať starý dobrý a známy kód v pythone s použitím knižnice pyspark a nastaviť jeho vykonávanie na N uzloch klastra nejakej kapacity s monitorovaním, bez hrabania sa v útrobách Hadoop a ťahania docker-mokré kontajnerov a odstraňovania konfliktov závislostí.
Ešte raz – jednoduchá myšlienka. Nie je potrebné nastavovať Apache Spark, stačí napísať kód v pythone pre pyspark, otestovať ho lokálne na pracovnej ploche a potom ho spustiť na veľkom klastri v cloude, указав, kde sa nachádzajú zdrojové údaje a kam uložiť výsledok. Niekedy je to potrebné a užitočné a takto to máme nastavené u nás:
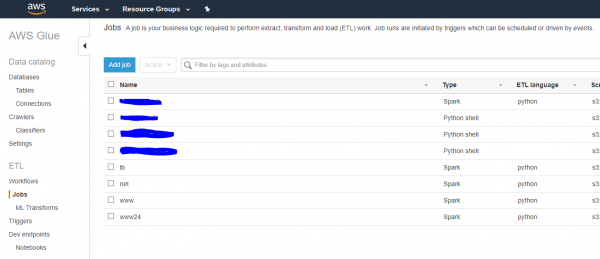
Takže, ak potrebujete niečo prepočítať na Spark klastri na údajoch v s3 – napíšeme kód v python/pyspark, otestujeme a do dobrého smeru do cloudu.
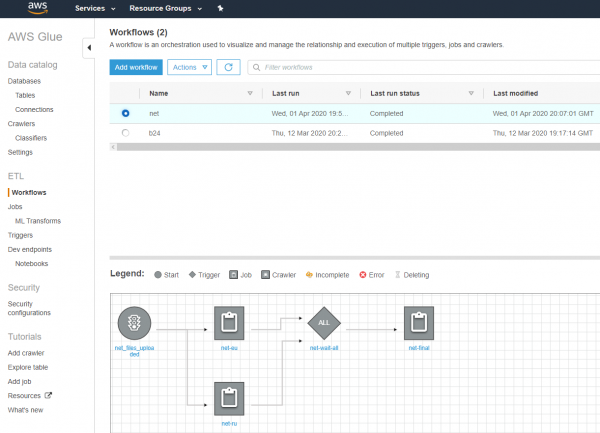
A čo s orchestráciou? A čo ak úloha spadla a zmizla? Áno, je navrhnuté vytvoriť pekný pipeline v štýle Apache Pig a aj sme sa o to pokúsili, ale zatiaľ sme sa rozhodli použiť našu hlboko prispôsobenú orchestráciu na PHP a JavaScript (chápem, že vzniká kognitívny disonanc, ale funguje to, roky a bez chýb).
Formát súborov uložených v jazere — kľúč k výkonnosti
Je naozaj veľmi dôležité pochopiť ešte dva kľúčové momenty. Aby sa dopyty na dáta súborov v jazere vykonávali maximálne rýchlo a výkonnosť sa neznižovala pri pridávaní nových informácií, je potrebné:
- Stĺpce súborov uchovávať zvlášť (aby nebolo potrebné prečítať všetky riadky, aby sme pochopili, čo je v stĺpcoch). Na to sme vzali formát parquet so zhlukovaním
- Je veľmi dôležité shardovať súbory podľa priečinkov v duchu: jazyk, rok, mesiac, deň, týždeň. Enginy, ktoré rozumejú tomuto typu shardovania, sa budú pozerať iba do potrebných priečinkov, bez toho, aby prehľadávali všetky dáta naraz.
V podstate týmto spôsobom vystavujete pôvodné dáta v najefektívnejšej forme pre analytické enginy, ktoré dokážu selektívne vstupovať do shardovaných priečinkov a čítať iba potrebné stĺpce. Niekam ich „nalievať“ netreba (úložisko by predsa jednoducho prasklo) — jednoducho ich hneď rozumne umiestnite do súborového systému v správnom formáte. Samozrejme, tu by malo byť jasné, že uchovávať v DataLake obrovský csv súbor, ktorý musí byť najprv celý riadok po riadku prečítaný klastrom, aby sa extrahovali stĺpce — nie je veľmi rozumné. Znovu si premyslite dva vyššie uvedené body, ak to zatiaľ nie je jasné, prečo je toto všetko dôležité.
AWS Athena — „čert“ z tabatierky
A tu, pri vytváraní jazera, sme, akosi mimochodom, narazili na Amazon Athena. Zrazu sa ukázalo, že ak správne usporiadame naše obrovské logy do shardov-priečinkov v správnom (parquet) stĺpcovom formáte — dá sa veľmi rýchlo robiť mimoriadne informatívne výbery a vytvárať správy BEZ apache Spark/Glue klastra.
Engin Athena, ktorý pracuje s dátami v s3, je založený na legendárnom — reprezentant rodiny MPP (massive parallel processing) prístupov k spracovaniu údajov, berúci údaje tam, kde sa nachádzajú, od s3 a Hadoop po Cassandra a bežné textové súbory. Stačí požiadať Athena, aby vykonala SQL dotaz, a všetko "pracuje rýchlo a samo". Je dôležité poznamenať, že Athena je "inteligentná", ide len do potrebných rozdelených priečinkov a načítava len potrebné stĺpce v dopyte.
Spôsob účtovania dotazov do Atheny je tiež zaujímavý. Platíme za . T.j. nie za počet strojov v klastri za minútu, ale… za naozaj prehľadané údaje len potrebné na vykonanie dotazu na 100-500 strojoch.
A keď požadujeme len potrebné stĺpce z správne rozdelených priečinkov, ukázalo sa, že služba Athena nás stojí desiatky dolárov mesačne. No predsa skvele, takmer zadarmo v porovnaní s analytikou na klastraoch!
Tu, mimochodom, ako rozdeľujeme svoje údaje v s3:
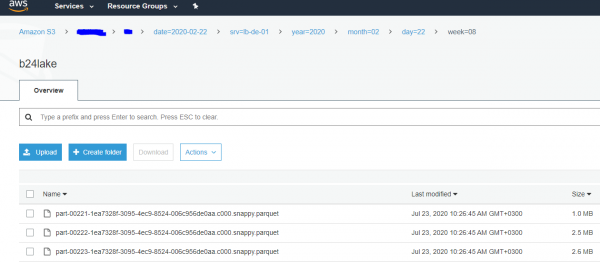
Výsledkom je, že za krátky čas sa v spoločnosti úplne rôzne oddelenia, od informačnej bezpečnosti po analytiku, začali aktívne pýtať na Athenou a rýchlo, za sekundy, dostávať užitočné odpovede z "veľkých" údajov za pomerne dlhé časové obdobia: mesiace, polrok a pod.
Ale šli sme ďalej a začali sa pýtať na odpovede v oblaku : analytik v obvyklej konzole píše SQL dotaz, ktorý na 100-500 strojoch "za malé peniaze" prehľadáva údaje v s3 a zvyčajne vracia odpoveď za niekoľko sekúnd. Pohodlné. A rýchle. Doteraz tomu nemôžem uveriť.
Nakoniec, rozhodnutím uchovávať údaje v s3, v efektívnom stĺpcovom formáte a s rozumným delením údajov po priečinkoch… sme dostali DataLake a rýchly a lacný analytický engine — zadarmo. A stal sa veľmi populárnym v spoločnosti, pretože rozumie SQL a pracuje rádovo rýchlejšie, ako zadaním/pozastavením/nastavením klastra. "A ak je výsledok rovnaký, prečo platiť viac?"
Dotaz do Atheny vyzerá približne takto. Ak si želáte, samozrejme, môžete vytvoriť dosť , ale obmedzíme sa na jednoduché agregovanie. Pozrieme sa, aké chybové kódy mal klient pred niekoľkými týždňami v logoch práce webového servera a presvedčíme sa, že nie sú žiadne chyby:
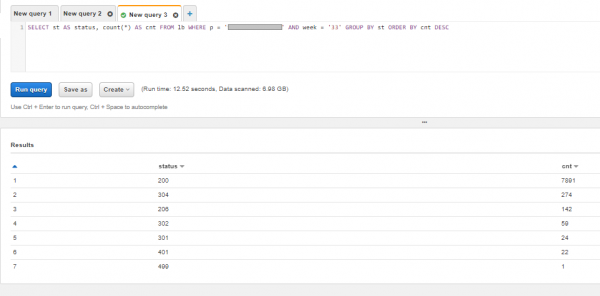
Zhrnutie
Po ceste, ktorá nebola dlhá, ale bolestná, sme neustále adekvátne hodnotili riziká, úroveň zložitosti a náklady na údržbu a našli sme riešenie pre DataLake a analytiku, ktoré nás neprestáva tešiť ako rýchlosťou, tak aj nákladmi na vlastníctvo.
Ukázalo sa, že vybudovať efektívny, rýchly a lacný na prevádzku DataLake pre potreby úplne rôznych oddelení spoločnosti je úplne v silách aj skúsených vývojárov, ktorí nikdy nepracovali ako architekti a nevedia kresliť šípky na štvorce a poznajú 50 termínov z ekosystému Hadoop.
Na začiatku cesty ma bolela hlava z množstva neuveriteľných zoologických záhrad otvoreného a uzatvoreného softvéru a rozmeru zodpovednosti voči budúcim generáciám. Jednoducho začnite budovať svoj DataLake od jednoduchých nástrojov: nagios/munin -> elastic/kibana -> Hadoop/Spark/s3…, zbierajúc spätnú väzbu a hlboko rozumejúc fyzike prebiehajúcich procesov. Všetko zložité a nejasné odovzdajte nepriateľom a konkurentom.
Ak nechcete do cloudu a radi sa staráte, aktualizujete a patchujete otvorené projekty, môžete vybudovať analóg našej schémy lokálne, na kancelárskych lacných strojoch s Hadoop a Presto navrch. Hlavné je neprestať a ísť dopredu, počítať, hľadať jednoduché a jasné riešenia a všetko sa určite podarí! Šťastie všetkým a do nových stretnutí!
Zdroj: habr.com
