

Ahojte, Habr! Posledné pár mesiacov sme prežili vo veľmi zaujímavej situácii a chcel by som sa podeliť o nášu príbeh o škálovaní infraštruktúry. Počas tohto obdobia SberMarket zvýšil objem objednávok štvornásobne a spustil službu v 17 nových mestách. Explozívny rast dopytu po doručení potravín si vyžiadal od nás rozširovanie infraštruktúry. O najzaujímavejších a najužitočnejších poznatkoch čítajte pod katom.
Volám sa Dima Bobylev, som technický riaditeľ SberMarketu. Keďže toto je prvý príspevok v našom blogu, poviem pár slov o sebe a o spoločnosti. Minulú jeseň som sa zúčastnil súťaže mladých lídrov RuNetu. Pre túto súťaž som o tom, ako my v SberMarkete vidíme vnútornú kultúru a prístup k rozvoju služby. A hoci sa mi v súťaži nepodarilo vyhrať, formuloval som si hlavné zásady rozvoja IT-ekosystému.
Pri riadení tímu je dôležité rozumieť a nájsť rovnováhu medzi tým, čo potrebuje biznis, a potrebami každého konkrétneho vývojára. V súčasnosti SberMarket rastie 13-krát ročne, čo ovplyvňuje produkt a vyžaduje neustále zvyšovanie objemov a tempa vývoja. Napriek tomu vyčleňujeme dostatok času pre vývojárov na predbežnú analýzu a kvalitné písanie kódu. Ustanovený prístup pomáha nielen pri vytváraní funkčného produktu, ale aj pri jeho ďalšom škálovaní a rozvoji. V dôsledku takého rastu sa SberMarket už stal lídrom medzi službami doručovania potravín: denne doručujeme približne 18 tisíc objednávok, hoci ešte na začiatku februára ich bolo len okolo 3500.
Raz zákazník požiadal kuriéra SberMarketu, aby mu doručil potraviny bezkontaktným spôsobom — priamo na balkón.
Ale poďme k praktickému. Posledné mesiace sme aktívne pracovali na rozširovaní infraštruktúry našej spoločnosti. Tento potrebný krok bol spôsobený vonkajšími a vnútornými faktormi. Spolu so zvyšovaním našej klientely sa počet pripojených obchodov zvýšil z 90 na začiatku roka na viac ako 200 do polovice mája. Samozrejme, pripravili sme sa, rezervovali sme hlavnú infraštruktúru a kalkulovali sme s možnosťou vertikálneho a horizontálneho rozširovania všetkých virtuálnych strojov umiestnených v cloude Yandex. Avšak prax ukázala: „Všetko, čo môže ísť zle, pôjde zle.“ Dnes by som chcel zdieľať niekoľko zaujímavých situácií, ktoré sa vyskytli počas týchto týždňov. Dúfam, že naše skúsenosti budú pre vás užitočné.
Slave je v plnej bojovej pohotovosti
Ešte pred začiatkom pandémie sme sa stretli s rastom počtu požiadaviek na naše backend servery. Trend objednávania produktov s doručením domov sa začal vyvíjať, a s príchodom prvých opatrení izolácie v súvislosti s COVID-19, sa záťaž dramaticky zvyšovala pred očami počas celého dňa. Vznikla potreba rýchlo uvoľniť master servery hlavnej databázy a presunúť časť požiadaviek na čítanie na repliku serverov (slave).
Na tento krok sme sa vopred pripravili, a pre tento manéver sme už spustili 2 slave servery. Na nich sa prevažne vykonávali batch úlohy generovania informačných feedov na výmenu údajov s partnermi. Tieto procesy vytvárali zbytočnú záťaž a právom boli presunuté „mimo zretelia“ pred niekoľkými mesiacmi.
Keďže na Slave prebiehal replikácia, dodržiavali sme koncepciu, že aplikácie môžu s nimi pracovať iba v režime len na čítanie. Disaster Recovery Plan predpokladal, že v prípade katastrofy budeme môcť jednoducho pripojiť Slave miesto Master a prepnúť všetky požiadavky na zápis a čítanie na Slave. Chceli sme však tiež využiť repliky na potreby analytického oddelenia, takže servery neboli úplne premenené na status len na čítanie, a na každom hoste bol svoj vlastný súbor používateľov, pričom niektorí mali práva na zápis na uchovanie medzičasových výsledkov výpočtov.
Do určité úrovne zaťaženia nám stačil master na zápis aj čítanie pri spracovaní http-žiadostí. V polovici marca, práve keď Sbermarket prijal rozhodnutie prejsť na prácu z domu, sme zažili výrazný nárast RPS. Čoraz viac našich klientov prešlo na samoizoláciu alebo prácu z domu, čo sa odrazilo na ukazovateľoch zaťaženia.
Výkon „mastera“ prestal byť dostačujúci, a preto sme začali presúvať časť najnáročnejších čítacích požiadaviek na replikáciu. Na transparentné smerovanie požiadaviek na zápis do mastera, a čítanie do slave, sme použili ruby gem „“. Vytvorili sme špeciálneho používateľa s postfixom _readonly bez práv na zápis. Ale v dôsledku chyby v konfigurácii jedného z hostiteľov sa časť požiadaviek na zápis dostala na slave-server pod menom používateľa, ktorý mal príslušné práva.
Problém sa neprejavil hneď, pretože zvýšené zaťaženie zvýšilo oneskorenie sláv. Nekonzistencia dát bola zistená ráno, keď po nočných importoch slávy nedohnali master. Pripísali sme to na vysoké zaťaženie samotného servisu a importy spojené so spustením nových obchodov. Ale poskytovanie údajov s hodinovým oneskorením bolo neprijateľné, a tak sme prepli procesy na druhého analytického slave, pretože mal väčšie zdroje a nebol zaťažený požiadavkami na čítanie (čím sme si aj vysvetlili absenciu lagovania replikácie).oKeď sme sa vysporiadali s príčinami „rozchodu“ hlavného slave, analytický už bol mimo prevádzky z rovnakého dôvodu. Napriek tomu, že sme mali dva ďalšie servery, na ktoré sme plánovali presunúť zaťaženie v prípade zlyhania mastera, kvôli hlúpej chybe sa ukázalo, že v kritickej chvíli neexistoval ani jeden.
Ale keďže sme robili nielen dump databázy (obnova trvala približne 5 hodín), ale aj snapshot master-servera, podarilo sa nám spustiť replikáciu za 2 hodiny. Pravda, po tom nás čakalo nahrávanie replikačného logu na dlhú dobu (pretože proces prebieha v jednopriestorovom režime, ale to je už úplne iný príbeh).
Keďže sme nielenže robili dump databázy (restaurácia trvala približne 5 hodín), ale aj snapshot master-servera, podarilo sa nám spustiť replikáciu za 2 hodiny. Po tom nás však čakal dlhý proces aplikácie replikačného logu (pretože proces prebieha v jednovláknovom režime, ale to je už úplne iný príbeh).
Výstup: Po takom incidente sa stalo jasné, že je potrebné vzdať sa praxe obmedzenia záznamu pre používateľov a vyhlásiť celý server za readonly. Pri takomto prístupe si môžeme byť istí, že repliky budú dostupné v kritickom okamihu.
Optimalizácia aj len jedného ťažkého dopytu môže "vzbudiť" databázu.
Aj keď neustále aktualizujeme katalóg na stránke, dopyty, ktoré sme presunuli na Slave servery, mali mierne oneskorenie oproti Master. Čas, za ktorý sme objavili a odstránili problém "násilne odstavených" slave-ov, bol dlhší ako "psychologická bariéra" (počas tohto času mohlo dôjsť k aktualizácii cien, a klienti by videli zastarané údaje), a boli sme nútení prepnúť všetky dopyty na hlavný server databázy. Výsledkom bolo, že stránka fungovala pomaly... ale aspoň fungovala. A kým sa Slave obnovoval, nemali sme inú možnosť, než optimalizovať.
Kým sa Slave servery obnovovali, minúty sa pomaly ťahali, Master zostával preťažený a sústredili sme všetky sily na optimalizáciu aktívnych úloh podľa „Pravidla Pareto“: vybrali sme TOP dopyty, ktoré spôsobovali najväčšiu záťaž a začali s laděním. Robilo sa to priamo "za jazdy".
Zaujímavý efekt spočíval v tom, že MySQL prispôsobený na maximum reaguje na aj nepatrné zlepšenie procesov. Optimalizácia niekoľkých dopytov, ktoré tvorili len 5% celkovej záťaže, už ukázala výrazné uvoľnenie CPU. Výsledkom sa nám podarilo zabezpečiť akceptovateľný prebytok zdrojov pre prácu Master s databázou a získať potrebný čas na obnovu replik.
Výstup: Aj drobná optimalizácia umožňuje "prežiť" pri preťažovaní počas niekoľkých hodín. To nám stačilo na čas obnovy serverov s replikami. Mimochodom, technickú stránku optimalizácie dopytov prediskutujeme v jednom z nasledujúcich príspevkov. Tak sa prihláste na odber nášho blogu, ak by sa vám to mohlo hodiť.
Zorganizujte monitorovanie funkčnosti služieb partnerov.
Zaoberáme sa spracovaním objednávok od zákazníkov, a preto naše služby neustále komunikujú so spoľahlivými API — sú to brány na zasielanie SMS, platobné platformy, systémy smerovania, geokodér, služba FSN a množstvo iných systémov. A keď sa zaťaženie rýchlo zvýšilo, začali sme narazínať na obmedzenia API našich partnerských služieb, o ktorých sme predtým ani nepremýšľali.
Neočakávané prekročenie kvót partnerských služieb môže viesť k výpadku vo vašom vlastnom. Mnohé API blokujú klientov, ktorí prekračujú limity, a v niektorých prípadoch nadbytok požiadaviek môže preťažiť produkciu partnera.
Napríklad, v čase rastu počtu dodávok sprievodné služby nezvládali úlohy ich rozdelenia a určovania trás. Výsledkom bolo, že objednávky boli vytvorené, ale služba, ktorá vytvára trasu, nefungovala. Treba povedať, že naši logistici urobili takmer nemožné za týchto podmienok a jasná spolupráca tímu pomohla kompenzovať dočasné výpadky služieb. Ale taký objem žiadostí nie je možné stále spracovávať ručne, a po určitom čase by sme sa stretli s neakceptovateľným rozporom medzi objednávkami a ich vykonaním.
Bola prijatá celá rada organizačných opatrení a súlade práce kolektívu pomohlo získať čas, kým sme sa dohodli na nových podmienkach a čakali na modernizáciu služieb zo strany niektorých partnerov. Existujú aj iné API, ktoré sa vyznačujú vysokou odolnosťou a neuveriteľnými tarifami v prípade vysokého prenosu. Napríklad, na začiatku sme používali jedno známe mapové API na určenie adresy odoslania. Ale na konci mesiaca sme dostali účet takmer 2 milióny rubľov. Následne sme sa rozhodli ho rýchlo vymeniť. Nebudem robiť reklamu, ale poviem, že naše náklady sa výrazne znížili.
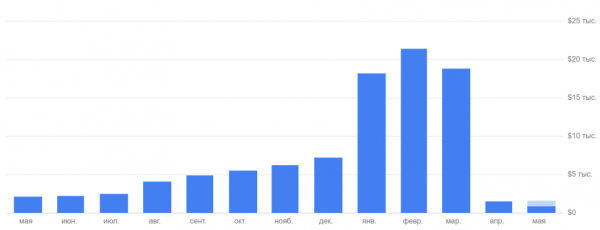
Výstup: Je potrebné neustále monitorovať podmienky fungovania všetkých partnerských služieb a mať ich na zreteli. Aj keď sa dnes zdá, že majú "veľký rezerva", neznamená to, že zajtra sa nestanú prekážkou pre rast. A samozrejme, je lepšie dohodnúť sa na finančných podmienkach zvýšených požiadaviek na službu vopred.
Niekedy sa ukáže, že "" (c) nepomáha
Sme zvyknutí na „zácpy“ v hlavnej databáze alebo na serveroch aplikácií, no pri rozširovaní sa problémy môžu prejaviť tam, kde ich ani nečakáte. Na fulltextové vyhľadávanie na webe používame engine Apache Solr. S rastúcim zaťažením sme si všimli zníženie doby odozvy, zatiaľ čo zaťaženie procesora servera dosiahlo už 100%. Čo by mohlo byť jednoduchšie — poskytneme kontajneru so Solrom viac prostriedkov.
Namiesto očakávaného nárastu výkonu server jednoducho „umrel“. Okamžite sa zaťažoval na 100% a odpovedal ešte pomalšie. Pôvodne sme mali 2 jadrá a 2 GB RAM. Rozhodli sme sa urobiť to, čo zvyčajne pomáha — dali sme serveru 8 jadier a 32 GB. Všetko sa stalo oveľa horšie (ako presne a prečo — povieme v samostatnom príspevku).
Za pár dní sme pochopili nuansy tejto záležitosti a dosiahli sme optimálny výkon pri 8 jadrách a 32 GB. Táto konfigurácia nám umožňuje aj dnes pokračovať v zvyšovaní zaťaženia, čo je veľmi dôležité, pretože rast prebieha nielen u klientov, ale aj v počte pripojených obchodov — za 2 mesiace sa ich počet zdvojnásobil.
Výstup: Štandardné metódy ako „pridať viac hardvéru“ nefungujú vždy. Takže pri rozširovaní akejkoľvek služby je potrebné dobre chápať, ako využíva zdroje a vopred testovať jej prácu v nových podmienkach.
Stateless — kľúč k jednoduchému horizontálnemu škálovaniu.
V našom celkovom prístupe sa naša tím riadi známych princípom: služby by nemali mať vnútorný stav (stateless) a mali by byť nezávislé od prostredia behu. To nám umožnilo prežiť rast zaťaženia jednoduchým horizontálnym škálovaním. Ale mali sme jednu výnimku: spracovateľ dlhých pozadových úloh. Ten sa zaoberal odosielaním emailov a sms, spracovaním udalostí, generovaním feedov, importom cien a skladov, spracovaním obrázkov. Tak sa stalo, že závisel od lokálneho súborového úložiska a bol v jedinom exemplári.
Keď sa zvýšil počet úloh v poradí spracovateľa (čo sa prirodzene stalo so zvýšením počtu objednávok), výkon hosťa, na ktorom boli umiestnené spracovateľ a úložisko súborov, sa stal limitujúcim faktorom. V dôsledku toho sa zastavilo aktualizovanie sortimentu a cien, odosielanie notifikácií používateľom a množstvo ďalších kritických funkcií, ktoré uviazli v poradí. Tím Ops rýchlo presunul úložisko súborov do S3-podobného sieťového úložiska, čo nám umožnilo nasadiť niekoľko výkonných strojov na škálovanie spracovateľa pozadí.
Výstup: Pravidlo Stateless je potrebné dodržiavať pre všetky komponenty bez výnimky, aj keď sa zdá, že "tu sa určite nezasekneme". Radšej investovať trochu času do správnej organizácie práce všetkých systémov, než potom v zhone prepisovať kód a opravovať službu, ktorá zažíva preťaženie.
7 princípov pre intenzívny rast
Napriek dostupnosti ďalších kapacít sme počas rastu narazili na niekoľko prekážok. Počas tohto času sa počet objednávok zvýšil viac ako 4-krát. Teraz už doručujeme viac ako 17 000 objednávok denne v 62 mestách a plánujeme ešte viac rozšíriť geografiu — v prvom polroku 2020 sa očakáva spustenie služby po celom Rusku. Aby sme sa vyrovnali s rastúcou záťažou a zohľadnili už nahromadené skúsenosti, definovali sme si 7 základných princípov práce v podmienkach neustáleho rastu:
- Incident management. Vytvorili sme dosku v Jira, kde sa každý incident odráža vo forme tiketu. To pomôže fakticky prioritizovať a vykonávať úlohy súvisiace s incidentom. Veď v podstate nie je hrozné robiť chyby — hrozné je robiť chyby dvakrát na tom istom mieste. Pre prípady, keď sa incidenty opakujú skôr, než sa podarí opraviť príčinu, by mala byť pripravená inštrukcia na postup, pretože počas veľkej záťaže je dôležité reagovať okamžite.
- Monitorovanie je potrebný pre všetky prvky infraštruktúry bez výnimky. Práve vďaka nemu sme mohli predpovedať rast zaťaženia a správne vyberať "úzke hrdlá" na prioritizáciu odstraňovania. Pravdepodobne pri vysokom zaťažení sa pokazí alebo začne spomaľovať všetko, o čom by ste ani nepremýšľali. Preto je najlepšie vytvárať nové upozornenia hneď po prvých incidentoch, aby sme ich monitorovali a predvídali.
- Správne upozornenia sú jednoducho nevyhnutné pri náhlom raste zaťaženia. Po prvé, musia informovať o tom, čo sa presne pokazilo. Po druhé, nemalo by byť veľa upozornení, pretože množstvo nekritických upozornení vedie k ignorovaniu všetkých oznámení.
- Aplikácie musia byť stateless. Uistili sme sa, že pre toto pravidlo by nemali byť výnimky. Potrebná je úplná nezávislosť od prostredia vykonávania. Na tento účel môžete ukladať zdieľané údaje v databáze alebo, napríklad, priamo v S3. A ešte lepšie je dodržiavať pravidlá. Počas náhleho rastu nie je čas na optimalizáciu kódu a s zaťažením bude potrebné vysporiadať sa priamym zvýšením výpočtových zdrojov a horizontálnym škálovaním.
- Kvóty a výkon externých služieb. Pri rýchlom raste môže problém vzniknúť nielen vo vašej infraštruktúre, ale aj v externých službách. Najviac mrzí, keď sa to stane nie z dôvodu zlyhania, ale kvôli dosiahnutiu kvót alebo limitov. Takže externé služby by mali škálovať rovnako dobre ako vy sami.
- Oddelujte procesy a fronty. To veľmi pomáha, keď na jednom zo vstupných bodov dôjde k zadrhnutiu. Nestretli by sme sa so zdržaním v prenose údajov, keby zaplnené fronty odosielania SMS nebránili výmene oznámení medzi informačnými systémami. Rovnako by bolo jednoduchšie zvýšiť počet pracovníkov, ak by pracovali samostatne.
- Finančné reality. Keď prebieha výbušný rast tokov údajov, nie je čas rozmýšľať nad tarifami a predplatnými. Ale treba na ne pamätať, najmä ak ste malá spoločnosť. Veľký účet môže vystaviť vlastník akéhokoľvek API, ako aj váš hostingový poskytovateľ. Takže zmluvy je potrebné čítať starostlivo.
Záver
Aj keď nie bez strát, prežili sme túto etapu a dnes sa snažíme dodržiavať všetky nájdené princípy. Každý server má možnosť jednoduchého zvýšenia výkonu až 4-krát na zvládanie nečakaných situácií.
V nasledujúcich príspevkoch sa podelíme o naše skúsenosti s analýzou poklesu výkonu v Apache Solr, ako aj o optimalizácii dopytov a o tom, ako spolupráca s daňovým úradom pomáha spoločnosti šetriť peniaze. Sledujte náš blog, aby ste nič nezmeškali, a podeľte sa v komentároch o to, či ste aj vy zažili podobné problémy počas rastu návštevnosti.
Len registrovaní používatelia sa môžu zúčastniť prieskumu. , prosím.
Stretli ste sa s oneskorením alebo poklesom služieb pri náhlom náraste záťaže kvôli:
55,6%Nemožnosti rýchlo pridať výpočtové zdroje10
16,7%Obmedzeniam infraštruktúry poskytovateľa hostingu3
33,3%Obmedzeniam externých API6
27,8%Porušeniu princípov stateless vo svojich aplikáciách5
88,9%Neoptimalizovanosti kódu vlastných služieb16
Hlasovalo 18 používateľov. Zdržali sa 6 používateľov.
Zdroj: habr.com
