

Volám sa Pavel Parchomenko, som ML vývojár. V tomto článku by som chcel prerozprávať, ako funguje služba Yandex.Zen a podeliť sa o technické vylepšenia, ktorých zavedenie zvýšilo kvalitu odporúčaní. Z toho príspevku sa dozviete, ako nájsť medzi miliónmi dokumentov tie najrelevantnejšie pre používateľa za niekoľko milisekúnd; ako vykonávať kontinuálnu faktorizáciu veľkej matice (složené z miliónov stĺpcov a desiatok miliónov riadkov), aby nové dokumenty získali svoj vektor za niekoľko desiatok minút; ako znovu využiť rozloženie matice používateľ-artikel na to, aby sme získali dobré vektorové znázornenie pre videá.
Naša odporúčacia databáza obsahuje milióny dokumentov rôznych formátov: textové články vytvorené na našej platforme a prevzaté z vonkajších stránok, videá, naratívy a krátke príspevky. Rozvoj podobnej služby súvisí s množstvom technických výziev. Tu sú niektoré z nich:
- Rozdelenie výpočtových úloh: všetky náročné operácie vykonávať offline a v reálnom čase vykonávať len rýchle aplikácie modelov, aby sme odpovedali za 100-200 ms.
- Rýchlo zohľadniť akcie používateľa. Na to je potrebné, aby všetky udalosti boli okamžite doručené do doporučovacieho systému a ovplyvnili výsledok práce modelov.
- Urobiť kanál tak, aby sa noví používatelia rýchlo prispôsobili ich správaniu. Čerstvo prichádzajúci do systému musia cítiť, že ich spätná väzba ovplyvňuje odporúčania.
- Rýchlo pochopiť, komu odporučiť nový článok.
- Operatívne reagovať na neustále vznikajúci nový obsah. Desiatky tisíc článkov sa každý deň uvoľňujú a mnoho z nich má obmedzenú životnosť (povedzme správy). V tom spočíva ich rozdiel od filmov, hudby a iného obsahu, ktorý má dlhú životnosť a je nákladný na vytvorenie.
- Prenášať vedomosti z jednej domény do druhej. Ak má odporúčací systém vyškolené modely pre textové články a do neho pridáme videá, môžeme znovu využiť existujúce modely, aby obsah nového typu bol lepšie hodnotený.
Povediem vás, ako sme tieto úlohy riešili.
Výber kandidátov
Ako znížiť množstvo zvažovaných dokumentov tisíckrát za niekoľko milisekúnd, pričom prakticky nezhoršíme kvalitu hodnotenia?
Predpokladajme, že sme vyškolili množstvo ML modelov, generovali na ich základe znaky a vyškolili ďalší model, ktorý hodnotí dokumenty pre používateľa. Všetko by bolo v poriadku, ale nemôžeme len tak vziať a vypočítať všetky znaky pre všetky dokumenty v reálnom čase, ak je týchto dokumentov milióny a odporúčania je potrebné vytvoriť za 100-200 ms. Úlohou je vybrať z miliónov akéhosi podmnožinu, ktorá bude hodnotená pre používateľa. Tento krok sa zvyčajne nazýva výber kandidátov. Na to sa kladú niektoré požiadavky. Po prvé, výber by sa mal uskutočňovať veľmi rýchlo, aby na samotné hodnotenie zostalo čo najviac času. Po druhé, pri výraznom znížení počtu dokumentov na hodnotenie musíme maximálne zachovať relevantné pre používateľa dokumenty.
Náš princíp výberu kandidátov sa postupne vyvíjal a v súčasnosti sme sa dostali k viacstupňovej schéme:
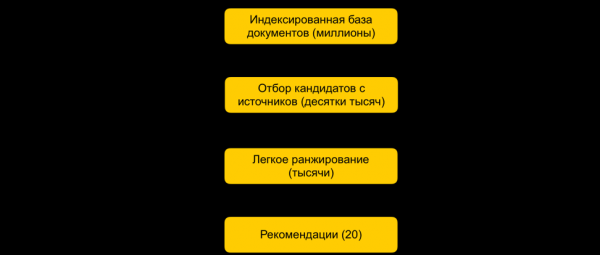
Najprv sa všetky dokumenty rozdeľujú do skupín a z každej skupiny sa berú najpopulárnejšie dokumenty. Skupinami môžu byť webové stránky, témy, klastre. Pre každého používateľa sa na základe jeho histórie vyberajú skupiny, ktoré mu najviac vyhovujú, a už z nich sa berú najlepšie dokumenty. Taktiež používame kNN-index na vyhľadávanie najbližších dokumentov používateľovi v reálnom čase. Existuje niekoľko metód na vytváranie kNN-indexu, u nás najlepšie fungoval (Hierarchical Navigable Small World graphs). Je to hierarchický model, ktorý umožňuje za niekoľko milisekúnd nájsť N najbližších vektorov pre používateľa z miliónovej databázy. Najprv offline indexujeme celú našu databázu dokumentov. Keďže vyhľadávanie v indexe funguje dosť rýchlo, môžeme pri použití niekoľkých silných embeddingov vytvoriť niekoľko indexov (po jednom indexe na každý embedding) a v reálnom čase sa odvolávať na každý z nich.
Pre nás zostáva desiatky tisíc dokumentov pre každého používateľa. To je stále veľa na počítanie všetkých znakov, takže v tejto fáze aplikujeme jednoduché hodnotenie — zjednodušený model ťažkého hodnotenia s menším počtom znakov. Úlohou je predpovedať, ktoré dokumenty budú mať ťažký model v top pozíciách. Dokumenty s najväčším predpokladom budú použité v ťažkom modeli, teda v poslednej fáze hodnotenia. Tento prístup umožňuje znížiť databázu dokumentov, ktoré sa pre používateľa zvažujú, z miliónov na tisíce v priebehu niekoľkých milisekúnd.
Krok ALS v runtime
Ako zohľadniť spätnú väzbu používateľa hneď po kliknutí?
Dôležitým faktorom v odporúčaniach je doba odozvy na spätnú väzbu používateľa. To je obzvlášť dôležité pre nových používateľov: keď človek práve začína používať odporúčací systém, dostáva nepersonalizovaný tok rôznych tematických dokumentov. Hneď ako vykoná prvé kliknutie, je potrebné okamžite to zohľadniť a prispôsobiť sa jeho záujmom. Ak by sa všetky faktory počítali offline, rýchla reakcia systému by bola nemožná kvôli oneskoreniu. Preto je potrebné v reálnom čase spracovávať akcie používateľa. Na tieto účely používame krok ALS v runtime na vytvorenie vektorového zastúpenia používateľa.
Predpokladajme, že pre všetky dokumenty máme vektorové zastúpenie. Napríklad môžeme offline na základe textu článku vytvoriť embeddings pomocou ELMo, BERT alebo iných modelov strojového učenia. Ako môžeme získať vektorové zastúpenie používateľov v rovnakom priestore na základe ich interakcií v systéme?
Všeobecný princíp tvorby a rozkladu matice používateľ-dokumentNecháme mať m používateľov a n dokumentov. Pre niektorých používateľov je známy ich postoj k niektorým dokumentom. Túto informáciu môžeme reprezentovať vo forme matice m x n: riadky zodpovedajú používateľom a stĺpce — dokumentom. Keďže väčšina dokumentov nebola človekom zobrazená, väčšina buniek matice zostane prázdnych, zatiaľ čo iné budú vyplnené. Pre každú udalosť (like, dislike, kliknutie) je v matici priradená nejaká hodnota — ale zvážme zjednodušený model, v ktorom like zodpovedá 1 a dislike –1.
Rozdelíme maticu na dve: P (m x d) a Q (d x n), kde d — dimenzia vektorového predstavenia (zvyčajne je to malé číslo). Každému objektu tak bude zodpovedať d-rozmerný vektor (používateľovi — riadok v matice P, dokumentu — stĺpec v matice Q). Tieto vektory budú embeddingami príslušných objektov. Na predpovedanie, či sa používateľovi dokument bude páčiť, stačí ich embeddingy vynásobiť.
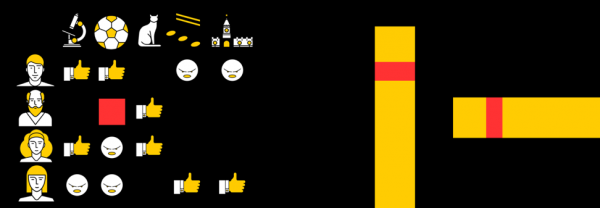
Jeden z možných spôsobov rozdelenia matice je ALS (Alternating Least Squares). Budeme optimalizovať nasledovnú funkciu straty:

Tu rui — interakcia používateľa u s dokumentom i, qi — vektor dokumentu i, pu — vektor používateľa u.
Potom optimálny vektor používateľa z hľadiska strednej kvadratickej chyby (pri fixovaných vektoroch dokumentov) sa analyticky určuje riešením zodpovedajúcej lineárnej regresie.
Toto sa nazýva "krok ALS". A samotný algoritmus ALS spočíva v tom, že striedavo fixujeme jednu z matíc (používateľov a článkov) a aktualizujeme druhú, aby sme našli optimálne riešenie.
Našťastie, nájdenie vektorového predstavenia používateľa — pomerne rýchla operácia, ktorú možno vykonávať v čase behu pomocou vektorových inštrukcií. Tento trik umožňuje okamžite zohľadniť spätnú väzbu používateľa v hodnotení. Taký istý embedding možno použiť aj v kNN indexe na zlepšenie výberu kandidátov.
Distribuovaná kolaboratívna filtrácia
Ako vykonávať inkrementálnu distribuovanú maticovú faktorizáciu a rýchlo nájsť vektorové predstavenie nových článkov?
Obsah nie je jediným zdrojom signálov pre odporúčania. Ďalším dôležitým zdrojom je kolaboratívna informácia. Dobrými signálmi v hodnotení tradične môžeme získať z rozkladu matice používateľ-dokument. Avšak pri pokuse o takéto rozloženie sme sa stretli s problémami:
1. Máme milióny dokumentov a desiatky miliónov používateľov. Matica sa celá nezmestí na jednu mašinu a rozklad bude veľmi dlhý.
2. Väčšina obsahu v systéme má krátku životnosť: dokumenty sú aktuálne iba niekoľko hodín. Preto je potrebné čo najrýchlejšie vytvoriť ich vektorové zobrazenie.
3. Ak by sme robili rozklad hneď po publikácii dokumentu, nebude mať dostatočný počet používateľov, aby ho ohodnotili. Preto jeho vektorové zobrazenie bude s vysokou pravdepodobnosťou nie veľmi kvalitné.
4. Ak používateľ dal palec hore alebo dole, nebudeme schopní hneď to zohľadniť v rozklade.
Aby sme vyriešili uvedené problémy, realizovali sme distribuovaný rozklad matice používateľ-dokument s častými inkrementálnymi aktualizáciami. Ako to presne funguje?
Predpokladajme, že máme klaster z N strojov (N sa počíta na stovky) a chceme realizovať distribuovaný rozklad matice, ktorá sa nezmestí na jedinú mašinu. Otázka znie — ako vykonať tento rozklad, aby na každej mašine boli dostatočné údaje a zároveň, aby výpočty boli nezávislé?
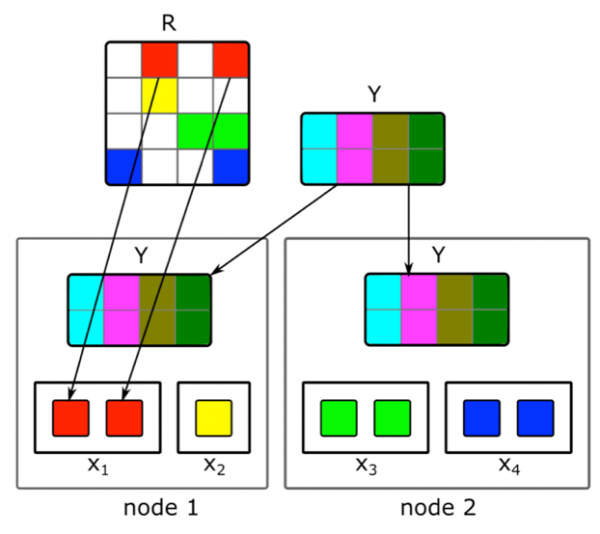
Budeme používať vyššie opísaný algoritmus rozkladu ALS. Pozrime sa, ako vykonať jeden krok ALS distribuovane — ostatné kroky budú podobné. Predpokladajme, že máme fixovanú maticu dokumentov a chceme vytvoriť maticu používateľov. Na to ju rozdelíme na N častí podľa riadkov, pričom každá časť bude obsahovať približne rovnaký počet riadkov. Rozposlali by sme na každú mašinu neprázdne bunky zodpovedajúcich riadkov, ako aj maticu embeddingov dokumentov (celú). Keďže má relatívne malú veľkosť a matica používateľ-dokument je zvyčajne veľmi riedka, tieto údaje sa zmestia na bežnú mašinu.
Tento trik je možné opakovať počas niekoľkých období až do konvergencie modelu, pričom sa striedavo mení fixná matica. Ale aj tak môže rozloženie matice trvať niekoľko hodín. A to nevyrieši problém, že je potrebné rýchlo získavať embedovanie nových dokumentov a aktualizovať embedovanie tých, o ktorých bolo pri budovaní modelu málo informácií.
Pomohla nám implementácia rýchleho inkrementálneho aktualizovania modelu. Predpokladajme, že máme aktuálny vycvičený model. Od jeho učenia sa objavili nové články, s ktorými interagovali naši používatelia, ako aj články, ktoré mali pri učení málo interakcií. Na rýchle získanie embedovania týchto článkov používame embedovania používateľov, získané počas prvého veľkého učenia modelu, a vykonávame jeden krok ALS, aby sme vypočítali maticu dokumentov pri fixnej matici používateľov. To umožňuje získať embedovania dosť rýchlo — v priebehu niekoľkých minút po publikácii dokumentu — a často aktualizovať embedovania čerstvých dokumentov.
Aby sa pri odporúčaniach okamžite zohľadnili akcie človeka, v runtime nepoužívame embedovania používateľov, získané offline. Namiesto toho vykonávame krok ALS a získavame aktuálny vektor používateľa.
Premiestnenie do inej domény
Ako využiť spätnú väzbu používateľa k textovým článkom na vytvorenie vektorového zastúpenia videa?
Pôvodne sme odporúčali len textové články, takže mnohé naše algoritmy sú zamerané na tento typ obsahu. Ale pri pridávaní obsahu iného typu sme čelili potrebe prispôsobiť modely. Ako sme riešili túto úlohu na príklade videa? Jednou z možností je pretrénovať všetky modely od základu. Ale to trvá dlho, navyše niektoré algoritmy sú náročné na objem trénovacej vzorky, ktorá ešte nie je v potrebnom množstve pre nový typ obsahu v počiatočných fázach jeho existencie na službe.
Vybrali sme iný prístup a znovu sme použili modely textov pre videá. Pri vytváraní vektorových reprezentácií videí nám pomohol rovnaký trik s ALS. Vzali sme vektorovú reprezentáciu používateľov na základe textových článkov a vykonali krok ALS, pričom sme použili informácie o prehrávaniach videí. Takto sme bez námahy získali vektorovú reprezentáciu videa. A za behu jednoducho vypočítame blízkosť medzi vektorom používateľa, získaným na základe textových článkov, a vektorom videa.
Záver
Vývoj jadra real-time odporúčacej systému je spojený s množstvom úloh. Je potrebné rýchlo spracovávať údaje a aplikovať metódy strojového učenia na efektívne využívanie týchto dát; budovať komplexné distribuované systémy schopné spracovávať používateľské signály a nové jednotky obsahu v minimálnom čase; a mnoho ďalších úloh.
V súčasnom systéme, ktorého konštrukciu som opísal, kvalita odporúčaní pre používateľa rastie spolu s jeho aktivitou a dĺžkou pobytu na službe. Ale samozrejme, tu sa skrýva aj hlavná ťažkosť: systému sa ťažko hneď porozumieť záujmom človeka, ktorý málo interagoval s obsahom. Zlepšiť odporúčania pre nových používateľov je našou kľúčovou úlohou. Budeme pokračovať v optimalizácii algoritmov, aby sa relevantný obsah dostal rýchlejšie do jeho feedu, zatiaľ čo nerelevantný sa nezobrazoval.
Zdroj: habr.com
