

Volám sa Anton Baderin. Pracujem v Centre vysokých technológií a zaoberám sa systémovým administratívnym. Pred mesiacom sa skončila naša firemná konferencia, kde sme zdieľali nadobudnuté skúsenosti s IT komunitou nášho mesta. Hovoril som o monitorovaní webových aplikácií. Materiál bol určený pre úroveň junior alebo middle, ktorí tento proces nevytvárali od nuly.
Kameňom úrazu, ktorý leží v základe akejkoľvek monitorovacej sústavy, sú podnikové úlohy. Monitorovanie len pre zaznamenávanie nie je nikomu zaujímavé. A čo chce podnik? Aby všetko fungovalo rýchlo a bez chýb. Podnik chce proaktivitu, aby sme sami odhalili problémy v prevádzke služby a maximálne rýchlo ich riešili. To sú vlastne úlohy, ktoré som riešil celý minulý rok na projekte jedného z našich zákazníkov.
O projekte
Projekt je jedným z najväčších programov lojality v krajine. Pomáhame maloobchodným sieťam zvyšovať frekvenciu predaja pomocou rôznych marketingových nástrojov, ako sú bonusové karty. V projekte je celkovo 14 aplikácií, ktoré fungujú na desiatich serveroch.
Pri vedení pohovorov som viackrát postrehol, že administrátori ne vždy správne pristupujú k monitorovaniu webových aplikácií: stále veľa z nich sa zameriava na metriky operačného systému a občas monitorujú služby.
V mojom prípade predtým ležala v základe monitorovacej sústavy zákazníka Icinga. Tento systém nijako neriešil uvedené úlohy. Často nás klient informoval o problémoch a niekedy nám proste chýbali údaje, aby sme sa dostali k príčine.
Okrem toho bolo jasné, že ďalší rozvoj systému je bezperspektívny. Myslím, že tí, ktorí sú oboznámení s Icingou, ma pochopia. Takže sme sa rozhodli úplne predeliť systém monitorovania webových aplikácií na projekte.
Prometheus
Vybrali sme Prometheus na základe troch hlavných ukazovateľov:
- Obrovské množstvo dostupných metrík. V našom prípade ich je 60 tisíc. Samozrejme, stojí za to poznamenať, že väčšina z nich sa nevyužíva (asi 95%). Na druhej strane, sú všetky relatívne lacné. Pre nás je to druhý extrém v porovnaní s predtým používaným Icinga. Pridávanie metrických údajov v nej bolo veľmi problematické: existujúce boli drahé (stačí sa pozrieť na zdrojový kód akéhokoľvek pluginu). Každý plugin bol skriptom napísaným v Bash alebo Python, ktorých spustenie je náročné z hľadiska spotrebovaných zdrojov.
- Tento systém spotrebováva relatívne malé množstvo zdrojov. Na všetky naše metriky stačí 600 MB operačnej pamäte, 15% jedného jadra a pár desiatok IOPS. Samozrejme, treba spúšťať exportéry metrík, ale všetky sú napísané v Go a tiež sa nevyznačujú veľkou spotrebou. Nemyslím si, že je to v súčasných podmienkach problém.
- Umožňuje prechod do Kubernetes. Vzhľadom na plány zákazníka – voľba je jasná.
ELK
Predtým sme logy nesbírali a nespracovávali. Nevýhody sú všetkým jasné. Vybrali sme ELK, pretože sme už mali skúsenosti s týmto systémom. Skladujeme tam iba logy aplikácií. Hlavnými kritériami voľby boli fulltextové vyhľadávanie a jeho rýchlosť.
Clickhouse
Na začiatku sme si vybrali InfluxDB. Uvedomovali sme si potrebu zbierať logy Nginx, štatistiky z pg_stat_statements a uchovávať historické dáta Prometheus. Influx sa nám nepáčil, pretože občas začal spotrebovávať veľké množstvo pamäte a zrútil sa. Navyše, chceli sme skupinovať dotazy podľa remote_addr, ale skupinová funkcia v tejto DB je len podľa tagov. Tagy sú drahé (pamäť), ich počet je podmienečne obmedzený.
Začali sme hľadať odznova. Potrebovali sme analytickú databázu s minimálnou spotrebou zdrojov, ideálne so znižovaním dát na disku.
Clickhouse spĺňa všetky tieto kritériá a nikdy sme svoj výber neľutovali. Nepíšeme do neho veľké objemy dát (počet vložení je okolo päťtisíc za minútu).
NewRelic
NewRelic historicky bol s nami, pretože to bol výber zákazníka. U nás sa používa ako APM.
Zabbix
Zabbix používame výlučne na monitorovanie Black Box rôznych API.
Definovanie prístupu k monitorovaniu
Chceli sme dekomponovať úlohu a tým systémovo usporiadať prístup k monitorovaniu.
Pre tento účel som našu systém rozdelil na nasledujúce úrovne:
- hardvér a VMS;
- operačný systém;
- systémové služby, softvérový stack;
- aplikácia;
- biznis logika.
Čo je na tomto prístupe výhodné:
- vieme, kto je zodpovedný za prácu každej úrovne a na základe toho môžeme posielať upozornenia;
- môžeme využiť štruktúru pri potláčaní upozornení — bolo by zvláštne posielať upozornenie o nedostupnosti databázy, keď je celková virtuálna mašina nedostupná.
Keďže našou úlohou je odhaľovať poruchy v systéme, musíme na každej úrovni vyčleniť určitú sadu metrík, na ktoré by sme mali dávať pozor pri písaní pravidiel pre upozornenia. Teraz prejdeme úrovňami „VMS“, „Operačný systém“ a „Systémové služby, softvérový stack.“
Virtuálne stroje
Hosting vyčleňuje nám procesor, disk, pamäť a sieť. A s prvými dvoma sme mali problémy. Takže, metriky:
CPU stolen time — keď si kúpite virtuálny server na Amazone (napríklad t2.micro), mali by ste chápať, že vám nie je pridelené celé jadro procesora, ale len kvóta jeho času. A keď ju vyčerpáte, procesor začne byť zaberaný.
Táto metrika umožňuje sledovať takéto momenty a prijímať rozhodnutia. Napríklad, či je potrebné zobrať si výkonnější plán alebo rozdeliť spracovanie pozadí a požiadaviek na API na rôzne servera.
IOPS + CPU iowait time — prekvapivo, mnohé cloudové hostingy sa hriechom nedodávajú IOPS. Navyše, graf s nízkymi IOPS pre nich nie je argument. Preto je dôležité zbierať aj CPU iowait. S touto dvojicou grafov — s nízkymi IOPS a vysokým čakaním na vstup a výstup — už je možné sa rozprávať s hostingom a riešiť problém.
Operačný systém
Metriky operačného systému:
- percento dostupnej pamäte;
- aktívnosť používania swap: vmstat swapin, swapout;
- počet dostupných inode a voľného miesta v súborovom systéme v %
- priemerné zaťaženie;
- počet spojení v stave tw;
- zaplnilosť tabuľky conntrack;
- kvalitu práce siete je možné sledovať pomocou utility ss, balíkom iproute2 — získať z jej výstupu hodnotu RTT spojení a skupinovať podľa dest-portu.
Takisto na úrovni operačného systému nám vzniká taká entita, ako sú procesy. Je dôležité vyčleniť v systéme súbor procesov, ktoré hrajú dôležitú úlohu v jeho práci. Ak máte niekoľko pgpool, je nevyhnutné zbierať informácie o každom z nich.
Súbor metrík je nasledujúci:
- CPU;
- pamäť — predovšetkým rezidentná;
- IO — ideálne v IOPS;
- FileFd — otvorené a limit;
- významné zlyhania stránky — tak budete môcť pochopiť, ktorý proces sa swapuje.
Celý monitoring je u nás rozvinutý v Dockeri, na zber dátových metrík používame Cadvisor. Na ostatných strojoch aplikujeme process-exporter.
Systémové služby, softvérový stack
Každá aplikácia má svoju špecifiku a je ťažké vyčleniť nejaký súbor metrík.
Univerzálným súborom sú:
- miera požiadaviek;
- počet chýb;
- latencia;
- saturation.
Najvýraznejšie príklady monitorovania tejto úrovne u nás — Nginx a PostgreSQL.
Najviac zaťaženou službou v našom systéme je databáza. V minulosti sme mali dostatočne často problémy s tým, aby sme zistili, čomu sa databáza venuje.
Videli sme vysoké zaťaženie diskov, ale slow logy nič podstatné neukazovali. Tento problém sme vyriešili pomocou pg_stat_statements, pohľadu, v ktorom sa zbiera štatistika požiadaviek.
To je všetko, čo potrebuje administrátor.
Staviame grafy aktivity požiadaviek na čítanie a zápis:
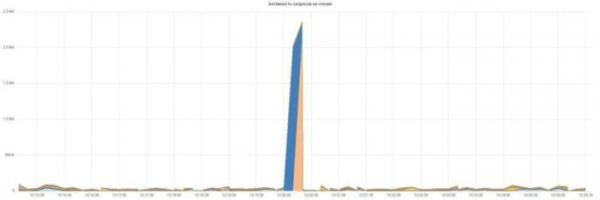
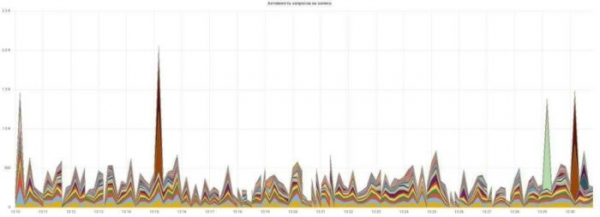
Všetko je jednoduché a pochopiteľné, každej požiadavke — vlastná farba.
Rovnako výrazným príkladom sú Nginx logy. Nie je prekvapením, že málo kto ich spracováva alebo spomína v zozname povinných. Štandardný formát nie je veľmi informatívny a je potrebné ho rozšíriť.
Osobne som pridal request_time, upstream_response_time, body_bytes_sent, request_length, request_id. Staviame grafy času odozvy a počtu chýb:
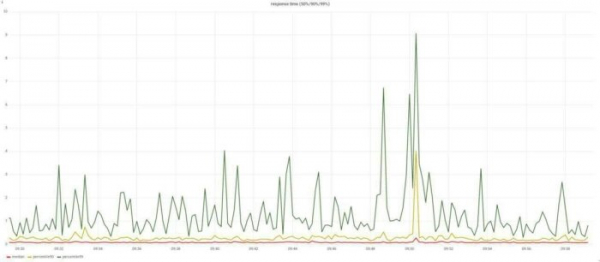
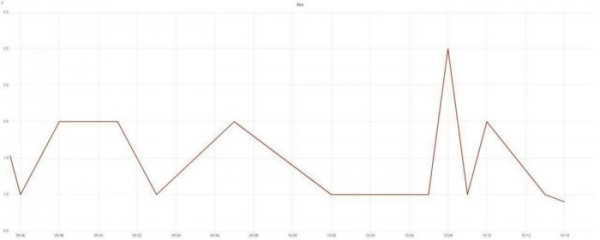
Staviame grafy času odozvy a počtu chýb. Pamätáte? Hovoril som o úlohách podnikania? Aby to bolo rýchlo a bez chýb? Tieto otázky sme už dvoma grafmi vyriešili. A podľa nich už môžeme volať pohotovým administrátorom.
Ale zostal ešte jeden problém — zabezpečiť rýchle odstránenie príčin incidentu.
Odstránenie incidentov
Celý proces od identifikácie po riešenie problému je možné rozdeliť na niekoľko krokov:
- identifikácia problému;
- notifikácia pohotového administrátora;
- reakcia na incident;
- odstránenie príčin.
Je dôležité, aby sme to robili maximálne rýchlo. A ak na fázach identifikácie problému a odoslania notifikácie nemôžeme získať veľa času — dve minúty na ne v každom prípade uzmú, tak nasledujúce — to je jednoducho neorané pole na zlepšenia.
Predstavte si, že telefon zavelí službe. Čo bude robiť? Hľadať odpovede na otázky — čo sa pokazilo, kde sa to stalo, ako reagovať? Tu sú spôsoby, ako na tieto otázky odpovedáme:
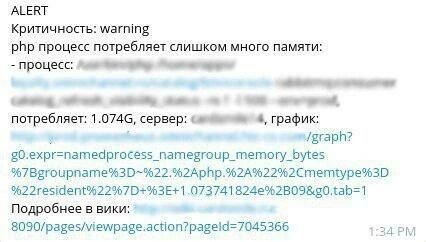
Jednoducho zahrnieme všetky tieto informácie do textu upozornenia a poskytneme v ňom odkaz na stránku v wiki, kde je popísané, ako reagovať na tento problém, ako ho vyriešiť a eskalovať.
Ešte som nič nepovedal o úrovni aplikácií a obchodnej logiky. Bohužiaľ, v našich aplikáciách zatiaľ neexistuje zber metrík. Jediným zdrojom akýchkoľvek informácií z týchto úrovní sú logy.
Pár bodov.
Po prvé, píšte štruktúrované logy. Netreba zahŕňať kontext do textu správy. Sťažuje to ich skupinovanie a analýzu. Logstash potrebuje veľa času na to, aby to všetko normalizoval.
Po druhé, správne používajte úrovne závažnosti. Každý jazyk má svoj štandard. Osobne rozdeľujem na štyri úrovne:
- chýba chyba;
- chyba na strane klienta;
- chyba na našej strane, nestrácame peniaze, neriskujeme;
- chyba na našej strane, strácame peniaze.
Na záver. Snažte sa budovať monitorovanie presne od obchodnej logiky. Snažte sa monitorovať samotnú aplikáciu a pracovať už s takými metrikami, ako je počet predajov, počet nových registrácií používateľov, počet aktívnych používateľov v danom okamihu a tak ďalej.
Ak je celé vaše podnikanie len jedno tlačidlo v prehliadači, je potrebné sledovať, či je stlačené, či funguje správne. Všetko ostatné nie je dôležité.
Ak to nemáte, môžete sa pokúsiť to dohnať v logoch aplikácie, logoch Nginx a tak ďalej, ako sme to urobili my. Musíte byť čo najbližšie k aplikácii.
Metriky operačného systému sú samozrejme dôležité, ale obchod ich nezaujíma, my nedostávame zaplatené za ne.
Zdroj: habr.com
