

V posledných niekoľkých rokoch sa databázy časových radov (Time-series databases) pretransformovali z niečoho neobvyklého (špecializovane používaného buď v otvorených systém v monitorovania (a viazaného na konkrétne riešenia), alebo v projektoch Big Data) na „tovar pre masy“. Na území RF si za to zaslúži osobitné poďakovanie Yandex a ClickHouse. Predtým, ak ste potrebovali uchovávať veľké množstvo časových radov údajov, museli ste sa buď vzdať a zaviesť monštruóznu Hadoop architektúru a udržiavať ju, alebo komunikovať s protokolmi špecifickými pre každú systém.
Môže sa zdať, že v roku 2019 bude článok o tom, ktorý TSDB by sa mal používať, pozostávať iba z jedinej vety: „jednoducho použite ClickHouse“. Ale… sú tu nuansy.
Naozaj, ClickHouse sa aktívne vyvíja, používateľská základňa rastie a podpora sa poskytuje veľmi aktívne, ale nestali sme sa väzňami verejného úspechu ClickHouse, ktorý zatienil iné, možno efektívnejšie/spolehlivejšie riešenia?
Na začiatku minulého roku sme sa zaoberali prepracovaním nášho vlastného monitorovacieho systému, v procese ktorého sa objavila otázka výberu vhodnej databázy pre uchovávanie údajov. O histórii tejto voľby by som chcel tu rozprávať.
Stanovenie úlohy
Predovšetkým – potrebné úvodné slovo. Prečo vôbec potrebujeme vlastný monitorovací systém a ako bol postavený?
Začali sme poskytovať služby podpory v roku 2008 a v roku 2010 sa stalo jasným, že agregovať údaje o procesoch v klientskej infraštruktúre pomocou vtedajších riešení sa stalo zložitým (hovoríme o, prepáčte, Cacti, Zabbixe a vznikajúcom Graphite).
Našimi hlavnými požiadavkami boli:
- podpora (v tom čase – desiatok, a v budúcnosti – stovkách) klientov v rámci jedného systému a pritom existenciu centralizovaného systému správy upozornení;
- flexibilita v správe systému upozornení (eskalácia upozornení medzi strážcov, zohľadňovanie rozvrhu, databáza vedomostí);
- možnosť hlbokého podrobnenia grafov (Zabbix vtedy vykresľoval grafy vo forme obrázkov);
- dlhé uchovávanie veľkého množstva údajov (rok a viac) a možnosť ich rýchlej selekcie.
V tomto článku nás zaujíma posledný bod.
Pokiaľ ide o ukladanie, požiadavky boli nasledovné:
- systém by mal rýchlo fungovať;
- je žiaduce, aby systém mal SQL rozhranie;
- systém by mal byť stabilný a mať aktívnu používateľskú základňu a podporu (v minulosti sme sa stretli s potrebou podporovať také systémy ako MemcacheDB, ktoré prestali byť vyvíjané, alebo distribuované úložisko MooseFS, ktorého bugtrackery boli v čínskom jazyku: nechceli sme opakovať tento príbeh pre náš projekt);
- zhoda s CAP teóriou: Consistency (nevyhnutné) — dáta musia byť aktuálne, nechceme, aby systém správy upozornení nezískal nové dáta a pľul alerty o nedorážaní dát vo všetkých projektoch; Partition Tolerance (nevyhnutné) — nechceme zažiť Split Brain systémy; Availability (nie kritické, v prípade existencie aktívnej repliky) — môžeme prepnúť na záložný systém v prípade havárie, programovo.
Akoby to bolo prekvapujúce, v tom čase sa pre nás ideálnym riešením stal MySQL. Naša štruktúra dát bola veľmi jednoduchá: id servera, id počítadla, timestamp a hodnota; rýchle vyhľadávanie horúcich dát bolo zabezpečené veľkým rozmerom buffer pool, a výber historických dát — SSD.
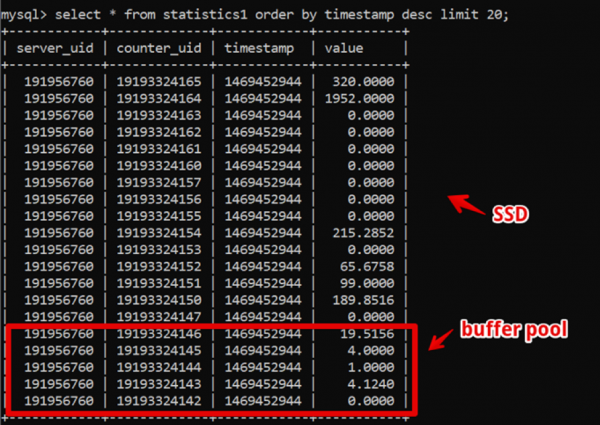
Týmto spôsobom sme dosiahli výber čerstvých dvojtýždňových dát, s detailizáciou až na sekundu za 200 ms do momentu úplného vykreslenia dát, a žili sme v tomto systéme pomerne dlho.
Medzitým čas plynul a množstvo dát rástlo. Do roku 2016 objemy dát dosahovali desiatky terabajtov, čo v podmienkach prenajatých SSD úložísk predstavovalo značnú investíciu.
V tom čase už aktívne prenikali stĺpcové databázy, o ktorých sme začali intenzívne premýšľať: v stĺpcových DB sa dáta ukladajú, ako možno pochopiť, stĺpcovo, a ak sa pozrieme na naše dáta, je ľahké vidieť veľké množstvo duplikátov, ktoré by sa mohli, pri použití stĺpcovej DB, skomprimovať.
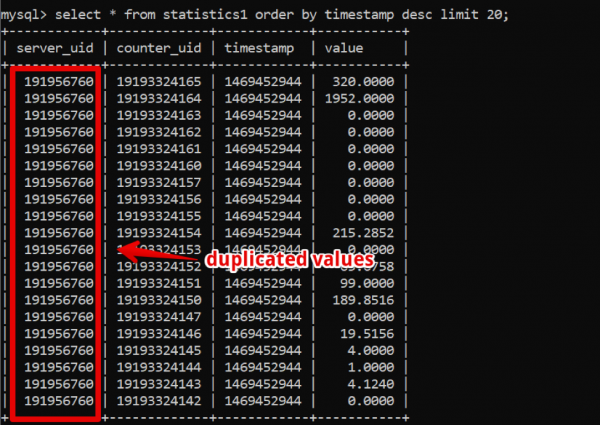
Ale kľúčový systém spoločnosti pokračoval v stabilnej prevádzke a experimentovať s prechodom na niečo iné sme nechceli.
V roku 2017 na konferencii Percona Live v San Jose sa možno po prvýkrát predstavili vývojári Clickhouse. Na prvý pohľad bola táto sústava pripravená na produkciu (veď Yandex.Metrica je tvrdá produkcia), podpora bola rýchla a jednoduchá a najmä samotná prevádzka bola jednoduchá. Od roku 2018 sme začali proces prechodu. Ale do tej doby sa objavilo veľa „dospelých“ a viac-menej overených systémov TSDB, a tak sme sa rozhodli venovať značný čas porovnávaniu alternatív, aby sme sa uistili, že neexistujú alternatívne riešenia k Clickhouse-u, ktoré vyhovujú našim požiadavkám.
Okrem už uvedených požiadaviek na úložisko sa objavili nové:
- nový systém by mal poskytovať minimálne rovnaký výkon ako MySQL na rovnakom hardvéri;
- úložisko nového systému by malo zaberajú výrazne menej miesta;
- DBMS by mala byť naďalej jednoduchá na správu;
- chceli sme minimálne meniť aplikáciu pri zmene DBMS.
Aké systémy sme začali zvažovať
Apache Hive/Apache Impala
Starý overený Hadoop stack. V podstate ide o SQL rozhranie, ktoré je postavené nad úložiskom dát vo vlastných formátoch na HDFS.
Výhody.
- Pri stabilnej prevádzke je veľmi jednoduché škálovať dáta.
- Existujú stĺpcové riešenia na ukladanie dát (menej miesta).
- Veľmi rýchle vykonávanie paralelne spracovaných úloh pri dostatočných zdrojoch.
Nevýhody.
- Je to Hadoop, a je zložitý na prevádzku. Ak nie sme pripravení prijímať hotové riešenie v cloude (a nie sme pripravení z hľadiska nákladov), celý stack bude potrebné zostaviť a udržiavať vlastnými administrátormi, čo je veľmi neželané.
- Údaje sa agregujú .
Avšak:
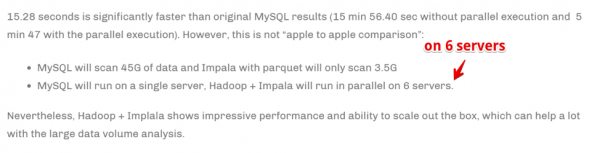
Rýchlosť sa dosahuje škálovaním počtu výpočtových serverov. Jednoducho povedané, ak sme veľká spoločnosť, ktorá sa zaoberá predikciou a je pre podnik mimoriadne dôležité čo najrýchlejšie agregovať informácie (nech to stojí aj množstvo výpočtových zdrojov), — môže to byť naša voľba. Ale neboli sme pripravení výrazne zvyšovať park hardvéru pre zvýšenie rýchlosti vykonávania úloh.
Druid/Pinot
Už oveľa viac o konkrétnych TSDB, avšak opäť — Hadoop stack.
Existuje .
Keby sme to mali povedať v niekoľkých slovách: Druid/Pinot vyzerajú lepšie ako Clickhouse v situáciách, keď:
- Máte heterogénny charakter dát (v našom prípade zapisujeme iba časové rady serverových metrík, a v podstate ide o jednu tabuľku. Môžu však existovať aj iné prípady: časové rady zariadení, ekonomické časové rady a podobne — každé s vlastnou štruktúrou, ktorú je potrebné agregovať a spracovávať).
- Týchto údajov je pritom veľmi veľa.
- Tabuľky a údaje s časovými radmi sa objavujú a miznú (teda nejaký súbor údajov prišiel, bol analyzovaný a odstránený).
- Neexistuje jasné kritérium, podľa ktorého by mohli byť údaje partitionované.
V opačných prípadoch sa lepšie ukazuje ClickHouse, a to je náš prípad.
ClickHouse
- Podobné SQL.
- Je jednoduchý na správu.
- Ľudia hovoria, že funguje.
Dostáva sa do zoznamu testovania.
InfluxDB
Zahraničná alternatíva k ClickHouse. Z mínusov: Vysoká dostupnosť je prítomná iba v komerčnej verzii, ale treba porovnať.
Dostáva sa do zoznamu testovania.
Cassandra
Na jednej strane vieme, že sa používa na uchovávanie metrických časových rádov v takých monitorovacích systémoch, ako napríklad, alebo OkMeter. Avšak existuje špecifika.
Cassandra nie je stĺpcová databáza v jej bežnom chápaní. Vyzerá skôr ako riadková, ale v každom riadku môže byť iné množstvo stĺpcov, vďaka čomu je ľahké usporiadať stĺpcovú prezentáciu. V tomto zmysle je jasné, že pri obmedzení na 2 miliardy stĺpcov je možné uchovávať určité údaje práve v stĺpcoch (napríklad tie isté časové rady). Napríklad v MySQL je obmedzenie na 4096 stĺpcov a tam sa ľahko narazí na chybu s kódom 1117, ak sa pokúsite urobiť to isté.
Cassandra je databázový systém určený na ukladanie veľkých objemov dát v distribuovanom systéme bez hlavného uzla, a podľa vyššie spomenutej CAP teórie je Cassandra viac zameraná na AP, teda na dostupnosť dát a odolnosť voči rozdeleniu partition. Tento nástroj je teda skvelou voľbou, ak je potrebné iba zapisovať do tejto databázy a čítať z nej len zriedka. Preto je logické použiť Cassandru ako „chladné“ úložisko. Tým sa rozumie dlhodobé spoľahlivé miesto na ukladanie veľkých objemov historických dát, ktoré sa zriedka vyžadujú, ale pri potrebe sa dajú jednoducho získať. Napriek tomu, pre úplnosť obrazu, ju otestujeme aj my. Avšak, ako som už povedal, nemám chuť aktívne prepísať kód podľa vybranej databázy, preto ju budeme testovať obmedzene — bez prispôsobenia štruktúry databázy špecifikám Cassandry.
Prometheus
Nuže, a z istého zvedavosti sme sa rozhodli otestovať výkon úložiska Prometheus — len aby sme pochopili, či sme rýchlejší ako aktuálne riešenia alebo pomalší, a v akej miere.
Metodológia a výsledky testovania
Takže sme otestovali 5 databáz v nasledujúcich 6 konfiguráciách: ClickHouse (1 uzol), ClickHouse (distribuovaná tabuľka na 3 uzloch), InfluxDB, Mysql 8, Cassandra (3 uzly) a Prometheus. Testovací plán je nasledujúci:
- nahrávame historické údaje za týždeň (840 miliónov hodnôt denne; 208 tisíc metrík);
- generujeme záťaž na zápis (preskúmali sme 6 režimov záťaže, pozri nižšie);
- paralelne so zápisom občas robíme výbery, emulujúc požiadavky používateľa pracujúceho s grafmi. Aby sme to príliš nekomplikovali, vybrali sme údaje pre 10 metrík (presne toľko ich je na grafe CPU) za týždeň.
Zatěžujeme, emulujúc správanie agenta nášho monitorovania, ktorý posiela hodnoty v každej metrike každých 15 sekúnd. Zároveň nás zaujíma variabilita:
- celkový počet metrík, do ktorých sa zapisujú dáta;
- interval odosielania hodnôt do jednej metriky;
- veľkosť dávky.
O veľkosti dávky. Keďže takmer všetky naše testované databázy neodporúčajú zaťažovať jednorazovými insertmi, potrebujeme reláciu, ktorá zbiera prichádzajúce metriky a zoskupuje ich podľa množstva a zapisuje ich do databázy ako hromadný insert.
Aby sme lepšie porozumeli, ako interpretovať získané údaje, predstaviť si môžeme, že neposielame len hromadu metrík, ale sú usporiadané do serverov — po 125 metrík na server. Server tu je len virtuálna entita — len aby sme chápali, že napríklad 10000 metrík zodpovedá približne 80 serverom.
Na základe toho máme šesť režimov zaťaženia databázy pri zápise:
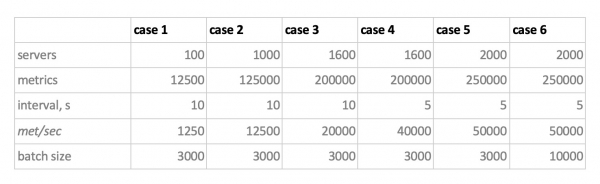
Tu sú dva aspekty. Po prvé, pre Cassandru sú takéto veľkosti batchov príliš veľké, použili sme hodnoty 50 alebo 100. A po druhé, keďže Prometheus funguje striktne v režime pull, teda sám chodí a získava údaje zo zdrojov metrík (a dokonca pushgateway, napriek názvu, situáciu zásadne nemení), zodpovedajúce zaťaženia boli realizované pomocou kombinácie statických konfigurácií.
Výsledky testovania sú takéto:
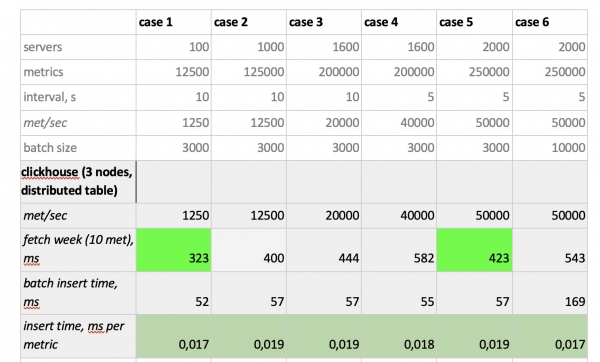
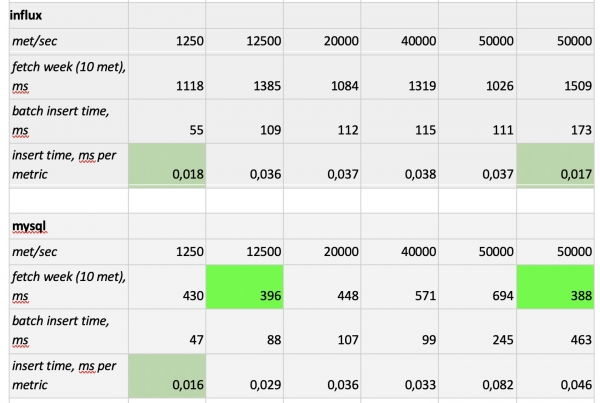
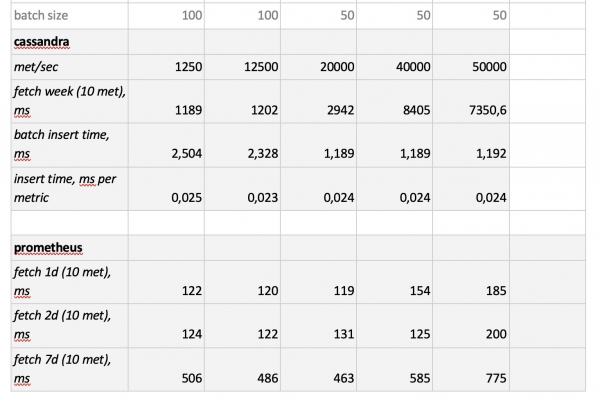
Čo je potrebné poznamenať: fantasticky rýchle dotazy z Prometheusa, hrozne pomalé dotazy z Cassandry, neprijateľne pomalé dotazy z InfluxDB; čo sa týka rýchlosti zápisu, všetkých porazil ClickHouse, a Prometheus sa súťaže nezúčastňuje, pretože vykonáva vkladanie sám vo vnútri seba a nič nemeriame.
Nakoniec: najlepšie sa ukázali ClickHouse a InfluxDB, ale klaster z Influxu je možné postaviť iba na základe Enterprise verzie, ktorá je za peniaze, zatiaľ čo ClickHouse nič nestojí a je vyvinutý v Rusku. Logicky, v USA by bol výber pravdepodobne v prospech InfluxDB, zatiaľ čo u nás v prospech ClickHouse.
Zdroj: habr.com
