

Pozn. prekl.: Predstavujeme vám technické podrobnosti o príčinách nedávneho výpadku v prevádzke cloudovej služby spravovanej tvorcami Grafana. Je to klasický príklad toho, ako nová a, zdalo by sa, mimoriadne užitočná funkcia, ktorá má zlepšiť kvalitu infraštruktúry… môže uškodiť, ak sa nezohľadnia mnohé nuansy jej použitia v reálnych podmienkach výroby. Je úžasné, keď sa objavujú takéto materiály, ktoré umožňujú učiť sa nielen na vlastných chybách. Podrobnosti nájdete v preklade tohto textu od viceprezidenta pre produkt z Grafana Labs.
V piatok, 19. júla, služba Hosted Prometheus v Grafana Cloud prestala fungovať približne na 30 minút. Ospravedlňujem sa všetkým zákazníkom, ktorí boli postihnutí týmto výpadkom. Našou úlohou je poskytovať potrebné nástroje na monitorovanie a chápeme, že ich nedostupnosť komplikuje váš život. Túto udalosť berieme veľmi vážne. V tejto poznámke vysvetlíme, čo sa stalo, ako sme na to reagovali a čo robíme, aby sa niečo podobné už neopakovalo.
Pozadie
Služba Grafana Cloud Hosted Prometheus je založená na — projekte CNCF na vytvorenie horizontálne škálovateľného, vysoko dostupného, multitenantného (multi-tenant) servisu Prometheus. Architektúra Cortex sa skladá z niekoľkých samostatných mikroslužieb, z ktorých každá vykonáva svoju funkciu: replikáciu, ukladanie, dopyty atď. Cortex sa aktívne vyvíja, neustále sa objavujú nové funkcie a zvyšuje sa výkonnosť. Pravidelne nasadzujeme nové verzie Cortex do klastrov, aby zákazníci mohli využiť tieto vylepšenia — na šťastie, Cortex zvláda aktualizácie bez výpadkov.
Pre bezvýpadkové aktualizácie služba Ingester Cortexu vyžaduje dodatočnú replikáciu Ingesteru počas procesu aktualizácie. (Pozn. prekl.: — základná súčasť Cortexu. Jeho úlohou je zhromažďovať nepretržitý tok vzoriek, usporadúvať ich do chunkov Prometheus a ukladať ich do databázy ako DynamoDB, BigTable alebo Cassandra.) Toto umožňuje starým Ingesterom prenášať aktuálne údaje novým Ingesterom. Je treba poznamenať, že Ingesteri sú nároční na zdroje. Na ich prácu je potrebné mať 4 jadrá a 15 GB pamäte na pod, t.j. 25 % procesorového výkonu a pamäte základného stroja v prípade našich klastrov Kubernetes. Vo všeobecnosti máme zvyčajne oveľa viac nevyužitých zdrojov v klastri ako 4 jadrá a 15 GB pamäte, takže môžeme ľahko spustiť tieto dodatočné Ingesteri počas aktualizácií.
Avšak často sa stáva, že počas normálnej prevádzky nie na jednom z počítačov nie sú týchto 25 % nevyužitých zdrojov. A ani nesnažíme: CPU a pamäť sú vždy potrebné pre iné procesy. Na vyriešenie tohto problému sme sa rozhodli využiť . Myšlienka je priradiť Ingesterom vyššiu prioritu ako iným (stateless) mikroslužbám. Keď potrebujeme spustiť dodatočný (N+1) Ingester, dočasne vytlačíme iné, menšie pody. Tieto pody sa prenášajú na voľné zdroje na iných strojoch, pričom zostáva dostatočne veľká "diera" na spustenie dodatočného Ingesteru.
Vo štvrtok, 18. júla, sme nasadili štyri nové úrovne priorít vo svojich klastroch: kritická, vysokú, stredná a nízka. Boli testované na internom klastri bez klientského prenosu približne jeden týždeň. Predvolene pody bez nastavenej priority dostávali stredná prioritu, pre Ingesterov bola nastavená trieda s vysokou prioritou. Kritická bola rezervovaná pre monitorovanie (Prometheus, Alertmanager, node-exporter, kube-state-metrics atď.). Naša konfigurácia je otvorená a pozrieť si PR je možné .
Nehoda
V piatok, 19. júla, jeden z inžinierov spustil nový vyhradený klaster Cortex pre veľkého klienta. Konfigurácia tohto klastra nezahŕňala nové priority podov, takže všetkým novým podom bola priradená predvolená priorita — stredná.
V klastri Kubernetes nebolo dosť zdrojov pre nový klaster Cortex a existujúci produkčný klaster Cortex nebol aktualizovaný (Ingesteri zostali bez vysokej priority). Keďže Ingesteri nového klastra mali predvolene stredná prioritu a existujúce produkčné pody pracovali bez prioryty, Ingesteri nového klastra vytlačili Ingester z existujúceho produkčného klastra Cortex.
ReplicaSet pre vytlačeného Ingester’a v production klastri zistil vytlačený pod a vytvoril nový na udržanie požadovaného počtu kópií. Novému podu bol automaticky pridelený stredná priorita, a ďalší „starý“ Ingester v produkcii prišiel o zdroje. Výsledkom bol lavínový proces, ktorý viedol k vytlačeniu všetkých pod’ov s Ingesterom pre production klastry Cortexu.
Ingester’y uchovávajú stav (stateful) a ukladajú dáta za predchádzajúcich 12 hodín. To nám umožňuje efektívnejšie ich komprimovať pred zápisom do dlhodobého úložiska. Na tento účel Cortex vykonáva shardovanie dát po sériách, pričom využíva distribuovanú hašovaciu tabuľku (Distributed Hash Table, DHT) a replikujú každú sériu na tri Ingester’y pomocou kvórumovej konzistencie v štýle Dynamo. Cortex nepíše dáta do Ingester’ov, ktoré sú vypnuté. Takže, keď veľké množstvo Ingester’ov opúšťa DHT, Cortex nemôže zabezpečiť dostatočnú replikáciu záznamov a tie „spadnú“.
Zistenie a odstránenie
Nové upozornenia Prometheus na základe „rozpočtu chýb“ (error-budget-based — podrobnosti sa objavia v budúcej článku) začali hlásiť alarm po 4 minútach od začiatku výpadku. Počas nasledujúcich približne piatich minút sme vykonali diagnostiku a navýšili spodný cluster Kubernetes na umiestnenie nových aj existujúcich production klastrov.
Ešte o päť minút staré Ingester’y úspešne uložili svoje dáta, zatiaľ čo nové sa spustili a clustery Cortex opäť nadobudli dostupnosť.
Ďalších 10 minút bolo venovaných diagnostike a oprave chýb out-of-memory (OOM) od reverzných proxy serverov autentifikácie umiestnených pred Cortexom. OOM chyby boli spôsobené desiatkami násobným nárastom QPS (čo predpokladáme, že bolo spôsobené príliš agresívnymi požiadavkami zo serverov Prometheus klienta).
Dôsledky
Celková doba výpadku trvala 26 minút. Dáta neboli stratené. Ingester’y úspešne načítali všetky in-memory dáta do dlhodobého úložiska. Počas výpadku Prometheus servery klientov ukladali do vyrovnávacej pamäte vzdialené (remote) záznamy pomocou na základe WAL (podľa autorstva z Grafana Labs) a zopakovali neúspešné záznamy po poruche.
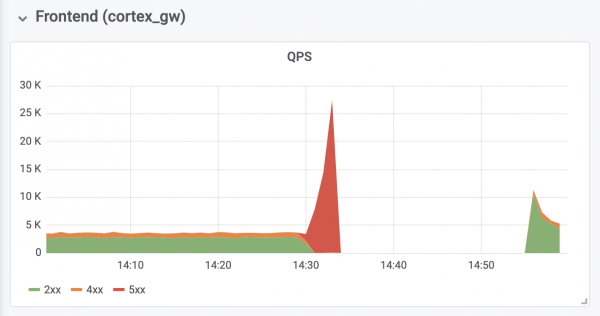
Operácie zápisu produkčného klastra
Zhrnutie
Je dôležité poučiť sa z tohto incidentu a prijať potrebné opatrenia, aby sa zabránilo jeho opakovaniu.
Pri pohľade späť musíme uznať, že sme nemali nastavovať predvolené stredná priority, kým všetky Ingester-y v produkcii nedostali vysokú prioritu. Navyše, mali sme sa vopred postarať o ich vysokú prioritu. Teraz je všetko opravené. Dúfame, že naše skúsenosti pomôžu aj iným organizáciám, ktoré zvažujú využitie priorít podov v Kubernetes.
Pridáme ďalšiu úroveň kontroly nad nasadením akýchkoľvek ďalších objektov, ktorých konfigurácie sú globálne pre klaster. Odteraz budú takéto zmeny hodnotené väčším počtom ľudí. Okrem toho, modifikácia, ktorá spôsobila zlyhanie, bola považovaná za príliš nepodstatnú na samostatný projektový dokument — diskutovalo sa o nej len v GitHub issue. Odteraz budú všetky takéto zmeny konfigurácie sprevádzané príslušnou projektovou dokumentáciou.oNakoniec automatizujeme zmenu veľkosti reverzného proxy servera autentifikácie, aby sme predišli OOM pri preťažení, na čo sme sa stali svedkami, a analyzujeme predvolené parametre Prometheus súvisiace s návratom a škálovaním, aby sme predišli podobným problémom v budúcnosti.
Prežité zlyhanie malo aj niektoré pozitívne následky: získaním potrebných zdrojov sa Cortex automaticky obnovil bez ďalšieho zásahu. Získali sme tiež cenné skúsenosti s
— naším novým systémom agregácie logov, — ktorý pomohol zabezpečiť, že všetky Ingester-y sa správne správali počas a po zlyhaní. Prechod Tinder na Kubernetes
P.S. od prekladateľa
Prečítajte si tiež na našom blogu:
- «»;
- «»;
- «»;
- «».
Zdroj: habr.com
