

V tomto článku je popísaná realizácia rúrky v jadre Unix. Bol som trochu sklamaný, že nedávny článok s názvom „“ sa ukázal nie ako článok o vnútornej štruktúre. Zaujímalo ma to, a tak som sa ponoril do starých zdrojov, aby som našiel odpoveď.
O čom je reč?
Rúrky — "pravdepodobne najdôležitejší vynález v Unixe" — sú určujúcou charakteristikou základnej filozofie Unixu spájania malých programov do jedného, ako aj známa správa v príkazovom riadku:
$ echo hello | wc -c
6
Táto funkčnosť závisí od systémového volania poskytovaného jadrom, pipektoré je popísané na stránkach dokumentácie a :
Rúrky poskytujú jednosmerný kanál medzi procesmi. Rúra má vstup (write end) a výstup (read end). Dáta zapísané do vstupu rúrky je možné čítať na výstupe.
Rúra sa vytvára pomocou volania
pipe(2), ktoré vracia dva súbory popisovačov: jeden odkazuje na vstup rúrky, druhý na výstup.
Výsledky sledovania uvedenej príkazovej sekvencie demonštrujú vytvorenie rúrky a prenos dát cez ňu z jedného procesu do druhého:
$ strace -qf -e execve,pipe,dup2,read,write
    sh -c 'echo hello | wc -c'

execve("/bin/sh", ["sh", "-c", "echo hello | wc -c"], …)
pipe([3, 4]) = 0
[pid 2604795] dup2(4, 1) = 1
[pid 2604795] write(1, "hellon", 6) = 6
[pid 2604796] dup2(3, 0) = 0
[pid 2604796] execve("/usr/bin/wc", ["wc", "-c"], …)
[pid 2604796] read(0, "hellon", 16384) = 6
[pid 2604796] write(1, "6n", 2) = 2
Rodičovský proces volá pipe(), aby získal pripojené súbory popisovačov. Jeden podradený proces píše do jedného popisovača, zatiaľ čo druhý proces číta tie isté dáta z iného popisovača. Shell pomocou dup2 "premenuje" popisovače 3 a 4, aby zodpovedali stdin a stdout.
Bez rúr by shell musel zapisovať výsledok jedného procesu do súboru a odovzdávať ho inému procesu, aby mohol čítať dáta zo súboru. Tým by sme míňali viac zdrojov a miesta na disku. Rúrky však nie sú dobré len preto, že šetria používanie dočasných súborov:
Ak sa proces pokúša čítať z prázdnej rúrky,
read(2)sa zablokuje, kým údaje nebudú k dispozícii. Ak sa proces pokúsi zapisovať do zaplnenej rúrky,write(2)zablokuje, kým sa z potrubia neprečítajú dostatočné údaje pre vykonanie zápisu.
Rovnako ako požiadavka POSIX, toto je dôležitá vlastnosť: zápis do potrubia až do PIPE_BUF bytov (minimálne 512) musí byť atomárny, aby mohli procesy komunikovať navzájom cez potrubie tak, ako to bežné súbory (ktoré takéto záruky neposkytujú) nemôžu.
Pri použití bežného súboru môže proces zapísať všetky svoje výstupy a odovzdať ich inému procesu. Alebo môžu procesy fungovať v režime tvrdého paralelizmu, pomocou vonkajšieho signálneho mechanizmu (ako je semafor) oznamovať si navzájom ukončenie zápisu alebo čítania. Potrubia nás zbavujú všetkých týchto starostí.
Čo hľadáme?
Vysvetlím na jednoduchom príklade, aby ste si mohli lepšie predstaviť, ako môže potrubie fungovať. Budete potrebovať vyhradiť v pamäti buffer a nejaký stav. Budete potrebovať funkcie na pridávanie a odoberanie údajov z bufferu. Bude potrebný nejaký prostriedok, ktorý bude vykonávať funkcie počas operácií čítania a zápisu do súborových deskriptorov. A potrebujete zámky na implementáciu vyššie opísaného špeciálneho správania.
Teraz sme pripravení preskúmať podrobne zdrojový kód jadra, aby sme potvrdili alebo vyvrátili našu neurčité myšlienkovú modelu. Ale vždy buďte pripravení na prekvapenia.
Kde hľadáme?
Neviem, kde sa nachádza môj výtlačok známej knihy „„ so zdrojovým kódom Unix 6, ale vďaka môžeme online vyhľadávať v ešte starších verzií Unix.
Blúdenie po archívoch TUHS pripomína návštevu múzea. Môžeme sa pozrieť na našu spoločnú históriu, a cítim úctu k mnohoročným snahám o obnovenie všetkých týchto materiálov bit po bite zo starých kaziet a tlačových výstupov. A ostro si uvedomujem tie fragmenty, ktoré ešte chýbajú.
Po uspokojení svojho zvedavého na starobylú históriu potrubí môžeme porovnať s modernými jadrami.
Mimochodom, pipe je systémovým volaním číslo 42 v tabuľke sysent[]Jediná zhoda?
Tradičné jadra Unix (1970–1974)
Nenašiel som žiadne stopy pipe(2) ani v (január 1970), ani v (november 1971), ani v neúplnom zdrojovom kóde (jún 1972).
TUHS tvrdí, že (február 1973) bola prvou verziou s potrubiami:
Tretia edícia Unxu bola poslednou verziou s jadrom napísaným v assembleri, no zároveň prvou verziou s potrubiami. V priebehu roku 1973 sa pracovalo na vylepšení tretej edície, jadro bolo prepísané v jazyku C a tak vznikla štvrtá edícia Unxu.
Jeden z čitateľov našiel sken dokumentu, v ktorom Doug McIlroy navrhol myšlienku „spájania programov na princípe záhradného hadice“.
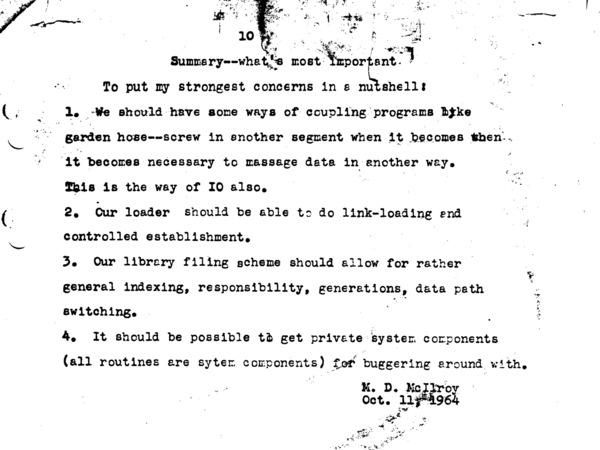
V knihe Briana Kernighana „“, v príbehu vzniku potrubí sa tiež spomína tento dokument: „… visel na stene v mojej kancelárii v Bell Labs po dobu 30 rokov“. Tu je , a ešte jeden príbeh z :
Keď vznikol Unix, moje nadšenie pre korutínové funkcie ma prinútilo požiadať autora OS, Kena Thompsona, aby umožnil údajom zaznamenaným v nejakom procese smerovať nielen na zariadenie, ale aj na výstup k inému procesu. Ken sa rozhodol, že je to možné. Ale ako minimalistický návrhár chcel, aby každá systémová funkcia zohrávala významnú úlohu. Má priamy zápis medzi procesmi naozaj veľkú výhodu v porovnaní so zápisom do dočasného súboru? A len keď som predložil konkrétny návrh s chytľavým názvom „potrubie“ a popisom syntaxe interakcie procesov, Ken konečne zvolal: „Urobím to!“.
A urobil. Jedného osudového večera Ken zmenil jadro a shell, opravil niekoľko štandardných programov, štandardizujúc ich procedúru prijímania vstupných údajov (ktoré môžu pochádzať z potrubia), a taktiež zmenil názvy súborov. Na druhý deň sa potrubia začali veľmi široko využívať v aplikáciách. Na konci týždňa sekretárky s ich pomocou posielali na tlač dokumenty z textových editorov. O niečo neskôr Ken nahradil pôvodné API a syntax pre shell používania potrubí za čistejšie dohody, ktoré sa od tej doby používajú.
Bohužiaľ, zdrojový kód jadra tretej edície Unxu je stratený. A hoci máme napísaný v jazyku C zdrojový kód jadra , vydanej v novembri 1973, prišiel teda niekoľko mesiacov pred oficiálnym vydaním a neobsahuje realizáciu potrubí. Je smutné, že zdrojový kód legendárnej funkcie Unxu je stratený, možno navždy.
Máme text dokumentácie k pipe(2) z oboch relízií, preto sa dá začať s hľadaním v dokumentácii (podľa určitých slov, zvýraznených „ručne“, riadok z literálov ^H, za ktorým nasleduje podčiarkovanie!). Tento proto-pipe(2) napísaný v assembleri a vracia iba jeden súborový deskriptor, ale už poskytuje očakávanú základnú funkcionalitu:
Systémové volanie pipe vytvára mechanizmus vstupu a výstupu, ktorý sa volá potrubie. Vrátený súborový deskriptor sa dá použiť na operácie čítania a zápisu. Keď sa do potrubia niečo zapisuje, tak sa vyrovnáva do 504 bajtov dát, po čom sa proces zápisu pozastaví. Pri čítaní z potrubia sa vyberú vyrovnané dáta.
Do nasledujúceho roka bolo jadro prekopírované do C a získalo svoj súčasný vzhľad s prototypom „pipe(fildes)»:
Systémové volanie pipe vytvára mechanizmus vstupu a výstupu, ktorý sa volá potrubie. Vrátené súborové deskriptor sa dajú použiť na operácie čítania a zápisu. Keď sa do potrubia zapisuje, používa sa deskriptor vrátený v r1 (zodp. fildes[1]), ktorý sa vyrovnáva do 4096 bajtov dát, po čom sa proces zápisu pozastaví. Pri čítaní z potrubia deskriptor vrátený v r0 (zodp. fildes[0]) vyberá dáta.
Predpokladá sa, že po definovaní potrubia dva (alebo viac) interactujúcich procesov (vytvorených následnými volaniami fork) budú prenášať dáta z potrubia pomocou volaní read a write.
V shelle existuje syntax na definovanie lineárneho poľa procesov, prepojených prostredníctvom potrubia.
Volania na čítanie z prázdneho potrubia (neobsahujúceho vyrovnané dáta), ktoré má iba jeden koniec (uzavreté všetky zapisovacie súborové deskriptory), vracajú „koniec súboru“. Volania na zápis v podobnej situácii sa ignorujú.
Najskoršia sa vzťahuje (jún 1974), ale je takmer identická s tou, ktorá sa objavila v nasledujúcom vydaní. Iba sa pridalo niekoľko komentárov, takže piaté vydanie možno preskočiť.
Šieste vydanie Unixu (1975)
Začneme čítať zdrojový kód Unixu (máj 1975). V mnohom vďaka Lions nájsť ho je oveľa ľahšie než zdroje skôr vydaných verzií:
Mnohé roky kniha Lions bola jediným dokumentom o jadre Unix, dostupným mimo steny Bell Labs. Hoci licencia šiestej edície umožňovala učiteľom používať jej zdrojový kód, licencia siedmej edície túto možnosť vylúčila, a preto sa kniha šírila ako nezákonné strojopisy.
Dnes si môžete kúpiť reprintovaný exemplar knihy, na obálke ktorej sú zobrazení študenti pri kopírovacom stroji. A vďaka Warrenovi Toonymu (ktorý spustil projekt TUHS) si môžete stiahnuť . Chcem vám dať predstavu, koľko síl bolo vložených do vytvorenia tohto súboru:
Viac ako 15 rokov dozadu som prepisoval kópiu zdrojového kódu, uvedeného v Lions, pretože sa mi nepáčila kvalita mojej kópie z neznámeho počtu iných kópií. TUHS ešte neexistovalo a nemal som prístup k starým zdrojom. Ale v roku 1988 som našiel starú pásku s 9 stopami, na ktorej bola záloha z počítača PDP11. Ťažko sa dalo pochopiť, či funguje, ale tam bolo nepoškodené stromové zloženie /usr/src/, v ktorom väčšina súborov bola označená rokom 1979, čo už vtedy vyzeralo zastaralo. Bola to siedma edícia alebo jej derivát PWB, ako som si myslel.
Túto nájdenú pamiatku som vybral ako základ a ručne som upravil zdroje do stavu šiestej edície. Časť kódu zostala rovnaká, niektoré som musel mierne upraviť, pričom som moderný token += vymenil za zastaraný =+. Niečo som jednoducho vymazal a niečo musel prepisovať úplne, ale nie veľmi veľa.
A dnes môžeme online čítať na TUHS zdrojový kód šiestej edície z .
Mimochodom, na prvý pohľad je hlavnou vlastnosťou C-kódu pred obdobím Kernighana a Ritchieho jeho stručnosť. Nie tak často sa mi podarí vložiť fragmenty kódu bez rozsiahlej úpravy, aby zodpovedali relatívne úzkej oblasti zobrazovania na mojej stránke.
Na začiatku je vysvetľujúci komentár (a áno, tam ešte existuje ):
/*
 * Max allowable buffering per pipe.
 * This is also the max size of the
 * file created to implement the pipe.
 * If this size is bigger than 4096,
 * pipes will be implemented in LARG
 * files, which is probably not good.
 */
#define    PIPSIZ    4096
Veľkosť vyrovnávacej pamäte sa nezmenila od čtvrtej edície. Ale tu vidíme bez akýchkoľvek verejných dokumentov, že kedysi používali súbory ako záložné úložisko!
Pokiaľ ide o LARG súbory, tie zodpovedajú , ktorý sa používa „algoritmom veľkého adresovania“ na spracovanie s cieľom podporiť väčšie súborové systémy. Keď Ken povedal, že je lepšie ich nepoužívať, rád mu verím.
Tu je skutočný systémový volanie pipe:
/*
 * The sys-pipe entry.
 * Allocate an inode on the root device.
 * Allocate 2 file structures.
 * Put it all together with flags.
 */
pipe()
{
    register *ip, *rf, *wf;
    int r;

    ip = ialloc(rootdev);
    if(ip == NULL)
        return;
    rf = falloc();
    if(rf == NULL) {
        iput(ip);
        return;
    }
    r = u.u_ar0[R0];
    wf = falloc();
    if(wf == NULL) {
        rf->f_count = 0;
        u.u_ofile[r] = NULL;
        iput(ip);
        return;
    }
    u.u_ar0[R1] = u.u_ar0[R0]; /* wf's fd */
    u.u_ar0[R0] = r;           /* rf's fd */
    wf->f_flag = FWRITE|FPIPE;
    wf->f_inode = ip;
    rf->f_flag = FREAD|FPIPE;
    rf->f_inode = ip;
    ip->i_count = 2;
    ip->i_flag = IACC|IUPD;
    ip->i_mode = IALLOC;
}
V komentári je jasne uvedené, čo sa deje. Ale pochopiť kód nie je také jednoduché, čiastočne kvôli tomu, ako sa pomocou "" a registrov R0 a R1 odovzdávajú parametre systémových volaní a vrátené hodnoty.
Skúsime s pomocou umiestniť na disku , a s pomocou — umiestniť v pamäti dva . Ak všetko pôjde dobre, nastavíme príznaky na rozlíšenie týchto súborov ako dvoch koncov potrubia, uvedieme ich v tom istom inode (číslo odkazov, ktoré sa zvýši na 2) a označíme inode ako zmenený a používaný. Dbajte na prístup k v chybových cestách (error paths) na zníženie počtu odkazov na nový inode.
pipe() musí cez R0 a R1 vracať čísla súborových popisovačov na čítanie a zápis. falloc() vracia ukazovateľ na súborovú štruktúru, ale tiež "vracia" cez u.u_ar0[R0] a súborový popisovač. Teda kód uchováva v r súborový popisovač na čítanie a priradí popisovač na zápis priamo z u.u_ar0[R0] po druhom volaní falloc().
Zástavka FPIPE, ktorý sme nastavili pri vytváraní potrubia, riadi správanie funkcie , vyžadujúcej konkrétne podprogramy vstupu-výstupu I/O:
/*
 * common code for read and write calls:
 * check permissions, set base, count, and offset,
 * and switch out to readi, writei, or pipe code.
 */
rdwr(mode)
{
    register *fp, m;

    m = mode;
    fp = getf(u.u_ar0[R0]);
        /* … */

    if(fp->f_flag&FPIPE) {
        if(m==FREAD)
            readp(fp); else
            writep(fp);
    }
        /* … */
}
Potom funkcia readp() v pipe.c číta údaje z potrubia. Ale je lepšie sledovať implementáciu začínajúc od writep(). Opakujem, kód sa skomplikoval kvôli osobitnostiam dohody o predaní argumentov, ale niektoré detaily je možné vynechať.
writep(fp)
{
    register *rp, *ip, c;

    rp = fp;
    ip = rp->f_inode;
    c = u.u_count;

loop:
    /* Ak je všetko hotové, vráť. */

    plock(ip);
    if(c == 0) {
        prele(ip);
        u.u_count = 0;
        return;
    }

    /*
     * Ak nie sú aktívne obidve strany čítania a zápisu potrubia, vráť chybu a signalizuj tiež.
     */

    if(ip->i_count i_size1 == PIPSIZ) {
        ip->i_mode |= IWRITE;
        prele(ip);
        sleep(ip + 1, PPIPE);
        goto loop;
    }

    /* Napíš, čo je možné a vráť sa späť. */

    u.u_offset[0] = 0;
    u.u_offset[1] = ip->i_size1;
    u.u_count = min(c, PIPSIZ - u.u_offset[1]);
    c -= u.u_count;
    writei(ip);
    prele(ip);
    if(ip->i_mode & IREAD) {
        ip->i_mode &= ~IREAD;
        wakeup(ip + 2);
    }
    goto loop;
}
Na vstupe potrubia chceme zapísať bajty u.u_count. Najprv požiadame o zablokovanie indexového deskriptora (pozri nižšie plock/prele).
Potom skontrolujeme počítadlo inodov. Kým sú oba konce potrubia otvorené, počítadlo by malo byť rovné 2. Držíme jednu referenciu (z rp->f_inode), takže ak bude počítadlo menej než 2, malo by to znamenať, že čítajúci proces uzavrel svoj koniec potrubia. Inými slovami, snažíme sa písať do uzavretého potrubia, čo je chyba. Prvýkrát sa objavuje chybový kód EPIPE a signál SIGPIPE sa objavil v šiestej edícii Unixu.
Ale aj keď je potrubie otvorené, môže byť plné. V tomto prípade uvoľníme zámok a ideme spať v nádeji, že iný proces prečíta z potrubia a oslobodí v ňom dostatok miesta. Po prebudení sa vraciame na začiatok, znovu zavesíme zámok a spustíme nový cyklus zápisu.
Ak je v potrubí dostatok voľného miesta, zapisujeme do neho dáta pomocou . Parameter i_size1 inodového prvku (pri prázdnom potrubí môže byť rovný 0) ukazuje na koniec dát, ktoré už obsahuje. Ak je dostatok miesta na zápis, môžeme naplniť potrubie z i_size1 do PIPESIZ. Potom uvoľníme zámok a pokúsime sa prebudiť akýkoľvek proces, ktorý čaká na možnosť prečítať z potrubia. Vraciame sa na začiatok, aby sme zistili, či sa nám podarilo zapísať toľko bajtov, koľko sme potrebovali. Ak nie, začíname nový cyklus zápisu.
Obvykle sa parameter i_mode inodového prvku používa na uchovávanie oprávnení. r, w a xAle v prípade potrubí signalizujeme čakajúcemu procesu zápisu alebo čítania pomocou bitov IREAD a IWRITE prislúchajúcich. Proces nastaví pr flag a zavolá sleep(), pričom sa očakáva, že v budúcnosti nejaký iný proces zavolá wakeup().
Skutočné čaro sa deje v sleep() a wakeup(). Sú implementované v , zdroji slávneho komentára „Nemusíte to chápať“ (You are not expected to understand this). Našťastie, nemusíme rozumieť kódu, len si prečítame niektoré komentáre:
/*
 * Give up the processor till a wakeup occurs
 * on chan, at which time the process
 * enters the scheduling queue at priority pri.
 * The most important effect of pri is that when
 * pri<0 a signal cannot disturb the sleep;
 * if pri>=0 signals will be processed.
 * Callers of this routine must be prepared for
 * premature return, and check that the reason for
 * sleeping has gone away.
 */
sleep(chan, pri) /* … */

/*
 * Wake up all processes sleeping on chan.
 */
wakeup(chan) /* … */
Proces, ktorý zavolá sleep() pre konkrétny kanál, môže byť neskôr prebudený iným procesom, ktorý zavolá wakeup() pre ten istý kanál. writep() a readp() koordinujú svoje akcie prostredníctvom takýchto párových volaní. Všimnite si, že pipe.c vždy dáva prioritu PPIPE pri volaní sleep(), takže všetky sleep() môžu byť prerušené signálom.
Teraz máme všetko, aby sme pochopili funkciu readp():
readp(fp)
int *fp;
{
    register *rp, *ip;

    rp = fp;
    ip = rp->f_inode;

loop:
    /* Veľmi konzervatívne zamykanie. */

    plock(ip);

    /*
     * Ak hlava (čítanie) dobehne
     * chvost (zápis), resetujeme oboje na 0.
     * /

    if(rp->f_offset[1] == ip->i_size1) {
        if(rp->f_offset[1] != 0) {
            rp->f_offset[1] = 0;
            ip->i_size1 = 0;
            if(ip->i_mode&IWRITE) {
                ip->i_mode =& ~IWRITE;
                wakeup(ip+1);
            }
        }

        /*
         * Ak nie sú aktívne obaja čitatelia a
         * zapisovatelia, vráť sa bez
         * splnenia čítania.
         * /

        prele(ip);
        if(ip->i_count i_mode =| IREAD;
        sleep(ip+2, PPIPE);
        goto loop;
    }

    /* Čítame a vraciame */

    u.u_offset[0] = 0;
    u.u_offset[1] = rp->f_offset[1];
    readi(ip);
    rp->f_offset[1] = u.u_offset[1];
    prele(ip);
}
Možno by pre vás bolo jednoduchšie čítať túto funkciu zdola nahor. Vetva „čítaj a vráť“ sa obyčajne používa, keď je v potrubí nejaké dáta. V tomto prípade použijeme na čítanie toľkých údajov, koľko je dostupných od aktuálneho f_offset čítania, a potom aktualizujeme hodnotu príslušného posunu.
Pri ďalšom čítaní potrubie bude prázdne, ak čítací posun dosiahol hodnotu i_size1 u inode’a. Resetujeme pozíciu na 0 a snažíme sa prebudiť akýkoľvek proces, ktorý chce zapisovať do potrubia. Vieme, že keď bude potrubie plné, writep() zaspí na ip+1. A teraz, keď je potrubie prázdne, môžeme ho prebudiť, aby obnovil svoj cyklus zápisu.
Ak nie je čo čítať, potom readp() môže nastaviť príznak IREAD a zaspať na ip+2. Vieme, že jeho prebudí writep(), keď zapíše do potrubia nejaké dáta.
Komentáre k pomôžu pochopiť, že namiesto predávania parametrov cez „u“ môžeme s nimi zaobchádzať ako s obyčajnými funkciami vstupu/výstupu, ktoré berú súbor, pozíciu, bufor v pamäti a počítajú množstvo bajtov na čítanie alebo zápis.
/*
 * Read the file corresponding to
 * the inode pointed at by the argument.
 * The actual read arguments are found
 * in the variables:
 *    u_base        core address for destination
 *    u_offset    byte offset in file
 *    u_count        number of bytes to read
 *    u_segflg    read to kernel/user
 */
readi(aip)
struct inode *aip;
/* … */

/*
 * Write the file corresponding to
 * the inode pointed at by the argument.
 * The actual write arguments are found
 * in the variables:
 *    u_base        core address for source
 *    u_offset    byte offset in file
 *    u_count        number of bytes to write
 *    u_segflg    write to kernel/user
 */
writei(aip)
struct inode *aip;
/* … */
Čo sa týka „konzervatívneho“ zamykania, readp() a writep() zamykajú inode, kým neskončia prácu alebo nedosiahnu výsledok (t.j. nevykonajú wakeup). plock() a prele() pracu od jednoduché: pomocou iného súboru volaní sleep a wakeup nám umožňujú prebudiť akýkoľvek proces, ktorý potrebuje zamknutie, ktoré sme práve zrušili:
/*
 * Lock a pipe.
 * If its already locked, set the WANT bit and sleep.
 */
plock(ip)
int *ip;
{
    register *rp;

    rp = ip;
    while(rp->i_flag&ILOCK) {
        rp->i_flag =| IWANT;
        sleep(rp, PPIPE);
    }
    rp->i_flag =| ILOCK;
}

/*
 * Unlock a pipe.
 * If WANT bit is on, wakeup.
 * This routine is also used to unlock inodes in general.
 */
prele(ip)
int *ip;
{
    register *rp;

    rp = ip;
    rp->i_flag =& ~ILOCK;
    if(rp->i_flag&IWANT) {
        rp->i_flag =& ~IWANT;
        wakeup(rp);
    }
}
Najprv som nemohol pochopiť, prečo readp() nevyvoláva prele(ip) pred zavolaním wakeup(ip+1). Prvá vec, čovyvoláva vo svojom cykle, je writep() plock(ip), čo vedie k vzájomnému blokovaniu, akešte nezrušil svoj zámok, takže kód by mal nejakým spôsobom fungovať správne. Ak sa pozrieme na readp() ... wakeup(), je jasné, že len označuje spiací proces ako pripravený na vykonanie, aby v budúcnosti sched() skutočne ho spustila. Takže readp() vyvoláva wakeup(), odblokuje, nastaví IREAD a vyvoláva sleep(ip+2)— to všetko predtým, ako writep() obnoví cyklus.
Na tomto popise potrubí v šiestej edícii sme skončili. Jednoduchý kód, ďalekosiahle dôsledky.
(január 1979) bola novým hlavným vydaním (po štyroch rokoch), v ktorom sa objavilo množstvo nových aplikácií a vlastností jadra. Tiež došlo k významným zmenám týkajúcim sa použitia konverzií typov, unióv a typovaných ukazovateľov na štruktúry. Avšak prakticky sa nezmenil. Môžeme túto edíciu vynechať.
Xv6, jednoduché Unixové jadro
Na vytvorenie jadra mala vplyv šiestu edíciu Unixu, avšak je napísaná v modernom C, aby mohla bežať na x86 procesoroch. Kód je ľahko čitateľný a zrozumiteľný. Navyše, na rozdiel od zdrojových kódov Unixu z TUHS, môžete ho skompilovať, upraviť a spustiť na niečom inom ako PDP 11/70. Preto je toto jadro široko používané na vysokých školách ako učebný materiál o operačných systémoch. Zdrojové kódy .
Kód obsahuje zrozumiteľnú a premyslenú implementáciu , podloženú vyrovnávacou pamäťou namiesto inode na disku. Tu uvádzam len definíciu "struktúrneho potrubia" a funkcie pipealloc():
#define PIPESIZE 512

struct pipe {
  struct spinlock lock;
  char data[PIPESIZE];
  uint nread;     // number of bytes read
  uint nwrite;    // number of bytes written
  int readopen;   // read fd is still open
  int writeopen;  // write fd is still open
};

int
pipealloc(struct file **f0, struct file **f1)
{
  struct pipe *p;

  p = 0;
  *f0 = *f1 = 0;
  if((*f0 = filealloc()) == 0 || (*f1 = filealloc()) == 0)
    goto bad;
  if((p = (struct pipe*)kalloc()) == 0)
    goto bad;
  p->readopen = 1;
  p->writeopen = 1;
  p->nwrite = 0;
  p->nread = 0;
  initlock(&p->lock, "pipe");
  (*f0)->type = FD_PIPE;
  (*f0)->readable = 1;
  (*f0)->writable = 0;
  (*f0)->pipe = p;
  (*f1)->type = FD_PIPE;
  (*f1)->readable = 0;
  (*f1)->writable = 1;
  (*f1)->pipe = p;
  return 0;

 bad:
  if(p)
    kfree((char*)p);
  if(*f0)
    fileclose(*f0);
  if(*f1)
    fileclose(*f1);
  return -1;
}
pipealloc() nastavuje stav celej ostatnej implementácie, ktorá obsahuje funkcie piperead(), pipewrite() a pipeclose(). Skutočný systémový volanie sys_pipe je obálka implementovaná v . Odporúčam prečítať celý jeho kód. Zložitost na úrovni zdroja šiestej edície, ale čítanie je oveľa jednoduchšie a príjemnejšie.
Linux 0.01
Môžete nájsť zdrojový kód Linux 0.01. Bude poučné preskúmať implementáciu potrubí v jeho fs/pipe.c. Tu pre reprezentáciu potrubia sa používa inode, ale samotné potrubie je napísané v modernom C. Ak ste sa prebili cez kód šiestej edície, tu nenarazíte na problémy. Takto vyzerá funkcia write_pipe():
int write_pipe(struct m_inode * inode, char * buf, int count)
{
    char * b=buf;

    wake_up(&inode->i_wait);
    if (inode->i_count != 2) { /* no readers */
        current->signal |= (1<0) {
        while (PIPE_FULL(*inode)) {
            wake_up(&inode->i_wait);
            if (inode->i_count != 2) {
                current->signal |= (1<i_wait);
        }
        ((char *)inode->i_size)[PIPE_HEAD(*inode)] =
            get_fs_byte(b++);
        INC_PIPE( PIPE_HEAD(*inode) );
        wake_up(&inode->i_wait);
    }
    wake_up(&inode->i_wait);
    return b-buf;
}
Aj bez pohľadu na definície štruktúr je možné pochopiť, ako sa počítač odkazov inode používa na kontrolu toho, či zápisová operácia vedie k SIGPIPE. Okrem práce po bytoch je túto funkciu ľahko porovnať s vyššie uvedenými myšlienkami. Dokonca logika sleep_on/wake_up nevyzerá až tak cudzorodo.
Moderné jadrá Linux, FreeBSD, NetBSD, OpenBSD
Rýchlo som prebehol niekoľkými modernými jadrami. Žiadne z nich už nemá implementáciu využívajúcu disk (nie je prekvapením). V Linuxe existuje vlastná implementácia. A aj keď tri moderné jadra BSD obsahujú implementácie založené na kóde, ktorý napísal John Dyson, v priebehu rokov sa od seba odlišujú.
Aby sa dalo čítať fs/pipe.c (v Linuxe) alebo sys/kern/sys_pipe.c (na *BSD), vyžaduje skutočné odhodlanie. Dnes je v kóde dôležitý výkon a podpora takých funkcií, ako sú vektorové a asynchrónne operácie vstupu a výstupu. A detaily o alokácii pamäte, zamknutí a konfigurácii jadra sa veľmi líšia. Toto nie je to, čo potrebujú vysoké školy pre úvodný kurz operačných systémov.
V každom prípade ma zaujímalo odkryť niekoľko starých modelov (napríklad generovanie SIGPIPE a návrat EPIPE pri zápise do uzavretého potrubia) naprieč všetkými týmito, tak odlišnými, modernými jadrami. Pravdepodobne nikdy neuvidím PDP-11 naživo, ale stále je z kódu, ktorý bol napísaný niekoľko rokov pred mojím narodením, čoho sa učiť.
Článok napísaný Divi Kapoor v roku 2011 „“ je prehľad toho, ako fungujú (stále) potrubia v Linuxe. A ilustruje model interakcie potrubia, ktorého možnosti prekonávajú možnosti dočasných súborov; a ukazuje, ako ďaleko sa potrubia vzdialili od „veľmi konzervatívneho zamknutia“ v jadre Unix šiesteho vydania.
Zdroj: habr.com
