

Obrázok:
Pre agregátory v oblasti elektronického obchodu je mimoriadne dôležité udržiavať aktuálne informácie. V opačnom prípade stráca svoju hlavnú výhodu – možnosť vidieť najrelevantnejšie údaje na jednom mieste.
Na vyriešenie tohto problému je potrebné použiť techniku webového scraping-u. Jej podstata spočíva v vytvorení špeciálneho softvéru – crawlera, ktorý prechádza potrebné webové stránky zo zoznamu, ťažko parsuje informácie z nich a nahráva ich na stránku agregátora.
Problém je v tom, že vlastníci webových stránok, z ktorých agregátory berú údaje, často nechcú tak ľahko poskytovať prístup. Je to možné pochopiť – ak sa informácie o cene v internetovom obchode dostanú na stránku agregátora a budú vyššie ako u konkurencie, ktorá je tam rovnaká, podnik stratí zákazníkov.
Metódy proti scraping-u
Preto sa často vlastníci takýchto stránok bránia scraping-u – teda sťahovaniu svojich údajov. Môžu identifikovať požiadavky, ktoré odosielajú boty-crawleri podľa IP adresy. Zvyčajne takýto softvér používa tzv. serverové IP, ktoré sú ľahko vypočítateľné a blokovateľné.
Naviac, namiesto blokovania požiadaviek sa často používa aj iná metóda – identifikovaným botom sa zobrazuje nerelevantná informácia. Napríklad, zvyšujú alebo znižujú ceny na tovar alebo menia ich popisy.
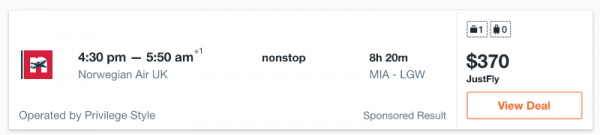
Príklad, ktorý sa často uvádza v tejto súvislosti – ceny leteniek. Naozaj, veľmi často letecké spoločnosti a cestovné kancelárie môžu zobrazovať rôzne výsledky pre rovnaké lety v závislosti od IP adresy. Skutočný prípad: hľadanie letenky z Miami do Londýna na ten istý dátum z IP adresy vo východnej Európe a Ázii vracia rôzne výsledky.
V prípade IP adresy vo východnej Európe cena vyzerá takto:
A pre IP adresu z Ázie takto:
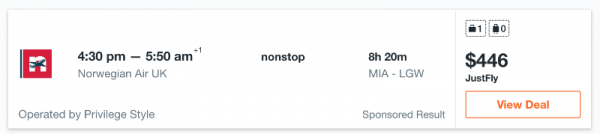
Ako je vidieť, cena za ten istý let sa výrazne líši – rozdiel činí 76 dolárov, čo je naozaj veľa. Pre stránku agregátora nie je nič horšie ako to – ak budú na nej zverejnené nesprávne informácie, používatelia ju nebudú využívať. Okrem toho, ak má agregátor pre konkrétny tovar jednu cenu, a pri prechode na stránku predajcu sa táto mení – to tiež negatívne ovplyvňuje povesť projektu.
Riešenie: používanie rezidentných proxy
Vyhnúť sa problémom pri skenovaní dát na potreby ich agregácie je možné pomocou rezidentných proxy. Serverové IP adresy poskytujú hostingoví poskytovatelia. Zistiť, ku ktorému poskytovateľovi patrí konkrétna adresa, je pomerne jednoduché – každé IP má ASN číslo, v ktorom sú tieto informácie obsiahnuté.
Existuje množstvo služieb na analýzu ASN čísiel. Často sú integrované s antispamovými systémami, ktoré blokujú prístup crawlerom alebo zmanipulujú údaje posielané v odpovediach na ich požiadavky.
Obísť takéto systémy pomáhajú rezidentné IP adresy. Tieto IP internetoví poskytovatelia vydávajú majiteľom nehnuteľností, s príslušnými označeniami vo všetkých súvisiacich databázach. Existujú špeciálne služby rezidentných proxy, ktoré umožňujú používať rezidentné adresy. – presne takáto služba.
Žiadosti, ktoré crawleri stránok-aggregátorov odosielajú z rezidentných IP, vyzerajú akoby prichádzali od bežných užívateľov z určitého regiónu. A bežných návštevníkov nikto neblokuje – v prípade internetových obchodov sú to potenciálni zákazníci.
Používanie rotovaných proxy od Infatica preto umožňuje stránkam-aggregátorom získať zaručene presné údaje a vyhnúť sa blokovaniu a problémom so skenovaním.
Ďalšie články na tému využívania rezidentných proxy pre podnikanie:
Zdroj: habr.com
