

V tomto článku sú zhromaždené niektoré všeobecné šablóny, ktoré pomáhajú inžinierom pracovať s rozsiahlymi službami, ku ktorým posielajú požiadavky milióny používateľov.
Na základe skúseností autora, toto nie je vyčerpávajúci zoznam, ale skutočne účinné rady. Tak začnime.
Preložené s podporou .
Základný plán
Nižšie uvedené opatrenia sú relatívne jednoduché na realizáciu, ale prinášajú vysokú návratnosť. Ak ste ich ešte neuplatnili, budete prekvapení významnými zlepšeniami.
Infrastruktúra ako kód
Prvá časť rád spočíva v realizácii infraštruktúry ako kódu. To znamená, že musíte mať programový spôsob nasadenia celej infraštruktúry. Znie to zložito, ale v skutočnosti hovoríme o nasledujúcom kóde:
Nasadenie 100 virtuálnych strojov
- s Ubuntu
- 2 GB RAM na každý
- budú mať nasledujúci kód
- s takýmito parametrami
Môžete sledovať zmeny v infraštruktúre a rýchlo sa k nim vrátiť pomocou systému správy verzií.
Modernista vo mne hovorí, že môžeme použiť Kubernetes/Docker, aby sme urobili všetko vyššie uvedené, a má pravdu.
Okrem toho zabezpečiť automatizáciu môžete pomocou Chef, Puppet alebo Terraform.
Neprerušená integrácia a dodávka
Na vytvorenie škálovateľnej služby je dôležité mať konvoj na zostavovanie a testovanie pre každý pull request. Aj keď je test najjednoduchší, aspoň zaručuje, že kód, ktorý nasadzujete, sa kompiluje.
Každý raz v tejto fáze odpovedáte na otázku: bude moja zostava kompilovať a prechádzať testami, je platná? Môže sa to zdať nízka latka, ale rieši množstvo problémov.
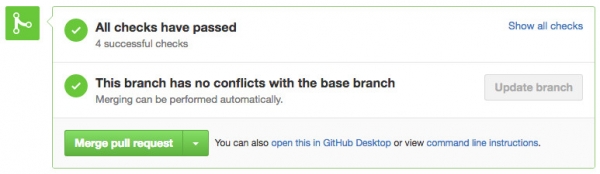
Nie je nič krásnejšie, než vidieť tieto začiarknutia
Pre túto technológiu môžete zvážiť Github, CircleCI alebo Jenkins.
Záťažové vyrovnávače
Takže chceme spustiť záťažový vyrovnávač, aby sme presmerovali dopravu a zabezpečili rovnomerné zaťaženie všetkých uzlov alebo funkčnosť služby v prípade výpadku:
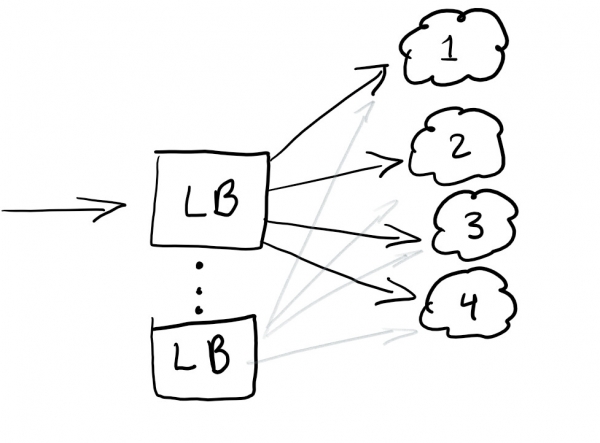
Záťažový vyrovnávač spravidla dobre pomáha rozdeľovať dopravu. Najlepšou praxou je redundantné vyrovnávanie, aby ste nemali jediný bod zlyhania.
Zvyčajne sa záťažové vyrovnávače nastavujú v tom cloude, ktorý používate.
RayID, korelačný ID alebo UUID pre dotazy
Stretli ste sa niekedy s chybou v aplikácii s upozornením podobným tomuto: „Niečo sa pokazilo. Uložte si toto ID a pošlite ho našej podpore“?
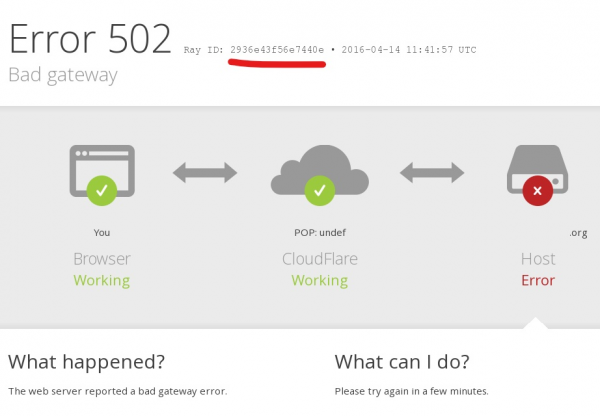
Jedinečný identifikátor, korelačný ID, RayID alebo akákoľvek varianta — to je jedinečný identifikátor, ktorý umožňuje sledovať požiadavku počas jej životného cyklu. To umožňuje sledovať celú cestu požiadavky v protokoloch.
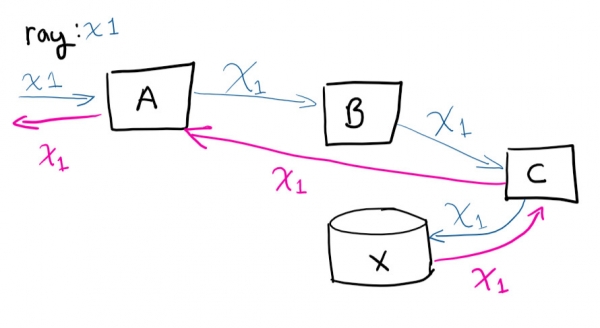
Používateľ zasiela požiadavku k systému A, potom A spojí s B, B spojí s C, uloží do X a následne sa požiadavka vracia do A
Keby ste sa na diaľku pripojili k virtuálnym strojom a snažili sa vysledovať cestu požiadavky (a manuálne zodpovedať, aké volania prebiehajú), šli by ste z toho do šialenstva. Mať jedinečný identifikátor výrazne uľahčuje život. Je to jedna z najjednoduchších vecí, ktoré môžete urobiť, aby ste ušetrili čas, ako sa služba rozrastá.
Priemerná úroveň
Tu sú rady náročnejšie ako predchádzajúce, ale správne nástroje uľahčujú úlohu, poskytujúc návratnosť investícií aj pre malé a stredné firmy.
Centralizované vedenie protokolov
Blahoželáme! Nasadili ste 100 virtuálnych strojov. Na ďalší deň prichádza generálny riaditeľ a sťažuje sa na chybu, ktorú dostal počas testovania služby. Oznámil príslušné ID, o ktorom sme hovorili vyššie, ale bude potrebné prehľadávať protokoly 100 strojov, aby ste našli ten, ktorý spôsobil zlyhanie. A to musí byť nájdené pred zajtrajšou prezentáciou.
Hoci to znie ako zábavné dobrodružstvo, je lepšie sa uistiť, že máte možnosť vyhľadávať vo všetkých protokoloch z jedného miesta. Riešil som problém centralizácie protokolov pomocou vstavaných funkcií ELK stacku: tu sa podporuje zber protokolov s vyhľadávacími možnosťami. To naozaj pomôže vyriešiť problém s vyhľadávaním konkrétneho protokolu. Ako bonus môžete vytvárať grafy a podobné zábavné veci.
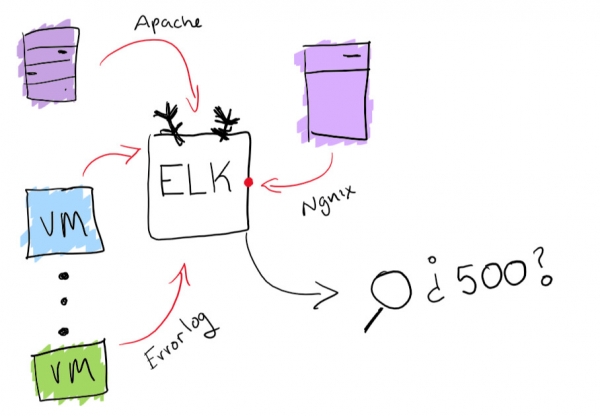
Funkcionalita ELK stacku
Monitorovacie agenti
Teraz, keď je vaša služba uvedená do prevádzky, musíte sa uistiť, že funguje bez problémov. Najlepší spôsob, ako to urobiť, je spustiť niekoľko agentov, ktorí pracujú súčasne a kontrolujú, že funguje a vykonávajú základné operácie.
V tomto kroku kontrolujete, či Spustená zostava sa cíti dobre a normálne funguje.
Pre malé a stredné projekty odporúčam Postman na monitorovanie a dokumentovanie API. Ale vo všeobecnosti by ste jednoducho mali mať spôsob, ako zistiť, kedy došlo k chybe, a dostať včasné upozornenie.
Automatické škálovanie na základe zaťaženia
Je to veľmi jednoduché. Ak máte virtuálny stroj, ktorý obsluhuje požiadavky, a blíži sa k tomu, že je zaneprázdnené 80% pamäte, môžete buď zvýšiť jeho zdroje, alebo pridať do clusteru viac virtuálnych strojov. Automatické vykonávanie týchto operácií je vynikajúce pre elastické prispôsobenie kapacity pod zaťažením. Ale vždy by ste mali byť opatrní, koľko peňazí míňate, a nastaviť rozumné limity.
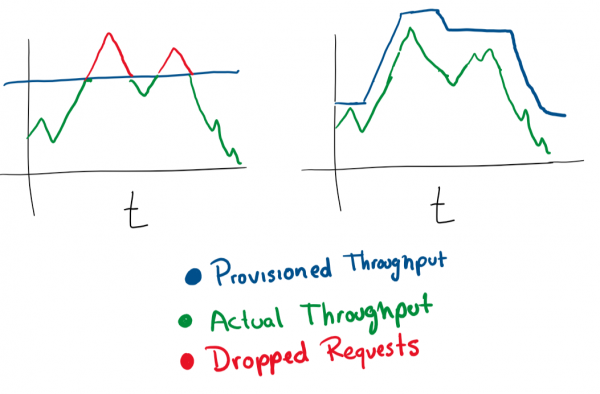
Vo väčšine cloudových služieb môžete nastaviť automatické škálovanie pomocou väčšieho počtu serverov alebo výkonnejších serverov.
Systém experimentov
Dobrým spôsobom, ako bezpečne nasadiť aktualizácie, je možnosť testovať niečo pre 1% používateľov počas hodiny. Určite ste videli také mechanizmy v akcii. Napríklad Facebook zobrazuje časti publika inú farbu alebo mení veľkosť písma, aby zistil, ako používatelia vnímajú zmeny. Toto sa nazýva A/B testovanie.
Dokonca aj uvedenie novej funkcie môžete spustiť ako experiment a potom určiť, ako ju uviesť. Taktiež získavate možnosť "vzpomenúť" si alebo meniť konfiguráciu za chodu, ak má funkcia za následok zhoršenie vášho servisu.
Pokročilá úroveň
Tu sú rady, ktoré sú dosť ťažko realizovateľné. Pravdepodobne budete potrebovať trochu viac zdrojov, takže malej alebo strednej firme sa s tým bude ťažko vyrovnať.
Modro-zelené nasadenia
To je to, čo nazývam 'erlangovým' spôsobom nasadenia. Erlang sa stal široko používaným, keď sa objavili telefónne spoločnosti. Na smerovanie telefonických hovorov sa začali používať softvérové prepínače. Hlavná úloha softvéru týchto prepínačov spočívala v tom, aby pri aktualizácii systému nedochádzalo k zrušeniu hovorov. Erlang má skvelý spôsob, ako načítať nový modul bez zrútenia predchádzajúceho.
Tento krok závisí od prítomnosti vyrovnávača záťaže. Predpokladajme, že máte verziu N vášho softvéru a potom chcete nasadiť verziu N+1.
Vy mohli by jednoducho zastaviť službu a nasadiť ďalšiu verziu v čase, ktorý považujete za vhodný pre svojich používateľov, a získať nejaký čas výpadku. Ale predpokladajme, že máte naozaj prísne podmienky SLA. SLA 99,99 % znamená, že môžete byť offline iba 52 minút ročne.
Ak chcete naozaj dosiahnuť takéto výsledky, potrebujete dve nasadenia súčasne:
- to, ktoré je práve teraz (N);
- nasledujúca verzia (N+1).
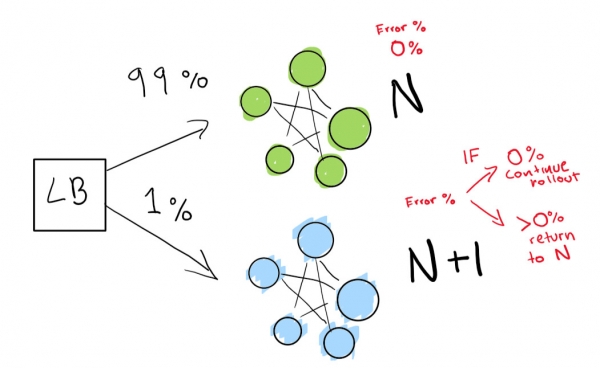
Hovoríte vyrovnávaču záťaže, aby presmeroval percento prevádzky na novú verziu (N+1), zatiaľ čo aktívne sledujete regresie.
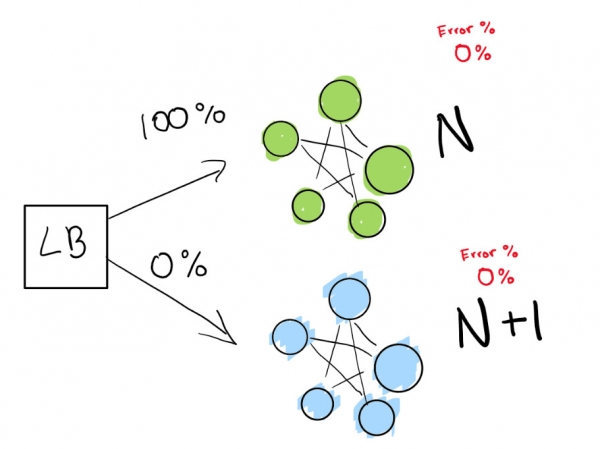
Tu máme zelené nasadenie N, ktoré funguje normálne. Pokúšame sa prejsť na nasledujúcu verziu tohto nasadenia
Najprv posielame skutočne malý test, aby sme zistili, či naše nasadenie N+1 funguje s malým množstvom prevádzky:
Nakoniec máme súbor automatických kontrol, ktoré nakoniec spustíme, kým naše nasadenie nebude dokončené. Ak ste veľmi, veľmi opatrní, môžete si tiež navždy ponechať svoje nasadenie N na rýchly návrat späť v prípade zlých regresií:
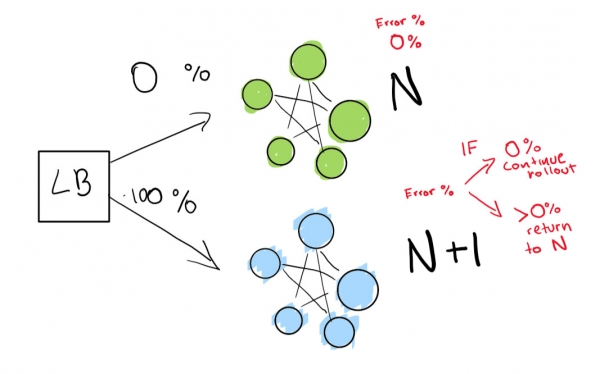
Ak chcete ísť na ešte pokročilejšiu úroveň, nechajte všetko v modro-zelenom nasadení vykonávať automaticky.
Zistenie anomálií a automatické zmiernenie dôsledkov
Vzhľadom k tomu, že máte centralizované vedenie záznamov a dobré zbieranie logov, môžete už nastaviť vyššie ciele. Napríklad proaktívne predpovedať poruchy. Na monitoroch a v logoch sa sledujú funkcie a vytvárajú rôzne grafy — a môžete vopred predpovedať, čo sa pokazí:
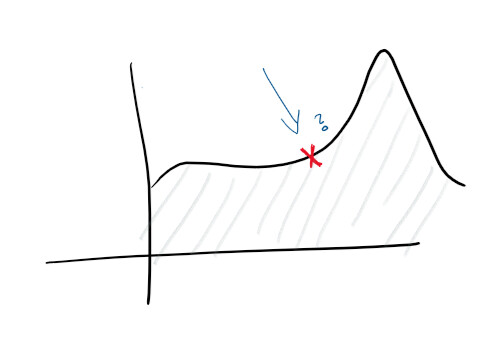
S detekciou anomálií začínate skúmať niektoré náznaky, ktoré služba poskytuje. Napríklad nárast zaťaženia CPU môže naznačovať, že pevný disk zlyháva, a nárast počtu požiadaviek znamená, že je potrebné škálovať. Tento typ štatistických údajov umožňuje, aby sa služba stala proaktívnou.
Získaním takýchto analytických údajov môžete škálovať v akomkoľvek rozmere, proaktívne a reaktívne meniť vlastnosti strojov, databáz, pripojení a iných zdrojov.
A to je všetko!
Tento zoznam priorít vás zbaví mnohých problémov, ak rozvíjate cloudovú službu.
Autor pôvodného článku vyzýva čitateľov, aby zanechali svoje komentáre a navrhovali zmeny. Článok sa šíri ako open source, pull requesty autor .
Čo ďalšie si prečítať na tému:
Zdroj: habr.com
