

Mnohí sú oboznámení s databázovým systémom PostgreSQL, ktorý sa osvedčil na malých inštaláciách. Avšak tendencia prechodu na Open Source sa stáva čoraz jasnejšou, aj keď ide o veľké spoločnosti a firemné požiadavky. V tomto článku sa podelíme o to, ako integrovať Postgres do firemného prostredia a zdieľame skúsenosti so systémom zálohovania (SRK) pre túto databázu na príklade zálohovacieho systému Commvault.
PostgreSQL už preukázala svoju účinnosť — databázový systém funguje skvele, používajú ho moderné digitálne podniky ako Alibaba a TripAdvisor, a jej bezplatnosť ju robí lákavou alternatívou k takým gigantům ako MS SQL alebo Oracle DB. Avšak, keď začneme rozmýšľať o PostgreSQL v prostredí Enterprise, narazíme na prísne požiadavky: "Ako to je s odolnosťou konfigurácie? Ako je to s katastrofickou odolnosťou? Kde je komplexný monitoring? A automatizované zálohovanie? A ako sa využívajú páskové knižnice, a to ako priamo, tak aj ako sekundárne úložisko?"
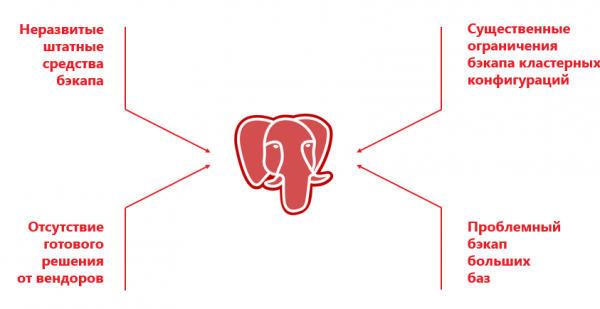
Na jednej strane, PostgreSQL nemá zabudované nástroje na zálohovanie, aké majú "dospelé" databázové systémy ako RMAN u Oracle DB alebo SAP Database Backup. Na druhej strane, dodávatelia firemných systémov na zálohovanie (Veeam, Veritas, Commvault) síce podporujú PostgreSQL, ale vlastne pracujú iba s určitými (zvyčajne samostatnými) konfiguráciami a so súborom rôznych obmedzení.
Špeciálne vyvinuté systémy zálohovania pre PostgreSQL, ako Barman, Wal-g, pg_probackup, sú mimoriadne populárne v malých inštaláciách databázy PostgreSQL alebo tam, kde nie sú potrebné ťažké zálohy iných prvkov IT prostredia. Napríklad, okrem PostgreSQL, môže byť v infraštruktúre fyzické a virtuálne, OpenShift, Oracle, MariaDB, Cassandra atď. Všetko toto by sa malo zálohovať spoločným nástrojom. Inštalácia samostatného riešenia výhradne pre PostgreSQL je nešťastný nápad: dáta sa skopírujú niekam na disk a potom ich treba archivovať na pásku. Takéto duplikovanie zálohovania zvyšuje čas zálohovania a, čo je kritickejšie, aj obnovovania. servery, OpenShift, Oracle, MariaDB, Cassandra atď. Všetko toto je žiaduce zálohovať pomocou spoločného nástroja. Vytvárať samostatné riešenie výlučne pre PostgreSQL — to je nešťastný nápad: dáta sa skopírujú niekam na disk, a potom ich treba uložiť na pásku. Takéto zdvojenie zálohovania zvyšuje čas zálohovania a tiež, čo je dôležitejšie, — obnovenia.
V enterprise riešení sa zálohovanie inštalácie uskutočňuje s počtom nód vyhradeného klasteru. Napríklad, Commvault dokáže pracovať iba s dvojnodovým klastrom, v ktorom sú Primary a Secondary pevne priradené k určitým nódam. Zálohovanie má význam len s Primary, pretože zálohovanie zo Secondary má svoje obmedzenia. V dôsledku špecifík DB sa dump na Secondary nevytvára, a preto zostáva len možnosť súborovej zálohy.
Aby sa znížili riziká výpadku, pri vytváraní odolného systému sa vytvára "živá" klclusterová konfigurácia a Primary môže postupne migrovať medzi rôznymi servermi. Napríklad, softvér Patroni sám spúšťa Primary na náhodne vybranej nódovej klastere. Systém správy rebootov (SRK) nemá spôsob, ako to sledovať "out of the box", a ak sa mení konfigurácia, procesy sa rozbijú. To znamená, že zavedenie vonkajšej správy bráni SRK efektívne fungovať, pretože spravujúci server jednoducho nechápe, odkiaľ a aké dáta je potrebné kopírovať.
Ďalší problém – implementácia zálohy v Postgres. Je možná cez dump a na malých databázach to funguje. Ale v veľkých DB sa dump robí dlho, vyžaduje veľa zdrojov a môže viesť k zlyhaniu inštancie DB.
Súborová záloha situáciu opravuje, ale na veľkých databázach ide pomaly, pretože funguje v jednovláknovom režime. Navyše, dodávatelia majú celý rad ďalších obmedzení. Niekedy nie je možné súčasne používať súborovú a dumpovú zálohu, inokedy nie je podporovaná deduplikácia. Problémov je veľa a častejšie je jednoduchšie namiesto Postgres vybrať drahú, ale osvedčenú DB.
Nie je úniku! Za nami je Moskva, vývojári!
Nedávno naša tím sa ocitol pred náročnou výzvou: v projekte vytvárania AIS OSAGO 2.0, kde sme robili IT infraštruktúru, si vývojári pre nový systém vybrali PostgreSQL.
Veľkým vývojárom softvéru je oveľa jednoduchšie používať "módne" open-source riešenia. V zamestnaní Facebooku je dostatočné množstvo odborníkov, ktorí udržiavajú fungovanie tejto DB. A v prípade RSA všetky úlohy "druhého dňa" spočívali na našich pleciach. Od nás sa vyžadovalo zabezpečiť odolnosť, zostaviť klaster a samozrejme nastaviť zálohovanie. Logika našich krokov bola taká:
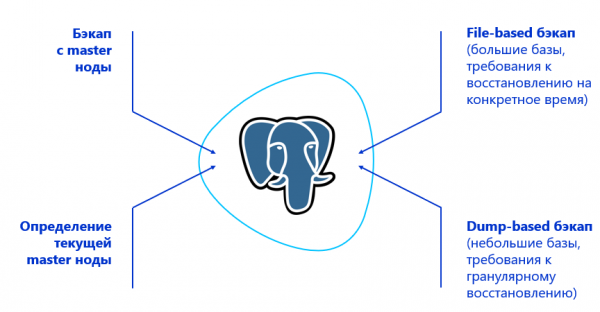
- Naučiť SRK robiť zálohu z primárneho uzla klastra. Na to musí SRK nájsť tento uzol — je teda potrebná integrácia s nejakým riešením na správu klastra PostgreSQL. V prípade RSA sa používal softvér Patroni.
- Rozhodnúť sa pre typ zálohy na základe objemov dát a požiadaviek na obnovu. Napríklad, ak je potrebné obnoviť stránky granularne, použiť dump, a ak sú databázy veľké a granularne obnovenie nie je potrebné — pracovať na úrovni súborov.
- Pripojiť k riešeniu možnosť blokovej zálohy, aby sa mohla vytvárať záloha v multithreadovom režime.
Pri tom sme si pôvodne stanovili cieľ vytvoriť efektívny a jednoduchý systém bez monštruóznej obvádzačky z ďalších komponentov. Čím menej berlíkov, tým menšia záťaž na personál a nižšie riziko poruchy SRK. Prístupy, v ktorých sa používali Veeam a RMAN, sme hneď vylúčili, pretože súprava dvoch riešení už naznačuje na spoľahlivosť systému.
Trochu mágie pre podnikové prostredie
Takže sme museli zaručiť spoľahlivé zálohovanie pre 10 klastrov po 3 uzly každý, pričom v záložnom DC zrkadlovo existuje rovnaká infraštruktúra. DC v prípade PostgreSQL fungujú na princípe active-passive. Celkový objem databáz činil 50 TB. S tým si hravo poradí akýkoľvek SRK podnikovej úrovne. Ale nuansa je v tom, že pôvodne neexistuje v Postgres žiadne spojenie pre úplnú a hlbokú kompatibilitu s systémami na zálohovanie. Preto sme museli hľadať riešenie, ktoré už od začiatku má maximálnu funkcionalitu v spojení s PostgreSQL a dopracovať systém.
Uskutočnili sme 3 interné hackathony — preskúmali sme viac než pol stovky návrhov, testovali ich, robili zmeny na základe našich hypotéz, a znova testovali. Po analýze dostupných možností sme si vybrali Commvault. Tento produkt už „z krabice“ mohol pracovať s najjednoduchšou klastrovou inštaláciou PostgreSQL, a jeho otvorená architektúra vyvolávala nádeje (ktoré sa splnili) na úspešné dopracovanie a integráciu. Taktiež Commvault dokáže vykonávať zálohu logov PostgreSQL. Napríklad, Veritas NetBackup v prípade PostgreSQL dokáže robiť iba úplné zálohy.
Viac informácií o architektúre. Riadiace servery Commvault boli nainštalované v každom z dvoch dátových centier v konfigurácii CommServ HA. Systém je zrkadlový, spravovaný cez jednu konzolu a z pohľadu HA spĺňa všetky požiadavky na úrovni enterprise.
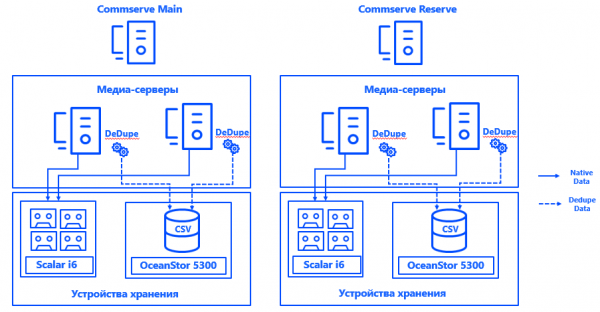
V každom dátovom centre sme spustili dve fyzické médiové servery, ku ktorým sme cez SAN pomocou Fibre Channel pripojili diskové polia a páskové knižnice špeciálne určené pre zálohy. Rozšírené deduplikačné databázy zabezpečili odolnosť médiových serverov voči poruchám, a pripojenie každého servera k každému CSV zabezpečilo možnosť kontinuálnej prevádzky aj pri výpadku akejkoľvek komponenty. Architektúra systému umožňuje pokračovať v zálohovaní aj v prípade, že jedno z dátových centier zlyhá.
Patroni určuje primárny uzol pre každý klaster. Môže ním byť ktorýkoľvek voľný uzol v dátovom centre — ale len v hlavnom. V rezervnom sú všetky uzly sekundárne.
Aby Commvault vedel, ktorý uzol klastru je primárny, integrovali sme systém (ďakujeme otvorenej architektúre riešenia) s Postgres. Na tento účel bol vytvorený skript, ktorý informuje správcu o aktuálnej polohe primárneho uzla. serveru Commvault.
Celkovo proces vyzerá takto:
Patroni vyberá primárny → Keepalived spúšťa IP-klaster a spúšťa skript → agent Commvault na vybranom uzle klastru dostáva oznámenie, že je to primárny → Commvault automaticky prispôsobuje zálohu v rámci pseudoklienta.
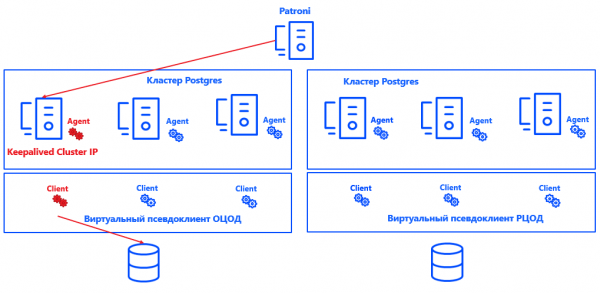
Výhodou tohto prístupu je, že riešenie neovplyvňuje ani konzistenciu, ani správnosť protokolov, ani obnovu inštancie Postgres. Takisto sa ľahko škáluje, pretože už nie je potrebné fixovať pre Commvault primárne a sekundárne uzly. Je dostatočné, že systém rozumie, kde je primárny, a počet uzlov môže byť zvýšený prakticky na akúkoľvek hodnotu.
Riešenie si nečiní nárok na dokonalosť a má svoje nuansy. Commvault dokáže zálohovať iba celú inštanciu, nie jednotlivé databázy. Preto bola pre každú databázu vytvorená osobná inštancia. Skutoční klienti sú skombinovaní do virtuálnych pseudoklientov. Každý pseudoklient Commvault predstavuje UNIX klaster. Do neho sa pridávajú tie uzly klastru, na ktorých je nainštalovaný agent Commvault pre Postgres. V dôsledku toho sa všetky virtuálne uzly pseudoklienta zálohujú ako jedna inštancia.
V každom pseudoklientovi je uvedená aktívna nódová klastre. Túto nódovú klastre definuje naše integračné riešenie pre Commvault. Princíp jeho fungovania je dosť jednoduchý: ak sa na nódovej klastre spustí klastre IP, skript nastaví v binárke agenta Commvault parameter "aktívna nódová klastre" — fakticky skript nastaví "1" na potrebnom mieste v pamäti. Agent prenáša tieto údaje na CommServe a Commvault vytvára zálohu z požadovaného uzla. Okrem toho sa na úrovni skriptu kontroluje správnosť konfigurácie, čím sa pomáha predchádzať chybám pri spúšťaní zálohovania.
Pri tom sa veľké databázy zálohujú blokovo v niekoľkých prúdoch, čím spĺňajú požiadavky RPO a okna zálohovania. Záťaž na systém je zanedbateľná: plné kópie sa nevykonávajú tak často, počas ostatných dní sa zbierajú iba logy, a to v obdobiach nízkej záťaže.
Mimochodom, zaviedli sme samostatné politiky pre zálohovanie archívnych záznamov PostgreSQL — tie sa uchovávajú podľa iných pravidiel, kopírujú sa podľa iného harmonogramu a pre ne sa nezapočíta deduplikácia, pretože tieto záznamy nesú unikátne údaje.
Aby sa zabezpečila konzistencia celej IT infraštruktúry, samostatní súboroví klienti Commvault sú nainštalovaní na každej nódovej klastre. Títo klienti vylučujú z záloh súbory Postgres a sú určení iba na zálohovanie operačného systému a aplikačných aplikácií. Pre túto časť dát je taktiež stanovená vlastná politika a vlastný čas uchovávania.
Momentálne SRK neovplyvňuje produktívne služby, ale ak sa situácia zmení, v Commvault sa môže aktivovať systém obmedzenia zaťaženia.
Je to v poriadku? Je to v poriadku!
Takže sme získali nielen funkčný, ale aj úplne automatizovaný záloh pre klastrovú inštaláciu PostgreSQL, ktorý je v súlade so všetkými požiadavkami podnikových výziev.
Parametre RPO a RTO na 1 hodinu a 2 hodiny sú prekryté s rezervou, čo znamená, že systém bude vyhovovať aj pri značnom raste objemu uchovávaných dát. Napriek mnohým pochybnostiam sa PostgreSQL a podnikové prostredie ukázali byť úplne kompatibilné. A teraz z vlastnej skúsenosti vieme, že zálohovanie pre takéto DBMS je možné v najrôznejších konfiguráciách.
Samozrejme, na tejto ceste sme museli opotrebovať sedem párov železných čižiem, prekonať množstvo ťažkostí, naraziť na niekoľko omylov a opraviť istý počet chýb. Ale teraz je prístup už otestovaný a môže byť použitý na implementáciu Open Source namiesto proprietárnych DBMS v náročných podmienkach enterprise.
Skúšali ste pracovať s PostgreSQL v korporátnom prostredí?
Autori:
Oleg Lavrenov, projektový inžinier systémov na ukladanie dát "Infosystemy Jet"
Dmitrij Jerykin, projektový inžinier výpočtových komplexov "Infosystemy Jet"
Zdroj: habr.com
