

Keď som zjedol novoročný olivier, nemal som čo robiť, a rozhodol som sa stiahnuť si na počítač všetky články z Habrhabra (a príbuzných platforiem) a preskúmať ich.
Vzniklo niekoľko zaujímavých príbehov. Prvý z nich je vývoj formátu a tematík článkov za 12 rokov existencie stránky. Napríklad, dynamika niektorých tém je veľmi výrečná. Pokračovanie je nižšie.
Proces parsovania
Aby som pochopil, ako sa Habr vyvíjal, musel som prejsť všetkými jeho článkami a vybrať z nich meta-informácie (napríklad dátumy). Prechádzanie bolo jednoduché, pretože odkazy na všetky články majú tvar "habrahabr.ru/post/337722/", pričom čísla sú striktne po poradí. Vedel som, že posledný príspevok má číslo o niečo menej ako 350 tisíc, a tak som jednoducho prešiel všetky možné id dokumentov cyklom (kód na Pythone):
import numpy as np
from multiprocessing import Pool
with Pool(100) as p:
    docs = p.map(download_document, np.arange(350000))
Funkcia download_document sa snaží načítať stránku s príslušným id a pokúša sa vytiahnuť z html štruktúry obsahovú informáciu.
import requests
from bs4 import BeautifulSoup

def download_document(pid):
    """ Stiahnuť a spracovať dokument Habr a jeho komentáre """
    # načítanie dokumentu
    r = requests.get('https://habrahabr.ru/post/' +str(pid) + '/')
    # parsovanie dokumentu
    soup = BeautifulSoup(r.text, 'html5lib') # namiesto html.parser
    doc = {}
    doc['id'] = pid
    if not soup.find("span", {"class": "post__title-text"}):
        # to sa stáva, ak článok neexistoval alebo bol odstránený
        doc['status'] = 'title_not_found'
    else:
        doc['status'] = 'ok'
        doc['title'] = soup.find("span", {"class": "post__title-text"}).text
        doc['text'] = soup.find("div", {"class": "post__text"}).text
        doc['time'] = soup.find("span", {"class": "post__time"}).text
        # vytvoriť ďalšie polia: hubs, tags, views, comments, votes, atď.
        # ...
    # uloženie výsledku do samostatného súboru
    fname = r'files/' + str(pid) + '.pkl'
    with open(fname, 'wb') as f:
        pickle.dump(doc, f)
Počas parsovania som objavil niekoľko nových vecí.
Po prvé, hovorí sa, že vytvárať viac procesov, ako je jadier v procesore, je zbytočné. Ale v mojom prípade sa ukázalo, že limitujúcim zdrojom nie je procesor, ale sieť, a 100 procesov funguje rýchlejšie než 4 alebo, povedzme, 20.
Po druhé, v niektorých príspevkoch sa objavili kombinácie špeciálnych znakov — napríklad eufemizmy typu "%&#@". Ukázalo sa, že html.parser, ktorý som používal najprv, reaguje na kombináciu &# bolestivo, považujúc ju za začiatok html entity. Už som sa chcel pustiť do čiernej mágie, ale na fóre mi poradili, že stačí zmeniť parser.
Po tretie, podarilo sa mi stiahnuť všetky publikácie okrem troch. Dokumenty s číslami 65927, 162075 a 275987 okamžite odstránil môj antivírus. Tieto články sa týkajú reťazca JavaScriptov, ktorý načítava škodlivý PDF, SMS-vydierača vo forme sadzby pluginov pre prehliadače a stránky CrashSafari.com, ktorá posiela iPhony do reštartu. Ešte jeden článok antivírus odhalil neskôr, pri skenovaní systému: príspevok 338586 o skriptoch na stránke zoobchodu, ktoré využívajú procesor používateľa na ťažbu kryptomeny. Takže môžeme považovať prácu antivírusu za celkom adekvátnu.
"Živých" článkov sa však našlo iba polovica z potenciálneho maxima — 166307 kusov. O ostatných Habr dáva možnosti "stránka zastaraná, bola odstránená alebo vôbec neexistovala". Nuž, to sa stáva.
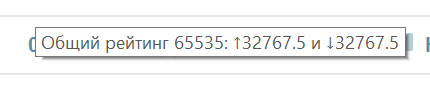
Po stiahnutí článkov nasledovala technická práca: napríklad, dátumy publikácie bolo potrebné previesť z formátu "’21. decembra 2006 o 10:47" do štandardného datetime, a "12,8k" zobrazení — na 12800. V tejto fáze sa objavilo ešte niekoľko kurióznych situácií. Najzábavnejšia sa týka počítania hlasov a typov dát: v niektorých starších príspevkoch došlo k pretečeniu int, a dostali 65535 hlasov.
Výsledkom je, že texty článkov (bez obrázkov) zaberali 1,5 gigabajtu, komentáre s meta informáciami ďalšie 3, a okolo sto megabajtov — meta informácia o článkoch. Takto je možné úplne sústrediť do RAM, čo bolo pre mňa milé prekvapenie.
Začal som analýzu článkov nie s textami, ale s meta informáciami: dátami, tagmi, hubmi, zobrazeniami a "lajkmi". Ukázalo sa, že aj ona môže veľa prezradiť.
Trendy vývoja Habrhabra
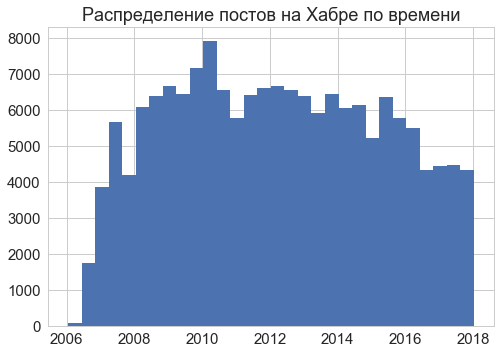
Články na stránke sa publikujú od roku 2006; najintenzívnejšie — v rokoch 2008-2016.
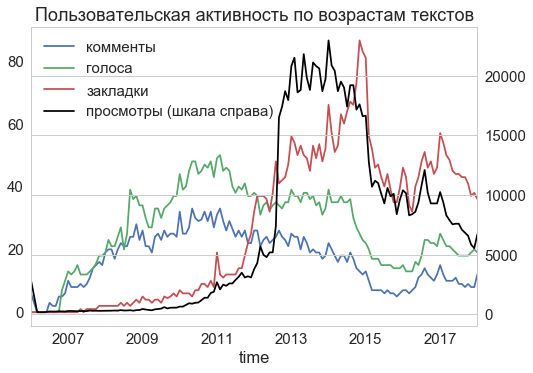
Hodnotiť, ako aktívne sa tieto články čítali v rôznych časoch, nie je také jednoduché. Texty z roku 2012 a mladšie sa viac aktívne komentovali a hodnotili, ale novšie texty majú viac zobrazení a pridaní do záložiek. Tieto metriky sa správali rovnako (dvojnásobne klesli) iba raz, v roku 2015. Možno, že v dobe hospodárskej a politickej krízy sa pozornosť čitateľov presunula z IT blogov k bolestivejším otázkam.
Okrem samotných článkov som stiahol aj komentáre k nim. Komentárov sa nazbieralo 6 miliónov, pričom 240 tisíc z nich bolo zakázaných ("priletelo UFO a zverejnilo tento zápis tu"). Užitočnou vlastnosťou komentárov je, že je pre ne uvedený čas. Študovaním času komentárov môžete približne pochopiť, kedy sa články vôbec čítajú.
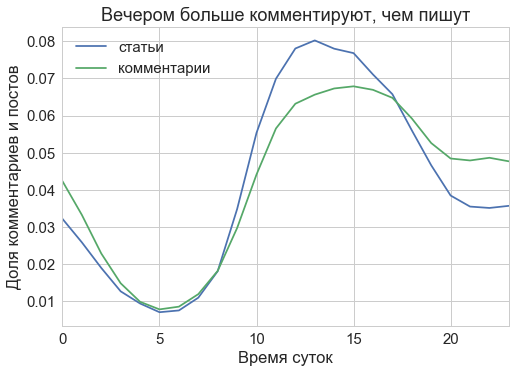
Ukázalo sa, že väčšinu článkov sa píše a komentuje niekde od 10:00 do 20:00, teda v typickom moskovskom pracovnom dni. To môže znamenať, že Habr čítajú z profesionálnych dôvodov, a tiež to môže byť dobrý spôsob prokrastinácie v práci. Mimochodom, toto rozloženie času počas dňa je stabilné od samotného založenia Habra až do dnešného dňa.
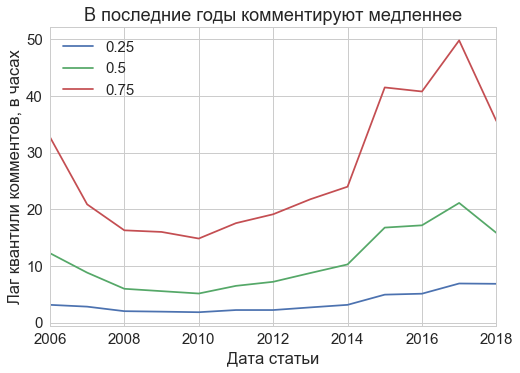
Hlavnou výhodou časovej pečiatky komentára však nie je čas dňa, ale doba "aktívneho života" článku. Spočítal som, ako je rozložený čas od publikácie článku po jeho komentár. Ukázalo sa, že teraz médiánový komentár (zelená čiara) prichádza približne po 20 hodinách, teda v prvých 24 hodinách po publikovaní zostáva v priemere o niečo viac ako polovica všetkých komentárov k článku. Po dvoch dňoch zostáva 75% všetkých komentárov. V minulosti sa články čítali ešte rýchlejšie – napríklad v roku 2010 prišla polovica komentárov už v prvých 6 hodinách.
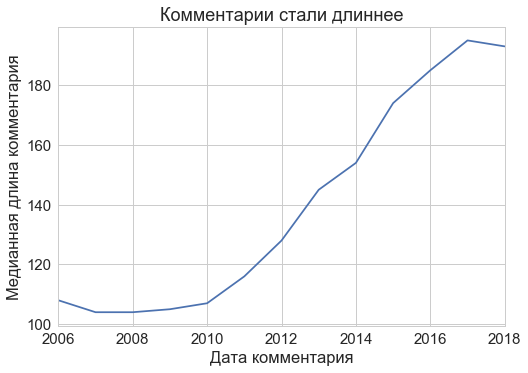
Prekvapilo ma, že komentáre sa predĺžili: priemerný počet znakov v komentári sa počas existencie Habra takmer zdvojnásobil!
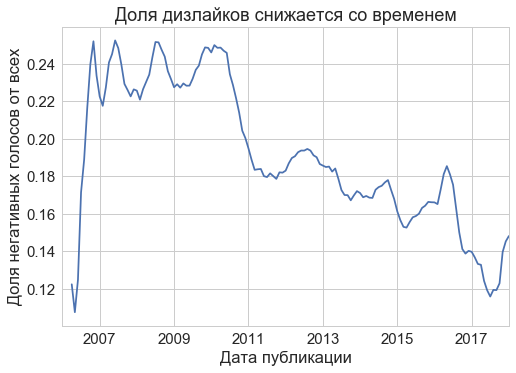
Jednoduchšia spätná väzba ako komentáre sú hlasy. Na rozdiel od mnohých iných zdrojov, na Habre môžete dávať nielen plusy, ale aj mínusy. Avšak poslednú možnosť čitatelia nevyužívajú tak často: aktuálny podiel dislike-ov je okolo 15% zo všetkých udelených hlasov. Predtým to bolo viac, ale časom čitatelia zmiernili svoje názory.
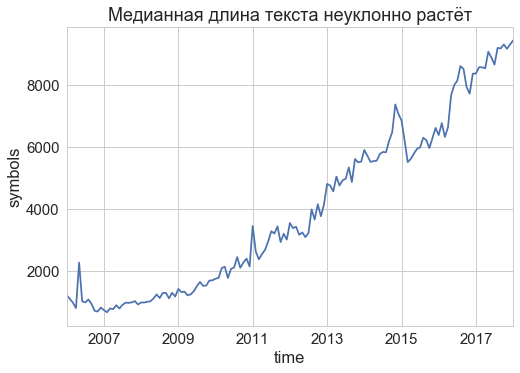
Texty sa časom takisto menili. Napríklad typická dĺžka textu neustále rastie od samotného spustenia stránky, napriek krízam. Za desať rokov sa texty stali takmer desaťkrát dlhšími!
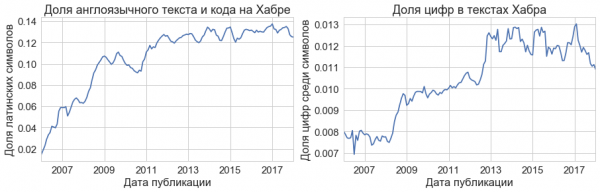
Štylistika textov (v prvom priblížení) sa takisto menila. Počas prvých rokov existencie Habra sa napríklad zvýšil podiel kódu a čísel v textoch:
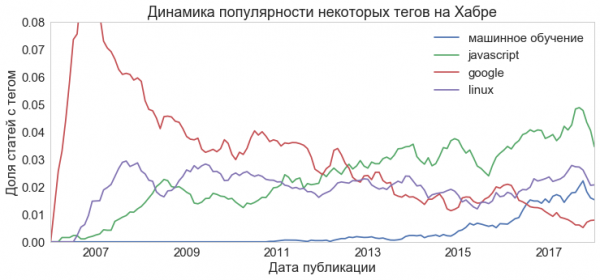
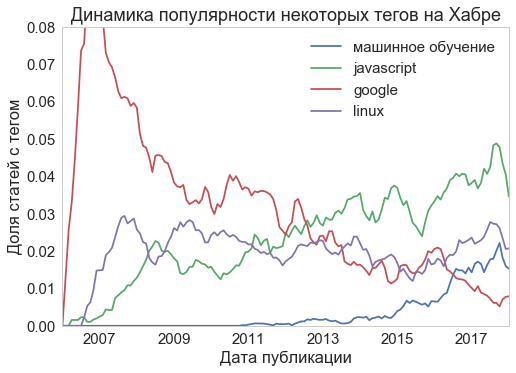
Keď som sa oboznámil so všeobecnou dynamikou webu, rozhodol som sa zmerať, ako sa menila popularita rôznych tém. Témy je možné automaticky vyfiltrovať z textov, ale na začiatok môžeme využiť už existujúce značky, ktoré priradili autori každého článku. Na grafe som zobraziť štyri typické trendy. Téma "Google" pôvodne dominovala (možno najmä kvôli SEO optimalizácii), ale s každým rokom strácala na váhe. Javascript bol populárnou témou a postupne pokračuje, zatiaľ čo strojové učenie začalo rýchlo získavať popularitu až v posledných rokoch. Linux však ostáva rovnako aktuálny počas celého desaťročia.
Samozrejme, zaujímalo ma, aké témy privádzajú viac čitateľskej aktivity. Spočítal som mediánový počet zobrazení, hlasov a komentárov v každej téme. Tu sú výsledky:
- Najviac sledované témy: arduino, webdizajn, webvývoj, digest, odkazy, css, html, html5, nginx, algoritmy.
- Najviac "lajkované" témy: vk, humor, jquery, opera, c, html, webvývoj, html5, css, webdizajn.
- Najviac diskutované témy: opera, skype, freelancing, vk, ubuntu, práca, nokia, nginx, arduino, firefox.
Mimochodom, keď už porovnávam témy, môžeme ich zoradiť podľa frekvencie (a porovnať výsledky s ).
- Po všetky roky existencie Habr boli najpopulárnejšími značkami (v zostupnom poradí) google, android, javascript, microsoft, linux, php, apple, java, python, programovanie, startupy, vývoj, ios, startup, sociálne siete.
- V roku 2017 boli najpopulárnejšie javascript, python, java, android, vývoj, linux, c++, programovanie, php, c#, ios, strojové učenie, informačná bezpečnosť, microsoft, react.
Pri porovnávaní týchto rebríčkov si môžeme všimnúť napríklad víťazné ťaženie Pythonu a vymieranie php, alebo "zánik" tematík startupov a vzostup strojového učenia.
Nie všetky tagy na Habr majú tak očividný tematický nádych. Tu je napríklad desiatok tagov, ktoré sa vyskytli iba raz, ale jednoducho sa mi zdali zábavné. Takže: "myšlienka ako hnací motor pokroku", "načítanie z obrazu disketky", "štát Iowa", "dramatúrgia", "superaleša", "parný motor", "čo robiť v sobotu", "mám líšku v mlynčeku na mäso", "a dopadlo to ako vždy", "vtipné tagy sa mi vymyslieť nepodarilo". Aby sme určili tému takýchto článkov, tagy nestačia — bude potrebné vykonať tematické modelovanie nad textami článkov.
Podrobnejšia analýza obsahu článkov bude v ďalšom príspevku. Po prvé, plánujem postaviť model, ktorý predpovedá počet zobrazení článku v závislosti od jeho obsahu. Po druhé, chcel by som naučiť neurónovú sieť generovať texty v tom istom štýle, ako majú autori Habr. Tak sa prihláste na odber 🙂
P.S. A tu je zakryté .
Zdroj: habr.com
