

Hovorí sa, že v živote treba všetko vyskúšať aspoň raz. A ak ste zvyknutí pracovať s relačnými databázami, odporúča sa oboznámiť sa prakticky s NoSQL predovšetkým pre všeobecný rozvoj. Vzhľadom na rýchly rozvoj tejto technológie existuje mnoho rozporuplných názorov a horlivých diskusií na túto tému, čo zvlášť podnecuje záujem.
Ak sa hlbšie zamyslíme nad podstatou týchto diskusií, ukáže sa, že vznikajú z nesprávneho prístupu. Tí, ktorí používajú NoSQL databázy presne tam, kde sú potrebné, sú spokojní a získavajú zo tohto riešenia všetky jeho výhody. Naopak, experimentátori, ktorí dúfajú v tuto technológiu ako v zázrak tam, kde nie je vôbec vhodná, zažívajú sklamanie, pretože prichádzajú o silné stránky relačných databáz bez zisku zohľadniteľných výhod.
Podelím sa o našu skúsenosť s implementáciou riešenia založeného na databáze Cassandra: s čím sme sa stretli, ako sme sa dostali z ťažkých situácií, či sme dokázali získať výhodu z používania NoSQL a kde sme museli investovať ďalšie úsilie/financie.
Pôvodná úloha sa týkala vytvorenia systému, ktorý zaznamenáva hovory do určitého úložiska.
Princíp fungovania systému je nasledujúci. Na vstup prichádzajú súbory s určitou štruktúrou, ktorá popisuje štruktúru hovoru. Následne aplikácia zabezpečuje ukladanie tejto štruktúry do príslušných stĺpcov. Uložené hovory sa následne využívajú – na zobrazenie informácií o využití dát pre účastníkov (účtovanie, hovory, história zostatku).
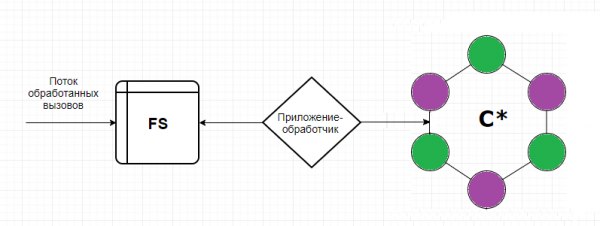
Prečo sme si vybrali Cassandru je celkom jasné — píše ako guľomet, ľahko sa škáluje, je odolná voči chybám.
Takže, tu je to, čo nám ponúkla skúsenosť
Áno, vyletelná uzol nie je katastrofa. V tom spočíva odolnosť Cassandry. Ale uzol môže byť živý a zároveň začať poklesať po výkonnosti. Ako sa ukázalo, to ihneď ovplyvňuje výkonnosť celého klastra.
Cassandra neochráni tam, kde Oracle udržoval pomocou svojich obmedzení. A ak autor aplikácie to dopredu nepochopil, tak zaslaný duplikát pre Cassandru nie je o nič horší ako originál. Ak prišiel, teda ho vložíme.
Bezplatná Cassandra "z krabice" sa náhle nepáčila IT bezpečnosti: neexistuje logovanie akcií používateľov, ani rozdelenie práv. Informácie o hovoroch sa týkajú osobných údajov, a to znamená, že všetky pokusy o ich požiadanie/zmenu musia byť zaznamenané s možnosťou následného auditu. Tiež je potrebné si uvedomiť nutnosť rozdeľovať práva na rôzne úrovne pre rôznych používateľov. Obvyklý inžinier prevádzky a superadministrátor, ktorý môže slobodne odstrániť celý keyspace – to sú rôzne role, rôzna zodpovednosť, kompetencia. Bez takéhoto rozdelenia prístupových práv sa hodnota a integrita dát okamžite dostanú pod otázku rýchlejšie, než pri úrovni konzistencie ANY.
Nehovorili sme o tom, že pre hovory je potrebná ako vážna analytika, tak aj periodické výbery podľa rôznych podmienok. Keďže vybrané záznamy sa potom predpokladajú na odstránenie a prepísanie (v rámci úlohy musíme podporovať proces aktualizácie dát pri pôvodne nesprávne doručených dátach do našeho prostredia), Cassandra nie je naším spoločníkom. Cassandra, ako pokladnica – je pohodlné do nej skladovať, ale nedá sa z nej počítať.
Stretli sme sa s problémom prenosu dát do testovacích zón (5 uzlov v teste oproti 20 v produkcii). Dump v tomto prípade nebude možné použiť.
Problém s aktualizáciou schémy dát aplikácie, ktorá zapisuje do Cassandry. Rollback vytvorí obrovské množstvo nadrobí, čo môže nepredvídateľným spôsobom znížiť výkon. Cassandra je optimalizovaná pre zápis a pred zápisom sa veľa nezamýšľa. Akákoľvek operácia s existujúcimi dátami je tiež zápis. T. j. odstránením zbytočného len vytvoríme ešte viac záznamov, a len časť z nich bude označená ako nadrobia.
Časové obmedzenia pri vkladaní. Cassandra je v zápise skvelá, ale niekedy prichádzajúci tok ju môže značně zneistiť. To sa stáva, keď aplikácia začína s niekoľkými záznamami, ktoré sa nedajú vložiť z nejakého dôvodu. A budeme potrebovať skutočného DBA, ktorý bude sledovať gc.log, logy system a debug kvôli pomalým dotazom, metrikám na comapction pending.
Niekoľko dátových centier v klastri. Odkiaľ čítať a kam zapisovať?
Je možné rozdeliť na čítanie a zápis? A ak áno, mal by byť DC bližšie k aplikácii pre zápis alebo pre čítanie? A nezískať tak naozajstný split brain, ak nesprávne vyberieme úroveň konzistencie? Veľa otázok, veľa nepreskúmaných nastavení a možností, ktoré by sme chceli vyskúšať.
Ako sme sa rozhodli
Aby nód neskolaboval, vypnuli sme SWAP. A teraz, pri nedostatku pamäte, by nód mal spadnúť, a nie produkovať dlhé gc pauzy.
Takže na logiku v DB už viac nedúfame. Vývojári aplikácie sa preškoľujú a začínajú sa aktívne chrániť vo vlastnom kóde. Ideálne jasné oddelenie uchovávania a spracovania dát.
Kúpili sme podporu od DataStax. Krabicová Cassandra už prestala byť vyvíjaná (posledný commit v februári 2018). Zároveň však Datastax ponúka vynikajúcu službu a množstvo vylepšených a prispôsobených riešení pre existujúce IS.
Ešte chcem poznamenať, že Cassandra nie je veľmi pohodlná na dotazy na výber. Samozrejme, CQL je veľký krok v ústrety používateľom (v porovnaní s Thriftom). Ale ak máte celé oddelenia, ktoré sú zvyknuté na takéto pohodlné joins, voľné filtrovanie podľa akéhokoľvek poľa a možnosti optimalizácie dotazu, a tieto oddelenia pracujú na uzatváraní sťažností a havárií, tak im riešenie na Cassandre pripadá nepriateľské a hlúpe. A začali sme riešiť otázku, ako naši kolegovia robia výbery.
Zvažovali sme dve možnosti. V prvej možnosti zapisujeme volania nielen do C*, ale aj do archívnej databázy Oracle. Rozdiel je v tom, že v tejto databáze sú uložené volania iba za aktuálny mesiac (dostatočná hĺbka uchovávania volaní pre prípady prehodnocovania). Tu sa ihneď objavila nasledujúca problém: ak zapisujeme synchronne, stratíme všetky výhody C*, súvisiace s rýchlym vkladaním, ak asynchrónne – nie je zaručené, že všetky potrebné volania sa vôbec dostanú do Oracle. Jedinou výhodou bol jeden, ale významný bod: na prevádzku zostáva stále rovnaký známy PL/SQL Developer, teda prakticky realizujeme vzor „Fasáda“. Alternatívna možnosť. Realizujeme mechanizmus, ktorý vyťahuje volania z C*, ťahá nejaké údaje na obohatenie z príslušných tabuliek v Oracle, spojí získané výbery a poskytne nám výsledok, ktorý potom nejako použijeme (vrátime, opakujeme, analyzujeme, obdivujeme). Nevýhody: proces sa stáva dosť viacfázovým, a okrem toho chýba rozhranie pre zamestnancov prevádzky.
Nakoniec sme sa predsa len rozhodli pre druhú možnosť. Na výbery z rôznych databáz sme použili Apache Spark. Podstata mechanizmu spočívala v Java kóde, ktorý na základe zadaných kľúčov (abonent, čas volania – kľúče sekcie) vyťahoval údaje z C*, ako aj potrebné údaje na obohatenie z akejkoľvek inej databázy. Potom ich spojil vo svojej pamäti a zobrazil výsledok v výslednej tabuľke. Nad Sparkom sme nakreslili webové rozhranie a výsledok bol celkom vhodný na prevádzku.
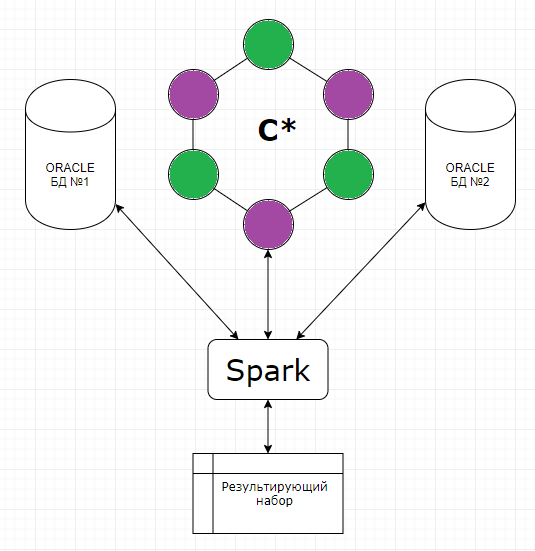
Pri riešení úlohy s aktualizáciou dát opäť zvážili niekoľko spôsobov riešenia. Ako prenos cez Sstloader, tak aj možnosť rozdelenia klastru v testovacej zóne na dve časti, pričom každá z nich striedavo vstupuje do jedného klastru s produkčným, čerpajúc tak od neho. Pri aktualizácii testu sa plánovalo meniť ich miestami: tá časť, ktorá pracovala v teste, sa vyčistí a zavádza do produkcie, zatiaľ čo druhá sa začne zaoberať dátami oddelene. Avšak, po ďalšom zvážení sme racionálnejšie posúdili tie údaje, ktoré stojí za to prenášať, a pochopili sme, že samotné výzvy – nekonzistentná entita pre testy, rýchlo generovaná v prípade potreby, a práve produkčný súbor dát nemá hodnotu na prenos do testu. Existuje niekoľko objektov-zhromažďovačov, ktoré stojí za to prenášať, ale to sú doslova len dve tabuľky, pričom nie sú veľmi náročné. Preto nám ako riešenie opäť pomohol Spark, pomocou ktorého sme napísali a začali aktívne používať skript na prenos dát medzi tabuľkami produkcia-test.
Naša aktuálna politika nasadzovania nám umožňuje pracovať bez návratov. Pred produkciou prebieha povinné nasadenie na test, kde je chyba menej nákladná. V prípade neúspechu je vždy možné zmazať keyspace a nasadiť celú schému od začiatku.
Na zabezpečenie nepokračujúcej dostupnosti Cassandry je potrebný DBA a nie len on. Všetci, ktorí pracujú s aplikáciou, musia chápať, kde a ako sledovať aktuálnu situáciu a ako včas diagnostikovať problémy. Na to aktívne používame DataStax OpsCenter (Správa a monitorovanie pracovných záťaží), systémové metriky Cassandra Driver (počet timeoutov na zápis do C*, počet timeoutov na čítanie z C*, maximálna latencia atď.), monitorujeme činnosť samotnej aplikácie, ktorá práve pracuje s Cassandrou.
Keď sme sa zamysleli nad predchádzajúcou otázkou, uvedomili sme si, kde môže byť náš hlavný riziko. Tým sú formy zobrazenia dát, ktoré vyťahujú údaje z niekoľkých navzájom nezávislých požiadaviek na úložisko. Takto môžeme získať pomerne nekonzistentné informácie. Avšak tento problém by bol rovnako aktuálny aj v prípade, keby sme pracovali iba s jedným dátovým centrom. Takže najrozumnejšie by bolo, samozrejme, vytvoriť dávkovú funkciu čítania údajov v externom aplikácii, ktorá zabezpečí získanie dát v jednotnom časovom období. Pokiaľ ide o rozdelenie na čítanie a zápis z hľadiska výkonu, tu nás zastavil riziko, že pri určitých stratách spojenia medzi dátovými centrami môžeme získať dva úplne nekonzistentné clustery.
Nakoniec, v súčasnosti sme sa rozhodli pre úroveň konzistencie pre zápis EACH_QUORUM, pre čítanie – LOCAL_QUORUM
Krátke dojmy a závery
Aby sme ocenili vyvinuté riešenie z hľadiska prevádzky a perspektívy ďalšieho rozvoja, rozhodli sme sa zamyslieť, kde ešte môžeme aplikovať takúto technológiu.
Ak hneď, tak scoring dát pre programy typu „Plať, keď ti to vyhovuje“ (nahrávame do S* informácie, výpočty na skriptoch Spark), sledovanie reklamácií s agregáciou podľa smerov, uchovávanie rolí a výpočty podľa rolového matice prístupových práv používateľov.
Ako vidíme, repertoár je široký a rozmanitý. A ak by sme mali vybrať tábor priaznivcov/odporkyň NoSQL, pripojíme sa k priaznivcom, pretože sme získali svoje výhody, a to presne tam, kde sme očakávali.
Aj variant Cassandra z krabice umožňuje horizontálne škálovanie v reálnom čase, bezproblémovo rieši otázku zvyšovania údajov v systéme. Podarilo sa nám vyčleniť do samostatného kontúru veľmi zaťažený mechanizmus na výpočet agregátov z hovorov, ako aj rozdeliť schému a logiku aplikácie, zbaviac sa zle očividnej praxe písania vlastných úloh a objektov v samotnej databáze. Získali sme možnosť vyberať a nastavovať, pre urýchlenie, na ktorých dátových centrách budeme robiť výpočty a na ktorých zapisovať dáta, čím sme sa chránili pred zlyhaniami jednotlivých uzlov, ako aj celkovo dátového centra.
Pri aplikácii našej architektúry na nové projekty, pričom už máme určitú skúsenosť, by sme mali hneď zohľadniť vyššie popísané nuansy a prediť niektorým chybám, vyhladiť určité ostré hrany, ktorým sme sa pôvodne nevyhli.
Napríklad, včas sledovať aktualizácie samotnej Cassandry., pretože množstvo problémov, ktoré sme zažili, už bolo známych a opravených.
Nesadit samotnú databázu a Spark na rovnaké uzly. (alebo prísne rozlišovať podľa počtu povoleného využitia zdrojov), pretože Spark môže spotrebovať viac pamäte, než je povolené, a rýchlo sa dostaneme k problému číslo 1 z nášho zoznamu.
Zlepšiť monitoring a odborné zručnosti v oblasti prevádzky už v etape testovania projektu. Pôvodne zohľadniť maximálne všetkých potenciálnych používateľov nášho riešenia,pretože práve od toho bude nakoniec závisieť štruktúra databázy.
Niekoľkokrát prehodnotiť získanú schému z pohľadu možnej optimalizácie. Určiť, ktoré polia je možné serializovať. Pochopiť, aké ďalšie tabuľky potrebujeme vytvoriť, aby sme čo najpresnejšie a optimálne zohľadnili a neskôr poskytli požadované informácie (napríklad, ak predpokladáme, že rovnaké údaje môžeme uchovávať v rôznych tabuľkách s rôznym rozdelením podľa rôznych kritérií, môžeme výrazne ušetriť procesorový čas pri čítacích dopytoch).
Nie je zlé ihneď predpokladať zavedenie TTL a čistenie zastaraných údajov.
Pri exportovaní údajov z Cassandry, logika aplikácie by mala fungovať na princípe FETCH, aby sa všetky riadky nenačítali do pamäte naraz, ale vyberali sa po dávkach.
Odporúča sa pred prechodom projektu na opísané riešenie skontrolovať odolnosť systému vykonaním série crash-testov,, ako je strata údajov v jednom dátovom centre, obnova poškodených údajov za určitý čas, pokles siete medzi dátovými centrami. Tieto testy nielen umožnia oceniť výhody a nevýhody navrhnutej architektúry, ale poskytnú aj dobrú rozcvičku inžinierom, ktorí ich vykonávajú, a získaná zručnosť sa ukáže ako veľmi užitočná, ak sa poruchy systému budú v praxi opakovať.
Ak pracujeme s kritickými informáciami (ako sú údaje na fakturáciu, výpočet dlhu zákazníka), je dôležité venovať pozornosť nástrojom, ktoré pomôžu znížiť riziká vyplývajúce z vlastností DBMS. Napríklad je možné použiť nástroj nodesync (Datastax) a vypracovať optimálnu stratégiu jeho používania, aby sa pre konzistenciu nevytvorila nadmerná záťaž na Cassandre a používať ho len pre určité tabuľky v určitých obdobiach.
Čo sa stalo po šiestich mesiacoch života s Cassandrou? Celkovo sme nemali nevyriešené problémy. Závažné havárie a strata údajov sa tiež nevyskytli. Áno, bolo potrebné zamyslieť sa nad kompenzáciou niektorých problémov, ktoré predtým nevznikali, ale nakoniec to našu architektonickú rozhodnutie výrazne neovplyvnilo. Ak chcete a nebojíte sa vyskúšať niečo nové, zároveň si neželáte byť príliš sklamaní, pripravte sa na to, že nič nie je zadarmo. Bude potrebné sa ponoriť do dokumentácie a zhromaždiť si svoje vlastné skúsenosti viac ako pri starých riešeniach legacy a žiadna teória vám vopred nepovie, aké prekážky čakajú práve na vás.
Zdroj: habr.com
