

Pred nejakým časom sme sa ocitli pred otázkou výberu ETL nástroja pre prácu s BigData. Predtým používané riešenie Informatica BDM nám nevyhovovalo kvôli obmedzenej funkcionalite. Jej použitie sa zúžilo na rámec na spúšťanie príkazov spark-submit. Na trhu nebolo veľa analógov, ktoré by vo všeobecnosti boli schopné pracovať s objemom údajov, s ktorými sa dennodenne stretávame. Nakoniec sme si vybrali Ab Initio. Počas pilotných prezentácií produkt ukázal veľmi vysokú rýchlosť spracovania údajov. Informácie o Ab Initio v slovenčine sú takmer nemožné nájsť, preto sme sa rozhodli podeliť o svoje skúsenosti na Habbre.
Ab Initio disponuje množstvom klasických a neobvyklých transformácií, ktorých kód môže byť rozšírený pomocou vlastného jazyka PDL. Pre malé podniky je tento mocný nástroj pravdepodobne nadbytočný a väčšina jeho funkcií môže byť nákladná a nevyužívaná. Ale ak sa vaše rozsahy blížia k sberovským, Ab Initio by vás mohlo zaujímať.
Pomáha podnikom globálne zhromažďovať poznatky a rozvíjať ekosystém, zatiaľ čo vývojárovi umožňuje zlepšovať svoje zručnosti v ETL, zdokonaľovať znalosti v shell, poskytuje možnosť osvojenia si jazyka PDL, dáva vizuálny prehľad o procesoch nahrávania a zjednodušuje vývoj vďaka množstvu funkčných komponentov.
V tomto príspevku sa podelím o možnosti Ab Initio a poskytnem porovnávacie charakteristiky práce s Hive a GreenPlum.
- Popis rámca MDW a práce na jeho doladení k GreenPlum
- Porovnávacie charakteristiky výkonu Ab Initio pri práci s Hive a GreenPlum
- Práca Ab Initio s GreenPlum v režime Near Real Time
Funkcionalita tohto produktu je veľmi široká a vyžaduje nemalo času na jeho štúdium. Avšak so správnymi zručnosťami a správnymi nastaveniami výkonnosti sú výsledky spracovania údajov mimoriadne pôsobivé. Použitie Ab Initio pre vývojára môže poskytnúť zaujímavé skúsenosti. Je to nový pohľad na ETL vývoj, hybrid medzi vizuálnym prostredím a vývojom nahrávania v skriptovskom jazyku.
Biznis rozvíja svoje ekosystémy a tento nástroj sa mu hodí ako nikdy predtým. S pomocou Ab Initio je možné zhromažďovať vedomosti o aktuálnom biznise a využívať tieto vedomosti na rozšírenie starých a otvorenie nových biznisov. Alternatívami k Ab Initio sú vizuálne prostredia ako Informatica BDM a neviditeľné prostredia ako Apache Spark.
Popis Ab Initio
Ab Initio, rovnako ako iné ETL nástroje, predstavuje súbor produktov.
Ab Initio GDE (Graphical Development Environment) je prostredie pre vývojárov, v ktorom si nastavujú transformácie dát a spájajú ich tokmi dát vo forme šípok. Takýto súbor transformácií sa nazýva graf:
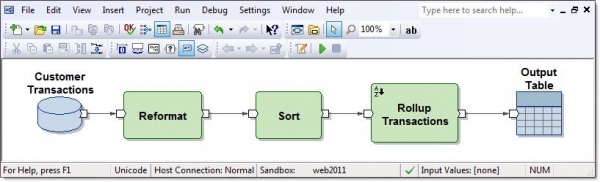
Vstupné a výstupné spojenia funkčných komponentov sú porty a obsahujú polia, vypočítané v rámci transformácií. Niekoľko grafov, spojených tokmi vo forme šípok v poradí ich vykonania, sa nazýva plán.
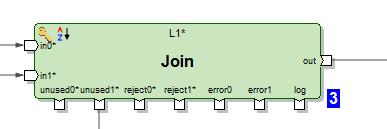
Existuje niekoľko stoviek funkčných komponentov, čo je veľmi veľa. Mnohé z nich sú úzko špecializované. Možnosti klasických transformácií v Ab Initio sú širšie ako v iných ETL nástrojoch. Napríklad Join má niekoľko výstupov. Okrem výsledku spojenia datasetov je možné na vstupe získať záznamy vstupných datasetov, podľa ktorých sa nepodarilo spojiť. Tiež je možné získať rejects, errors a log pracovnej transformácie, ktorý je možné v rovnakom grafe prečítať ako textový súbor a spracovať inými transformáciami:
Alebo, napríklad, je možné materializovať prijímač dát vo forme tabuľky a v rovnakom grafe z neho čítať dáta.
Existujú originálne transformácie. Napríklad, transformácia Scan má funkčnosť ako analytické funkcie. Existujú transformácie s hovorovými názvami: Create Data, Read Excel, Normalize, Sort within Groups, Run Program, Run SQL, Join with DB a ďalšie. Grafy môžu využívať parametre vykonávania, vrátane možnosti prenosu parametrov z operačného systému alebo do operačného systému. Soubory s pripravenou sadou prenášaných parametrov sa nazývajú parameter sets (psets).
Ako sa patrí, Ab Initio GDE má svoj repozitár, nazývaný EME (Enterprise Meta Environment). Vývojári majú možnosť pracovať s lokálnymi verziami kódu a robiť check in svojich vývojov do centrálneho repozitára.
Počas alebo po dokončení grafu máte možnosť kliknúť na akúkoľvek spojnicu transformácie toku a pozrieť si údaje, ktoré prešli medzi týmito transformáciami:
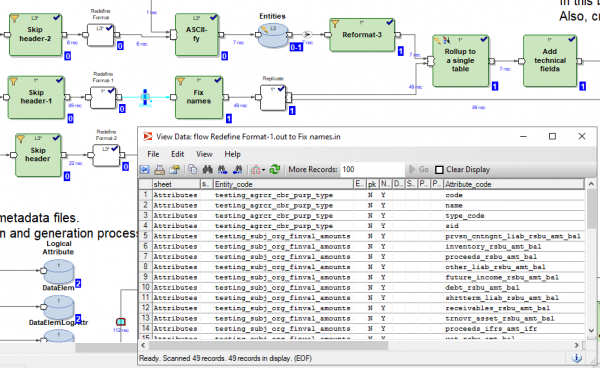
Takisto je možné kliknúť na akýkoľvek tok a pozrieť si podrobnosti sledovania – koľko paralelne pracovalo transformácií, koľko riadkov a bajtov sa načítalo v ktorej z paralel podľa:
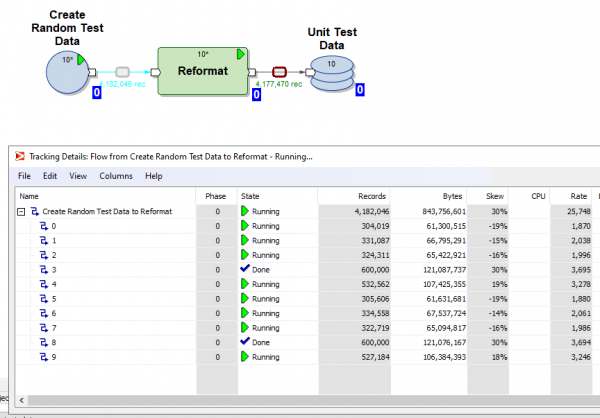
Je možné rozdeliť vykonanie grafu na fázy a označiť, že niektoré transformácie treba vykonávať ako prvé (v nulovej fáze), nasledujúce v prvej fáze, nasledujúce v druhej fáze a tak ďalej.
Každú transformáciu je možné vybrať takzvaný layout (kde bude vykonávaná): bez paralel alebo v paralelných tokoch, ktorých počet je možné zadať. Pri tom dočasné súbory, ktoré vytvára Ab Initio pri práci transformácií, je možné umiestniť ako do súborového systému servera, tak aj do HDFS.
V každej transformácii na základe šablóny je možné vytvoriť svoj vlastný skript v jazyku PDL, ktorý sa trochu podobá shell.
Pomocou jazyka PDL môžete rozširovať funkčnosť transformácií a konkrétne môžete dynamicky (počas vykonávania) generovať ľubovoľné útržky kódu v závislosti od parametrov času vykonávania.
V Ab Initio je tiež dobre vyvinutá integrácia s operačným systémom cez shell. Konkrétne v Sberbanke sa používa linux ksh. Je možné zdieľať s shellom premenné a používať ich ako parametre grafov. Je možné z shellu spúšťať vykonávanie grafov Ab Initio a spravovať Ab Initio.
Okrem Ab Initio GDE dodávka obsahuje mnoho iných produktov. Existuje vlastný Co>Operation System, ktorý sa snaží nazývať operačným systémom. Existuje Control>Center, v ktorom je možné plánovať a monitorovať toky načítania. Existujú produkty na realizáciu vývoja na primitívnejšej úrovni, ako umožňuje Ab Initio GDE.
Popis rámca MDW a práce na jeho doladení k GreenPlum
Spolu so svojimi produktmi dodávateľ poskytuje produkt MDW (Metadata Driven Warehouse), ktorý predstavuje konfigurátor grafov určený na pomoc pri typických úlohách plnenia dátových skladov alebo data vaults.
Obsahuje vlastné (špecifické pre projekt) parsery metadat a hotové generátory kódu 'ihneď'.
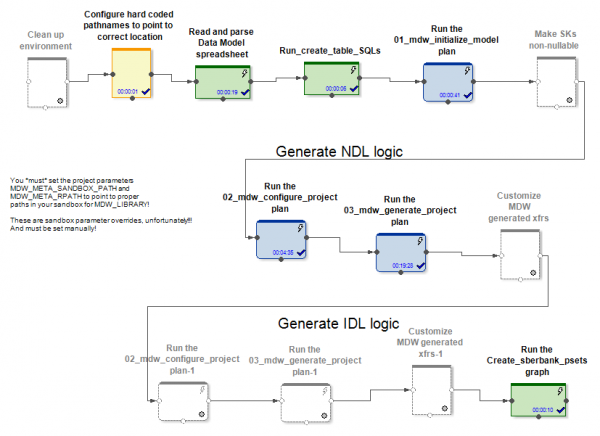
Na vstupe MDW prijíma model dát, konfiguračný súbor na nastavenie pripojenia k databáze (Oracle, Teradata alebo Hive) a niektoré iné nastavenia. Projektovo špecifická časť, napríklad nasadzuje model v databáze. Krabicová časť produktu generuje grafy a konfiguračné súbory k nim pri načítaní dát do tabuľiek modelu. Pri tom sa vytvárajú grafy (a psets) pre niekoľko režimov inicializačnej a inkrementálnej práce na aktualizácii entít.
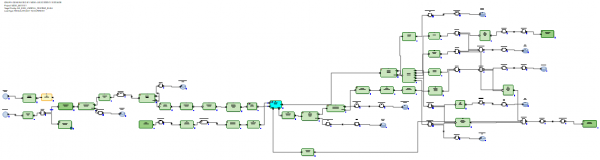
Vo prípadoch Hive a RDBMS sa generujú rôzne grafy pre inicializačnú a inkrementálnu aktualizáciu dát.
V prípade Hive sa prijaté dáta delty kombinujú pomocou Ab Initio Join s dátami, ktoré boli v tabuľke pred aktualizáciou. Načítavače dát v MDW (či už v Hive alebo RDBMS) nielenže vkladajú nové dáta z delty, ale aj uzatvárajú obdobia aktuálnosti dát podľa primárnych kľúčov, z ktorých prišla delta. Okrem toho je potrebné nanovo prepísať nezmenenú časť dát. Ale musíme to robiť, pretože v Hive neexistujú operácie delete alebo update.
V prípade RDBMS grafy pre inkrementálnu aktualizáciu dát vyzerajú omnoho optimálnejšie, pretože RDBMS majú reálne možnosti aktualizácie.
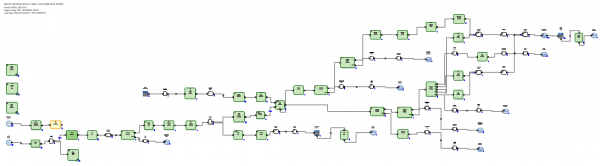
Prijatá delta sa načítava do dočasnej tabuľky v databáze. Potom sa delta spojí s dátami, ktoré boli v tabuľke pred aktualizáciou. A to sa robí za pomoci SQL s použitím vygenerovaného SQL dotazu. Ďalej pomocou SQL príkazov delete+insert prebieha vkladanie nových dát z delty do cieľovej tabuľky a uzatváranie období aktuálnosti dát podľa primárnych kľúčov, z ktorých prišla delta.
Nie je potrebné prepísať nezmenené dáta.
Tak sme dospeli k záveru, že v prípade Hive musí MDW prejsť na prepísanie celej tabuľky, pretože Hive nemá funkciu aktualizácie. A nič lepšieho, než úplné prepísanie dát pri aktualizácii, nebolo vymyslené. V prípade RDBMS, naopak, tvorcovia produktu sa rozhodli zveriť spojenie a aktualizáciu tabuliek využívaniu SQL.
Pre projekt v Sberbanke sme vytvorili novú opakovane použiteľnú implementáciu načítavača databázy pre GreenPlum. To bolo vykonané na základe verzie, ktorú MDW generuje pre Teradata. Práve Teradata, a nie Oracle, bola v tomto prípade najvhodnejšia a najbližšia, pretože je taktiež MPP systémom. Spôsoby práce a syntax Teradata a GreenPlum sa ukázali ako úzko príbuzné.
Príklady kritických rozdielov pre MDW medzi rôznymi RDBMS sú nasledujúce. V GreenPlum, na rozdiel od Teradata, pri vytváraní tabuliek je potrebné písať klauzulu
distributed byV Teradata píšu
vymazať <table> všetko, a v GreenPlum píšu
vymazať z <table>V Oracle s cieľom optimalizácie píšu
delete from t where rowid in (), a v Teradata a GreenPlum píšu
delete from t where exists (select * from delta where delta.pk=t.pk)Ešte by sme chceli poznamenať, že na prácu Ab Initio s GreenPlum bolo potrebné nainštalovať klienta GreenPlum na všetky uzly klastra Ab Initio. Dôvodom je, že sme sa pripojili k GreenPlum súčasne zo všetkých uzlov nášho klastra. A pre to, aby bolo čítanie z GreenPlum paralelné a každý paralelný tok Ab Initio čítal svoju časť údajov z GreenPlum, sme museli do sekcie „where“ SQL dotazov vložiť Ab Initio zrozumiteľnú konštrukciu
where ABLOCAL()a definovať hodnotu tejto konštrukcie, určením parametra pre transformáciu, ktorá číta z DB
ablocal_expr="string_concat(\"mod(t.\", string_filter_out(\"{$TABLE_KEY}\",\"{}\"), \" ,\", (decimal(3))(number_of_partitions()),\")=\", (decimal(3))(this_partition()))", ktorá sa kompiluje na niečo ako
mod(sk,10)=3, t.j. je potrebné dať GreenPlum explicitný filter pre každú partíciu. Pre iné databázy (Teradata, Oracle) môže Ab Initio vykonať toto rozdelenie automaticky.
Porovnávacie charakteristiky výkonu Ab Initio pri práci s Hive a GreenPlum
V Sberbanke bol vykonaný experiment na porovnanie výkonu generovaných MDW grafov v súvislosti s Hive a GreenPlum. V rámci experimentu malo Hive 5 uzlov na tej istej klastri ako Ab Initio, zatiaľ čo GreenPlum malo 4 uzly na samostatnej klastri. T.j. Hive malo určité výhody oproti GreenPlum „na hardvéri“.
Boli zvážené dve páry grafov, ktoré vykonávali rovnakú úlohu aktualizácie údajov v Hive a GreenPlum. Pri tom sa spúšťali grafy generované konfigurátorom MDW:
- inicializačné načítanie + inkrementálne načítanie náhodne generovaných údajov do tabuľky Hive
- inicializačné načítanie + inkrementálne načítanie náhodne generovaných údajov do rovnakej tabuľky GreenPlum
V oboch prípadoch (Hive a GreenPlum) sa spúšťali nahrávky v 10 paralelných prúdoch na rovnakom klastri Ab Initio. Medzi údaje pre výpočty Ab Initio sa uchovávali v HDFS (v termínoch Ab Initio bol použitý MFS layout using HDFS). Jeden riadok náhodne generovaných dát mal v oboch prípadoch 200 bajtov.
Výsledok bol takýto:
Hive:
Inicializačná nahrávka v Hive
Vložené riadky
6 000 000
60 000 000
600 000 000
Trvanie inicializačnej
nahrávky v sekundách
41
203
1 601
Prírastková nahrávka v Hive
Počet riadkov, ktoré boli v
cieľovej tabuľke na začiatku experimentu
6 000 000
60 000 000
600 000 000
Počet riadkov delty, aplikovaných na
cieľovú tabuľku počas experimentu
6 000 000
6 000 000
6 000 000
Trvanie prírastkovej
nahrávky v sekundách
88
299
2 541
GreenPlum:
Inicializačná nahrávka v GreenPlum
Vložené riadky
6 000 000
60 000 000
600 000 000
Trvanie inicializačnej
nahrávky v sekundách
72
360
3 631
Prírastková nahrávka v GreenPlum
Počet riadkov, ktoré boli v
cieľovej tabuľke na začiatku experimentu
6 000 000
60 000 000
600 000 000
Počet riadkov delty, aplikovaných na
cieľovú tabuľku počas experimentu
6 000 000
6 000 000
6 000 000
Trvanie prírastkovej
nahrávky v sekundách
159
199
321
Vidíme, že rýchlosť inicializačnej nahrávky ako v Hive, tak aj v GreenPlum lineárne závisí od objemu dát a z dôvodov lepšieho hardvéru je trochu rýchlejšia pre Hive, než pre GreenPlum.
Prírastková nahrávka v Hive tiež lineárne závisí od objemu už predtým nahraných dát v cieľovej tabuľke a prebieha dosť pomaly s rastom objemu. To je spôsobené potrebou úplne prepísať cieľovú tabuľku. To znamená, že aplikácia malých zmien na obrovských tabuľkách – nie je veľmi dobrý variant použitia pre Hive.
Naopak, prírastková nahrávka v GreenPlum slabšie závisí od objemu predtým nahraných dát v cieľovej tabuľke a prebieha pomerne rýchlo. To bolo dosiahnuté vďaka SQL Joins a architektúre GreenPlum, ktorá umožňuje operácie delete.
Takže GreenPlum nalieva deltu metódou delete+insert, zatiaľ čo v Hive neexistujú operácie delete alebo update, preto bol celý súbor údajov pri prírastkovom aktualizovaní nútený prepísať kompletne. Najvýstižnejšie je porovnať vyznačené tučnými písmenami bunky, keďže zodpovedajú najčastejšiemu variantu používania náročných nahrávok. Vidíme, že GreenPlum vyhral u Hive v tomto teste 8-krát.
Práca Ab Initio s GreenPlum v režime Near Real Time
V tomto experimente overíme možnosť Ab Initio aktualizovať tabuľku GreenPlum náhodne generovanými dávkami dát v režime blízkom reálnemu času. Budeme sa zaoberať tabuľkou GreenPlum dev42_1_db_usl.TESTING_SUBJ_org_finval, s ktorou sa bude pracovať.
Budeme používať tri grafy Ab Initio na prácu s ňou:
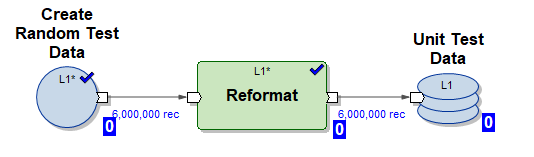
1) Graf Create_test_data.mp – vytvára v 10 paralelných tokoch súbory s údajmi v HDFS s 6 000 000 riadkami. Údaje sú náhodné, štruktúra je organizovaná na vloženie do našej tabuľky.
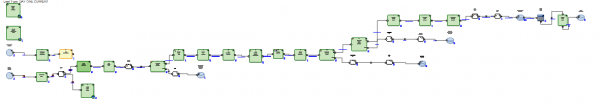
2) Graf mdw_load.day_one.current.dev42_1_db_usl_testing_subj_org_finval.pset – generovaný MDW graf pre iniciačné vloženie údajov do našej tabuľky v 10 paralelných tokoch (používajú sa testovacie údaje, generované grafom (1)).
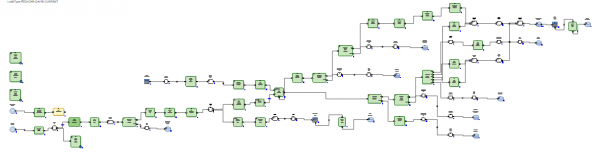
3) Graf mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset – generovaný MDW graf pre inkrementálne aktualizovanie našej tabuľky v 10 paralelných tokoch s použitím časti čerstvo prijatých údajov (delta), generovaných grafom (1).
Vykonáme nižšie uvedený scenár v režime NRT:
- vygenerovať 6 000 000 testovacích riadkov.
- vykonať iniciačné načítanie, vložiť 6 000 000 testovacích riadkov do prázdnej tabuľky.
- opakovať 5-krát inkrementálne načítanie.
- vygenerovať 6 000 000 testovacích riadkov.
- vykonať inkrementálne vloženie 6 000 000 testovacích riadkov do tabuľky (pritom starým údajom sa nastaví čas expirácie valid_to_ts a vložia sa čerstvejšie údaje s tým istým primárnym kľúčom).
Takýto scenár emuluje režim reálnej práce určitej biznis-systémy – v reálnom čase sa objaví dosť veľké množstvo nových údajov a okamžite sa vpraví do GreenPlum.
Teraz sa pozrime na log práce scenára:
Start Create_test_data.input.pset at 2020-06-04 11:49:11
Finish Create_test_data.input.pset at 2020-06-04 11:49:37
Start mdw_load.day_one.current.dev42_1_db_usl_testing_subj_org_finval.pset at 2020-06-04 11:49:37
Finish mdw_load.day_one.current.dev42_1_db_usl_testing_subj_org_finval.pset at 2020-06-04 11:50:42
Start Create_test_data.input.pset at 2020-06-04 11:50:42
Finish Create_test_data.input.pset at 2020-06-04 11:51:06
Start mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset at 2020-06-04 11:51:06
Finish mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset at 2020-06-04 11:53:41
Start Create_test_data.input.pset at 2020-06-04 11:53:41
Finish Create_test_data.input.pset at 2020-06-04 11:54:04
Start mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset at 2020-06-04 11:54:04
Finish mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset at 2020-06-04 11:56:51
Start Create_test_data.input.pset at 2020-06-04 11:56:51
Finish Create_test_data.input.pset at 2020-06-04 11:57:14
Start mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset at 2020-06-04 11:57:14
Finish mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset at 2020-06-04 11:59:55
Start Create_test_data.input.pset at 2020-06-04 11:59:55
Finish Create_test_data.input.pset at 2020-06-04 12:00:23
Start mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset at 2020-06-04 12:00:23
Finish mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset at 2020-06-04 12:03:23
Start Create_test_data.input.pset at 2020-06-04 12:03:23
Finish Create_test_data.input.pset at 2020-06-04 12:03:49
Spustite mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset dňa 2020-06-04 12:03:49
Ukončite mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset dňa 2020-06-04 12:06:46
Vytvára sa takýto obraz:
Graf
Čas začiatku
Čas ukončenia
Dĺžka
Create_test_data.input.pset
04.06.2020 11:49:11
04.06.2020 11:49:37
00:00:26
mdw_load.day_one.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 11:49:37
04.06.2020 11:50:42
00:01:05
Create_test_data.input.pset
04.06.2020 11:50:42
04.06.2020 11:51:06
00:00:24
mdw_load.regular.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 11:51:06
04.06.2020 11:53:41
00:02:35
Create_test_data.input.pset
04.06.2020 11:53:41
04.06.2020 11:54:04
00:00:23
mdw_load.regular.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 11:54:04
04.06.2020 11:56:51
00:02:47
Create_test_data.input.pset
04.06.2020 11:56:51
04.06.2020 11:57:14
00:00:23
mdw_load.regular.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 11:57:14
04.06.2020 11:59:55
00:02:41
Create_test_data.input.pset
04.06.2020 11:59:55
04.06.2020 12:00:23
00:00:28
mdw_load.regular.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 12:00:23
04.06.2020 12:03:23
00:03:00
Create_test_data.input.pset
04.06.2020 12:03:23
04.06.2020 12:03:49
00:00:26
mdw_load.regular.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 12:03:49
04.06.2020 12:06:46
00:02:57
Vidíme, že 6 000 000 záznamov sa spracováva za 3 minúty, čo je dosť rýchlo.
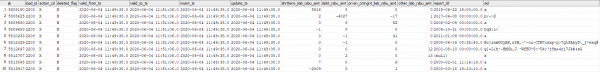
Údaje v cieľovej tabuľke sa rozdelili nasledovne:
select valid_from_ts, valid_to_ts, count(1), min(sk), max(sk) from dev42_1_db_usl.TESTING_SUBJ_org_finval group by valid_from_ts, valid_to_ts order by 1,2; 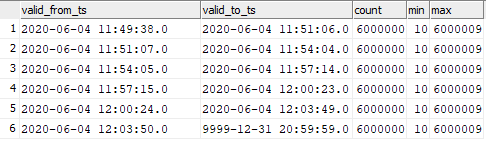
Môžeme vidieť zhodu vložených údajov s časmi spustenia grafov.
Takže je možné spustiť v Ab Initio inkrementálne načítavanie údajov do GreenPlum s veľmi vysokou frekvenciou a sledovať vysokú rýchlosť vkladania týchto údajov do GreenPlum. Samozrejme, nespustí sa každú sekundu, pretože Ab Initio, rovnako ako akýkoľvek ETL nástroj, pri spustení vyžaduje čas na "rozbehnutie".
Záver
V súčasnosti sa Ab Initio používa v Sberbank na vybudovanie Jedného semantického vrstvy údajov (EŠÚ). Tento projekt predpokladá vybudovanie jedinej verzie stavu rôznych bankových obchodných entít. Informácie prichádzajú z rôznych zdrojov, ktorých repliky sú pripravené na Hadoop. Na základe potrieb podnikania je pripravený model údajov a popísané transformácie údajov. Ab Initio načítava informácie do EŠÚ a načítané údaje nielenže predstavujú záujem pre podnikanie samé o sebe, ale aj slúžia ako zdroj na vytvorenie dátových vitrín. Funkcionalita produktu pritom umožňuje používať ako prijímač rôzne systémy (Hive, Greenplum, Teradata, Oracle), čo umožňuje bez väčších námahy pripravovať údaje pre podnikanie v rôznych požadovaných formátoch.
Možnosti Ab Initio sú široké, napríklad integrovaný rámec MDW umožňuje budovať technickú a obchodnú historickosť údajov "z krabice". Pre vývojárov Ab Initio poskytuje možnosť "neobjavovať koleso", ale využívať množstvo existujúcich funkčných komponentov, ktoré sú v podstate knižnicami potrebnými pri práci s údajmi.
Autor — expert profesionálneho spoločenstva Sberbank SberProfi DWH/BigData. Profesionálne spoločenstvo SberProfi DWH/BigData zodpovedá za rozvoj kompetencií v takých oblastiach, ako sú ekosystém Hadoop, Teradata, Oracle DB, GreenPlum, ako aj v BI nástrojoch Qlik, SAP BO, Tableau a ďalších.
Zdroj: habr.com
