

Čoraz častejšie dostávame od klientov požiadavky ako: „Chceme niečo ako Amazon RDS, ale lacnejšie“; „Chceme niečo ako RDS, ale úplne vo všetkých infraštruktúrach“. Aby sme realizovali podobné managed riešenie na Kubernetes, pozreli sme sa na aktuálny stav najpopulárnejších operátorov pre PostgreSQL (Stolon, operátori od Crunchy Data a Zalando) a urobili sme svoj výber.
Tento článok je náš preobtížený skúsenosť a to z teoretického pohľadu (prehľad riešení) aj z praktickej stránky (čo bolo vybrané a čo z toho vzniklo). Ale najprv si definujme, aké požiadavky sú kladené na potenciálnu náhradu RDS...
Čo vlastne je RDS
Keď ľudia hovoria o RDS, podľa našich skúseností, majú na mysli spravovaný (managed) službu DB, ktorá:
- je ľahko nastaviteľná;
- má možnosť práce so snapshotmi a obnoviť sa z nich (ideálne — s podporou );
- umožňuje vytvárať topológie master-slave;
- má bohatý zoznam rozšírení;
- poskytuje audit a správu používateľov/prístupov.
Čo sa týka implementácie stanoveného úloha, prístupy môžu byť veľmi rôzne, avšak cesta s podmienečným Ansible nám nie je blízka. (K podobnému záveru dospeli aj kolegovia z 2GIS na základe vytvoriť „nástroj na rýchle nasadenie vysokodostupného klastera na základe Postgres“.)
Práve operátori — sú bežným prístupom na riešenie takýchto úloh v ekosystéme Kubernetes. O nich podrobnejšie v súvislosti s databázami bežiacimi v Kubernetes už hovoril technický riaditeľ „Flanta“, , v .
Poznámka: Na rýchle vytváranie jednoduchých operátorov odporúčame venovať pozornosť našej Open Source utilite . Použitím jej je možné to robiť bez znalosti Go, a bežnejšími spôsobmi pre systémových administrátorov: na Bash, Python a pod.
Pre PostgreSQL existuje niekoľko populárnych K8s operátorov:
- Stolon;
- Crunchy Data PostgreSQL Operator;
- Zalando Postgres Operator.
Pozrime sa na ne podrobnejšie.
Výber operátora
Okrem tých dôležitých možností, ktoré už boli uvedené vyššie, sme — ako inžinieri infraštruktúry v Kubernetes — očakávali od operátorov aj nasledujúce:
- deploy z Git a s ;
- podporu pod anti-affinity;
- inštaláciu node affinity alebo node selector;
- inštaláciu tolerations;
- existencia možností ladírenia;
- jasné technológie a dokonca aj príkazy.
Bez podrobností o každom z bodoch (pýtajte sa v komentároch, ak po prečítaní celého článku zostanú otázky), chcem v celku zdôrazniť, že tieto parametre sú potrebné na presnejšie opísanie špecializácie uzlov klastra, aby sme ich mohli objednávať na konkrétne aplikácie. Tak môžeme dosiahnuť optimálnu rovnováhu medzi výkonom a nákladmi.
Teraz - k samotným operátorom PostgreSQL.
1. Stolon
od talianskej spoločnosti Sorint.lab v bol považovaný za určitý etalón medzi operátormi pre DBMS. Je to pomerne starý projekt: jeho prvé verejné vydanie sa uskutočnilo už v novembri 2015 (!) a GitHub repozitár sa môže pochváliť takmer 3000 hviezdami a 40+ prispievateľmi.
A naozaj, Stolon je skvelým príkladom premyslenej architektúry:
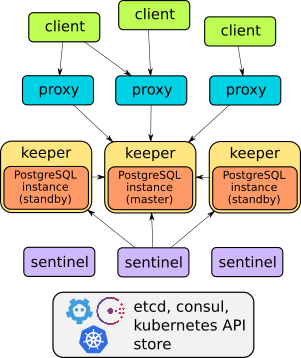
S dizajnom tohto operátora sa môžete podrobnejšie oboznámiť v správe alebo . Celkovo však stačí povedať, že zvládne všetko, čo je popísané: failover, proxy na transparentný prístup pre klientov, zálohy… A proxy poskytujú prístup cez jeden servisný endpoint - na rozdiel od dvoch ďalších riešení, ktoré budú ďalej preskúmané (majú po dva servisy na prístup k databáze).
Avšak Stolon , preto ho nemožno nasadiť tak, aby bolo jednoduché a rýchle - „ako horúce koláče“ - vytvárať inštancie DBMS v Kubernetes. Správa sa vykonáva prostredníctvom nástroja stolonctl, nasadenie - prostredníctvom Helm chartu, a používateľské definície sa určujú v ConfigMap.
Na jednej strane to vyzerá, že operátor nie je úplne operátorom (veď nepoužíva CRD). Ale na druhej strane - je to flexibilný systém, ktorý umožňuje nastaviť zdroje v K8s tak, ako vám to vyhovuje.
Zhrnutím, pre nás sa nepodarilo nájsť optimálnu cestu, ako zaviesť samostatný chart pre každú DB. Preto sme začali hľadať alternatívy.
2. Crunchy Data PostgreSQL Operator
, mladého amerického startupu, sa javí ako logická alternatíva. Jeho verejná história sa začína prvým vydaním v marci 2017, odvtedy GitHub repozitár získal necelých 1300 hviezd a 50+ prispievateľov. Posledné vydanie z septembra bolo testované na prácu s Kubernetes 1.15—1.18, OpenShift 3.11+ a 4.4+, GKE a VMware Enterprise PKS 1.3+.
Architektúra Crunchy Data PostgreSQL Operator tiež spĺňa deklarované požiadavky:
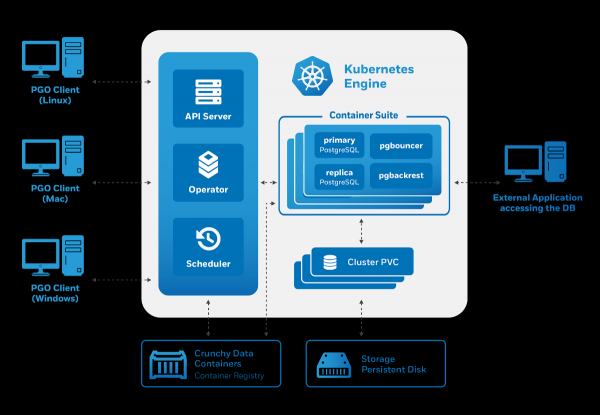
Správa prebieha prostredníctvom nástroja pgo, avšak na druhej strane generuje Custom Resources pre Kubernetes. Preto nás ako potenciálnych používateľov operátor potešil:
- existuje správa cez CRD;
- pohodlná správa používateľov (tiež cez CRD);
- integrácia s inými komponentmi — špecializovaná kolekcia obrazov kontajnerov pre PostgreSQL a utilít pre jeho obsluhu (vrátane pgBackRest, pgAudit, rozšírenia z contrib atď.).
Avšak pokusy o začatie používania operátora od Crunchy Data odhalili niekoľko problémov:
- Nebola možnosť nastaviť tolerancie — predpokladaný bol iba nodeSelector.
- Vytvorené pod 'y boli súčasťou Deploymentu, aj keď sme nasadzovali stateful aplikáciu. Na rozdiel od StatefulSet, Deploymenty nevedia vytvárať disky.
Posledná nevýhoda vedie k zábavným momentom: na testovacej špeciálne sa nám podarilo spustiť 3 repliky s jedným diskem local storage, v dôsledku čoho operátor oznámil, že 3 repliky fungujú (aj keď to tak nebolo).
Ďalšou vlastnosťou tohto operátora je jeho hotová integrácia s rôznymi pomocnými systémami. Napríklad, je ľahké nainštalovať pgAdmin a pgBounce, a v taktiež sú zvažované prednastavené Grafana a Prometheus. V nedávnom sa osobitne spomína vylepšená integrácia s projektom , vďaka čomu operátor ponúka prehľadnú vizualizáciu metrík pre PgSQL „z out-of-the-box“.
Napriek tomu zvláštny výber generovaných Kubernetes zdrojov viedol k potrebe nájsť iné riešenie.
3. Zalando Postgres Operator
Produkty Zalando poznáme už dlhšie: máme skúsenosti s používaním Zalenium a samozrejme sme sa pokúsili — ich populárne HA riešenie pre PostgreSQL. O prístupe spoločnosti k vytvoreniu rozprával jeden z jeho autorov — Alexej Klyukin — v živom prenose , a nám sa páčil.
Toto je najmladšie riešenie z tých, ktoré sa skúmajú v článku: prvé vydanie sa uskutočnilo v auguste 2018. Napriek tomu, že má len niekoľko formálnych vydaní, projekt prešiel dlhú cestu a už prekonal populárnosť riešenia od Crunchy Data s viac ako 1300 hviezdami na GitHub a maximálnym počtom prispievateľov (70+).
„Pod kapotou“ tohto operátora sa používajú osvedčené riešenia:
- Patroni a na správu,
- — na zálohovanie,
- — ako pool pripojení.
Tu je zobrazená architektúra operátora od Zalando:
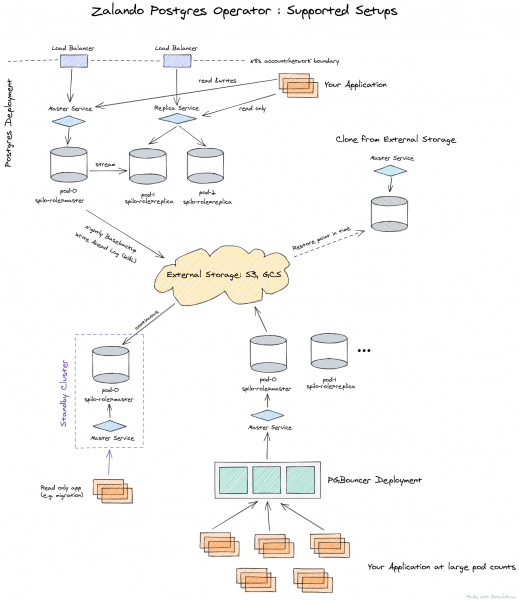
Operátor je plne spravovaný cez Custom Resources, automaticky vytvára StatefulSet z kontajnerov, ktoré potom môžu byť prispôsobené pridaním rôznych sidecar-ov do podu. To všetko je významná výhoda v porovnaní s operátorom od Crunchy Data.
Keďže sme si vybrali riešenie od Zalando spomedzi 3 zvažovaných možností, nižšie bude uvedený popis jeho možností spolu s praxou jeho využitia.
Praxe s Postgres Operator od Zalando
Nasadenie operátora prebieha veľmi jednoducho: stačí stiahnuť aktuálnu verziu z GitHubu a aplikovať YAML súbory z adresára . Ako alternatívu je možné tiež využiť .
Po inštalácii je potrebné postarať sa o nastavenie . To sa vykonáva prostredníctvom ConfigMap postgres-operator v názvovom priestore, do ktorého ste nainštalovali operátor. Keď sú úložiská nastavené, môžete nasadiť prvý klaster PostgreSQL.
Napríklad, štandardné nasadenie vyzerá nasledovne:
apiVersion: acid.zalan.do/v1
kind: postgresql
metadata:
 name: staging-db
spec:
 numberOfInstances: 3
 patroni:
   synchronous_mode: true
 postgresql:
   version: "12"
 resources:
   limits:
     cpu: 100m
     memory: 1Gi
   requests:
     cpu: 100m
     memory: 1Gi
 sidecars:
 - env:
   - name: DATA_SOURCE_URI
     value: 127.0.0.1:5432
   - name: DATA_SOURCE_PASS
     valueFrom:
       secretKeyRef:
         key: password
         name: postgres.staging-db.credentials
   - name: DATA_SOURCE_USER
     value: postgres
   image: wrouesnel/postgres_exporter
   name: prometheus-exporter
   resources:
     limits:
       cpu: 500m
       memory: 100Mi
     requests:
       cpu: 100m
       memory: 100Mi
 teamId: staging
 volume:
   size: 2Gi
Tento manifest nasadzuje klaster z 3 inštancií so sidecar-om vo forme , z ktorého snímame metriky aplikácie. Ako vidíte, všetko je veľmi jednoduché, a ak si prajete, môžete vytvoriť prakticky neobmedzené množstvo klastrov.
Je potrebné venovať pozornosť aj webovému panelu pre administráciu — . Ten je dodávaný spolu s operátorom a umožňuje vytvárať a mazať klastre, ako aj pracovať so zálohami, ktoré operátor vytvára.
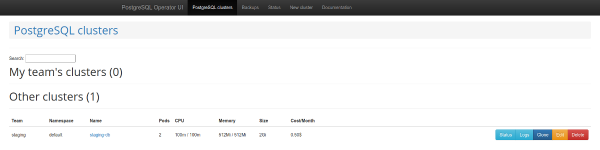
Zoznam klastrov PostgreSQL
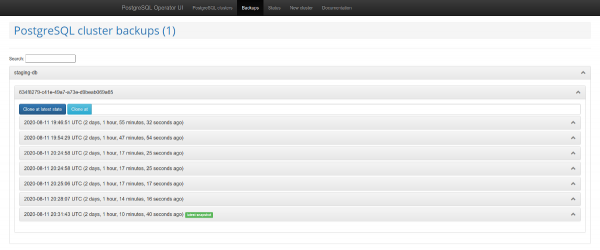
Správa záloh
Ďalšou zaujímavou funkciou je podpora . Tento mechanizmus automaticky vytvára role v PostgreSQL, vychádzajúc z prijatého zoznamu používateľských mien. Potom API umožňuje vrátiť zoznam používateľov, pre ktorých sa automaticky vytvárajú role.
Problémy a ich riešenie
Avšak používanie operátora čoskoro odhalilo niekoľko vážnych nedostatkov:
- absencia podpory nodeSelector;
- neschopnosť vypnúť zálohovanie;
- pri používaní funkcie vytvárania databáz sa neobjavujú predvolené oprávnenia;
- príležitostne chýba dokumentácia alebo je zastaraná.
Našťastie, mnohé z týchto problémov sa dajú vyriešiť. Začnime na konci — problém s dokumentáciou.
pravdepodobne narazíte na to, že nie je vždy jasné, ako nastaviť zálohu a ako pripojiť zálohový kôš k rozhraniu Operator UI. O tom sa v dokumentácii hovorí letmo, ale reálny popis nájdete v :
- je potrebné vytvoriť tajný kľúč;
- predať ho operátorovi ako parameter
pod_environment_secret_namev CRD s nastaveniami operátora alebo v ConfigMap (závisí od toho, ako ste sa rozhodli nainštalovať operátora).
Avšak, ako sa ukázalo, v súčasnosti to nie je možné. Práve preto sme zhromaždili s niektorými dodatočnými tretími stranami. Viac o nej — pozri nižšie.
Ak predávate operátorovi parametre pre zálohu, konkrétne — wal_s3_bucket a prístupové kľúče do AWS S3, potom on bude zálohovať všetko: nielen databázy vo výrobe, ale aj na stagingu. To nám nevyhovovalo.
V popise parametrov pre Spilo, čo je základný Docker obal pre PgSQL pri používaní operátora, sa ukázalo: je možné predložiť parameter WAL_S3_BUCKET prázdny, čím sa zálohy vypnú. Navyše, k našej veľkej radosti sa našiel aj , ktorý sme hneď prijali do nášho forku. Teraz stačí jednoducho pridať enableWALArchiving: false do zdroja klastru PostgreSQL.
Áno, bola možnosť to urobiť inak, spustením 2 operátorov: jedného pre staging (bez záloh), a druhého — pre výrobu. Ale takto sme sa dokázali zaobísť jedným.
Dobre, naučili sme sa predávať prístup do databáz pre S3 a zálohy sa začali dostávať do úložiska. Ako prinútiť stránky záloh fungovať v rozhraní Operator UI?
V rozhraní Operator UI bude potrebné pridať 3 premenné:
-
SPILO_S3_BACKUP_BUCKET -
AWS_ACCESS_KEY_ID -
AWS_SECRET_ACCESS_KEY
Po tomto sa správa o zálohách stane dostupnou, čo v našom prípade zjednoduší prácu so stagingom, umožní posielať tam vzorky z výrobného prostredia bez ďalších skriptov.
Ako ďalšia výhoda sa spomínala práca s Teams API a široké možnosti na vytváranie databáz a rolí pomocou operátora. Avšak vytvorené role nemali predvolené oprávnenia.Tým pádom, používateľ s oprávnením na čítanie nemohol čítať nové tabuľky.
Prečo je to tak? Napriek tomu, že v kóde sú potrebné GRANT, nie sú vždy aplikované. Existujú 2 metódy: syncPreparedDatabases a syncDatabases. V syncPreparedDatabases — aj keď v sekcii preparedDatabases existuje podmienka defaultRoles a defaultUsers na vytvorenie rolí, — predvolené práva sa neuplatňujú. Pracujeme na príprave záplaty, aby sa tieto práva automaticky aplikovali.
A posledná vec v aktuálnych vylepšeniach — , pridávajúca Node Affinity do vytváraného StatefulSet. Naši klienti často preferujú znížiť náklady použitím spot-inštancií, a tie by rozhodne nemali hostiť databázové služby. Túto otázku by bolo možné vyriešiť aj prostredníctvom tolerancie, ale prítomnosť Node Affinity poskytuje väčšiu istotu.
Čo sa podarilo?
Na základe riešenia uvedených problémov sme forkovali Postgres Operator od Zalando do , kde sa zostavuje s takými užitočnými záplatami. A pre väčšie pohodlie sme zostavili aj .
Zoznam PR prijatých do fork:
- ;
- ;
- ;
- .
Bude skvelé, ak komunita podporí tieto PR, aby sa dostali do upstreamu v nasledujúcej verzii operátora (1.6).
Bonus! Príbeh úspechu s migráciou produkcie
Ak používate Patroni, môžete migrovať živú produkciu na operátora s minimálnym výpadkom.
Spilo umožňuje vytvárať standby-klastre cez S3 úložiská s , keď sa binárny log PgSQL najprv ukladá do S3 a potom sa načítava replikou. Ale čo robiť, ak nie používate Wal-E v starej infraštruktúre? Riešenie tohto problému už na Habr.
Na pomoc prichádza logická replikácia PostgreSQL. Avšak nebudeme sa zaoberať detailmi, ako vytvárať publikácie a predplatné, pretože… náš plán zlyhal.
Ide o to, že v DB bolo niekoľko vysoko záťažených tabuliek s miliónmi riadkov, ktoré sa navyše neustále dopĺňali a vymazávali. s copy_data, keď nová replikácia kopíruje všetok obsah z majstra, jednoducho nestíhala za majstrom. Kopírovanie obsahu fungovalo týždeň, ale nakoniec nedostihlo majstra. Nakoniec, s problémom pomohla kolegyňa z Avito: je možné preniesť údaje pomocou pg_dump. Opíšem našu (malo upravenú) verziu tohto algoritmu.
Ideou je, že je možné vytvoriť vypnuté predplatné, priradené ku konkrétnemu replikácii slotu, a potom opraviť číslo transakcie. K dispozícii boli repliky na prácu s produkciou. To je dôležité, pretože replika pomôže vytvoriť konzistentnú dump a pokračovať v získavaní zmien z mastera.
V nasledujúcich príkazoch, ktoré popisujú proces migrácie, budú použité nasledujúce označenia pre hostiteľov:
- master — zdrojový server;
- replica1 — streamová replika na starom produkte;
- replica2 — nová logická replika.
Plán migrácie
1. Vytvoríme na masteri predplatné pre všetky tabuľky v schéme public databázy dbname:
psql -h master -d dbname -c "CREATE PUBLICATION dbname FOR ALL TABLES;"
2. Vytvoríme slot replikácie na masteri:
psql -h master -c "select pg_create_logical_replication_slot('repl', 'pgoutput');"
3. Zastavíme replikáciu na starej replice:
psql -h replica1 -c "select pg_wal_replay_pause();"
4. Získame číslo transakcie z mastera:
psql -h master -c "select replay_lsn from pg_stat_replication where client_addr = 'replica1';"
5. Urobíme dump zo starej repliky. Budeme to robiť v niekoľkých vláknach, čo pomôže urýchliť proces:
pg_dump -h replica1 --no-publications --no-subscriptions -O -C -F d -j 8 -f dump/ dbname
6. Načítať dump na nový server:
pg_restore -h replica2 -F d -j 8 -d dbname dump/
7. Po načítaní dumpu môžeme spustiť replikáciu na streamovej replice:
psql -h replica1 -c "select pg_wal_replay_resume();"
7. Vytvoríme predplatné na novej logickej replike:
psql -h replica2 -c "create subscription oldprod connection 'host=replica1 port=5432 user=postgres password=secret dbname=dbname' publication dbname with (enabled = false, create_slot = false, copy_data = false, slot_name='repl');"
8. Získame oid predplatné:
psql -h replica2 -d dbname -c "select oid, * from pg_subscription;"
9. Predpokladajme, že bol získaný oid=1000. Aplikujeme číslo transakcie na predplatné:
psql -h replica2 -d dbname -c "select pg_replication_origin_advance('pg_1000', 'AA/AAAAAAAA');"
10. Spustíme replikáciu:
psql -h replica2 -d dbname -c "alter subscription oldprod enable;"
11. Skontrolujeme stav predplatného, replikácia by mala fungovať:
psql -h replica2 -d dbname -c "select * from pg_replication_origin_status;"
psql -h master -d dbname -c "select slot_name, restart_lsn, confirmed_flush_lsn from pg_replication_slots;"
12. Po spustení replikácie a synchronizácii databáz môžeme vykonať prepnúť.
13. Po vypnutí replikácie je potrebné opraviť sekvencie. Toto je dobre opísané .
Vďaka takémuto plánu prešlo prepnúť s minimálnymi oneskoreniami.
Záver
Kubernetes operátory umožňujú zjednodušiť rôzne činnosti zúžením na vytváranie K8s zdrojov. Avšak, aj keď dosiahnete skvelú automatizáciu, mali by ste mať na pamäti, že môže priniesť aj niektoré neočakávané nuansy, preto k výberu operátorov pristupujte s rozvahou.
Po preskúmaní troch najpopulárnejších Kubernetes operátorov pre PostgreSQL sme sa rozhodli pre projekt od Zalando. Museli sme prekonávať určité ťažkosti, ale výsledok nás naozaj potešil, takže plánujeme rozšíriť tento zážitok aj na niektoré iné inštalácie PgSQL. Ak máte skúsenosti s podobnými riešeniami, radi uvidíme podrobnosti v komentároch!
P.S.
Prečítajte si tiež na našom blogu:
- «»;
- «»;
- «».
Zdroj: habr.com
