

Typické podmienky pri realizácii CI/CD v Kubernetes: aplikácia by mala byť schopná pred úplným zastavením neprijímať nové požiadavky od klientov, a čo je najdôležitejšie, úspešne ukončiť už existujúce.
Dodržiavanie tejto podmienky umožňuje dosiahnuť nulovú prestávku počas nasadenia. Avšak aj pri použití veľmi populárnych kombinácií (ako NGINX a PHP-FPM) sa môžeme stretnúť s problémami, ktoré spôsobia nárast chýb pri každom nasadení...
Teória. Ako žije pod
Podrobne sme už publikovali o životnom cykle pod'a . V kontexte aktuálnej témy nás zaujíma nasledovné: v momente, keď pod prechádza do stavu Terminating, prestávajú na neho byť zasielané nové požiadavky (pod je zo zoznamu endpoints pre službu). Takže aby sme sa vyhli prestávke počas nasadenia, naše strana musí vyriešiť problém s korektným zastavením aplikácie.
Treba tiež pamätať, že grace period je predvolene : po tomto období bude pod terminovaný a aplikácia by mala stihnúť spracovať všetky požiadavky do tohto časového limitu. Poznámka: aj keď akákoľvek požiadavka, ktorá sa vykonáva dlhšie ako 5-10 sekúnd, už predstavuje problém, a graceful shutdown jej už nepomôže...
Aby sme lepšie pochopili, čo sa deje, keď pod ukončuje svoju činnosť, stačí preskúmať nasledujúcu schému:
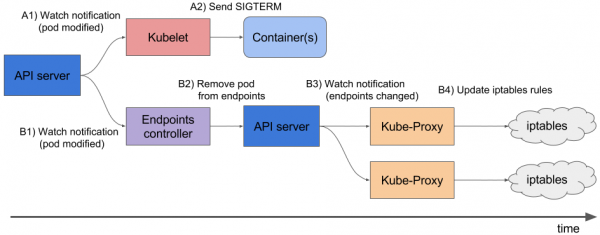
A1, B1 — Získanie zmien o stave pod'a
A2 — Odoslanie SIGTERM
B2 — Odstránenie pod'a z endpoints
B3 — Získanie zmien (zoznam endpoints sa zmenil)
B4 — Aktualizácia pravidiel iptables
Všimnite si: odstránenie endpointu pod'a a poslanie SIGTERM prebieha nie sekvenčne, ale paralelne. A kvôli tomu, že Ingress nezíska aktualizovaný zoznam Endpoints okamžite, na pod budú zasielané nové požiadavky od klientov, čo spôsobí 500 chyby počas terminácie pod'a. (podrobnejšie materiály k tejto otázke sme ). Riešiť tento problém treba nasledujúcimi spôsobmi:
- Posielať v hlavičkách odpovede Connection: close (ak ide o HTTP aplikáciu).
- Ak nie je možnosť upraviť kód, tak ďalej v článku je opísané riešenie, ktoré umožní spracovať požiadavky do konca grace periodu.
Teória. Ako NGINX a PHP-FPM ukončujú svoje procesy
NGINX
Začneme s NGINX, pretože s ním je všetko viac-menej jasné. Hlbším štúdiom teórie sa dozvieme, že NGINX má jeden master proces a niekoľko „workerov“ — ide o podriadené procesy, ktoré spracovávajú klientské požiadavky. Je tu užitočná funkcia: pomocou príkazu nginx -s môžeme ukončiť procesy buď v režime rýchlej rekonfigurácie, alebo v graceful shutdown. Je jasné, že nás zaujíma práve posledný variant.
Ďalej je všetko jednoduché: je potrebné pridať do príkaz, ktorý pošle signál o graceful shutdown. To sa dá urobiť v Deployment, v bloku kontajnera:
       lifecycle:
          preStop:
            exec:
              command:
              - /usr/sbin/nginx
              - -s
              - quit
Teraz pri ukončení práce podu v logoch kontajnera NGINX uvidíme nasledovné:
2018/01/25 13:58:31 [notice] 1#1: signal 3 (SIGQUIT) received, shutting down
2018/01/25 13:58:31 [notice] 11#11: gracefully shutting down
A to bude znamenať to, čo potrebujeme: NGINX čaká na dokončenie spracovania požiadaviek, po ktorých zhodiť proces. Mimochodom, nižšie sa bude zaoberať bežným problémom, kvôli ktorému aj pri príkaze nginx -s quit proces končí nesprávne.
A na tomto mieste sme skončili s NGINX: minimálne z logov môžeme pochopiť, že všetko funguje tak, ako má.
Ako sú na tom PHP-FPM? Ako spracováva graceful shutdown? Poďme na to prísť.
PHP-FPM
V prípade PHP-FPM je informácií o niečo menej. Ak sa zameriame na k PHP-FPM, dozvieme sa, že akceptuje nasledujúce POSIX signály:
-
SIGINT,SIGTERM— rýchla rekonfigurácia; -
SIGQUIT— graceful shutdown (to, čo potrebujeme).
Ostatné signály v tejto úlohe nie sú potrebné, preto ich analýzu vynecháme. Pre správne ukončenie procesu je potrebné napísať nasledujúci preStop hook:
        lifecycle:
          preStop:
            exec:
              command:
              - /bin/kill
              - -SIGQUIT
              - "1"
Na prvý pohľad je to všetko, čo je potrebné na vykonanie graceful shutdown v oboch kontajneroch. Napriek tomu je úloha zložitejšia, než sa zdá. Následne sú rozobrané dva prípady, v ktorých graceful shutdown nefungoval a spôsobil krátkodobú nedostupnosť projektu počas nasadenia.
Praxis. Možné problémy s graceful shutdown
NGINX
Najprv je užitočné pamätať si: okrem vykonávania príkazu nginx -s quit Je ešte jedna fáza, na ktorú by ste mali venovať pozornosť. Stretli sme sa s problémom, keď NGINX namiesto signálu SIGQUIT poslal SIGTERM, čo spôsobilo, že požiadavky sa nevykonali správne. Podobné prípady môžeme nájsť, napríklad, . Žiaľ, konkrétnu príčinu takéhoto správania sa nám nepodarilo zistiť: mali sme podozrenie na verziu NGINX, ale to sa nepotvrdilo. Symptómy spočívali v tom, že v logoch NGINX kontajnera sa objavili správy „open socket #10 left in connection 5“, po čom sa pod zastavil.
Túto problematiku môžeme pozorovať, napríklad, podľa odpovedí na požadovanom Ingress’e:
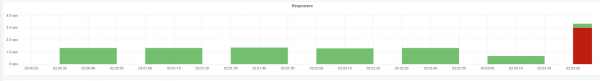
Ukazovatele stavových kódov v čase nasadenia
V tomto prípade dostávame presne 503 kód chyby od samotného Ingressu: nemôže sa obrátiť na kontajner NGINX, pretože ten už nie je dostupný. Ak sa pozrieme do logov kontajnera s NGINX, objavíme nasledovné:
[alert] 13939#0: *154 open socket #3 left in connection 16
[alert] 13939#0: *168 open socket #6 left in connection 13
Po zmene stop signálu sa kontajner začína zastavovať správne: to je potvrdené tým, že sa už nevyskytuje 503 chyba.
Ak ste sa stretli s podobným problémom, má zmysel zistiť, aký stop signál sa používa v kontajneri a ako presne vyzerá preStop-hák. Je možné, že príčina spočíva práve v tom.
PHP-FPM… a nielen
Problém s PHP-FPM je opísaný triviálne: nečaká na dokončenie potomkovských procesov, terminujú ich, čo spôsobuje 502 chyby počas nasadenia a ďalších operácií. Na bugs.php.net sú od roku 2005 niektoré hlásenia o chybách (napríklad, a ), ktoré popisujú tento problém. A v logoch pravdepodobne nič neuvidíte: PHP-FPM vyhlási o ukončení svojho procesu bez akýchkoľvek chýb alebo oznámení.
Je potrebné uviesť, že samotný problém môže v menšej alebo väčšej miere závisieť od samotnej aplikácie a nemusí sa vykazovať, napríklad, v monitorovaní. Ak sa však s ním stretnete, ako prvé vás napadne jednoduché riešenie: pridať preStop-hák so sleep(30). To umožní dokončiť všetky predchádzajúce požiadavky (nové už neprijímame, pretože pod musí byť zásobník. Ale „my praktikanti: u nás všetko funguje, ale nikto nevie prečo…“ je v stave Terminating), a po uplynutí 30 sekúnd sa pod sám ukončí signálom SIGTERM.
Z toho vyplýva, že lifecycle pre kontajner bude vyzerať nasledovne:
    lifecycle:
      preStop:
        exec:
          command:
          - /bin/sleep
          - "30"
Avšak, z dôvodu nastavenia 30-sekundového sleep sme silne predĺžime čas nasadenia, pretože každý pod bude ukončený minimum 30 sekúnd, čo nie je dobré. Čo s tým môžeme urobiť?
Obrátime sa na stranu, ktorá zodpovedá za bezprostredné vykonávanie aplikácie. V našom prípade je to PHP-FPM, ktorý podľa predvoleného nastavenia nesleduje vykonávanie svojich child procesov: hlavný proces sa ukončí okamžite. Toto správanie môžeme zmeniť pomocou direktívy process_control_timeout, ktorá určuje časové obmedzenia na čakanie na signály od hlavného procesom child procesmi. Ak nastavíme hodnotu na 20 sekúnd, pokryje väčšinu požiadaviek spracovávaných v kontajneri, a po ich dokončení bude hlavný proces zastavený.
S touto znalosťou sa vrátime k nášmu poslednému problému. Ako už bolo spomenuté, Kubernetes nie je monolitná platforma: interakcia medzi rôznymi jeho komponentami si vyžaduje určitý čas. To je obzvlášť relevantné, keď zvažujeme fungovanie Ingressov a ďalších súvisiacich komponentov, pretože kvôli takému oneskoreniu je v okamihu nasadenia ľahké získať nárast 500 chýb. Napríklad chyba môže nastať v štádiu odosielania požiadavky smerom k upstreamu, ale samotné „oneskorenie“ interakcie medzi komponentami je celkom krátke — menej ako sekundu.
Preto, v súhrne s už spomenutou direktívou process_control_timeout môžeme použiť nasledujúcu konštrukciu pre lifecycle:
lifecycle:
  preStop:
    exec:
      command: ["/bin/bash","-c","/bin/sleep 1; kill -QUIT 1"]
V takom prípade kompenzujeme oneskorenie príkazom sleep a veľmi nezvyšujeme čas nasadenia: veď rozdiel medzi 30 sekundami a jednou je dosť viditeľný?... V podstate „hlavnú prácu“ na seba berie práve process_control_timeout, a lifecycle používa sa len ako „záloha“ pre prípad oneskorenia.
Vo všeobecnosti, popísané správanie a zodpovedajúci workaround sa netýkajú len PHP-FPM. Podobná situácia môže tak či onak vzniknúť pri používaní iných programovacích jazykov/frameworkov. Ak sa iné spôsoby opravy graceful shutdown neosvedčia — napríklad prepisovaním kódu tak, aby aplikácia správne spracúvala signály ukončenia — môžeme použiť popísaný spôsob. Nech je to akokoľvek neestetické, funguje to.
Praxe. Záťažové testovanie na overenie fungovania podu
Záťažové testovanie je jedným zo spôsobov, ako overiť, ako funguje kontajner, keďže táto procedúra približuje realite, keď na stránku vstupujú používatelia. Pre testovanie uvedených odporúčaní môžete využiť : pokrýva všetky naše potreby. Tu sú rady a odporúčania na vykonávanie testovania s názorným príkladom z našich skúseností — vďaka grafom Grafana a samotnému Yandex.Tanku.
Najdôležitejšie je, kontrolovať zmeny po etapách. Po pridaní nového opravy spustite testovanie a sledujte, či sa výsledky zmenili v porovnaní s predchádzajúcim spustením. V opačnom prípade bude ťažké odhaliť neefektívne riešenia a dlhodobo sa môže stať, že to dokonca uškodí (napríklad predĺži čas nasadenia).
Ďalším detailom je sledovať protokoly kontajnera počas jeho ukončenia. Zaznamenáva sa tam informácia o čistom ukončení? Sú v protokoloch chyby pri prístupe k iným zdrojom (napríklad k vedľajšiemu kontajneru PHP-FPM)? Chyby samotnej aplikácie (ako v opísanom prípade s NGINX)? Dúfam, že úvodné informácie z tohto článku pomôžu lepšie pochopiť, čo sa deje s kontajnerom počas jeho ukončenia.
Takže prvé spustenie testovania prebehlo bez lifecycle a bez dodatočných direktív pre server aplikácií (process_control_timeout v PHP-FPM). Cieľom tohto testu bolo odhaliť približný počet chýb (a či vôbec existujú). Z dodatočných informácií je potrebné vedieť, že priemerný čas nasadenia každého podu bol približne 5-10 sekúnd do stavu plnej pripravenosti. Výsledky sú tieto:
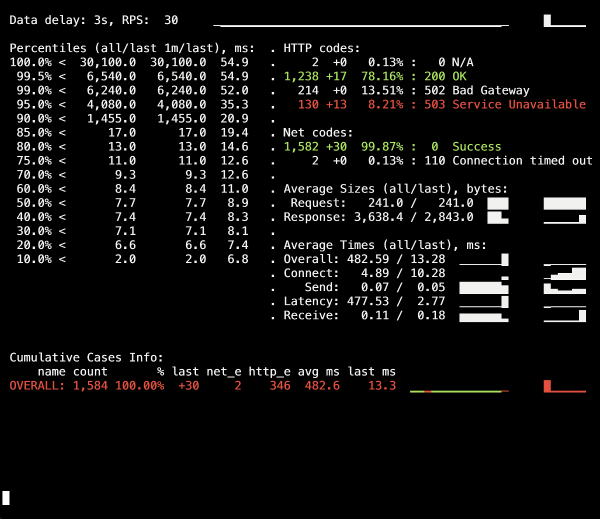
Na informačnej nástenke Yandex.Tanku je viditeľný nárast 502 chýb, ktorý sa objavil v čase nasadenia a trval priemerne 5 sekúnd. Predpokladá sa, že sa prerušené existujúce požiadavky na starý pod, keď bol ukončený. Po tomto sa objavili 503 chyby, čo bolo výsledkom zastaveného kontajnera NGINX, ktorý taktiež prerušil pripojenia z dôvodu backendu (prečo sa nemohol pripojiť Ingress).
Pozrime sa, ako process_control_timeout v PHP-FPM nám pomôže čakať na dokončenie child-procesov, t.j. opraviť takéto chyby. Opakované nasadenie už s použitím tejto direktívy:
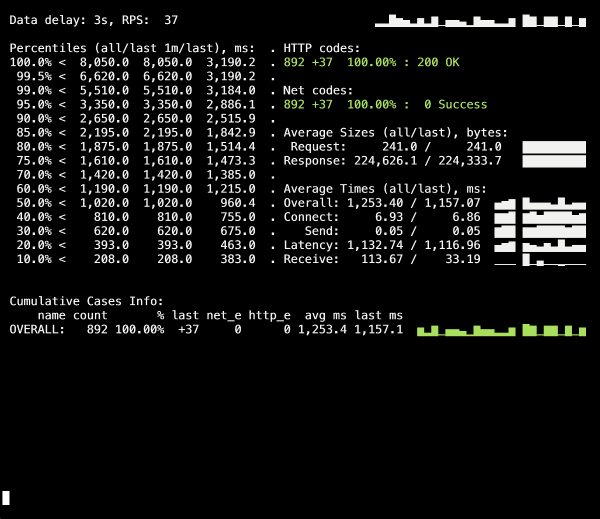
Počas nasadzovania už nie sú 500-ky! Nasadenie prebieha úspešne, graceful shutdown funguje.
Je však potrebné si pripomenúť chvíľu s Ingress-kontajnermi, malý percento chýb, ktoré môžeme dostávať kvôli dočasnému zdržaniu. Aby sme sa im vyhli, stačí pridať konštrukciu so sleep a zopakovať nasadenie. Napriek tomu v našom konkrétnom prípade neboli žiadne viditeľné zmeny (chyby sú opäť preč).
Záver
Na správne ukončenie procesu očakávame od aplikácie nasledujúce správanie:
- Čakať niekoľko sekúnd, po čom prestane prijímať nové pripojenia.
- Počkať na dokončenie všetkých požiadaviek a uzavrieť všetky keepalive-připojenia, ktoré požiadavky nevykonávajú.
- Ukončiť svoj proces.
Nie všetky aplikácie však dokážu takto fungovať. Jedným z riešení problému v realitách Kubernetes je:
- pridanie pre-stop hooku, ktorý bude čakať niekoľko sekúnd;
- preskúmanie konfiguračného súboru nášho backendu na prítomnosť príslušných parametrov.
Príklad s NGINX ukazuje, že aj aplikácia, ktorá by mala správne reagovať na signály na ukončenie, tak nemusí robiť, preto je kritické kontrolovať prítomnosť 500 chýb počas nasadenia aplikácie. Taktiež to umožňuje pozerať sa na problém širšie a nesústreďovať sa na jednotlivý pod alebo kontajner, ale zhodnotiť celú infraštruktúru ako celok.
Ako nástroj na testovanie môžeme použiť Yandex.Tank spolu s akýmkoľvek monitorovacím systémom (v našom prípade sa na test brali údaje z Grafany s backendom v podobe Prometheus). Problémy s graceful shutdown sú dobre viditeľné pri vysokých záťažiach, ktoré môže generovať benchmark, a monitoring pomáha detailnejšie rozobrať situáciu počas alebo po teste.
V odpovedi na spätnú väzbu k článku je potrebné uviesť, že problémy a možnosti ich riešenia sú tu popisované v súvislosti s NGINX Ingress. Pre iné prípady existujú iné riešenia, ktoré možno preskúmame v budúcich materiáloch cyklu.
P.S.
Ďalšie z cyklu K8s tips & tricks:
- «»;
- «»;
- «»;
- «».
Zdroj: habr.com
