

TL;DR
- Na dosiahnutie vysokej sledovateľnosti kontajnerov a mikroservisov, ako aj ich záznamov a primárnych metrík, to nestačí.
- Na rýchlejšie zotavenie a zvýšenie odolnosti aplikácie je potrebné uplatniť Princíp vysokej sledovateľnosti (HOP, High Observability Principle).
- Na úrovni aplikácie pre HOP sú potrebné: správne záznamy, dôkladný monitoring, kontrola dostupnosti a sledovanie výkonu/prechodov.
- Ako súčasť HOP používajte kontroly readinessProbe a livenessProbe Kubernetes.
Čo je Šablóna kontroly dostupnosti?
Pri navrhovaní kriticky dôležitej a vysoko dostupnej aplikácie je veľmi dôležité myslieť na aspekt, ako je odolnosť proti poruchám. Aplikácia sa považuje za odolnú voči poruchám, ak sa rýchlo obnoví po poruche. Typická cloudová aplikácia používa architektúru mikroservisov – pri ktorej je každý komponent umiestnený v samostatnom kontajneri. A aby ste sa uistili, že aplikácia na k8s je vysoko dostupná, pri navrhovaní klastru musíte dodržiavať určité šablóny. Medzi nimi je aj Šablóna kontroly dostupnosti. Táto šablóna určuje, ako aplikácia informuje k8s o svojej dostupnosti. Nie je to len informácia o tom, či pod funguje, ale aj o tom, ako prijíma požiadavky a na ne odpovedá. Čím viac Kubernetes vie o dostupnosti podu, tým inteligentnejšie rozhodnutia prijíma o smerovaní prevádzky a vyvažovaní zaťaženia. Takto Princíp vysokej sledovateľnosti umožňuje aplikácii včas reagovať na požiadavky.
Princíp vysokej sledovateľnosti (HOP)
Princíp vysokej sledovateľnosti je jedným z . V mikroslužobnej architektúre je službám jedno, ako sa spracováva ich požiadavka (a to je v poriadku), ale dôležité je, ako získať odpovede od prijímajúcich služieb. Napríklad na autentifikáciu používateľa jeden kontajner posiela druhému HTTP požiadavku a očakáva odpoveď v určitej forme - a to je všetko. Požiadavku môže spracovať aj PythonJS, a odpovedať môže Python Flask. Kontajnery sú pre seba čiernymi škatuľami so skrytým obsahom. Avšak princíp NOP požaduje, aby každá služba odhalila niekoľko koncových bodov API, ktoré ukazujú, do akej miery je funkčná, ako aj svoj stav pripravenosti a odolnosti voči poruchám. Tieto indikátory sa žiadajú od Kubernetes, aby mohol premýšľať o ďalších krokoch v smerovaní a vyvažovaní záťaže.
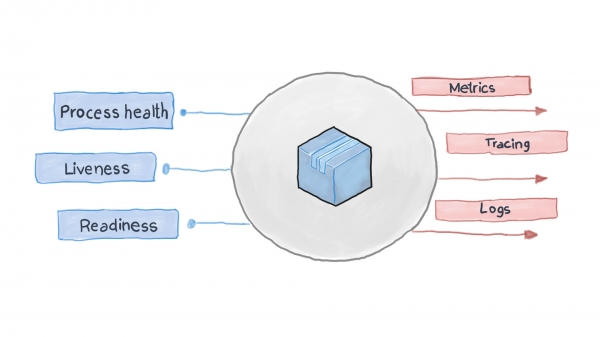
Dobre navrhnutá cloudová aplikácia zaznamenáva svoje kľúčové udalosti pomocou štandardných vstupných a výstupných prúdov STDERR a STDOUT. Následne pracuje pomocná služba, ako napríklad filebeat, logstash alebo fluentd, ktorá prenáša logy do centralizovaného systému monitorovania (napríklad Prometheus) a systému zberu logov (súbor softvéru ELK). Na obrázku nižšie je znázornené, ako cloudová aplikácia funguje v súlade s Šablónou kontroly funkčnosti a Princípom vysokej observability.
Ako aplikovať Šablónu kontroly funkčnosti v Kubernetes?
Out-of-the-box k8s monitoruje stav podov pomocou jedného z kontrolérov (, , , a ďalšie, ďalšie). Ak kontrolér zistí, že pod z nejakého dôvodu zlyhal, pokúša sa ho reštartovať alebo presunúť na iný uzol. Avšak pod môže oznámiť, že je spustený a funguje, a pritom v skutočnosti nefunguje. Uveďme príklad: vaša aplikácia používa ako webový server Apache, komponent ste nainštalovali na niekoľko podov klastrov. Keďže bola knižnica nastavená nesprávne - všetky požiadavky na aplikáciu odpovedajú kódom 500 (vnútorna chyba servera). Pri kontrole podávania kontrola stavu podov prináša úspešný výsledok, avšak klienti si to myslia inak. Túto neočakávanú situáciu opíšeme nasledovne:
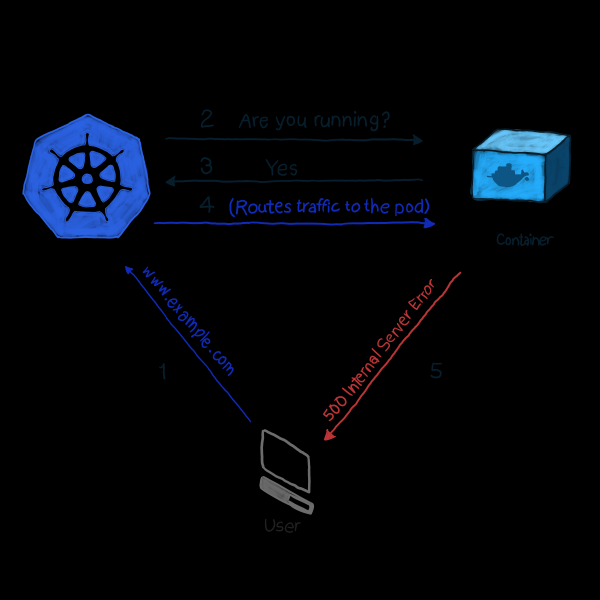
V našom príklade k8s vykonáva kontrolu funkčnosti. V tomto type kontroly kubelet nepretržite sleduje stav procesu v kontajneri. Ak zistí, že proces sa zastavil, reštartuje ho. Ak sa chyba odstráni jednoduchým reštartom aplikácie a program je navrhnutý tak, aby sa pri akejkoľvek chybe odpojil, potom stačí kontrola funkčnosti procesu na dodržiavanie NORM a Šablóny kontroly funkcionality. Škoda len, že nie všetky chyby sa odstránia reštartom. Na tento účel k8s ponúka dva hlbšie spôsoby zistenia problémov s fungovaním podu: a .
LivenessProbe
Počas livenessProbe kubelet vykonáva 3 typy kontrol: nielen zisťuje, či pod funguje, ale aj či je pripravený prijímať a adekvátne odpovedať na požiadavky:
- Nastaviť HTTP požiadavku na pod. Odpoveď by mala obsahovať HTTP kód odpovede v rozmedzí od 200 do 399. Takto kódy 5xx a 4xx signalizujú, že s podom sú problémy, aj keď proces funguje.
- Na kontrolu podov s ne-HTTP službami (napríklad poštový server Postfix) je potrebné nadviazať TCP spojenie.
- Vykonanie ľubovoľného príkazu pre pod (interné). Kontrola sa považuje za úspešnú, ak kód dokončenia príkazu je 0.
Príklad toho, ako to funguje. Definícia nasledujúceho podu obsahuje NodeJS aplikáciu, ktorá na HTTP požiadavky vracia chybu 500. Aby sme sa uistili, že kontajner sa reštartuje po obdržaní takejto chyby, používame parameter livenessProbe:
apiVersion: v1
kind: Pod
metadata:
 name: node500
spec:
 containers:
   - image: magalix/node500
     name: node500
     ports:
       - containerPort: 3000
         protocol: TCP
     livenessProbe:
       httpGet:
         path: /
         port: 3000
       initialDelaySeconds: 5
To sa nijako nelíši od akejkoľvek inej definície podu, ale pridávame objekt .spec.containers.livenessProbe. Parameter httpGet berie cestu, na ktorú odosiela HTTP GET požiadavku (v našom príklade je to /, ale v bojových scenároch to môže byť niečo ako /api/v1/status). Ešte livenessProbe prijíma parameter initialDelaySeconds, ktorý predpisuje, aby operácia kontroly čakala stanovený počet sekúnd. Zdržanie je potrebné, pretože kontajner potrebuje čas na štartovanie a pri reštarte bude nejaký čas nedostupný.
Aby ste použili toto nastavenie vo svojom klastri, použite:
kubectl apply -f pod.yamlO niekoľko sekúnd neskôr môžete skontrolovať obsah podu pomocou nasledujúceho príkazu:
kubectl describe pods node500Na konci výstupu nájdite .
Ako vidíte, livenessProbe inicioval HTTP GET požiadavku, kontajner vyhodil chybu 500 (na čo bol naprogramovaný), kubelet ho reštartoval.
Ak vás zaujíma, ako bolo naprogramované NideJS aplikáciu, tu sú súbory app.js a Dockerfile, ktoré boli použité:
app.js
var http = require('http');

var server = http.createServer(function(req, res) {
    res.writeHead(500, { "Content-type": "text/plain" });
    res.end("Narazili sme na chybu
");
});

server.listen(3000, function() {
    console.log('Server beží na 3000')
})
Dockerfile
FROM node
COPY app.js /
EXPOSE 3000
ENTRYPOINT [ "node","/app.js" ]
Je dôležité si uvedomiť toto: livenessProbe reštartuje kontajner iba pri zlyhaní. Ak reštart nepomôže opraviť chybu, ktorá bráni fungovaniu kontajnera, kubelet nebude môcť podniknúť kroky na odstránenie poruchy.
readinessProbe
readinessProbe funguje podobne ako livenessProbes (GET požiadavky, TCP pripojenia a vykonávanie príkazov), s výnimkou akcií na odstránenie porúch. Kontajner, v ktorom došlo k zlyhaniu, nie je reštartovaný, ale izolovaný od prichádzajúcej prevádzky. Predstavte si, že jeden z kontajnerov vykonáva veľa výpočtov alebo podlieha veľkej záťaži, čo spôsobuje, že sa predlžuje čas odpovede na požiadavky. V prípade livenessProbe sa aktivuje kontrola dostupnosti odpovede (prostredníctvom parametra overenia timeoutSeconds), po ktorej kubelet reštartuje kontajner. Po reštartovaní kontajner začne vykonávať náročné úlohy a znova ho reštartujú. To môže byť kritické pre aplikácie, ktorým záleží na rýchlosti odpovede. Napríklad stroj priamo na ceste čaká na odpoveď od servera, odpoveď sa oneskoruje – a stroj havaruje.
Poďme napísať definíciu readinessProbe, ktorá nastaví čas odpovede na GET požiadavku maximálne dve sekundy, zatiaľ čo aplikácia bude odpovedať na GET požiadavku po 5 sekundách. Súbor pod.yaml by mal vyzerať nasledovne:
apiVersion: v1
kind: Pod
metadata:
 name: nodedelayed
spec:
 containers:
   - image: afakharany/node_delayed
     name: nodedelayed
     ports:
       - containerPort: 3000
         protocol: TCP
     readinessProbe:
       httpGet:
         path: /
         port: 3000
       timeoutSeconds: 2
Nasadíme pod s kubectl:
kubectl apply -f pod.yamlPočkáme pár sekúnd a potom sa pozrieme, ako zafungovala readinessProbe:
kubectl describe pods nodedelayedNa konci výstupu je možné vidieť, že časť udalostí je podobná .
Ako vidíte, kubectl nerezignoval na reštartovanie podu, keď čas overenia presiahol 2 sekundy. Namiesto toho zrušil požiadavku. Prichádzajúce spojenia sú presmerované na iné, funkčné pody.
Vezmite na vedomie, že teraz, keď bola z podu odstránená nadmerná záťaž, kubectl opäť smeruje požiadavky naň: odpovede na GET požiadavky už nie sú oneskorené.
Na porovnanie: nižšie je zobrazený upravený súbor app.js:
var http = require('http');

var server = http.createServer(function(req, res) {
   const sleep = (milliseconds) => {
       return new Promise(resolve => setTimeout(resolve, milliseconds))
   }
   sleep(5000).then(() => {
       res.writeHead(200, { "Content-type": "text/plain" });
       res.end("Hellon");
   })
});

server.listen(3000, function() {
   console.log('Server is running at 3000')
})
TL;DR
Pred príchodom cloudových aplikácií boli hlavnými prostriedkami monitorovania a overovania stavu aplikácií logy. Avšak neexistovali prostriedky na vykonávanie opráv. Logy sú aj dnes užitočné, treba ich zbierať a posielať do systému na zhromažďovanie logov na analýzu havarijných situácií a prijímanie rozhodnutí. [to všetko mohlo byť realizované aj bez cloudových aplikácií pomocou monit, napríklad, ale s k8s to bolo oveľa jednoduchšie 🙂 – pozn. red. ]
Dnes je však potrebné vykonávať opravy takmer v reálnom čase, takže aplikácie už nemusia byť čierne skrinky. Nie, musia ukazovať koncové body, ktoré umožňujú monitorovacím systémom požadovať a zbierať cenné údaje o stave procesov, aby mohli v prípade potreby okamžite reagovať. To sa nazýva Dizajnový vzor overovania funkčnosti, ktorý dodržiava Princíp vysokej pozorovateľnosti (SLO).
Kubernetes ponúka štandardne 2 druhy overovania funkčnosti: readinessProbe a livenessProbe. Obe používajú rovnaké typy kontrol (HTTP GET požiadavky, TCP spojenia a vykonávanie príkazov). Rozlišujú sa v tom, aké rozhodnutia sa prijímajú v reakcii na poruchy v puedo. livenessProbe reštartuje kontajner s nádejou, že sa chyba už nebude opakovať, zatiaľ čo readinessProbe izoluje pod od prichádzajúceho prenosu – až do odstránenia príčiny poruchy.
Správne navrhnutie aplikácie by malo zahŕňať oba typy overovaní a zabezpečiť, aby zbierali dostatok údajov, najmä keď vznikne výnimočná situácia. Mali by tiež zobrazovať potrebné API koncové body, ktoré prenášajú monitorovacej sústave (tomu istému Prometheus) dôležité metriky stavu funkčnosti.
Zdroj: habr.com
