

Dôležitým aspektom fungovania distribuovaných systémov je spracovanie porúch. Kubernetes s tým pomáha pomocou ovládačov, ktoré sledujú stav vášho systému a reštartujú nepracujúce služby. Avšak Kubernetes môže nútene zastaviť fungovanie aplikácií, aby zabezpečil celkovú životaschopnosť systému. V tejto sérii sa pozrieme na to, ako môžete pomôcť Kubernetes vykonávať svoju prácu efektívnejšie a skrátiť čas výpadku aplikácií.
Predtým, než sa začalo používať kontajnerové technológie, väčšina aplikácií fungovala na virtuálnych alebo fyzických strojoch. Ak aplikácia zlyhala alebo zamrzla, trvalo veľa času, kým sa úloha zastavila a program znova načítal. V najhoršom prípade sa niekto musel s touto problémovou situáciou vysporiadať manuálne v noci, v úplne nevhodnom čase. Ak sa dôležitá úloha vykonávala iba na 1-2 pracovných strojoch, takéto zlyhanie bolo úplne neprijateľné.
Preto sa namiesto ručného reštartu začalo používať monitorovanie na úrovni procesov na automatické reštartovanie aplikácie v prípade jej havárie. Ak program zlyhá, monitorovací proces zachytí exit-kód a reštartuje server. S príchodom takých systémov, akým je Kubernetes, bol tento spôsob reakcie na poruchy jednoducho integrovaný do infraštruktúry.
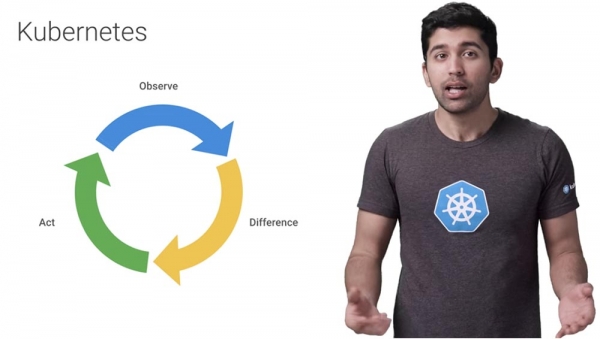
Kubernetes využíva slučku udalostí "sledovanie – zaznamenávanie rozdielov – vykonanie akcie", aby sa ubezpečil, že zdroje zostávajú funkčné na ceste z kontajnerov k samotným uzlom.
To znamená, že už nemusíte ručne spúšťať monitorovanie procesov. Ak zdroj neprejde testom zdravotnej kontroly Health Check, Kubernetes mu jednoducho automaticky poskytne náhradu. Pri tom Kubernetes robí oveľa viac, než len sleduje poruchy vašich aplikácií. Môže vytvárať viac kópií aplikácie pre viaceré stroje, aktualizovať aplikáciu alebo súčasne spúšťať viac verzií vašej aplikácie.
Existuje mnoho dôvodov, prečo môže Kubernetes prerušiť prácu úplne zdravého kontajnera. Napríklad, ak aktualizujete svoje nasadenie, Kubernetes pomaly zastaví staré pody a zároveň spúšťa nové. Ak odpojíte uzol, Kubernetes zastaví všetky pody na tomto uzle. Nakoniec, ak uzlu dôjdu zdroje, Kubernetes vypne všetky pody, aby uvoľnil tieto zdroje.
Je preto veľmi dôležité, aby vaša aplikácia prestala fungovať s minimálnym dopadom na koncového používateľa a minimálnym časom obnovy. To znamená, že pred odpojením by mala uložiť všetky údaje, ktoré je potrebné zachrániť, uzavrieť všetky sieťové pripojenia, dokončiť zvyšnú prácu a stihnúť vykonať ďalšie naliehavé úlohy.
V praxi to znamená, že vaša aplikácia by mala vedieť spracovať signál SIGTERM – signál na ukončenie procesu, ktorý je predvoleným signálom pre utilitu kill v operačných systémoch rodiny Unix. Po prijatí tohto signálu by sa aplikácia mala vypnúť.
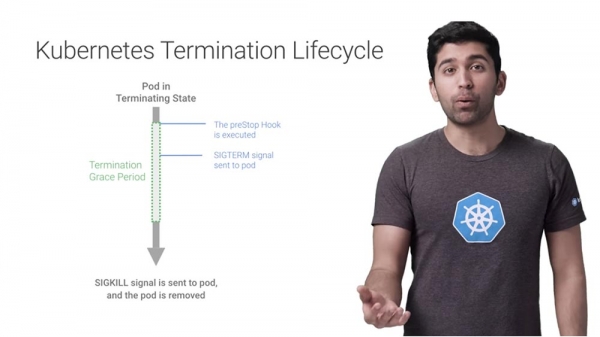
Po tom, čo sa Kubernetes rozhodne ukončiť pod, sa odohrá séria udalostí. Poďme sa pozrieť na každý krok, ktorý Kubernetes vykonáva pri vypnutí kontajnera alebo podu.
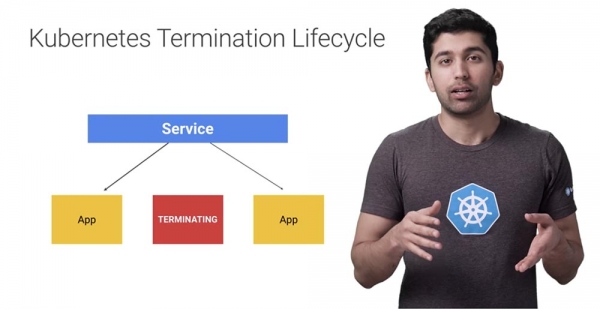
Predpokladajme, že chceme ukončiť jeden z podov. V tomto momente prestane prijímať nový traffic – bežiace kontajnery v pode nebudú ovplyvnené, ale celý nový traffic bude zablokovaný.
Pozrime sa na hook preStop – to je špeciálny príkaz alebo HTTP požiadavka, ktorá sa odosiela kontajnerom v pode. Ak sa vaša aplikácia pri prijatí SIGTERM nezavrie správne, môžete použiť preStop na správne ukončenie práci.
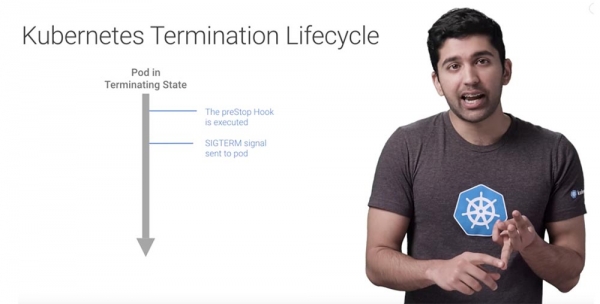
Väčšina programov pri prijatí signálu SIGTERM správne ukončí svoju prácu, ale ak používate cudzí kód alebo nejaký systém, ktorý nemôžete úplne kontrolovať, hook preStop je skvelý spôsob, ako dosiahnuť elegantné vypnutie bez zmeny aplikácie.
Po vykonaní tohto hooku Kubernetes pošle kontajnerom v pode signál SIGTERM, ktorý im dá vedieť, že čoskoro budú vypnuté. Po prijatí tohto signálu sa váš kód presunie do procesu vypínania. Tento proces môže zahŕňať zastavenie akýchkoľvek dlhodobých spojení, ako je pripojenie k databáze alebo WebSocket prúd, uloženie aktuálneho stavu a podobne.
Aj keď používate hook preStop, je veľmi dôležité skontrolovať, čo sa s vašou aplikáciou deje, keď jej pošlete signál SIGTERM, ako sa správa, aby ste predišli neočakávaným udalostiam alebo zmenám v prevádzke systému spôsobeným vypnutím poda.
V tomto momente, predtým než podniknete ďalšie kroky, Kubernetes čaká počas stanoveného času, nazývaného terminationGracePeriodSecond, alebo obdobím pre riadne vypínanie po prijatí signálu SIGTERM.
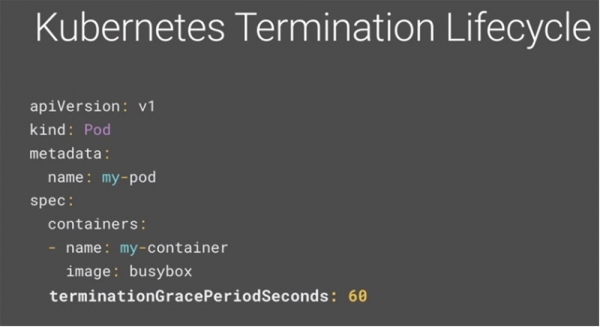
Predvolene je toto obdobie 30 sekúnd. Je dôležité poznamenať, že prebieha súčasne s preStop hook a signálom SIGTERM. Kubernetes nebude čakať, kým sa dokončí preStop hook a SIGTERM — ak vaša aplikácia ukončí prácu pred skončením obdobia TerminationGracePeriod, Kubernetes okamžite prejde na ďalší krok. Skontrolujte, aby hodnota tohto obdobia v sekundách nebola menšia než čas potrebný na riadne vypínanie poda, a ak presahuje 30 sekúnd, predĺžte obdobie na potrebnú hodnotu v YAML. V uvedenom príklade je to 60 sekúnd.
A nakoniec, posledný krok — ak kontajnery stále pracujú po uplynutí terminationGracePeriod, pošlú signál SIGKILL a budú nútene odstránené. V tomto momente Kubernetes tiež vyčistí všetky ostatné objekty poda.
Kubernetes ukončuje pod-y z mnohých dôvodov, a preto sa uistite, že vaša aplikácia bude vždy ukončená správne, aby sa zabezpečila stabilná prevádzka služby.
Trochu reklamy 🙂
Ďakujeme, že ostávate s nami. Páčia sa vám naše články? Chcete vidieť viac zaujímavých materiálov? Podporte nás, vytvorením objednávky alebo odporúčaním známym, , unikátny ekvivalent entry-level serverov, ktorý sme pre vás vytvorili: (k dispozícii varianty s RAID1 a RAID10, až 24 jadier a až 40GB DDR4).
Dell R730xd je dvakrát lacnejší v dátovom centre Equinix Tier IV v Amsterdame? Len u nás v Holandsku! Dell R420 — 2x E5-2430 2.2Ghz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — od 99 dolárov! Prečítajte si o tom
Zdroj: habr.com
