

Ak ste ako väčšina ľudí, pravdepodobne používate zdroje, ktoré fungujú mimo vášho klastru. Možno používate API Taleo na odosielanie textových správ alebo analyzujete obrázky pomocou API Google Cloud Vision.
Ak používate rovnaký endpoint — bod prijatia požiadaviek na strane servera vo všetkých svojich prostrediach a neplánujete presunúť svoje servery do Kubernetes, je úplne normálne mať endpoint služby priamo vo vašom kóde. Existuje však množstvo iných scenárov. V tejto sérii „Najlepšie praktiky Kubernetes“ sa dozviete, ako používať vstavané mechanizmy Kubernetes na objavovanie služieb, ako vo vnútri, tak aj mimo klastru.
Príkladom bežne používaných vonkajších služieb môže byť databáza, ktorá funguje mimo klastru Kubernetes. Na rozdiel od takých cloudových databáz, ako sú Google Cloud Data Store alebo Google Cloud Spanner, ktoré používajú jeden endpoint pre všetky typy prístupu, väčšina databáz má samostatné endpointy pre rôzne okolnosti.
Najlepšou praxou pri používaní tradičných databáz, ako sú MySQL a MongoDB, je zvyčajne pripojiť sa k rôznym komponentom pre rôzne prostredia. Môžete mať veľký server pre produkčné dáta a menší server pre testovacie prostredie. Každý z nich bude mať svoju vlastnú IP adresu alebo doménové meno, ale určite nebudete chcieť meniť svoj kód pri prechode z jedného prostredia do druhého. Preto namiesto tvrdého kódovania týchto adries môžete použiť vstavané objavovanie vonkajších služieb v Kubernetes na základe DNS rovnako ako pre natívne služby Kubernetes.
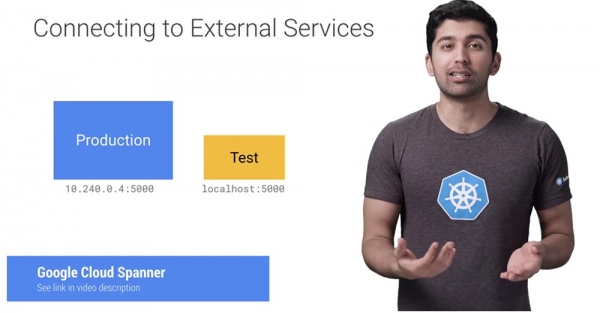
Predpokladajme, že spúšťate databázu MongoDB v Google Compute Engine. Zostanete zaseknutí v tomto hybridnom svete, kým ju nebudete môcť presunúť do klastru.
Našťastie môžete využiť statické služby Kubernetes, aby ste si aspoň trochu uľahčili život. V tomto príklade som vytvoril server MongoDB pomocou Google Cloud Launcher. Keďže je vytvorený v tej istej sieti (alebo VPC klastru Kubernetes), prístup k nemu prebieha pomocou výkonného vnútorného IP adresy.
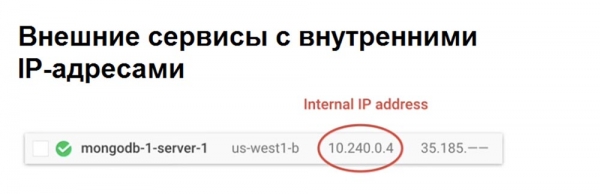
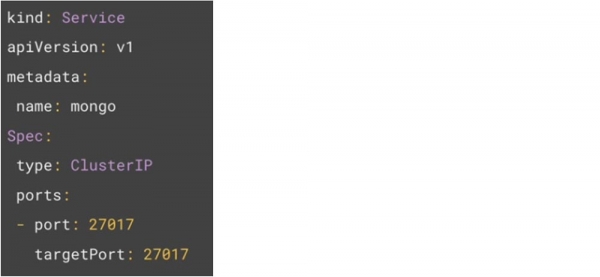
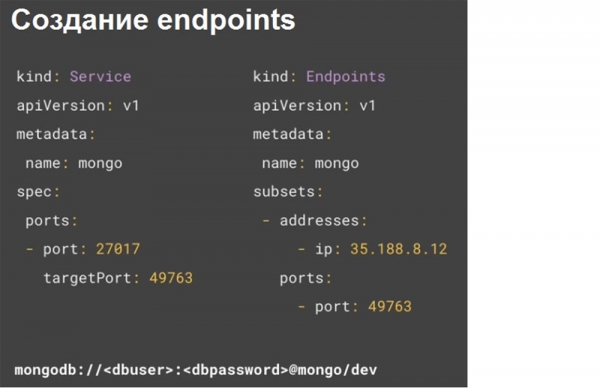
V Google Cloud je toto predvolené nastavenie, takže nemusíte nič nastavovať. Teraz, keď je tu IP adresa, prvým krokom je vytvorenie služby. Môžete si všimnúť, že táto služba nemá žiadne selektory podov. To znamená, že sme vytvorili službu, ktorá nebude vedieť, kam posielať trafick...
Nasledujúci príklad kódu ukazuje, že koncové body určujú IP adresu pre databázu, používajúc to isté meno mongo, ako služba.
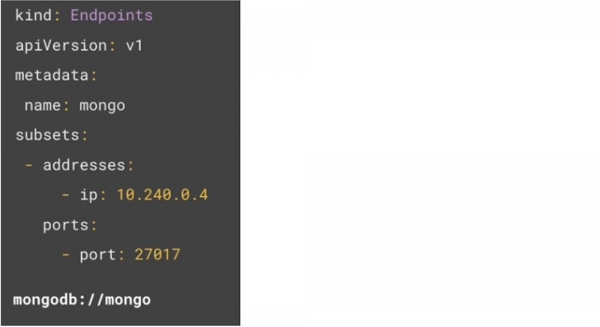
Kubernetes použije všetky IP adresy, aby našiel koncové body, ako keby to boli bežné pody Kubernetes, takže teraz sa môžete k databáze pripojiť pomocou jednoduchého pripojenia k vyššie uvedenému menu mongodb://mongo. Pri tom nie je potrebné v kóde používať IP adresy.
Ak sa v budúcnosti IP adresy zmenia, stačí aktualizovať koncové body s novou IP adresou a vaše aplikácie nebude potrebné nejakým spôsobom menšiť.
Ak používate databázu hostenú na externom hostiteľovi, pravdepodobne vám vlastníci hostingu poskytli na pripojenie unifikovaný identifikátor zdroja URI. Takže ak vám dali IP adresu, môžete jednoducho využiť predchádzajúcu metódu. Tento príklad ukazuje, že mám dve databázy MongoDB hostené na hostingu mLab.
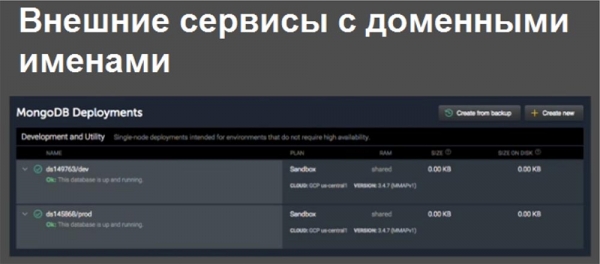
Jedna z nich je databáza pre vývojárov a druhá je databáza produkcie. Pripojenia pre tieto databázy vyzerajú takto - mLab vám poskytuje dynamický URI a dynamický port. Ako vidíte, sú odlišné.
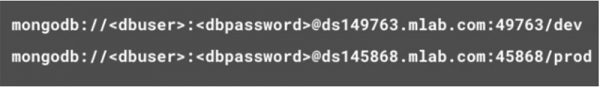
Aby sme sa od toho abstrahovali, použijeme Kubernetes a pripojíme sa k databáze pre vývojárov. Môžete vytvoriť externé meno služby Kubernetes, ktoré vám poskytne statickú službu, ktorá presmeruje trafick na externú službu.
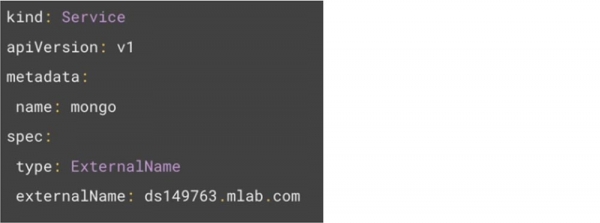
Táto služba vykoná jednoduchú CNAME presmerovanie na úrovni jadra, čo má minimálny dopad na výkon. Vďaka tomu môžete použiť jednoduchší prístupový reťazec.

Avšak, keďže vonkajšie meno používa CNAME presmerovanie, nemôže vykonať premapovanie portov. Preto je toto riešenie aplikovateľné len na statické porty a nemôže sa používať s dynamickými portami. Bezplatný mLab Free Tier predvolene poskytuje používateľovi dynamické číslo portu a nemôžete to zmeniť. To znamená, že na dev a prod potrebujete rôzne príkazy na pripojenie. Zlé je to, že v tomto prípade bude potrebné pevné zakódovanie čísla portu. Ako teda dosiahnuť fungovanie premapovania portov?
Prvým krokom je získanie IP adresy z URI. Ak spustíte príkaz nslookup, hostname alebo pingnete URI, môžete získať IP adresu databázy. Ak služba vráti niekoľko IP adries, všetky tieto adresy môžu byť použité na koncových bodoch objektu.
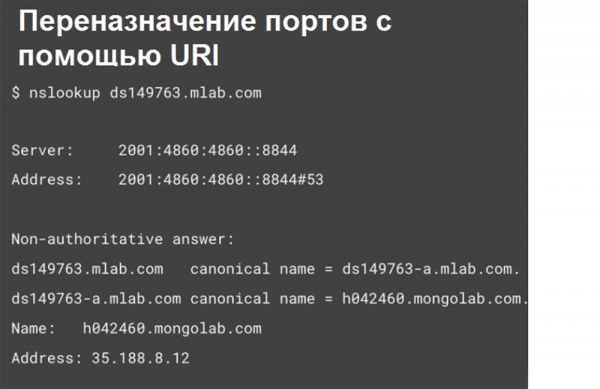
Treba pamätať, že IP adresy URI sa môžu zmeniť bez predchádzajúceho upozornenia, takže ich je dosť riskantné používať v prod. S pomocou takejto IP adresy sa môžete pripojiť k vzdialenej databáze bez uvedenia portu. Takto služba Kubernetes vykonáva premapovanie portov pomerne transparentne.
Mapovanie, alebo priradenie vonkajších zdrojov k vnútorným, vám poskytuje možnosť flexibilne používať tieto služby vo vnútri klastera v budúcnosti pri minimalizácii snáh na refaktorovanie. Uľahčuje to aj správu a poskytuje pochopenie, ktoré vonkajšie služby vaša spoločnosť využíva.
Pokračovanie čoskoro ...
Trochu reklamy 🙂
Ďakujeme, že ostávate s nami. Páčia sa vám naše články? Chcete vidieť viac zaujímavých materiálov? Podporte nás, vytvorením objednávky alebo odporúčaním známym, , unikátny ekvivalent entry-level serverov, ktorý sme pre vás vytvorili: (k dispozícii varianty s RAID1 a RAID10, až 24 jadier a až 40GB DDR4).
Dell R730xd je dvakrát lacnejší v dátovom centre Equinix Tier IV v Amsterdame? Len u nás v Holandsku! Dell R420 — 2x E5-2430 2.2Ghz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — od 99 dolárov! Prečítajte si o tom
Zdroj: habr.com
