

Ahoj, Habr! Pozývame Data Engineerov a špecialistov na Machine Learning na bezplatnú ukážkovú hodinu . Taktiež zverejňujeme článok od Lucy Monno — vedúcej finančnej analytiky v CDP SpA.
Jednou z najužitočnejších a najjednoduchších metód strojového učenia je Ensemble Learning. Ensemble Learning je metóda, na ktorej sú založené XGBoost, Bagging, Random Forest a mnohé ďalšie algoritmy.
Na Towards Data Science je veľa skvelých článkov, ale ja som si vybral dva príbehy ( a ), ktoré sa mi najviac páčili. Prečo však písať ešte jeden článok o EL? Pretože chcem ukázať, ako to funguje na jednoduchom príklade, ktorý mi dal pochopiť, že tu nie je žiadne kúzlo.
Keď som prvýkrát uvidel EL v akcii (pri práci s niekoľkými veľmi jednoduchými regresnými modelmi), nemohol som uveriť vlastným očiam a dodnes si spomínam na profesora, ktorý ma naučil túto metódu.
Mal som dva rozdielne modely (dva slabé učebné algoritmy) s hodnotami out-of-sample R² zodpovedajúcimi 0,90 a 0,93. Predtým, než som sa pozrel na výsledok, myslel som si, že dostanem R² niekde medzi týmito dvoma pôvodnými hodnotami. Inými slovami, veril som, že EL sa môže použiť, aby model fungoval nie tak zle ako najhorší, ale ani tak dobre, ako by mohol fungovať najlepší model.
K mojemu najväčšiemu prekvapeniu, výsledky jednoduchého priemerovania predpovedí priniesli R² 0,95.
Najprv som začal hľadať chybu, ale potom som si pomyslel, že tu môže byť nejaká mágia!
Čo je Ensemble Learning
Pomocou EL môžeme zlúčiť predpovede dvoch alebo viacerých modelov, aby sme získali spoľahlivejší a výkonnejší model. Existuje množstvo metodológií na prácu s ansámblmi modelov. Tu sa dotknem dvoch najužitočnejších, aby som poskytol všeobecný prehľad.
S pomocou regresie môžeme priemerné hodnoty existujúcich modelov.
S pomocou klasifikácie môžeme nechať modely vybrať štítky. Štítok, ktorý sa vyberal najčastejšie – to je ten, ktorý bude vybraný novým modelom.
Prečo EL funguje lepšie
Hlavný dôvod, prečo EL funguje lepšie, spočíva v tom, že každé predpovedanie má chybu (čo vieme z teórie pravdepodobnosti) a spojenie dvoch predpovedí môže pomôcť znížiť chybu, a tým zlepšiť výkonové ukazovatele (RMSE, R² a pod.).
Na nasledujúcej diagrame vidno, ako dva slabé algoritmy pracujú s údajovým súborom. Prvý algoritmus má väčší sklon, ako je potrebné, zatiaľ čo druhý je takmer nulový (možno kvôli nadmernej regularizácii). Ale ensemble ukazuje výsledok oveľa lepšie.
Pokiaľ ide o ukazovateľ R², hodnoty prvého a druhého učenia algoritmu budú -0.01¹, 0.22, zatiaľ čo pre ensemble dosiahne 0.73.
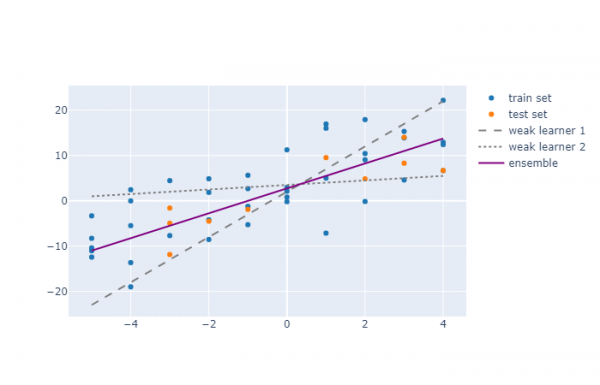
Existuje množstvo dôvodov, prečo môže byť algoritmus zlým modelom, aj na takom základnom príklade, ako je tento: možno ste sa rozhodli použiť regularizáciu, aby ste sa vyhli preučeniu, alebo ste sa rozhodli nevylúčiť niektoré anomálie, alebo ste použili polynomiálnu regresiu a zvolili nesprávny stupeň (napríklad ste použili druhý stupeň, zatiaľ čo na testovacích údajoch je jasná asymetria, pre ktorú by sa lepšie hodil tretí stupeň).
Keď EL pracuje lepšie
Zvážme dva učené algoritmy, ktoré pracujú s rovnakými údajmi.
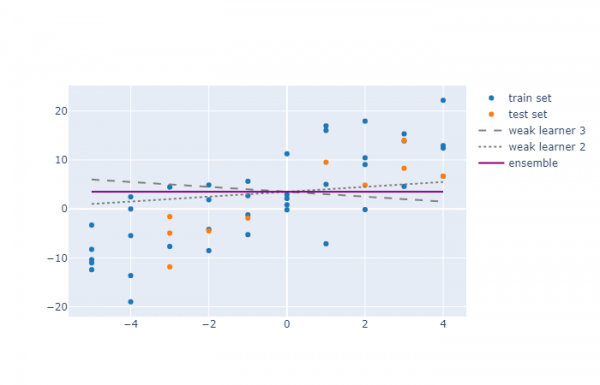
Tu vidno, že spojenie dvoch modelov neprinieslo výrazné zlepšenie výkonu. Pôvodne mali dva učené algoritmy hodnoty R² -0,37 a 0,22, zatiaľ čo pre ensemble to bolo -0,04. Teda model EL dostal priemernú hodnotu ukazovateľov.
Avšak medzi týmito dvoma príkladmi existuje veľký rozdiel: v prvom prípade boli chyby modelov negatívne korelované, zatiaľ čo v druhom pozitívne (koeficienty troch modelov neboli hodnotené, ale jednoducho boli vybrané autorom ako príklad).
Tým pádom môže byť Ensemble Learning využitý na zlepšenie vyváženia biasu/variancie v akýchkoľvek prípadoch, ale keď chyby modelov nie sú pozitívne korelované, použitie EL môže viesť k zlepšeniu výkonu..
Homogénne a heterogénne modely
Často sa EL používa na homogénnych modeloch (ako v tomto príklade alebo v náhodnom lese), ale v skutočnosti môžete kombinovať rôzne modely (lineárnu regresiu + neurónovú sieť + XGBoost) s rôznymi súbormi vysvetľujúcich premenných. To pravdepodobne povedie k nekorelovaným chybám a zvýšeniu výkonu.
Porovnanie s diverzifikáciou portfólia
EL funguje analogicky s diverzifikáciou v teórii portfólia, avšak tým lepšie pre nás.
Pri diverzifikácii sa snažíte znížiť rozptyl vašich ukazovateľov investovaním do nekorelovaných akcií. Dobre diverzifikované portfólio akcií bude mať výkon lepší ako najhoršia individuálna akcia, ale nikdy nie lepší ako tá najlepšia.
Cituje Warrena Buffetta:
„Diverzifikácia je ochrana pred neznalosťou, pre toho, kto nevie, čo robí, má [diverzifikácia] veľmi malý zmysel.“
V strojovom učení EL pomáha znižovať rozptyl vášho modelu, ale môže to viesť k vytvoreniu modelu s celkovým výkonom lepším než najlepší pôvodný model.
Zhrnieme to
Spojenie viacerých modelov do jedného je relatívne jednoduchá metóda, ktorá môže pomôcť vyriešiť problém rozptylu a zvýšiť výkon.
Ak máte dva alebo viac modelov, ktoré fungujú dobre, nevyberajte si medzi nimi: použite ich všetky (ale opatrne)!
Máte záujem sa v tejto oblasti rozvíjať? Prihláste sa na bezplatnú Demo hodinu a zúčastnite sa — Machine Learning Engineer v Mail.ru Group.
Zdroj: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish
 Turkish