

V roku 2018 sa v profesionálnych kruhoch a na tematických konferenciách venovaných AI objavil pojem MLOps, ktorý sa rýchlo upevnil v odvetví a teraz sa vyvíja ako samostatný smer. V budúcnosti môže MLOps stať jednou z najžiadanejších oblastí v IT. Čo to vlastne je a ako to funguje, dozvieme sa ďalej.
Čo je MLOps
MLOps (spojenie technológií a procesov strojového učenia a prístupov k implementácii vyvinutých modelov do obchodných procesov) je nový spôsob spolupráce medzi zástupcami biznisu, vedcami, matematikmi, špecialistami v oblasti strojového učenia a IT inžiniermi pri vytváraní systémov umelej inteligencie.
Inými slovami, je to spôsob, ako premeniť metódy a technológie strojového učenia na užitočný nástroj pre riešenie obchodných úloh.
Je potrebné chápať, že reťazec produktizácie začína dávno pred vývojom modelu. Jeho prvým krokom je definovať obchodný problém, hypotézy o hodnote, ktorú je možné z dát vyťažiť, a obchodné myšlienky na jej aplikáciu.
Pojem MLOps vznikol ako analógia pojmu DevOps aplikovaná na modely a technológie strojového učenia. DevOps je prístup k vývoju softvéru, ktorý umožňuje zvýšiť rýchlosť nasadzovania jednotlivých zmien pri zachovaní flexibility a spoľahlivosti pomocou rôznych prístupov, medzi ktoré patrí nepretržitý vývoj, rozdelenie funkcií na radu nezávislých mikroservisov, automatizované testovanie a nasadenie jednotlivých zmien, globálny monitoring funkčnosti, systém rýchlej reakcie na zistené poruchy a ďalšie.
DevOps definoval životný cyklus softvéru a v komunite odborníkov sa objavila myšlienka použiť túto metódu aj na veľké dáta. DataOps je pokus prispôsobiť a rozšíriť túto metódu s ohľadom na špecifiká ukladania, prenosu a spracovania veľkých objemov dát na rôznych a vzájomne si rozumiacich platformách.
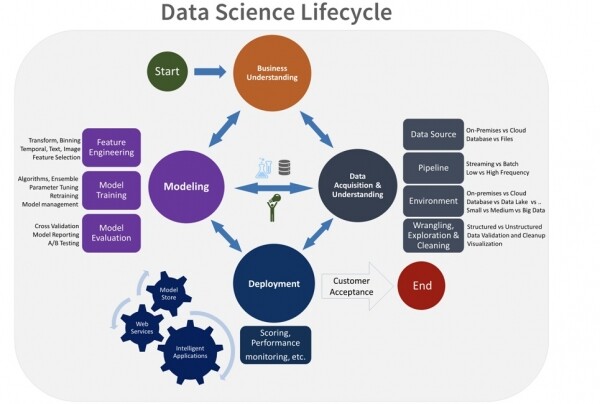
S príchodom určitej kritickej masy modelov strojového učenia integrovaných do podnikových procesov sa pozorovalo silné podobné správanie životného cyklu matematických modelov strojového učenia a životného cyklu softvéru. Jediný rozdiel je v tom, že algoritmy modelov sa vytvárajú pomocou nástrojov a metód strojového učenia. Preto prirodzene vznikla myšlienka aplikovať a prispôsobiť už známe prístupy k vývoju softvéru pre modely strojového učenia. Takže v životnom cykle modelov strojového učenia môžeme vyčleniť nasledujúce kľúčové etapy:
- definovanie obchodnej myšlienky;
- trénovanie modelu;
- testovanie a implementácia modelu do podnikového procesu;
- prevádzka modelu.
Keď v priebehu prevádzky nastane potreba zmeniť alebo preučiť model na nových dátach, cyklus sa začína odznova — model sa vylepšuje, testuje a nasadzuje sa nová verzia.
Odklon. Prečo preučiť, a nie znovu preučiť? Termín „znovu preučenie modelu“ má dvojitý význam: medzi odborníkmi znamená chybu modelu, keď model dobre predpovedá, v skutočnosti opakuje predpovedaný parameter na trénovacej vzorke, ale oveľa horšie funguje na externých dátach. Samozrejme, takýto model je považovaný za zmetok, pretože táto chyba bráni jeho aplikácii.
V tomto životnom cykle sa logicky javí použitie nástrojov DevOps: automatizované testovanie, nasadenie a monitorovanie, prezentácia výpočtov modelov vo forme samostatných mikroslužieb. Ale existuje aj niekoľko špecifických aspektov, ktoré bránia priamemu použitiu týchto nástrojov bez dodatočnej ML väzby.
Ako prinútiť modely pracovať a prinášať zisk
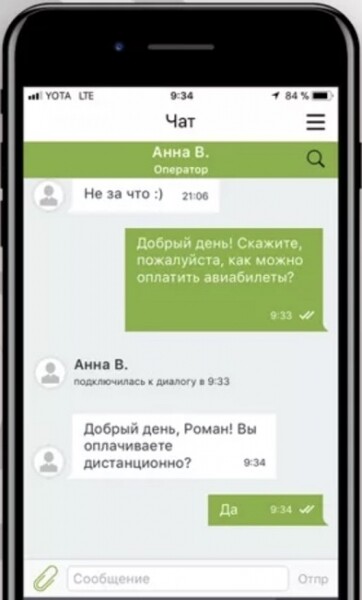
Ako príklad, na ktorom predvedieme aplikáciu prístupu MLOps, sa zameriame na klasickú úlohu automatizácie chatu zákazníckej podpory bankového (alebo akéhokoľvek iného) produktu. Zvyčajne obchodný proces podpory prostredníctvom chatu vyzerá nasledovne: zákazník zadá do chatu správu s otázkou a dostane odpoveď od špecialistu v rámci vopred definovanej štruktúry dialógu. Úloha automatizácie takéhoto chatu sa obvykle rieši pomocou expertných súborov pravidiel, ktoré sú veľmi prácne na vývoj a údržbu. Efektívnosť takejto automatizácie, v závislosti od úrovne zložitosti úlohy, môže dosiahnuť 20–30%. Samozrejme, vzniká myšlienka, že výhodnejšie je zavedenie modulu umelej inteligencie — modelu vyvinutého pomocou strojového učenia, ktorý:
- je schopný spracovať bez účasti operátora väčšie množstvo požiadaviek (v závislosti od témy, v niektorých prípadoch môže efektivita dosiahnuť 70–80%);
- lepšie sa prispôsobuje neštandardným formuláciám v dialógu — dokáže určiť intent, skutočné želanie používateľa na základe nepresne formulovanej požiadavky;
- dokáže určiť, kedy je odpoveď modelu adekvátna, a kedy existujú pochybnosti o „vedomosti“ tejto odpovede a je potrebné položiť dodatočnú spresňujúcu otázku alebo prepínať na operátora;
- môže byť automatizovane ďalej trénovaná (namiesto skupiny vývojárov, ktorí neustále prispôsobujú a upravujú scenáre odpovedí, model ďalej trénuje špecialista na Data Science, ktorý používa príslušné knižnice strojového učenia).
Ako prinútiť taký pokročilý model pracovať?
Rovnako ako pri riešení akejkoľvek inej úlohy, pred tým, než vyvineme takýto modul, je potrebné definovať obchodný proces a formálne opísať konkrétnu úlohu, ktorú budeme riešiť pomocou metódy strojového učenia. V tomto bode začína proces operacionalizácie označený skratkou Ops.
Nasledujúcim krokom špecialista na Data Science v spolupráci s dátovým inžinierom kontroluje dostupnosť a dostatočnosť dát a obchodnú hypotézu o funkčnosti obchodnej myšlienky, vytvára prototyp modelu a testuje jeho skutočnú efektívnosť. Až po potvrdení zo strany podnikania môže začať prechod od vývoja modelu k jeho implementácii do systémov vykonávajúcich konkrétne obchodné procesy. Priečne plánovanie implementácie, hlboké pochopenie v každej fáze, ako bude model používaný a aký ekonomický prínos prinesie, je základným bodom v procesoch implementácie prístupov MLOps do technologického prostredia spoločnosti.
S rozvojom technológií AI narastá množstvo a rozmanitosť úloh, ktoré je možné riešiť pomocou strojového učenia. Každý takýto obchodný proces znamená úsporu pre spoločnosť vďaka automatizácii práce zamestnancov v masových pozíciách (call centrum, kontrola a triedenie dokumentov atď.), rozšírenie zákazníckej základne pridaním nových atraktívnych a pohodlných funkcií, úsporu prostriedkov optimalizáciou ich využitia a redistribúciou zdrojov a mnoho ďalšieho. Napokon, každý proces je zameraný na vytváranie hodnoty a ako dôsledok by mal prinášať konkrétny ekonomický efekt. Je veľmi dôležité jasne formulate obchodnú ideu a vypočítať predpokladaný zisk z implementácie modelu v celkovej štruktúre vytvárania hodnoty spoločnosti. Niekedy nastávajú situácie, keď implementácia modelu sa neosvedčí, a čas, ktorý odborníci na strojové učenie strávia, sa ukáže byť oveľa drahší ako pracovné miesto operátora, ktorý vykonáva túto úlohu. Preto je potrebné takéto prípady snažiť sa odhaliť v raných fázach vytvárania systémov AI.
Z toho vyplýva, že zisk modelu začína prichádzať iba vtedy, keď bola v procese MLOps správne formulovaná obchodná úloha, určené priority a v raných fázach vývoja bol definovaný proces implementácie modelu do systému.
Nový proces – nové výzvy
Vyčerpávajúca odpoveď na zásadnú otázku podnikania, do akej miery sú modely strojového učenia aplikovateľné na riešenie problémov, a všeobecná otázka dôvery v AI – to je jedna z kľúčových výziev v procese rozvoja a implementácie prístupov MLOps. Podniky spočiatku skepticky pristupujú k implementácii strojového učenia do procesov – ťažko sa spoliehať na modely v oblastiach, kde tradične pracovali ľudia. Pre podniky sa programy javia ako „čierna skrinka“, ktorej relevantnosť odpovedí sa ešte musí dokázať. Okrem toho v bankovom sektore, v oblasti telekomunikačných operátorov a v iných oblastiach existujú prísne požiadavky vládnych regulátorov. Všetky systémy a algoritmy implementované v bankových procesoch podliehajú auditu. Aby sa táto úloha vyriešila a dokázala sa podnikom a regulátorom oprávnenosť a správnosť odpovedí umelej inteligencie, sú spolu s modelom implementované monitorovacie nástroje. Existuje aj proces nezávislej validácie, ktorý je povinný pre regulačné modely, ktorý spĺňa požiadavky centrálnej banky. Nezávislá expertíza vykonáva audit výsledkov, ktoré model získal, pričom zohľadňuje vstupné údaje.
Druhá výzva – hodnotenie a zohľadnenie rizík modelov pri implementácii modelu strojového učenia. Ak ani človek nemôže so stopercentnou istotou odpovedať na otázku, či bolo to šaty biele alebo modré, tak aj umelá inteligencia má právo na chybu. Je tiež potrebné zohľadniť, že časom sa údaje môžu meniť a modely sa musia ďalej učiť, aby poskytovali dostatočne presný výsledok. Aby biznis proces netrpel, je potrebné riadiť riziká modelov a sledovať prácu modelu, pravidelne ho preškoľovať na nových údajoch.
Ale po prvej fáze nedôvery sa začína prejavovať opačný efekt. Čím viac modelov sa úspešne implementuje do procesov, tým viac rastie apetít podnikov po využití umelej inteligencie – nachádzajú sa nové a nové úlohy, ktoré je možné riešiť metódami strojového učenia. Každá úloha spúšťa celý proces, ktorý si vyžaduje rôzne kompetencie:
- dátoví inžinieri pripravujú a spracovávajú údaje;
- dátoví vedci aplicujú nástroje strojového učenia a vyvíjajú model;
- IT zavádza model do systému;
- ML inžinier určuje, ako túto model správne integrovať do procesu, aké IT nástroje použiť v závislosti od požiadaviek na režim aplikácie modelu s ohľadom na tok žiadostí, čas odpovede a podobne.
- ML architekt navrhuje, ako fyzicky realizovať softvérový produkt v priemyselnom systéme.
Celý cyklus vyžaduje množstvo vysoko kvalifikovaných odborníkov. V určitom bode rozvoja a stupňa prenikania ML modelov do obchodných procesov sa ukáže, že lineárne škálovať počet odborníkov úmerne k rastu počtu úloh sa stáva nákladné a neefektívne. Preto vzniká otázka automatizácie procesu MLOps — definícia niekoľkých štandardných tried úloh strojového učenia, vývoj typových pipeline spracovania dát a doškoľovania modelov. V ideálnom prípade na riešenie takýchto úloh potrebujú odborníci, ktorí rovnako dobre ovládajú kompetencie na rozhraní BigData, Data Science, DevOps a IT. Preto je najväčším problémom v priemysle Data Science a najväčšou výzvou pri organizácii procesov MLOps — nedostatok takejto kompetencie na existujúcom trhu prípravy pracovnej sily. Odborníci, ktorí spĺňajú takéto požiadavky, sú v súčasnosti jediní na trhu práce a sú cenení na váhu zlata.
K otázke kompetencií
Teoreticky sa všetky úlohy MLOps dajú riešiť klasickými nástrojmi DevOps a nemusí sa uchýliť k špecializovanému rozšíreniu rolnej model. Ako sme už povedali vyššie, dátový vedec by mal byť nielen matematikom a odborníkom na analytiku dát, ale aj guru všetkých pipeline — na jeho pleciach spočíva vývoj architektúry, programovanie modelov v niekoľkých jazykoch v závislosti od architektúry, príprava vitríny dát a nasadenie samotnej aplikácie. Avšak vytvorenie technologickej obálky, realizovanej v procesoch MLOps, zaberá až 80% pracovného času, čo znamená, že kvalifikovaný matematik, ktorým je kvalitný dátový vedec, bude len 20% času venovať svojej špecializácii. Preto sa rozdelenie rolí špecialistov, ktorí realizujú proces implementácie modelov strojového učenia, stáva životne dôležitým.
To what extent roles should be delineated depends on the scale of the enterprise. It's one thing when a startup has one specialist, a jack-of-all-trades who acts as an engineer, architect, and DevOps all at once. It's quite another when a large company centralizes all model development processes among a few high-level Data Science specialists, while programmers or database specialists—a more common and less costly competence in the job market—can take on most routine tasks.
Thus, the boundary in selecting specialists to ensure the MLOps process and how the operationalization of developed models is organized directly impacts the speed and quality of model development, the productivity of the team, and the microclimate within it.
What our team has already accomplished
Not long ago, we began building the competency structure and MLOps processes. However, we currently have our projects on model lifecycle management and model deployment as a service in the MVP testing stage.
We have also defined the optimal competency structure and organizational interaction for a large enterprise. Agile teams have been organized to address tasks for the entire spectrum of business clients, and a process for collaboration with project teams in creating platforms and infrastructure, which form the foundation of the MLOps framework, has been established.
Questions for the future
MLOps is an emerging field that is facing a shortage of competencies and will gain momentum in the future. For now, it is best to rely on the developments and practices of DevOps. The primary goal of MLOps is to utilize ML models more effectively to solve business problems. However, this raises many questions:
- How can we reduce the time to launch models into production?
- How can we minimize bureaucratic friction between teams of different competencies and enhance collaborative focus?
- How can we track models, manage versions, and organize effective monitoring?
- How can we create a truly cyclical lifecycle for a modern ML model?
- How can we standardize the machine learning process?
Odpovede na tieto otázky do veľkej miery určia, ako rýchlo MLOps odhalí svoj plný potenciál.
Zdroj: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish