

V tomto článku sa podelím o situáciu, ktorá sa nedávno stala na jednom zo serverov našich VPS cloudov, a ktorá ma prinútila tráviť hodiny neisto. S konfiguráciou a riešením problémov so servermi Linux sa zaoberám už približne 15 rokov, ale tento prípad sa úplne vymyká mojej praxi — spravil som niekoľko falošných predpokladov a mierne som beznádejne hľadal správnu príčinu problému, kým som ju nakoniec mohol určiť a vyriešiť.
Preámbula
Prevádzkujeme stredne veľký cloud, ktorý budujeme na typických serveroch s nasledujúcou konfiguráciou — 32 jadier, 256 GB RAM a NVMe úložisko PCI-E Intel P4500 s kapacitou 4TB. Tento konfiguračný návrh je nám veľmi sympatický, pretože nám eliminuje obavy o nedostatok I/O, pričom zaručuje správne obmedzenie na úrovni typov instancií VM. Keďže NVMe Intel má pôsobivý výkon, dokážeme rovnomerne zabezpečiť plné IOPS pre stroje aj zálohovanie úložiska na zálohovacom serveri so žiadnym IOWAIT.
Patríme medzi tých tradičných, ktorí nepoužívajú hyperkonvergentné SDN a iné trendy, moderné, mladícke vymoženosti na ukladanie objemov VM, pretože si myslíme, že čím je systém jednoduchší, tým je jeho odstraňovanie problémov jednoduchšie, keď "hlavný guru sa vybral do hôr". Nakoniec uchovávame objemy VM vo formáte QCOW2 na XFS alebo EXT4, ktorý je nasadený nad LVM2.
Použitie QCOW2 je nám nevyhnutné aj kvôli produktu, ktorý používame na orchestráciu — Apache CloudStack.
Na vykonanie zálohovania robíme úplný obraz objemu, ako snímku LVM2 (áno, vieme, že snímky LVM2 môžu spomaľovať, ale Intel P4500 nás zachraňuje aj tam). Robíme lvmcreate -s .. a pomocou dd posielame zálohu na vzdialený server so ZFS úložiskom. Tu sme predsa len mierne pokrokoví — ZFS dokáže uchovávať dáta komprimovane, a my ich môžeme rýchlo obnoviť pomocou DD alebo extrahovať jednotlivé objemy VM pomocou mount -o loop ....
Samozrejme, môžeme robiť aj nie úplný obraz objemu LVM2 a pripojiť súborový systém v režime
ROa kopírovať samotné obrazy QCOW2, avšak stretli sme sa s tým, že XFS sa pri tom zhoršoval, a to nie hneď, ale nepravidelne. Veľmi nemáme radi, keď hypervizory "zamŕzajú" náhodne cez víkendy, v noci alebo počas sviatkov kvôli chybám, ktoré nie je jasné, kedy nastanú. Preto pre XFS nepoužívame pripojenie snímok v režimeROna extrakciu zväzkov, ale jednoducho kopírujeme celý zväzok LVM2.
Rýchlosť zálohovania na server záloh sa v našom prípade určuje výkonnosťou záložného servera, ktorá je približne 600-800 MB/s pre nekomprimované dáta, ďalší obmedzovač je kanál 10Gbit/s, ktorým je zálohový server pripojený k clustru.
Pritom na jeden záložný server súčasne nahrávajú zálohy 8 serverov hypervizorov. Takto diskové a sieťové subsystémy záložného servera, ktoré sú pomalšie, nepreťažujú diskové subsystémy hypervizorov, pretože jednoducho nie sú schopné spracovať, povedzme, 8 GB/s, ktoré hypervizory môžu bez námahy vydať.
Vyššie opísaný proces kopírovania je veľmi dôležitý pre ďalšie rozprávanie, vrátane detailov — použitie rýchlej pamäte Intel P4500, použitie NFS a pravdepodobne použitie ZFS.
Príbeh o zálohovaní
Na každom uzle hypervizora máme malú časť SWAP s veľkosťou 8 GB, a samotný uzol hypervizora "nasadzujeme" pomocou DD z referenčného obrazu. Pre systémový zväzok na serveroch používame 2xSATA SSD RAID1 alebo 2xSAS HDD RAID1 na hardvérovom ovládači LSI alebo HP. V podstate je nám úplne jedno, čo je vo vnútri, keďže systémový zväzok u nás funguje v režime "takmer readonly", okrem SWAP-u. A keďže máme na serveri veľa RAM, ktorá je na 30-40% voľná, o SWAP sa nestaráme.
Proces vytvárania zálohy. Úloha vyzerá približne takto:
#!/bin/bash

mkdir -p /mnt/backups/volumes

DIR=/mnt/images-snap
VOL=images/volume
DATE=$(date "+%d")
HOSTNAME=$(hostname)

lvcreate -s -n $VOL-snap -l100%FREE $VOL
ionice -c3 dd iflag=direct if=/dev/$VOL-snap bs=1M of=/mnt/backups/volumes/$HOSTNAME-$DATE.raw
lvremove -f $VOL-snap
Venujte pozornosť ionice -c3, v skutočnosti je táto vec pre zariadenia NVMe úplne zbytočná, pretože plánovač IO pre ne je nastavený na:
cat /sys/block/nvme0n1/queue/scheduler
[none]
Avšak, máme niekoľko legacy uzlov s bežnými SSD RAID-ami, pre ktoré je to aktuálne, a preto sa to presúva AS IS. V podstate ide len o zaujímavý kúsok kódu, ktorý vysvetľuje márnosť ionice v prípade takejto konfigurácie.
Všimnite si vlajku iflag=direct pre DD. Používame direct IO mimo vyrovnávacej pamäte, aby sme sa vyhli nadbytočným výmenám IO bufferov pri čítaní. Avšak, oflag=direct to nerobíme, pretože sme sa stretli s problémami s výkonom ZFS pri jeho používaní.
Tento prístup úspešne používame už niekoľko rokov bez problémov.
A tu to začalo… Zistili sme, že pre jednu z uzlov prestalo fungovať zálohovanie, a predchádzajúce prebehlo s hrozným IOWAIT pod 50%. Pri pokuse pochopiť, prečo zálohovanie neprebieha, sme sa stretli s fenoménom:
Volume group "images" not foundZačali sme uvažovať o "konci Intel P4500", avšak pred vypnutím servera na výmenu disku bolo potrebné ešte vykonať zálohovanie. Opravené LVM2 pomocou obnovy metadát zo zálohy LVM2:
vgcfgrestore imagesSpustili sme zálohovanie a videli sme takýto obraz:
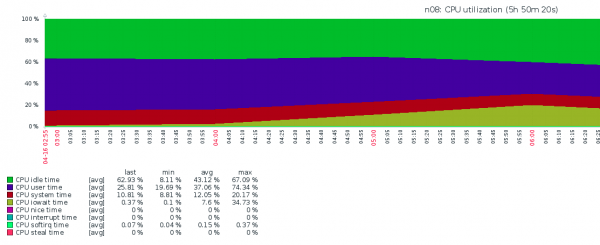
Opäť sme sa veľmi sklamali — bolo jasné, že takto žiť nemôžeme, pretože všetky VPS budú trpieť, a teda budeme trpieť aj my. Čo sa dialo, bolo úplne nejasné — iostat ukazoval žalostné IOPS a mimoriadne vysoké IOWAIT. Nápady, okrem "poďme vymeniť NVMe", neboli, ale prišlo včas osvietenie.
Analýza situácie po krokoch
Historický denník. Niekoľko dní predtým bolo na tomto serveri potrebné vytvoriť veľký VPS s 128 GB RAM. Pamäte sa zdalo, že je dosť, ale pre istotu sme pridelili ďalších 32 GB pre swapový priestor. VPS bol vytvorený, úspešne splnil svoju úlohu a incident bol zabudnutý, ale SWAP priestor zostal.
Konfigurácia. Pre všetky servery cloudu bola hodnota parametra vm.swappiness nastavená na predvolené hodnoty 60. A SWAP bol vytvorený na SAS HDD RAID1.
Čo sa dialo (podľa redakcie). Pri zálohovaní DD vydávalo veľa údajov na zápis, ktoré sa ukladali do RAM bufferov pred zápisom do NFS. Jadro systému, riadiac sa politikou swappiness, presúvalo mnoho stránok pamäte VPS do oblasti swapovania, ktorá bola umiestnená na pomalom objeme HDD RAID1. To spôsobilo, že IOWAIT veľmi vzrástlo, ale nie kvôli IO NVMe, ale kvôli IO HDD RAID1.
Ako bola problém vyriešený. Bol odpojený 32 GB swapový priestor. To trvalo 16 hodín, ako a prečo sa SWAP vypína tak pomaly, sa dá prečítať samostatne. Boli zmenené parametre swappiness na hodnotu rovná 5 v celom cloude.
Ako by sa to mohlo staťPo prvé, keby bol SWAP na SSD RAID alebo NVMe zariadení, po druhé, keby neexistovalo NVMe zariadenie, ale bolo by tam pomalšie zariadenie, ktoré by nevydávalo taký objem dát — s iróniou, problém vznikol z toho, že NVMe je príliš rýchly.
Po tomto všetko fungovalo ako predtým — s nulovým IOWAIT.
Zdroj: habr.com
