

O vytvorení systému monitorovania sme uvažovali už v etape formovania produktových tímov. Stalo sa jasným, že náš úkol – prevádzka – sa do týchto tímov nijako nezapája. Prečo je to tak?
Ide o to, že všetky naše tímy sú postavené okolo jednotlivých informačných systémov, mikroslužieb a frontov, takže celkový zdravotný stav celej sústavy tím nie je schopný vidieť. Napríklad nemusia vedieť, ako určitá malá časť hlbokého backendu ovplyvňuje frontovú časť. Ich záujmy sú obmedzené na systémy, s ktorými je ich systém integrovaný. Ak je tím a jeho služba A takmer nijako nesúvisí so službou B, takáto služba je pre tím takmer neviditeľná.
Naša tím však, na druhej strane, pracuje so systémami, ktoré sú medzi sebou veľmi silno integrované: medzi nimi je množstvo spojení, ide o pomerne veľkú infraštruktúru. A od všetkých týchto systémov (ktorých máme, mimochodom, obrovské množstvo), závisí funkcia internetového obchodu.
A tak sa ukazuje, že naše oddelenie nepatrí do žiadneho tímu, ale nachádza sa trochu na okraji. V celej tejto súvislosti je našou úlohou chápať komplexne, ako fungujú informačné systémy, ich funkčnosť, integrácie, softvér, sieť, hardvér a ako všetko toto súvisí medzi sebou.
Platforma, na ktorej fungujú naše internetové obchody, vyzerá takto:
- front
- middle-office
- back-office
Ako veľmi by sme si to priali, nie je možné, aby všetky systémy fungovali hladko a bezchybne. Opäť ide o množstvo systémov a integrácií – pri takom množstve, ako máme, sú nejaké incidenty nevyhnutnosťou, napriek kvalite testovania. A to ako vo vnútri určitého systému, tak aj pokiaľ ide o ich integráciu. A je potrebné sledovať stav celej platformy komplexne, a nie len nejakú jej jednotlivú časť.
Ideálne by sledovanie stavu zdravia celej platformy malo byť automatizované. A k monitorovaniu sme dospeli ako k nevyhnutnej súčasti tohto procesu. Pôvodne bolo vybudované len pre frontovú časť, pričom vlastné systémy monitorovania po vrstvách mali a majú sieťoví administrátori, správcovia softvéru a hardvéru. Títo ľudia sledovali monitorovanie len na svojej úrovni, komplexné porozumenie nemal nikto.
Napríklad, ak zlyhá virtuálny stroj, v drvivej väčšine prípadov o tom vie len administrátor zodpovedný za hardware a virtuálny stroj. Frontend tím v takýchto prípadoch videl iba fakt zlyhania aplikácie, ale informácie o zlyhaní virtuálneho stroja nemal. Administrátor môže vedieť, kto je zákazník, a približne si predstavovať, čo presne teraz na tomto virtuálnom stroji beží, pokiaľ ide o nejaký veľký projekt. O malých projektoch pravdepodobne nevie. V každom prípade musí administrátor ísť za vlastníkom, pýtať sa, čo bolo na tomto stroji, čo treba obnoviť a čo zmeniť. A ak sa niečo vážne pokazilo, začala behúť po kruhu — pretože nikto nevidel systém celkovo.
V konečnom dôsledku tieto roztrhnuté príbehy ovplyvňujú celý frontend, používateľov a našu hlavnú obchodnú funkciu — internetový predaj. Keďže nie sme súčasťou tímov, ale zaoberáme sa prevádzkou všetkých ecommerce aplikácií ako súčasť internetového obchodu, vzali sme si na seba úlohu vytvoriť komplexný monitoring ecommerce platformy.
Štruktúra systému a stack
Začali sme tým, že sme vyčlenili niekoľko vrstiev monitorovania pre naše systémy, v rámci ktorých budeme potrebovať zbierať metriky. A to všetko bolo potrebné spojiť, čo sme spravili v prvej fáze. Teraz na tejto fáze dopracovávame čo najkvalitnejšie zbieranie metrik vo všetkých našich vrstvách, aby sme vytvorili koreláciu a porozumeli tomu, ako systémy ovplyvňujú jedna druhú.
Nedostatok komplexného monitorovania v počiatočných fázach spustenia aplikácií (pretože sme začali budovať monitoring, keď väčšina systémov bola už v prevádzke) viedol k tomu, že sme vytvorili značný technický dlh pri nastavení monitorovania celej platformy. Nemohli sme si dovoliť sústrediť sa na nastavenie monitorovania nejakej jednej IS a detailne ho spracovať pre ňu, pretože ostatné systémy by na nejaký čas zostali bez monitorovania. Na vyriešenie tejto úlohy sme určili zoznam najpotrebnejších metrik hodnotenia stavu informačného systému podľa vrstiev a začali sme ho zavádzať.
Preto sme sa rozhodli jesť slona po častiach.
Náš systém pozostáva z:
- hardware;
- operačného systému;
- software;
- UI prvky v aplikácii na monitorovanie;
- biznisové metriky;
- aplikácie integrácie;
- informačná bezpečnosť;
- sieť;
- vyvažovač záťaže.
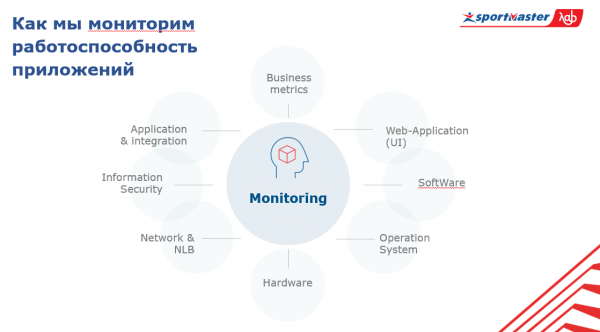
V centre tohto systému je samotné monitorovanie. Aby sme mohli všeobecne pochopiť stav celého systému, musíme vedieť, čo sa deje s aplikáciami na všetkých týchto vrstvách a v rámci množstva aplikácií.
Tak teda, o stacku.
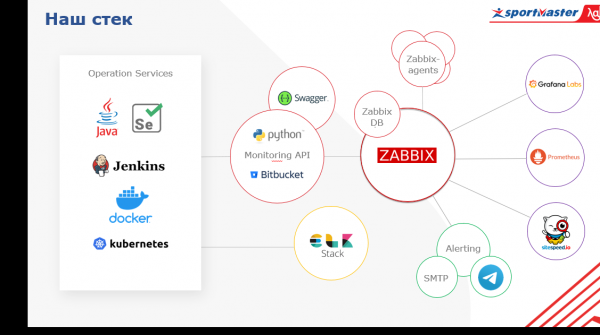
Používame softvér s otvoreným zdrojovým kódom. V centre máme Zabbix, ktorý používame predovšetkým ako systém alertovania. Je známe, že je ideálny na monitorovanie infraštruktúry. Čo týmto myslíme? Rovnako nízkoúrovňové metriky, ktoré má každá spoločnosť, ktorá má vlastné DCI (a Sportmaster má svoje DCI) — teplota servera, stav pamäte, RAID-u, metriky sieťových zariadení.
Integrovali sme Zabbix s messingerom Telegram a Microsoft Teams, ktoré sú aktívne používané v tímových prácach. Zabbix pokrýva vrstvu faktickej siete, hardvéru a čiastočne softvéru, ale to nie je panacea. Tieto dáta obohacujeme z niektorých ďalších služieb. Napríklad, na úrovni hardvéru sa priamo cez API pripájame v našom virtualizačnom systéme a získavame dáta.
Čo ďalšie. Okrem Zabbixu používame Prometheus, ktorý umožňuje monitorovať metriky v aplikácii dynamického prostredia. To znamená, že môžeme získavať metriky aplikácie cez HTTP endpoint a nemáme obavy o to, aké metriky do nej načítať a aké nie. Na základe týchto dát môžeme spracovávať analytické dopyty.
Zdroje dát pre ostatné vrstvy, napríklad biznisové metriky, sú u nás rozdelené na tri časti.
Po prvé, ide o externé biznisové systémy, Google Analytics, zbierame metriky z logov. Zozbierame dáta o aktívnych užívateľoch, konverziách a všetkom ostatnom, čo súvisí s biznisom. Po druhé, to je systém UI monitorovania. O ňom by sme mali podrobnejšie hovoriť.
Kedysi sme začínali s manuálnym testovaním a to prerástlo do automatických testov funkcionality a integrácií. Z toho sme vytvorili monitorovanie, ponechajúc iba základnú funkcionalitu a prepojili sme sa na markery, ktoré sú maximálne stabilné a zvyčajne sa časom nezmenia.
Nová štruktúra tímov predpokladá, že všetka činnosť v aplikáciách je uzavretá na produktových tímach, preto sa už čisto testovaniu nevenujeme. Namiesto toho sme testy transformovali na UI monitorovanie, ktoré je napísané v Jave, Selenium a Jenkins (používa sa ako systém spúšťania a generovania správ).
Mali sme veľa testov, ale nakoniec sme sa rozhodli prejsť na hlavnú cestu, na vyššiu úroveň metriky. A ak budeme mať mnoho špecifických testov, bude ťažké udržať aktuálnosť dát. Každé ďalšie vydanie by výrazne poškodilo celý systém, a my by sme sa len zaoberali jeho opravou. Preto sa zameriavame na úplne základné veci, ktoré sa zriedka menia, a monitorujeme len tie.
Nakoniec, tretím zdrojom dát je centralizovaný systém logovania. Na logy používame Elastic Stack, a následne tieto dáta môžeme načítať do nášho systému monitorovania cez obchodné metriky. Okrem toho funguje náš vlastný Monitoring API servis, napísaný v Pythone, ktorý prijíma dáta z akýchkoľvek služieb cez API a potom ich zasiela do Zabbix.
Ďalším neoceniteľným atribútom monitorovania je vizualizácia. U nás je postavená na základe Grafana. Medzi ostatnými systémami vizualizácie sa vyznačuje tým, že na dashboarde môžeme vizualizovať metriky z rôznych zdrojov dát. Môžeme zhromaždiť vrcholové metriky internetového obchodu, ako napríklad počet objednávok zachytených za poslednú hodinu, z DB, metriky výkonnosti OS, na ktorom beží tento internetový obchod, z Zabbix, a metriky inštancií tejto aplikácie - z Prometheus. A to všetko bude na jednom dashboarde. Prehľadne a dostupne.
Chcem poznamenať ohľadom zabezpečenia - aktuálne vylepšujeme systém, ktorý neskôr integrujeme s globálnym systémom monitorovania. Podľa môjho názoru sú hlavné problémy, ktorým čelí e-commerce v oblasti informačnej bezpečnosti, spojené s botmi, parsermi a brutálnym silovým útokom. Je potrebné to sledovať, pretože to môže kriticky ovplyvniť ako fungovanie našich aplikácií, tak aj reputáciu z pohľadu podnikania. A vybraným stackom tieto úlohy úspešne pokrývame.
Ešte dôležitý bod — úroveň aplikácií zbiera Prometheus. Ten je u nás tiež integrovaný so Zabbixom. A máme tiež sitespeed, službu, ktorá nám umožňuje sledovať také parametre ako rýchlosť načítania našej stránky, bottlenecky, vykreslenie stránky, načítanie skriptov a podobne, táto služba je tiež integrovaná cez API. Takže metriky sa u nás zbierajú v Zabbixe, a alerty tiež posielame odtiaľ. Všetky alerty zatiaľ idú na hlavné spôsoby posielania (začiatkom sú to e-mail a telegram, nedávno sme pridali aj MS Teams). V pláne máme vylepšiť alerting do takého stavu, aby inteligentní boti fungovali ako služba a poskytovali informácie o monitoringu všetkým produktovým tímom, ktorí o to majú záujem.
Pre nás sú dôležité metriky nielen jednotlivých informačných systémov, ale aj celkové metriky celej infraštruktúry, ktorú aplikácie používajú: klastre fyzických serverov, na ktorých bežia virtuálne stroje, záťažové vyrovnávače, Network Load Balancer-y, samotná sieť a využitie komunikačných kanálov. Plus metriky pre naše vlastné dátové centrá (máme ich niekoľko a infraštruktúra je pomerne významných rozmerov).
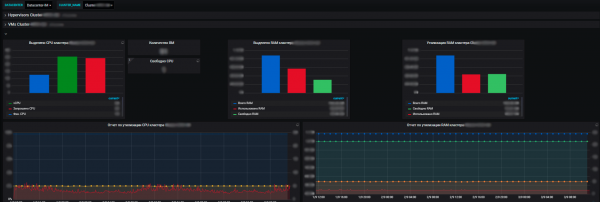
Výhody nášho monitorovacieho systému spočívajú v tom, že pomocou neho vidíme stav funkčnosti všetkých systémov, môžeme posúdiť ich vzájomný vplyv a vplyv na spoločné zdroje. A v konečnom dôsledku nám to umožňuje plánovať zdroje, čo tiež patrí do našich zodpovedností. Spravujeme serverové zdroje — pool v rámci e-commerce, uvádzame do prevádzky nové vybavenie, nakupujeme nové, vykonávame audit využívania zdrojov a ďalšie. Každý rok tímy plánujú nové projekty, rozvíjajú svoje systémy a pre nás je dôležité zabezpečiť im zdroje.
A pomocou metrik vidíme trend spotrebovania zdrojov našimi informačnými systémami. A už na ich základe môžeme niečo plánovať. Na úrovni virtualizácie zbierame dáta a vidíme informácie o dostupnom počte zdrojov v rámci dátových centier. A už vo vnútri dátového centra sú viditeľné aj využitie a skutočné rozdelenie, spotreba zdrojov. A to ako na standalone serveroch, tak aj na virtuálnych strojoch a klastroch fyzických serverov, na ktorých všetky tieto virtuálne stroje bez problémov bežia.
Vyhliadky
Teraz máme celkovú kostru systému hotovú, ale stále zostáva dosť bodov, na ktorých je ešte potrebné pracovať. Minimálne ide o úroveň informačnej bezpečnosti, ale je tiež dôležité dostať sa do siete, rozvinúť alertovanie a vyriešiť otázku korelácie. Úrovní a systémov máme mnoho, na každej úrovni je ešte množstvo metrik. Vzniká tak matrjoška v stupni matrjošky.
Našou úlohou je v konečnom dôsledku vytvoriť správne alerty. Napríklad, ak dôjde k problému s hardvérom, opäť s virtuálnym strojom, a tam bola dôležitá aplikácia, a služba nebola nijako zálohovaná. Zistíme, že virtuálny stroj zlyhal. Potom budú alarmovať obchodné metriky: používatelia niekam zmizli, nie sú konverzie, UI v rozhraní nie je dostupné, softvér a služby tiež zlyhali.
Pri takejto situácii dostaneme spam z alertov, a to už sa nezapadá do formátu správneho monitorovacieho systému. Objavuje sa otázka korelácie. Preto v ideálnom prípade by náš monitorovací systém mal povedať: "Chlapci, vaša fyzická mašina zlyhala, a spolu s ňou táto aplikácia a takéto metriky," pomocou jedného alertu, namiesto toho, aby nás zasypal stovkou alertov. Mal by informovať o hlavnom — o príčine, čo napomáha rýchlemu vyriešeniu problému prostredníctvom jeho lokalizácie.
Náš systém notifikácií a spracovania alertov je postavený okolo 24-hodinovej horúcej línie. Všetky alerty, ktoré považujeme za nevyhnutné a sú súčasťou kontrolného zoznamu, sú tam posielané. Každý alert by mal nevyhnutne mať popis: čo sa stalo, čo to vlastne znamená, na čo to vplýva. A tiež odkaz na dashboard a pokyny, čo v takom prípade treba robiť.
To je všetko, čo sa týka požiadaviek na budovanie alertovania. Situácia sa môže vyvíjať dvoma smermi — buď problém existuje a je potrebné ho riešiť, alebo došlo k zlyhaniu monitorovacieho systému. Ale v každom prípade je potrebné ísť a zaoberať sa tým.
Priemerne v súčasnosti za deň dostávame asi sto alertov, a to s ohľadom na to, že korelácia alertov ešte nie je správne nastavená. A ak je potrebné vykonať technické práce a niečo nútene odpojíme, ich počet narastá niekoľkonásobne.
Okrem monitorovania systémov, ktoré prevádzkujeme, a zhromažďovania metrik, ktoré považujeme za dôležité, systém monitorovania umožňuje zberať dáta pre produktové tímy. Tí môžu ovplyvniť zostavenie metrik v rámci informačných systémov, ktoré sa u nás monitorujú.
Náš kolega môže prísť a požiadať, aby sme pridali nejakú metriku, ktorá sa ukáže ako užitočná pre nás aj pre tím. Alebo napríklad tímu môže chýbať tých základných metrík, ktoré máme k dispozícii, a potrebujú sledovať niečo špecifické. V Grafane vytvárame priestor pre každý tím a poskytujeme im administrátorské práva. Taktiež, ak tím potrebuje dashboardy a sami to nevedia urobiť, pomáhame im.
Keďže nie sme súčasťou toku tvorby hodnoty tímu, ich vydaní a plánovania, postupne prechádzame k tomu, že vydania všetkých systémov sú bezproblémové a je možné ich uvoľňovať denne bez súhlasu s nami. A pre nás je dôležité sledovať tieto vydania, pretože potenciálne môžu ovplyvniť výkon aplikácie a niečo pokaziť, čo je kritické. Na správu vydaní používame Bamboo, odkiaľ prostredníctvom API získavame dáta a môžeme vidieť, ktoré vydania v ktorých informačných systémoch boli vydané a ich stav. A najdôležitejšie — v ktorom čase. Marker na vydania aplikujeme na hlavné kritické metriky, čo vizuálne pôsobí veľmi výstižne v prípade problémov.
Takto môžeme vidieť koreláciu medzi novými vydaniami a vznikajúcimi problémami. Hlavná myšlienka je porozumieť, ako systém funguje na všetkých úrovniach, rýchlo lokalizovať problém a takisto ho rýchlo opraviť. Veď často trvá najviac času nie samotné riešenie problému, ale hľadanie jeho príčiny.
A v tejto oblasti sa v budúcnosti chceme zamerať na proaktivitu. Ideálne by bolo vopred vedieť o nadchádzajúcom probléme, nie až ex post, aby sme sa mohli zaoberať jeho predchádzaním, nie riešením. Niekedy dochádza k falošným poplachom monitorovacieho systému, či už z dôvodu ľudskej chyby alebo zmien v aplikácii. Pracujeme na tom, vylepšujeme ho a snažíme sa pred akýmikoľvek manipuláciami so systémom monitorovania varovať používateľov, ktorí ho používajú spolu s nami, alebo vykonávať tieto aktivity v technickom okne.
Takže systém je spustený a úspešne funguje od začiatku jari... a ukazuje celkom reálny zisk. Samozrejme, toto nie je jeho finálna verzia, budeme zavádzať ešte množstvo užitočných funkcií. Ale práve teraz, pri takom veľkom množstve integrácií a aplikácií, sa bez automatizácie monitorovania naozaj nezaobídeme.
Ak tiež monitorujete veľké projekty s vážnym množstvom integrácií — napíšte do komentárov, akú striebornú guľu ste na to našli.
Zdroj: habr.com
