

Ahoj, Habr!
Pripomíname, že po knihe o sme vydali nemenej zaujímavú prácu o knižnici .
Kým komunita si iba osvojuje hranice možností tohto mocného nástroja. Nedávno bola vydaná článok, s ktorou sa vám chceme oboznámiť. Na vlastnej skúsenosti autor rozpráva, ako spraviť z Kafka Streams distribuované úložisko dát. Príjemné čítanie!
Knižnica Apache sa po celom svete používa v podnikoch na distribuované streamové spracovanie nad Apache Kafka. Jedným z prehliadaných aspektov tohto rámca je to, že umožňuje uchovávať lokálny stav generovaný na základe streamového spracovania.
V tomto článku poviem, ako sa našej spoločnosti podarilo výhodne využiť túto možnosť pri vývoji produktu na bezpečnosť cloudových aplikácií. Pomocou Kafka Streams sme vytvorili mikroservisy so zdieľaným stavom, z ktorých každý slúži ako nám odolný a vysoko dostupný zdroj dôveryhodných informácií o stave objektov v systéme. Pre nás je to krok vpred v oblasti spoľahlivosti aj v pohodlí podpory.
Ak vás zaujíma alternatívny prístup, ktorý umožňuje používať jednu centrálnu databázu na podporu formálneho stavu vašich objektov – prečítajte si, bude to zaujímavé…
Prečo sme považovali, že nastal čas zmeniť naše prístupy k práci so zdieľaným stavom
Potrebovali sme udržiavať stav rôznych objektov, spoliehajúc sa na správy agentov (napríklad: bol web napadnutý?). Pred prechodom na Kafka Streams sme sa často spoliehali na riadenie stavu prostredníctvom jednej centrálnej databázy (+ servisného API). Tento prístup má svoje nevýhody: v udržanie konzistencie a synchronizácie sa stáva skutočnou výzvou. Databáza sa môže stať úzkym miestom alebo sa nachádzať v a trpieť nepravidelnosťami.
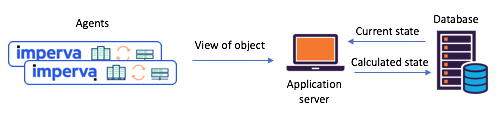
Ilustrácia 1: typický scenár s delením stavu, ktorý sa vyskytoval pred prechodom na
Kafku a Kafka Streams: agenti oznamujú svoje predpoklady cez API, aktualizovaný stav sa vypočítava cez centrálnu databázu
Predstavujeme Kafka Streams – teraz je jednoduché vytvárať mikroservisy so zdieľaným stavom
Približne pred rokom sme sa rozhodli dôkladne preskúmať naše scenáre práce so zdieľaným stavom, aby sme sa vyrovnali s niektorými problémami. Hneď sme sa rozhodli vyskúšať Kafka Streams – je známo, aký je škálovateľný, vysoko dostupný a odolný, a aké bohaté funkcie streamovania má (vrátane transformácií so zachovaním stavu). Presne to, čo sme potrebovali, nehovoriac o tom, ako zrelý a spoľahlivý systém výmeny správ je v Kafka.
Každý z našich vytvorených mikroservisov so zdieľaným stavom bol postavený na inštancii Kafka Streams s celkom jednoduchou topológiou. Skladala sa z 1) zdroja 2) procesora s trvalým úložiskom kľúčov a hodnôt 3) odtoku:
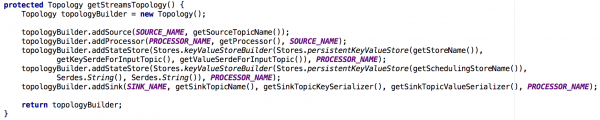
Obrázok 2: prednastavená topológia našich streamových inštancií pre mikroservisy so zdieľaným stavom. Upozorňujeme: tu je tiež úložisko, ktoré obsahuje metaúdaje o plánovaní.
Pri tomto novom prístupe agenti zostavujú správy, ktoré sa posielajú do zdrojového topiku, a spotrebitelia – povedzme, služba e-mailových oznámení – prijímajú vypočítaný zdieľaný stav cez odtok (výstupný topik).
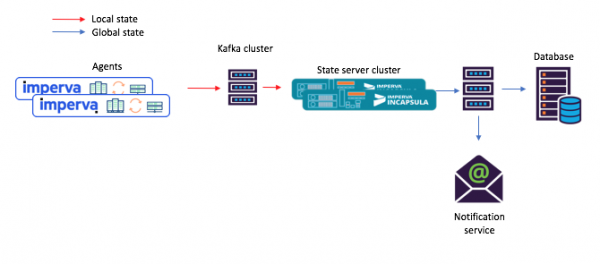
Obrázok 3: nový príklad toku úloh pre scenár so zdieľanými mikroservismi: 1) agent generuje správu, ktorá prichádza do zdrojového topika Kafka; 2) mikroservis so zdieľaným stavom (používajúci Kafka Streams) ju spracováva a zapisuje vypočítaný stav do konečného topika Kafka; po čom 3) spotrebitelia prijímajú nový stav
Hej, toto zabudované úložisko kľúčov a hodnôt je naozaj veľmi užitočné!
Ako sme spomenuli vyššie, naša topológia so zdieľaným stavom obsahuje úložisko kľúčov a hodnôt. Našli sme niekoľko spôsobov jeho využitia, a dva z nich sú popísané nižšie.
Možnosť #1: využitie úložiska kľúčov a hodnôt pri výpočtoch
Naš prvý ukladací priestor pre kľúče a hodnoty obsahoval pomocné údaje, ktoré sme potrebovali pre výpočty. Napríklad v niektorých prípadoch bolo zdieľané stavy definované na základe princípu „väčšiny hlasov“. V úložisku sa mohli uchovávať všetky najnovšie správy agentov o stave určitého objektu. Potom, keď sme dostali novú správu od jedného alebo druhého agenta, mohli sme ju uložiť, extrahovať zo skladu správy všetkých ostatných agentov o stave toho istého objektu a zopakovať výpočty.
Nižšie na ilustrácii 4 je zobrazené, ako sme otvorili prístup k úložisku kľúčov a hodnôt spracovávajúcej metóde procesora, takže bolo možné spracovať novú správu.
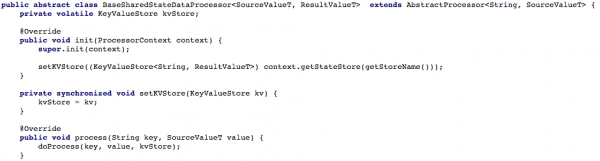
Ilustrácia 4: Otvárame prístup k úložisku kľúčov a hodnôt pre spracovávajúcu metódu procesora (po tomto je v každom scenári pracujúcom so zdieľaným stavom potrebné implementovať metódu doProcess)
Možnosť #2: Vytvorenie CRUD API nad Kafka Streams
Po nastavení nášho základného toku úloh sme sa pokúsili napísať RESTful CRUD API pre naše mikroslužby so zdieľaným stavom. Chceli sme, aby bolo možné extrahovať stav niektorých alebo všetkých objektov, ako aj nastavovať alebo odstraňovať stav objektu (to je užitočné pri podpore serverovej časti).
Na podporu všetkých API Get State, zakaždým, keď sme potrebovali znovu vypočítať stav pri spracovaní, sme ho na dlhú dobu ukladali do zabudovaného ukladacieho priestoru kľúčov a hodnôt. V takom prípade je dosť jednoduché implementovať také API pomocou jediného inštancie Kafka Streams, ako je uvedené v nasledujúcom zozname:
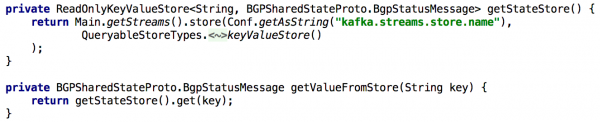
Ilustrácia 5: Použitie zabudovaného ukladacieho priestoru kľúčov a hodnôt na získanie predpočítaného stavu objektu
Aktualizácia stavu objektu cez API nie je taktiež zložitá. V podstate je na to potrebné len vytvoriť producenta Kafka, a pomocou neho vykonať zápis, v ktorom je zahrnutý nový stav. To zabezpečí, že všetky správy generované prostredníctvom API budú spracovávané presne tak, ako správy od iných producentov (napr. agentov).
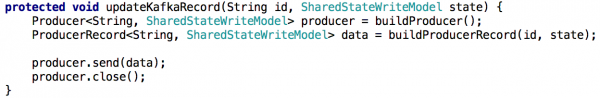
Ilustrácia 6: Stav objektu sa dá nastaviť pomocou producenta Kafka
Malé komplikácie: Kafka má mnoho partií
Naším cieľom bolo rozložiť zaťaženie súvisiace s spracovaním a zlepšiť dostupnosť poskytnutím klastru mikroslužieb so zdieľaným stavom pre každý scenár. Nastavenie bolo veľmi jednoduché: po tom, čo sme nakonfigurovali všetky inštancie tak, aby pracovali so rovnakým ID aplikácie (a s rovnakými servermi na spustenie), prakticky všetko ostatné sa vykonalo automaticky. Taktiež sme určili, že každý vstupný topic bude pozostávať z niekoľkých partícií, aby mohol byť každej inštancii priradený podmnožina týchto partícií.
Rovnako spomeniem, že je tu bežné robiť zálohu úložiska stavov, aby v prípade obnovy po zlyhaní sme mohli preniesť túto kópiu na inú inštanciu. Na každé úložisko stavov v Kafka Streams sa vytvára replikovaný topic s logom zmien (v ktorom sú sledované miestne aktualizácie). Takže Kafka neustále poistuje úložisko stavov. Preto v prípade zlyhania jednej alebo druhej inštancie možno stavy úložiska Kafka Streams rýchlo obnoviť na inej inštancii, kde budú prenesené príslušné partície. Naše testy ukázali, že to trvá len niekoľko sekúnd, aj keď je v úložisku milióny záznamov.
Prechod od jednej mikroslužby so zdieľaným stavom na klaster mikroslužieb nie je tak triviálny, pokiaľ ide o realizáciu Get State API. V novej situácii obsahuje úložisko stavov každej mikroslužby iba časť celkového obrazu (tých objektov, ktorých kľúče boli mapované na konkrétnu partíciu). Museli sme zistiť, na ktorej inštancii sa nachádzal stav požadovaného objektu, a to sme robili na základe metadát prúdov, ako je znázornené nižšie:
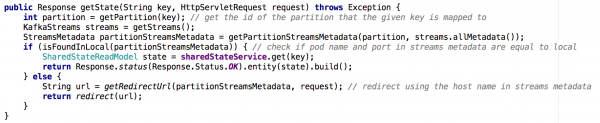
Ilustrácia 7: pomocou metadát prúdov určujeme, z ktorej inštancie žiadať stav požadovaného objektu; podobný prístup bol použitý s GET ALL API
Hlavné zistenia
Úložiská stavov v Kafka Streams de facto môžu slúžiť ako distribuovaná databáza,
- neustále replikovaná v Kafka
- Nad takýmto systémom sa ľahko buduje CRUD API
- Spracovanie viacerých partícií je o niečo zložitejšie
- Je možné pridať jedno alebo viac skladových miest do streamovacej topológie na uchovávanie pomocných údajov. Takáto možnosť môže byť použitá na:
- Dlhodobé uchovávanie údajov potrebných na výpočty pri streamovacom spracovaní
- Dlhodobé uchovávanie údajov, ktoré môžu byť užitočné pri nasledujúcej inicializácii streamovej inštancie
- mnohých ďalších…
Vďaka týmto a ďalším výhodám je Kafka Streams vynikajúca na podporu globálneho stavu v takej distribuovanej sieti, ako je tá naša. Kafka Streams sa ukázala byť veľmi spoľahlivá v produkcii (od momentu jej nasadenia sme prakticky nestratili správy) a sme presvedčený, že jej možnosti tu nekončia!
Zdroj: habr.com
