

Úvod
Často sa používatelia, vývojári a administrátori databázových systémov MS SQL Server stretávajú s problémami s výkonom databáz alebo samotného DBMS, a preto je monitorovanie MS SQL Serveru veľmi aktuálne.
Tento článok dopĺňa článok a v ňom budú prebrané niektoré aspekty monitorovania MS SQL Serveru, konkrétne: ako rýchlo určiť, aké zdroje chýbajú, ako aj odporúčania na nastavenie trasovacích praporkov.
Na spustenie nasledujúcich skriptov je potrebné vytvoriť schému inf v požadovanej databáze nasledovne:
Vytvorenie schémy inf
use ;
go
create schema inf;
Metóda zisťovania nedostatku operačnej pamäte
Prvým ukazovateľom nedostatku operačnej pamäte je situácia, keď inštancia MS SQL Serveru využíva celú pridelenú RAM.
Na to vytvoríme nasledujúci pohľad inf.vRAM:
Vytvorenie pohľadu inf.vRAM
CREATE view [inf].[vRAM] as
select a.[TotalAvailOSRam_Mb]						--koľko voľnej RAM na serveri v MB
		 , a.[RAM_Avail_Percent]					--percento voľnej RAM na serveri
		 , a.[Server_physical_memory_Mb]				--koľko celkovej RAM na serveri v MB
		 , a.[SQL_server_committed_target_Mb]			--koľko celkovej RAM je pridelené pre MS SQL Server v MB
		 , a.[SQL_server_physical_memory_in_use_Mb] 		--koľko celkovej RAM využíva MS SQL Server v danom okamihu v MB
		 , a.[SQL_RAM_Avail_Percent]				--percento voľnej RAM pre MS SQL Server vzhľadom na celkovú pridelenú RAM pre MS SQL Server
		 , a.[StateMemorySQL]						--je dostatok RAM pre MS SQL Server
		 , a.[SQL_RAM_Reserve_Percent]				--percento pridelené RAM pre MS SQL Server v porovnaní so všetkou RAM servera
		 --je dostatok RAM pre server
		, (case when a.[RAM_Avail_Percent]5 and a.[TotalAvailOSRam_Mb]<8192 then 'Warning' when a.[RAM_Avail_Percent]<=5 and a.[TotalAvailOSRam_Mb]<2048 then 'Danger' else 'Normal' end) as [StateMemoryServer]
	from
	(
		select cast(a0.available_physical_memory_kb/1024.0 as int) as TotalAvailOSRam_Mb
			 , cast((a0.available_physical_memory_kb/casT(a0.total_physical_memory_kb as float))*100 as numeric(5,2)) as [RAM_Avail_Percent]
			 , a0.system_low_memory_signal_state
			 , ceiling(b.physical_memory_kb/1024.0) as [Server_physical_memory_Mb]
			 , ceiling(b.committed_target_kb/1024.0) as [SQL_server_committed_target_Mb]
			 , ceiling(a.physical_memory_in_use_kb/1024.0) as [SQL_server_physical_memory_in_use_Mb]
			 , cast(((b.committed_target_kb-a.physical_memory_in_use_kb)/casT(b.committed_target_kb as float))*100 as numeric(5,2)) as [SQL_RAM_Avail_Percent]
			 , cast((b.committed_target_kb/casT(a0.total_physical_memory_kb as float))*100 as numeric(5,2)) as [SQL_RAM_Reserve_Percent]
			 , (case when (ceiling(b.committed_target_kb/1024.0)-1024)<ceiling(a.physical_memory_in_use_kb/1024.0) then 'Warning' else 'Normal' end) as [StateMemorySQL]
		from sys.dm_os_sys_memory as a0
		cross join sys.dm_os_process_memory as a
		cross join sys.dm_os_sys_info as b
		cross join sys.dm_os_sys_memory as v
	) as a;
Potom je možné určiť, že inštancia MS SQL Server spotrebúva celú pridelenú pamäť prostredníctvom nasledujúceho dopytu:
select SQL_server_physical_memory_in_use_Mb, SQL_server_committed_target_Mb
from [inf].[vRAM];
Ak je hodnota SQL_server_physical_memory_in_use_Mb neustále menej ako SQL_server_committed_target_Mb, je potrebné skontrolovať štatistiku čakania.
Na určenie nedostatku operačnej pamäte prostredníctvom štatistiky čakania vytvoríme zobrazenie inf.vWaits:
Vytvorenie zobrazenia inf.vWaits
VYTVORI view [inf].[vWaits] ako
WITH [Waits] AS
    (VYBER
        [wait_type], -- názov typu čakania
        [wait_time_ms] / 1000.0 AS [WaitS], -- Celkový čas čakania tohto typu v milisekundách. Tento čas zahŕňa signal_wait_time_ms
        ([wait_time_ms] - [signal_wait_time_ms]) / 1000.0 AS [ResourceS], -- Celkový čas čakania tohto typu v milisekundách bez signal_wait_time_ms
        [signal_wait_time_ms] / 1000.0 AS [SignalS], -- Rozdiel medzi časom signálovania čakajúceho vlákna a časom jeho začiatku vykonávania
        [waiting_tasks_count] AS [WaitCount], -- Počet čakateľných úloh tohto typu. Tento počet sa zvyšuje zakaždým, keď začne čakanie
        100.0 * [wait_time_ms] / SUM ([wait_time_ms]) OVER() AS [Percentage],
        ROW_NUMBER() OVER(ORDER BY [wait_time_ms] DESC) AS [RowNum]
    Z sys.dm_os_wait_stats
    KDE [waiting_tasks_count] > 0
		a [wait_type] NIE JE V (
        N'BROKER_EVENTHANDLER',         N'BROKER_RECEIVE_WAITFOR',
        N'BROKER_TASK_STOP',            N'BROKER_TO_FLUSH',
        N'BROKER_TRANSMITTER',          N'CHECKPOINT_QUEUE',
        N'CHKPT',                       N'CLR_AUTO_EVENT',
        N'CLR_MANUAL_EVENT',            N'CLR_SEMAPHORE',
        N'DBMIRROR_DBM_EVENT',          N'DBMIRROR_EVENTS_QUEUE',
        N'DBMIRROR_WORKER_QUEUE',       N'DBMIRRORING_CMD',
        N'DIRTY_PAGE_POLL',             N'DISPATCHER_QUEUE_SEMAPHORE',
        N'EXECSYNC',                    N'FSAGENT',
        N'FT_IFTS_SCHEDULER_IDLE_WAIT', N'FT_IFTSHC_MUTEX',
        N'HADR_CLUSAPI_CALL',           N'HADR_FILESTREAM_IOMGR_IOCOMPLETION',
        N'HADR_LOGCAPTURE_WAIT',        N'HADR_NOTIFICATION_DEQUEUE',
        N'HADR_TIMER_TASK',             N'HADR_WORK_QUEUE',
        N'KSOURCE_WAKEUP',              N'LAZYWRITER_SLEEP',
        N'LOGMGR_QUEUE',                N'ONDEMAND_TASK_QUEUE',
        N'PWAIT_ALL_COMPONENTS_INITIALIZED',
        N'QDS_PERSIST_TASK_MAIN_LOOP_SLEEP',
        N'QDS_CLEANUP_STALE_QUERIES_TASK_MAIN_LOOP_SLEEP',
        N'REQUEST_FOR_DEADLOCK_SEARCH', N'RESOURCE_QUEUE',
        N'SERVER_IDLE_CHECK',           N'SLEEP_BPOOL_FLUSH',
        N'SLEEP_DBSTARTUP',             N'SLEEP_DCOMSTARTUP',
        N'SLEEP_MASTERDBREADY',         N'SLEEP_MASTERMDREADY',
        N'SLEEP_MASTERUPGRADED',        N'SLEEP_MSDBSTARTUP',
        N'SLEEP_SYSTEMTASK',            N'SLEEP_TASK',
        N'SLEEP_TEMPDBSTARTUP',         N'SNI_HTTP_ACCEPT',
        N'SP_SERVER_DIAGNOSTICS_SLEEP', N'SQLTRACE_BUFFER_FLUSH',
        N'SQLTRACE_INCREMENTAL_FLUSH_SLEEP',
        N'SQLTRACE_WAIT_ENTRIES',       N'WAIT_FOR_RESULTS',
        N'WAITFOR',                     N'WAITFOR_TASKSHUTDOWN',
        N'WAIT_XTP_HOST_WAIT',          N'WAIT_XTP_OFFLINE_CKPT_NEW_LOG',
        N'WAIT_XTP_CKPT_CLOSE',         N'XE_DISPATCHER_JOIN',
        N'XE_DISPATCHER_WAIT',          N'XE_TIMER_EVENT')
    )
, ress as (
	VYBER
	    [W1].[wait_type] AS [WaitType],
	    CAST ([W1].[WaitS] AS DECIMAL (16, 2)) AS [Wait_S], -- Celkový čas čakania tohto typu v milisekundách. Tento čas zahŕňa signal_wait_time_ms
	    CAST ([W1].[ResourceS] AS DECIMAL (16, 2)) AS [Resource_S], -- Celkový čas čakania tohto typu v milisekundách bez signal_wait_time_ms
	    CAST ([W1].[SignalS] AS DECIMAL (16, 2)) AS [Signal_S], -- Rozdiel medzi časom signálovania čakajúceho vlákna a časom jeho začiatku vykonávania
	    [W1].[WaitCount] AS [WaitCount], -- Počet čakateľných úloh tohto typu. Tento počet sa zvyšuje zakaždým, keď začne čakanie
	    CAST ([W1].[Percentage] AS DECIMAL (5, 2)) AS [Percentage],
	    CAST (([W1].[WaitS] / [W1].[WaitCount]) AS DECIMAL (16, 4)) AS [AvgWait_S],
	    CAST (([W1].[ResourceS] / [W1].[WaitCount]) AS DECIMAL (16, 4)) AS [AvgRes_S],
	    CAST (([W1].[SignalS] / [W1].[WaitCount]) AS DECIMAL (16, 4)) AS [AvgSig_S]
	Z [Waits] AS [W1]
	INNER JOIN [Waits] AS [W2]
	    ON [W2].[RowNum] <= [W1].[RowNum]
	GROUP BY [W1].[RowNum], [W1].[wait_type], [W1].[WaitS],
	    [W1].[ResourceS], [W1].[SignalS], [W1].[WaitCount], [W1].[Percentage]
	HAVING SUM ([W2].[Percentage]) - [W1].[Percentage] < 95 -- percentuálny prah
)
VYBER [WaitType]
      ,MAX([Wait_S]) AS [Wait_S]
      ,MAX([Resource_S]) AS [Resource_S]
      ,MAX([Signal_S]) AS [Signal_S]
      ,MAX([WaitCount]) AS [WaitCount]
      ,MAX([Percentage]) AS [Percentage]
      ,MAX([AvgWait_S]) AS [AvgWait_S]
      ,MAX([AvgRes_S]) AS [AvgRes_S]
      ,MAX([AvgSig_S]) AS [AvgSig_S]
  Z ress
  GROUP BY [WaitType];
V tomto prípade je možné nedostatok operačnej pamäte určiť nasledujúcim dotazom:
SELECT [Percentage]
      ,[AvgWait_S]
  FROM [inf].[vWaits]
  where [WaitType] in (
    'PAGEIOLATCH_XX',
    'RESOURCE_SEMAPHORE',
    'RESOURCE_SEMAPHORE_QUERY_COMPILE'
  );
Tu je potrebné venovať pozornosť ukazovateľom Percentage a AvgWait_S. Ak sú ich súhrnné hodnoty podstatné, veľmi pravdepodobne je nedostatok operačnej pamäte pre inštanciu MS SQL Server. Podstatné hodnoty sú stanovené individuálne pre každý systém. Avšak môžete začať s nasledujúcim ukazovateľom: Percentage>=1 a AvgWait_S>=0.005.
Na výstup ukazovateľov do monitorovacieho systému (napr. Zabbix) je možné vytvoriť nasledujúce dva dotazy:
- koľko percentuálne zaťažujú typy čakaní pamäť (súčet všetkých takýchto typov čakaní):
select coalesce(sum([Percentage]), 0.00) as [Percentage] from [inf].[vWaits] where [WaitType] in ( 'PAGEIOLATCH_XX', 'RESOURCE_SEMAPHORE', 'RESOURCE_SEMAPHORE_QUERY_COMPILE' ); - koľko milisekúnd zaberajú typy čakaní pamäť (maximálna hodnota zo všetkých priemerných zdržaní pre všetky takéto typy čakaní):
select coalesce(max([AvgWait_S])*1000, 0.00) as [AvgWait_MS]
from [inf].[vWaits]
       where [WaitType] in (
           'PAGEIOLATCH_XX',
           'RESOURCE_SEMAPHORE',
            'RESOURCE_SEMAPHORE_QUERY_COMPILE'
  );
Na základe dynamiky získaných hodnôt týchto dvoch ukazovateľov je možné vyvodiť záver, či je operačná pamäť dostatočná pre inštanciu MS SQL Server.
Metóda na identifikáciu nadmerného zaťaženia CPU
Na zistenie nedostatku procesorového času stačí využiť systémový pohľad sys.dm_os_schedulers. Tu, ak je ukazovateľ runnable_tasks_count neustále väčší ako 1, existuje veľká pravdepodobnosť, že počet jadier nie je dostatočný pre inštanciu MS SQL Server.
Na výstup ukazovateľa do monitorovacieho systému (napr. Zabbix) je možné vytvoriť nasledujúci dotaz:
select max([runnable_tasks_count]) as [runnable_tasks_count]
from sys.dm_os_schedulers
where scheduler_id<255;
Na základe dynamiky získaných hodnôt tohto ukazovateľa je možné vyvodiť záver, či je procesorový čas (počet jadier CPU) dostatočný pre inštanciu MS SQL Server.
Je dôležité si uvedomiť, že samotné dopyty môžu požadovať súčasne niekoľko vlákien. A niekedy optimalizátor nemôže správne vyhodnotiť zložitost samotného dopytu. Vtedy môže byť dopytu pridelené príliš veľa vlákien, ktoré v danom okamihu nemôžu byť spracované súčasne. To tiež spôsobuje typ čakania spojený s nedostatkom procesorového času a rastom radu pre plánovače, ktoré používajú konkrétne jadrá CPU, takže ukazovateľ runnable_tasks_count v takých podmienkach bude rásť.
V takom prípade, predtým ako zvýšite počet CPU jadier, je potrebné správne nastaviť vlastnosti paralelizmu samotného inštancie MS SQL Server a od verzie 2016 správne nastaviť vlastnosti paralelizmu potrebných databáz:
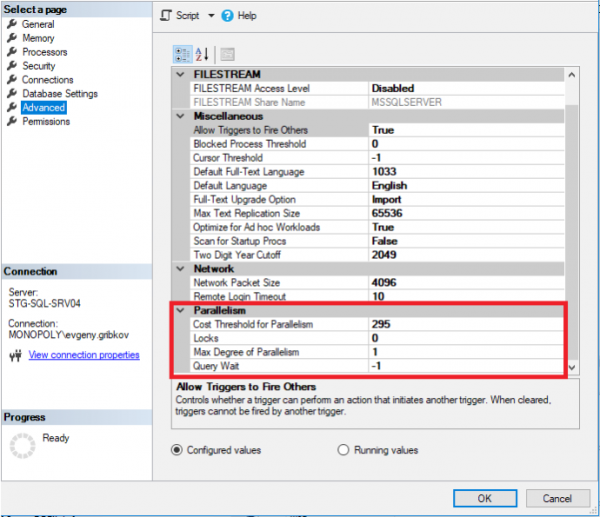
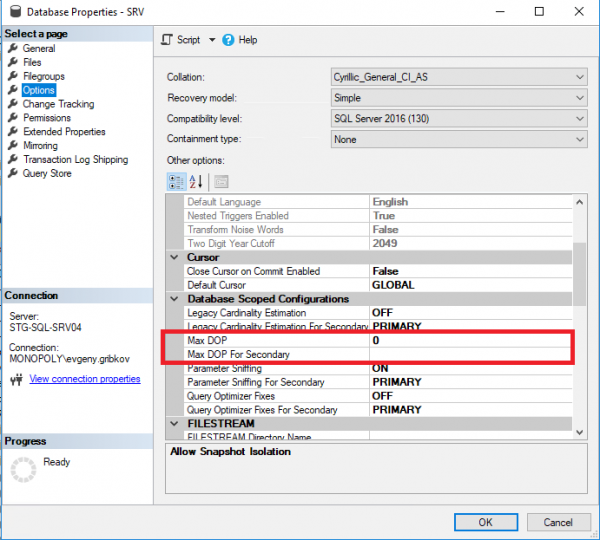
Tu treba venovať pozornosť nasledujúcim parametrom:
- Max Degree of Parallelism – určuje maximálny počet vlákien, ktoré môžu byť pridelené každému dopytu (predvolenie je 0 - obmedzenie len samotným operačným systémom a edíciou MS SQL Server)
- Cost Threshold for Parallelism – odhadovaná cena paralelizmu (predvolenie je 5)
- Max DOP – určuje maximálny počet vlákien, ktoré môžu byť pridelené každému dopytu na úrovni databázy (ale nie viac, než je hodnota vlastnosti „Max Degree of Parallelism“) (predvolenie je 0 - obmedzenie len samotným operačným systémom a edíciou MS SQL Server, ako aj obmedzenie podľa vlastnosti „Max Degree of Parallelism“ celej inštancie MS SQL Server)
Tu nie je možné poskytnúť rovnaký dobrý recept pre všetky prípady, tj. treba analyzovať ťažké dopyty.
Na základe vlastných skúseností odporúčam nasledujúci postup pre OLTP systémy na nastavenie vlastností paralelizmu:
- najprv zakázať paralelizmus, nastavením Max Degree of Parallelism na 1 na úrovni celej inštancie
- analyzovať najťažšie dopyty a získať pre nich optimálny počet vlákien
- nastaviť Max Degree of Parallelism na optimálny počet vlákien získaný z bodu 2, ako aj pre konkrétne databázy nastaviť hodnotu Max DOP získanú z bodu 2 pre každú databázu
- analyzovať najťažšie dopyty a identifikovať negatívny efekt z multi-threadingu. Ak existuje, zvýšiť Cost Threshold for Parallelism.
Pre také systémy ako 1C, Microsoft CRM a Microsoft NAV väčšinou vyhovuje zákaz multi-threadingu.
Ak je nainštalovaná edícia Standard, obvykle postačuje obmedzenie viacerých vlákien, vzhľadom na to, že táto edícia je obmedzená počtom jadier CPU.
Pre OLAP systémy nie je vyššie opísaný algoritmus vhodný.
Na základe vlastných skúseností odporúčam nasledujúci postup pri nastavovaní vlastností paralelizmu pre OLAP systémy:
- analyzovať najťažšie dopyty a získať pre nich optimálny počet vlákien
- nastaviť Max Degree of Parallelism na optimalizovaný počet vlákien, ktorý bol určený v bode 1, a tiež pre konkrétne databázy stanoviť hodnotu Max DOP, určenú v bode 1 pre každú databázu.
- analyzovať najnáročnejšie dotazy a zistiť negatívny dopad obmedzenia paralelizmu. Ak existuje, znížiť hodnotu Cost Threshold for Parallelism alebo zopakovať kroky 1-2 tohto algoritmu.
Pre OLTP systémy prechádzame od jednovláknovej k viacerovláknovej prevádzke, pre OLAP systémy naopak prechádzame od viacerovláknovej k jednovláknovej prevádzke. Týmto spôsobom je možné získať optimálne nastavenia paralelizmu pre konkrétnu databázu aj pre celú inštanciu MS SQL Server.
Je tiež dôležité pochopiť, že nastavenia vlastností paralelizmu je potrebné časom meniť na základe výsledkov monitorovania výkonnosti MS SQL Server.
Odporúčania na nastavenie trasovacích flagov
Na základe vlastných skúseností a skúseností mojich kolegov odporúčam nastavovať na úrovni spustenia služby MS SQL Server pre verzie 2008-2016 nasledujúce trasovacie flagy:
- 610 — Znižovanie protokolovania vkladov do indexovaných tabuliek. Môže pomôcť pri vklade do tabuliek s veľkým počtom záznamov a množstvom transakcií, pri častých dlhých čakaniach WRITELOG na zmeny v indexoch.
- 1117 — Ak súbory v súborovej skupine splnia požiadavky prahu automatického zväčšenia, všetky súbory v súborovej skupine sa zväčšia.
- 1118 — Zabezpečuje, že všetky objekty sú umiestnené v rôznych extento, čo minimalizuje potrebu skenovania stránky SGAM, ktorá sa používa na sledovanie zmiešaných extentov.
- 1224 — Vypína zhlukovanie zámkov na základe počtu zámkov. Avšak príliš aktívne používanie pamäte môže spustiť zhlukovanie zámkov.
- 2371 — Mení prah fixovaného automatického aktualizovania štatistiky na prah dynamického automatického aktualizovania štatistiky. Je dôležité pre aktualizáciu plánov dopytov týkajúcich sa veľkých tabuliek, kde nesprávne určenie počtu záznamov vedie k chybným plánom vykonávania.
- 3226 — Potláča správy o úspešnom vykonaní zálohovania v chybovom denníku.
- 4199 — Zapojuje zmeny v optimalizátore dopytov vydané v kumulatívnych balíkoch aktualizácií a balíkoch aktualizácií SQL Server.
- 6532-6534 — Zapojuje zlepšenie výkonu operácií dopytov s priestorovými typmi údajov.
- 8048 — Premení objekty pamäte, rozdelené podľa NUMA, na rozdelené podľa CPU.
- 8780 — Zapojuje dodatočné pridelenie času na zostavenie plánu dopytu. Niektoré dopyty bez tohto prajku môžu byť zamietnuté, pretože nemajú plán dopytu (veľmi zriedkavá chyba).
- 8780 — 9389 — Zapojuje dodatočný dynamicky poskytovaný pamäťový buffer pre operátory dávkového režimu, čo umožňuje operátorovi dávkového režimu požiadať o dodatočnú pamäť a vyhnúť sa prenášaniu údajov do tempdb, ak je dodatočná pamäť dostupná.
Taktiež do verzie 2016 je užitočné zapnúť flag trasovania 2301, ktorý zapína optimalizáciu rozšírenej podpory rozhodovania a tým pomáha pri výbere správnejších plánov dopytov. Avšak, začínajúc s verziou 2016, má často negatívny vplyv na dostatočne dlhý celkový čas vykonávania dopytov.
Taktiež pre systémy, v ktorých je veľmi veľa indexov (napríklad pre databázy 1C), odporúčam zapnúť flag trasovania 2330, ktorý vypína zbieranie o používaní indexov, čo pozitívne vplýva na systém.
Podrobnejšie o flagoch trasovania sa môžete dozvedieť.
Pri uvedenom odkaze je dôležité tiež zohľadniť verzie a zostavy MS SQL Server, keďže pre novšie verzie niektoré flagy trasovania sú zapnuté predvolene alebo nemajú žiadny účinok.
Zapnúť a vypnúť flag trasovania je možné pomocou príkazov DBCC TRACEON a DBCC TRACEOFF. Podrobnejšie si pozrite.
Stav flagov trasovania môžete získať pomocou príkazu DBCC TRACESTATUS:
Aby boli vlajky sledovania zahrnuté do automatického spustenia služby MS SQL Server, je potrebné otvoriť Správcu konfigurácie SQL Server a v nastaveniach služby pridať týchto vlajky sledovania prostredníctvom -T:
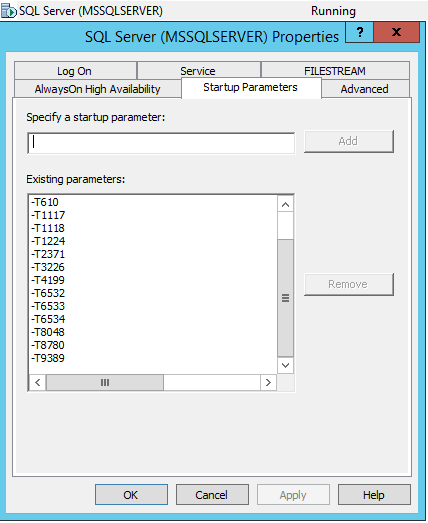
Zhrnutie
V tomto článku boli rozobraté niektoré aspekty monitorovania MS SQL Server, pomocou ktorých je možné rýchlo odhaliť nedostatok RAM a voľného času CPU, ako aj množstvo ďalších menej zrejmých problémov. Boli preskúmané najčastejšie používané vlajky sledovania.
Zdroje:
»
»
»
»
»
»
»
Zdroj: habr.com
