

LINQ sa stal súčasťou .NET ako nový mocný jazyk na manipuláciu s dátami. LINQ to SQL ako jeho súčasť umožňuje pohodlnú komunikáciu s databázovými systémami pomocou napríklad Entity Frameworku. Avšak, pomerne často, pri jeho používaní zabúdajú vývojári venovať pozornosť tomu, aký presný SQL dotaz vygeneruje queryable provider, vo vašom prípade — Entity Framework.
Prejdeme si dva hlavné aspekty na príklade.
Na to v SQL Serveri vytvoríme databázu Test a v nej vytvoríme dve tabuľky pomocou nasledujúceho dotazu:
Vytvorenie tabuliek
USE [TEST]
GO

SET ANSI_NULLS ON
GO

SET QUOTED_IDENTIFIER ON
GO

CREATE TABLE [dbo].[Ref](
	[ID] [int] NOT NULL,
	[ID2] [int] NOT NULL,
	[Name] [nvarchar](255) NOT NULL,
	[InsertUTCDate] [datetime] NOT NULL,
 CONSTRAINT [PK_Ref] PRIMARY KEY CLUSTERED
(
	[ID] ASC
)WITH (PAD_INDEX = OFF, STATISTICS_NORECOMPUTE = OFF, IGNORE_DUP_KEY = OFF, ALLOW_ROW_LOCKS = ON, ALLOW_PAGE_LOCKS = ON) ON [PRIMARY]
) ON [PRIMARY]
GO

ALTER TABLE [dbo].[Ref] ADD  CONSTRAINT [DF_Ref_InsertUTCDate]  DEFAULT (getutcdate()) FOR [InsertUTCDate]
GO

USE [TEST]
GO

SET ANSI_NULLS ON
GO

SET QUOTED_IDENTIFIER ON
GO

CREATE TABLE [dbo].[Customer](
	[ID] [int] NOT NULL,
	[Name] [nvarchar](255) NOT NULL,
	[Ref_ID] [int] NOT NULL,
	[InsertUTCDate] [datetime] NOT NULL,
	[Ref_ID2] [int] NOT NULL,
 CONSTRAINT [PK_Customer] PRIMARY KEY CLUSTERED
(
	[ID] ASC
)WITH (PAD_INDEX = OFF, STATISTICS_NORECOMPUTE = OFF, IGNORE_DUP_KEY = OFF, ALLOW_ROW_LOCKS = ON, ALLOW_PAGE_LOCKS = ON) ON [PRIMARY]
) ON [PRIMARY]
GO

ALTER TABLE [dbo].[Customer] ADD  CONSTRAINT [DF_Customer_Ref_ID]  DEFAULT ((0)) FOR [Ref_ID]
GO

ALTER TABLE [dbo].[Customer] ADD  CONSTRAINT [DF_Customer_InsertUTCDate]  DEFAULT (getutcdate()) FOR [InsertUTCDate]
GO
Teraz naplníme tabuľku Ref pomocou spustenia nasledujúceho skriptu:
Naplnění tabulky Ref
USE [TEST]
GO

DECLARE @ind INT=1;

WHILE(@ind<1200000)
BEGIN
	INSERT INTO [dbo].[Ref]
           ([ID]
           ,[ID2]
           ,[Name])
    SELECT
           @ind
           ,@ind
           ,CAST(@ind AS NVARCHAR(255));

	SET @ind=@ind+1;
END
GO
Rovnako naplníme tabuľku Customer pomocou nasledujúceho skriptu:
Naplnění tabulky Customer
POUŽITE [TEST]
GO

DECLARE @ind INT=1;
DECLARE @ind_ref INT=1;

KÝM(@ind<=12000000)
ZAČIATOK
	AK(@ind%3=0) NASTAV @ind_ref=1;
	INAK AK (@ind%5=0) NASTAV @ind_ref=2;
	INAK AK (@ind%7=0) NASTAV @ind_ref=3;
	INAK AK (@ind=0) NASTAV @ind_ref=4;
	INAK AK (@ind=0) NASTAV @ind_ref=5;
	INAK AK (@ind=0) NASTAV @ind_ref=6;
	INAK AK (@ind=0) NASTAV @ind_ref=7;
	INAK AK (@ind=0) NASTAV @ind_ref=8;
	INAK AK (@ind=0) NASTAV @ind_ref=9;
	INAK AK (@ind=0) NASTAV @ind_ref=10;
	INAK AK (@ind=0) NASTAV @ind_ref=11;
	INAK NASTAV @ind_ref=@ind90000;

	VLOŽIŤ DO [dbo].[Customer]
	 ([ID]
	 ,[Name]
	 ,[Ref_ID]
	 ,[Ref_ID2])
	 VYBERTE
	 @ind,
	 CAST(@ind AS NVARCHAR(255)),
	 @ind_ref,
	 @ind_ref;


	NASTAV @ind=@ind+1;
KONEC
GO
Takto sme dostali dve tabuľky, v jednej z nich viac ako 1 milión riadkov dát, a v druhej viac ako 10 miliónov riadkov dát.
Teraz je potrebné v Visual Studio vytvoriť testovací projekt Visual C# Console App (.NET Framework):
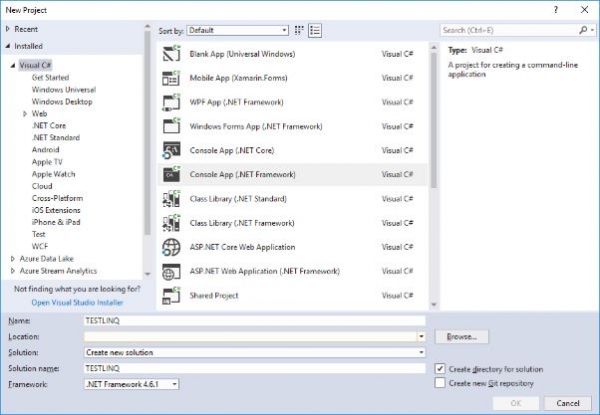
Ďalej je potrebné pridať knižnicu pre Entity Framework na interakciu s databázou.
Aby sme ju pridali, klikneme pravým tlačidlom myši na projekt a v kontextovom menu vyberieme položku Spravovať NuGet balíčky:
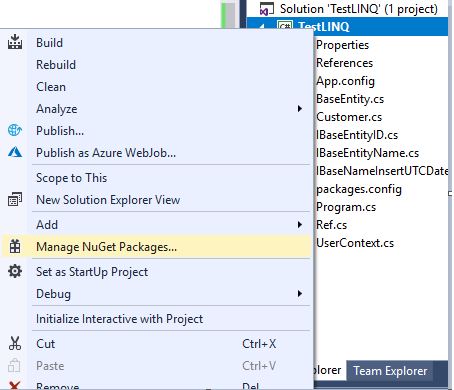
Potom v okne na správu NuGet balíčkov zadajte do vyhľadávacieho poľa slovo „Entity Framework“ a vyberte balík Entity Framework a nainštalujte ho:
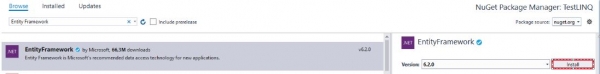
Ďalej do súboru App.config po uzavretí prvku configSections je potrebné pridať nasledujúci blok:
Do connectionString treba vpísať pripojovaciu reťazec.
Teraz vytvoríme v samostatných súboroch 3 rozhrania:
- Implementácia rozhrania IBaseEntityID
namespace TestLINQ { public interface IBaseEntityID { int ID { get; set; } } } - Implementácia rozhrania IBaseEntityName
namespace TestLINQ { public interface IBaseEntityName { string Name { get; set; } } } - Implementácia rozhrania IBaseNameInsertUTCDate
namespace TestLINQ
{
    public interface IBaseNameInsertUTCDate
    {
        DateTime InsertUTCDate { get; set; }
    }
}
A v samostatnom súbore vytvoríme základnú triedu BaseEntity pre naše dve entity, do ktorej budú patriť spoločné polia:
Implementácia základnej triedy BaseEntity
namespace TestLINQ
{
    public class BaseEntity : IBaseEntityID, IBaseEntityName, IBaseNameInsertUTCDate
    {
        public int ID { get; set; }
        public string Name { get; set; }
        public DateTime InsertUTCDate { get; set; }
    }
}
Potom v samostatných súboroch vytvoríme naše dve entity:
- Implementácia triedy Ref
using System.ComponentModel.DataAnnotations.Schema; namespace TestLINQ { [Table("Ref")] public class Ref : BaseEntity { public int ID2 { get; set; } } } - Implementácia triedy Customer
using System.ComponentModel.DataAnnotations.Schema;

namespace TestLINQ
{
    [Table("Customer")]
    public class Customer: BaseEntity
    {
        public int Ref_ID { get; set; }
        public int Ref_ID2 { get; set; }
    }
}
Teraz vytvoríme v samostatnom súbore kontext UserContext:
Implementácia triedy UserContex
using System.Data.Entity;

namespace TestLINQ
{
    public class UserContext : DbContext
    {
        public UserContext()
            : base("DbConnection")
        {
            Database.SetInitializer(null);
        }

        public DbSet Customer { get; set; }
        public DbSet Ref { get; set; }
    }
}
Získali sme hotové riešenie na vykonávanie testov optimalizácie s LINQ to SQL prostredníctvom EF pre MS SQL Server:
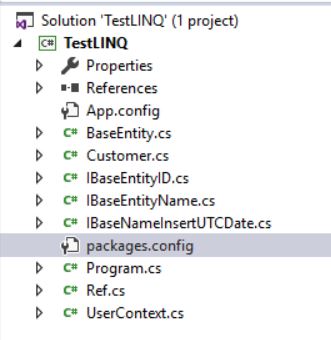
Teraz do súboru Program.cs vložte nasledujúci kód:
Súbor Program.cs
using System;
using System.Collections.Generic;
using System.Linq;

namespace TestLINQ
{
    class Program
    {
        static void Main(string[] args)
        {
            using (UserContext db = new UserContext())
            {
                var dblog = new List();
                db.Database.Log = dblog.Add;

                var query = from e1 in db.Customer
                            from e2 in db.Ref
                            where (e1.Ref_ID == e2.ID)
                                 && (e1.Ref_ID2 == e2.ID2)
                            select new { Data1 = e1.Name, Data2 = e2.Name };

                var result = query.Take(1000).ToList();

                Console.WriteLine(dblog[1]);

                Console.ReadKey();
            }
        }
    }
}
Ďalej spustíme náš projekt.
Na konci práce bude na konzole zobrazené:
Vygenerovaný SQL dotaz
SELECT TOP (1000)
    [Extent1].[Ref_ID] AS [Ref_ID],
    [Extent1].[Name] AS [Name],
    [Extent2].[Name] AS [Name1]
    FROM  [dbo].[Customer] AS [Extent1]
    INNER JOIN [dbo].[Ref] AS [Extent2] ON ([Extent1].[Ref_ID] = [Extent2].[ID]) AND ([Extent1].[Ref_ID2] = [Extent2].[ID2])
T. j. celkovo LINQ dotaz vygeneroval SQL dotaz pre DB MS SQL Server celkom dobre.
Teraz zmeníme podmienku A na ALEBO v LINQ dotaze:
LINQ dotaz
var query = from e1 in db.Customer
                            from e2 in db.Ref
                            where (e1.Ref_ID == e2.ID)
                                || (e1.Ref_ID2 == e2.ID2)
                            select new { Data1 = e1.Name, Data2 = e2.Name };
A znovu spustíme našu aplikáciu.
Spustenie vyhodí chybu súvisiacu s prekročením časového limitu príkazu na 30 sekúnd:
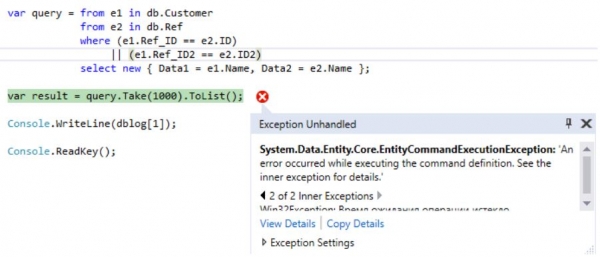
Ak sa pozrieme, aký dotaz bol pri tom vygenerovaný LINQ:
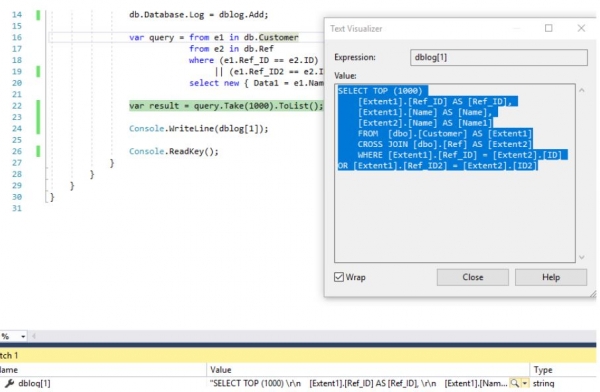
, môžeme sa presvedčiť, že výber prebieha cez kartezské súčiny dvoch množín (tabuliek):
Vygenerovaný SQL dotaz
SELECT TOP (1000)
    [Extent1].[Ref_ID] AS [Ref_ID],
    [Extent1].[Name] AS [Name],
    [Extent2].[Name] AS [Name1]
    FROM  [dbo].[Customer] AS [Extent1]
    CROSS JOIN [dbo].[Ref] AS [Extent2]
    WHERE [Extent1].[Ref_ID] = [Extent2].[ID] OR [Extent1].[Ref_ID2] = [Extent2].[ID2]
Poďme prepísať LINQ dotaz nasledovne:
Optimalizovaný LINQ dotaz
var query = (from e1 in db.Customer
                   join e2 in db.Ref
                   on e1.Ref_ID equals e2.ID
                   select new { Data1 = e1.Name, Data2 = e2.Name }).Union(
                        from e1 in db.Customer
                        join e2 in db.Ref
                        on e1.Ref_ID2 equals e2.ID2
                        select new { Data1 = e1.Name, Data2 = e2.Name });
Potom dostaneme nasledujúci SQL dotaz:
SQL dotaz
VYBERTE
    [Limit1].[C1] AKO [C1],
    [Limit1].[C2] AKO [C2],
    [Limit1].[C3] AKO [C3]
    Z ( VYBERTE ODLIŠNÉ TOP (1000)
        [UnionAll1].[C1] AKO [C1],
        [UnionAll1].[Name] AKO [C2],
        [UnionAll1].[Name1] AKO [C3]
        Z  (VYBERTE
            1 AKO [C1],
            [Extent1].[Name] AKO [Name],
            [Extent2].[Name] AKO [Name1]
            Z  [dbo].[Customer] AKO [Extent1]
            VNÚTORNE PRIPOJIŤ [dbo].[Ref] AKO [Extent2] NA [Extent1].[Ref_ID] = [Extent2].[ID]
        ZLÚČIŤ VŠETKÉ
            VYBERTE
            1 AKO [C1],
            [Extent3].[Name] AKO [Name],
            [Extent4].[Name] AKO [Name1]
            Z  [dbo].[Customer] AKO [Extent3]
            VNÚTORNE PRIPOJIŤ [dbo].[Ref] AKO [Extent4] NA [Extent3].[Ref_ID2] = [Extent4].[ID2]) AKO [UnionAll1]
    )  AKO [Limit1]
Bohužiaľ, v LINQ dotazoch môže byť len jedna podmienka spojenia, preto je možné vytvoriť ekvivalentný dotaz cez dva dotazy pre každú podmienku a následne ich spojiť pomocou Union na odstránenie duplicitných riadkov.
Áno, dotazy v zásade budú neekvivalentné, predpokladajúc, že môžu byť vrátené úplné duplicitné riadky. Avšak v skutočnom živote úplné duplicitné riadky nie sú potrebné a snažíme sa ich zbaviť.
Teraz porovnajme plány vykonania týchto dvoch dotazov:
- pre CROSS JOIN je priemerný čas vykonania 195 sekúnd:

- pre INNER JOIN-UNION je priemerný čas vykonania menej ako 24 sekúnd:

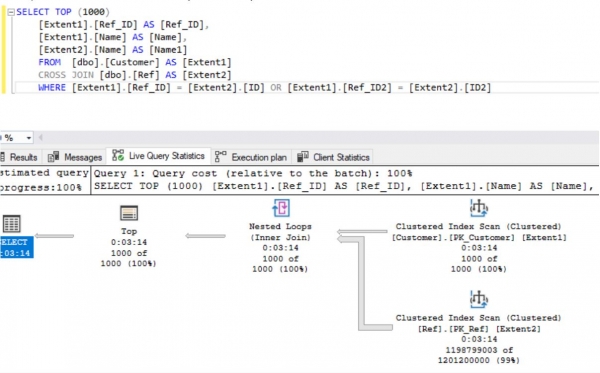
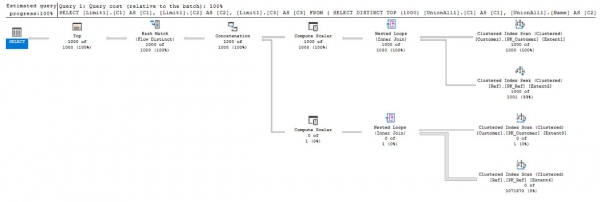
Ako je vidieť z výsledkov, optimalizovaný LINQ dotaz pre dve tabuľky s miliónmi záznamov funguje niekoľkonásobne rýchlejšie ako neoptimalizovaný.
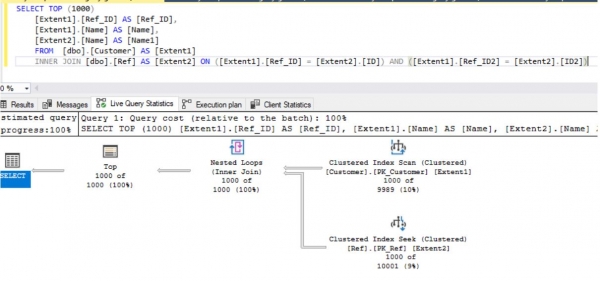
Pre variant s AND v podmienkach LINQ, dotaz má tvar:
LINQ dotaz
var query = from e1 in db.Customer
                            from e2 in db.Ref
                            where (e1.Ref_ID == e2.ID)
                                 && (e1.Ref_ID2 == e2.ID2)
                            select new { Data1 = e1.Name, Data2 = e2.Name };
takmer vždy bude generovaný správny SQL dotaz, ktorý sa bude vykonávať v priemere približne 1 sekundu:
Takisto pre manipulácie s LINQ to Objects namiesto dotazu tvaru:
LINQ dotaz (prvá varianta)
var query = from e1 in seq1
                            from e2 in seq2
                            where (e1.Key1==e2.Key1)
                               && (e1.Key2==e2.Key2)
                            select new { Data1 = e1.Data, Data2 = e2.Data };
môžeš použiť dotaz tvaru:
LINQ dotaz (druhá varianta)
var query = from e1 in seq1
                            join e2 in seq2
                            on new { e1.Key1, e1.Key2 } equals new { e2.Key1, e2.Key2 }
                            select new { Data1 = e1.Data, Data2 = e2.Data };
kde:
Definícia dvoch polí
Para[] seq1 = new[] { new Para { Key1 = 1, Key2 = 2, Data = "777" }, new Para { Key1 = 2, Key2 = 3, Data = "888" }, new Para { Key1 = 3, Key2 = 4, Data = "999" } };
Para[] seq2 = new[] { new Para { Key1 = 1, Key2 = 2, Data = "777" }, new Para { Key1 = 2, Key2 = 3, Data = "888" }, new Para { Key1 = 3, Key2 = 5, Data = "999" } };
, a typ Para je definovaný nasledovne:
Definícia typu Para
class Para
{
        public int Key1, Key2;
        public string Data;
}
Takto sme preskúmali niektoré aspekty optimalizácie LINQ dotazov na MS SQL Server.
Bohužiaľ, aj skúsení a vedúci .NET vývojári zabúdajú na to, že je potrebné chápať, čo robia za scénou tie inštrukcie, ktoré používajú. Inak sa môžu stať konfigurátormi a môžu do budúcnosti zakúpiť časovanú bombu pri škálovaní softvérového riešenia alebo pri menších zmenách vonkajších podmienok prostredia.
Taktiež sa uskutočnil malý prehľad a .
Zdroje pre test - samotný projekt, vytvorenie tabuliek v databáze TEST a ich naplnenie údajmi sa nachádza .
Taktiež v tomto repozitári v priečinku Plans sú plány vykonávania dotazov s podmienkami ALEBO.
Zdroj: habr.com
