

Hneď vysvetlím názov článku. Pôvodne sa plánovalo poskytnúť dobrú, spoľahlivú radu o urýchlení používania refleksie na jednoduchom, ale realistickom príklade, avšak počas benchmarkingu sa ukázalo, že refleksia nefunguje tak pomaly, ako som si myslel, zatiaľ čo LINQ pracuje pomalšie, než som kedy sníval. A nakoniec sa ukázalo, že som spravil aj chybu v meraniach… Podrobnosti tejto životnej histórie nájdete nižšie a v komentároch. Keďže je príklad dostatočne bežný a realizovaný v zásade ako sa obvykle robí v podnikových prostrediach, vyšla z toho podľa mňa zaujímavá ukážka života: vplyv na rýchlosť hlavného predmetu článku nebolo vidno kvôli vonkajšej logike: Moq, Autofac, EF Core a iná „obalová“ logika.
Začal som prácu pod dojmom z toho článku:
Ako vidno, autor navrhuje používať skompilované delegáty namiesto priameho volania metód typov refleksie ako vynikajúci spôsob, ako značně urýchliť prácu aplikácie. Samozrejme, existuje tam aj IL emisia, ale tej by som sa rád vyhol, pretože je to najpracovnejší spôsob vykonania úlohy, ktorý je spojený s chybami.
Vzhľadom na to, že som si vždy zachovával podobný názor na rýchlosť refleksie, nemal som v úmysle spochybňovať autorove závery.
Neraz sa stretávam s naivným používaním refleksie v podnikových prostrediach. Zoberie sa typ. Zoberie sa informácia o vlastnosti. Volá sa metóda SetValue a všetci sa tešia. Hodnota sa dostala do cieľového poľa, všetci sú spokojní. Ľudia sú veľmi inteligentní — seniori a tímoví lídri — píšu si vlastné rozšírenia na object, založené na takej naivnej implementácii „univerzálnych“ mapperov z jedného typu do druhého. Zvyčajne ide o to: vezmeme všetky polia, vezmeme všetky vlastnosti, iterujeme cez ne: pri zhode mien členov typu vykonáme SetValue. Občas chytíme výnimky pri neúspechoch tam, kde sme nenašli nejakú vlastnosť u jedného z typov, ale aj tu je východisko, ktoré zlepšuje výkon. Try/catch.
Viděl jsem, jak lidé znovuobjevují parsery a mapovače, aniž by měli kompletní informační výzbroj o tom, jak fungují vynalezené bicykly před nimi. Viděl jsem, jak lidé skrývají své naivní implementace za strategiemi, za rozhraními, za injekcemi, jako by to omlouvalo následnou chaos. Od takových implementací jsem se odvrátil. Ve skutečnosti jsem měření skutečného úniku výkonu neprováděl a pokud to bylo možné, jednoduše jsem měnil implementaci na „optimálnější“, pokud na to došlo. Proto mne první měření, o kterých je řeč níže, vážně zaskočila.
Myslím, že mnozí z vás, když čtete Richtera nebo jiné ideologické autority, se setkali s poměrně spravedlivým tvrzením, že reflexe v kódu je jev, který má extrémně negativní dopad na výkon aplikace.
Volání reflexe nutí CLR procházet sestavení při hledání potřebného, načítat jejich metadata, parsovat je atd. Kromě toho reflexe během procházení sekvencí vede k alokaci velkého objemu paměti. Spotřebováváme paměť, CLR vyndá GČ a začne to způsobovat trhání. To musí být pozoruhodně pomalé, věřte mi. Obrovské objemy paměti moderních produkčních serverů či cloudových strojů nezachraňují od vysokých latencí při zpracování. Ve skutečnosti, čím více paměti máte, tím vyšší je pravděpodobnost, že si VĚDOMĚTE, jak GČ funguje. Reflexe – to je, podle mého názoru, zbytečná červená hadřík pro něj.
Nicméně, všichni používáme jak IoC kontejnery, tak datové mapovače, jejichž princip fungování je také založen na reflexi, avšak otázky k jejich výkonu obvykle nevznikají. Ne, ne proto, že by implementace závislostí a abstrakce od modelů vnějšího omezeného kontextu byly tak nezbytné věci, že bychom museli obětovat výkon v každém případě. Všechno je jednodušší – to opravdu výrazně neovlivňuje výkon.
Podle mého názoru, nejběžnější rámce, které jsou založeny na technologii reflexe, používají rozmanité triky pro efektivnější práci s ní. Obvykle se jedná o cache. Obvykle – to jsou výrazy a zkompilované delegáty z výrazu. Ten samý automapper si drží konkurentní slovník, který mapuje typy na funkce, které mohou jeden druhému konvertovat již bez volání reflexe.
Ako sa to dosahuje? V podstate sa to nelíši od logiky, ktorou sa riadi samotná platforma pri generovaní kódu JIT. Pri prvom volaní metódy sa táto skompiluje (a áno, tento proces nie je rýchly), pri následných volaniach sa už ovládanie prenáša na skompilovanú metódu, a tu nebudú žiadne významné poklesy výkonu.
V našom prípade môžeme tiež využiť JIT kompiláciu a potom používať skompilované správanie s rovnakým výkonom ako jeho AOT analógy. Na pomoc nám v tomto prípade prídu výrazy.
Stručne možno zhrnúť princíp, o ktorom hovoríme, nasledujúcim spôsobom:
Je potrebné cachovať konečný výsledok práce reflexie vo forme delegáta, ktorý obsahuje skompilovanú funkciu. Všetky potrebné objekty so správami o typoch má tiež zmysel cachovať v uchovávaných mimo objektov poliach vášho typu - pracovníka.
Logika v tomto je. Zdravý rozum nám hovorí, že ak niečo možno skompilovať a cachovať, mali by sme to urobiť.
Zabiehajúc dopredu, treba povedať, že cache pri práci s reflexiou má svoje výhody, aj keď sa nevyužije navrhnutá metóda kompilácie výrazov. V zásade tu len zopakujem tézy autora článku, na ktorý sa odvolávam vyššie.
Teraz kódu. Poďme si pozrieť príklad, ktorý je založený na mojej nedávnej bolesti, s ktorou som sa musel vysporiadať v serióznom produkčnom prostredí serióznej kreditnej inštitúcie. Všetky entity sú fiktívne, aby nikto neuhádol.
Existuje akási entita. Nech je to Contact. Existujú e-maily so štandardizovaným telom, z ktorých parser a hydrátor vytvárajú tieto kontakty. Prišiel e-mail, prečítali sme ho, rozobrali na páry kľúč-hodnota, vytvorili kontakt a uložili do db.
Je to elementárne. Predpokladajme, že kontakt má vlastnosti Meno, Vek a kontaktné telefónne číslo. Tieto údaje sa prenášajú v e-maili. Rovnako biznis chce, aby podpora mohla rýchlo pridávať nové kľúče na mapovanie vlastností entity na páry v tele e-mailu. Na ten prípad, ak niekto urobil preklep v šablóne alebo ak pred vydaním bude potrebné rýchlo spustiť mapovanie od nového partnera, prispôsobiť sa novému formátu. Vtedy novú koreláciu mapovania môžeme pridať ako lacný dátový fix. To znamená, že ide o reálny príklad.
Realizujeme, vytvárame testy. Funguje to.
Kód nebudem uvádzať: zdrojových kódov je veľa a sú dostupné na GitHub-e na odkaze na konci článku. Môžete si ich stiahnuť, vyskúšať do nemoty a zmerať, ako by to ovplyvnilo váš prípad. Uvediem iba kód dvoch šablónových metód, ktorými sa odlišujú hydrátory, ktoré mali byť rýchle od hydrátorov, ktoré mali byť pomalé.
Logika je nasledujúca: šablónová metóda získava páry, vytvorené základnou logikou parsera. Úroveň LINQ je parser a základná logika hydrátora, ktorá vykonáva dotaz na databázový kontext a porovnáva kľúče s pármi od parsera (pre tieto funkcie existuje kód bez LINQ na porovnanie). Potom sa páry odovzdávajú do hlavnej metódy hydratácie a hodnoty párov sa nastavujú do príslušných vlastností entity.
„Rýchly“ (predpona Fast v benchmarkoch):
 protected override Contact GetContact(PropertyToValueCorrelation[] correlations)
        {
            var contact = new Contact();
            foreach (var setterMapItem in _proprtySettersMap)
            {
                var correlation = correlations.FirstOrDefault(x => x.PropertyName == setterMapItem.Key);
                setterMapItem.Value(contact, correlation?.Value);
            }
            return contact;
        }
Ako vidíme, používa sa statická kolekcia so settermi vlastností – skompilovanými lambda výrazmi, ktoré volajú setter entity. Sú vytvorené nasledujúcim kódom:
        static FastContactHydrator()
        {
            var type = typeof(Contact);
            foreach (var property in type.GetProperties())
            {
                _proprtySettersMap[property.Name] = GetSetterAction(property);
            }
        }

        private static Action GetSetterAction(PropertyInfo property)
        {
            var setterInfo = property.GetSetMethod();
            var paramValueOriginal = Expression.Parameter(property.PropertyType, "value");
            var paramEntity = Expression.Parameter(typeof(Contact), "entity");
            var setterExp = Expression.Call(paramEntity, setterInfo, paramValueOriginal).Reduce();

            var lambda = (Expression<Action>)Expression.Lambda(setterExp, paramEntity, paramValueOriginal);

            return lambda.Compile();
        }
V celku je to jasné. Obchádzame vlastnosti, vytvárame pre ne delegáty, ktoré volajú settery, a uchovávame ich. Potom ich voláme, keď je to potrebné.
„Pomalý“ (predpona Slow v benchmarkoch):
        protected override Contact GetContact(PropertyToValueCorrelation[] correlations)
        {
            var contact = new Contact();
            foreach (var property in _properties)
            {
                var correlation = correlations.FirstOrDefault(x => x.PropertyName == property.Name);
                if (correlation?.Value == null)
                    continue;

                property.SetValue(contact, correlation.Value);
            }
            return contact;
        }
Tu hneď obchádzame vlastnosti a priamo voláme SetValue.
Aby to bolo prehľadnejšie a ako referenčný bod, implementoval som naivnú metódu, ktorá zapíše hodnoty ich korelačných párov priamo do polí entity. Predpona – Manual.
Teraz vezmeme BenchmarkDotNet a preskúmame výkonnosť. A zrazu... (spoiler – toto nie je správny výsledok, podrobnosti nižšie)
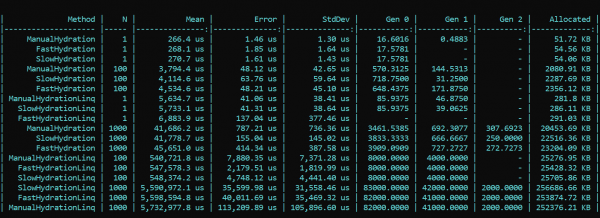
Čo tu vidíme? Metódy, ktoré s pýchou nesú predponu Fast, sú takmer vo všetkých prechodoch pomalšie ako metódy s predponou Slow. To platí pre alokáciu aj pre rýchlosť spracovania. Na druhej strane, krásna a elegantná implementácia mapovania s použitím metód LINQ všade tam, kde je to možné, naopak, výrazne znižuje výkonnosť. Rozdiely sú poriadne výrazné. Trend sa nemenní s rôznym počtom prechodov. Rozdiely sú len v mierke. S LINQ je výkon 4 – 200-krát pomalší, množstvo odpadu je približne v rovnakých mierkach.
AKTUALIZOVANÉ
Neveril som vlastným očiam, ale čo je dôležitejšie, náš kolega neveril ani mojim očiam, ani môjmu kódu — . Po prekontrole môjho riešenia brilantne objavil a upozornil na chybu, ktorú som kvôli niekoľkým zmenám v implementácii od počiatočnej po konečnú verziu prehliadol. Po oprave zistenej chyby v nastavení Moq, sa všetky výsledky dostali na svoje miesto. Z výsledkov nového testovania sa hlavný trend nezmenil – LINQ má aj tak silnejší vplyv na výkon ako reflexia. Avšak, je potešujúce, že práca s kompiláciou Expression sa neoplatí zbytočne a výsledok je viditeľný ako pri alokácii, tak aj pri čase vykonávania. Prvé spustenie, keď sa inicializujú statické polia, je predvídateľne pomalšie u "rýchlej" metódy, ale ďalej sa situácia mení.
Tu sú výsledky nového testovania:
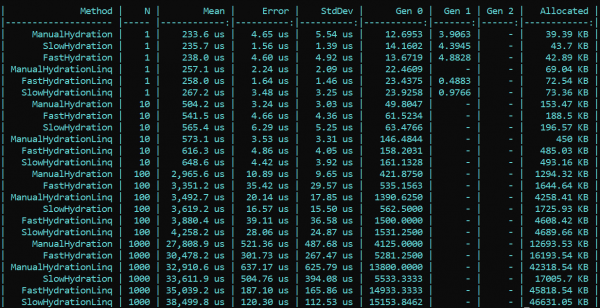
Záver: pri používaní reflexie v podnikovej sfére nie je potrebné uchýliť sa k špekulantom — LINQ oveľa viac znižuje výkon. Napriek tomu, v silne zatiahnutých metódach vyžadujúcich optimalizáciu je možné uchovať reflexiu vo forme inicializátorov a kompilátorov delegátov, ktoré náležite zabezpečia "rýchlu" logiku. Tak môžete zachovať flexibilitu reflexie aj rýchlosť prevádzky aplikácie.
Kód s benchmarkom je dostupný tu. Všetci záujemcovia si môžu prekontrolovať moje slová:
PS: Kód v testoch používa IoC, zatiaľ čo v benchmarkoch – explicitnú konštrukciu. Ide o to, že v konečnej implementácii som odstránil všetky faktory, ktoré by mohli ovplyvniť výkon a zakryť výsledok.
PPS: Ďakujem používateľovi za odhalenie mojej chyby v nastavení Moq, ktorá ovplyvnila prvé merania. Ak má niekto z čitateľov dostatočnú karmu, prosím, dajte mu like. Človek sa zastavil, človek sa zaoberal, človek preveril a poukázal na chybu. Považujem to za zaslúženú úctu a náklonnosť.
PPPS: Ďakujem tomu dôvtipnému čitateľovi, ktorý sa zaoberal štýlom a formátovaním. Som za jednotnosť a pohodlie. Diplomatickosť podania by mohla byť lepšia, ale kritiku som zohľadnil. Prosím, pokračujte s argumentáciou.
Zdroj: habr.com
