

Až donedávna bolo v Odnoklassnikach približne 50 TB údajov spracovávaných v reálnom čase uložených v SQL Serveri. Pre taký objem je zabezpečiť rýchly, spoľahlivý a odolný prístup k DCP s použitím SQL DB prakticky nemožné. Zvyčajne sa v takýchto prípadoch používajú jedno z NoSQL úložísk, ale nie všetko sa dá preniesť do NoSQL: niektoré entity vyžadujú záruky ACID transakcií.
To nás priviedlo k použitiu NewSQL úložísk, teda DB, ktorá poskytuje odolnosť voči chybe, škálovateľnosť a rýchlosť NoSQL systémov, no zároveň zachováva tradičné ACID záruky klasických systémov. Fungujúcich priemyselných systémov tejto novej triedy je málo, preto sme taký systém implementovali sami a spustili ho do priemyselnej prevádzky.
Ako to funguje a čo sa podarilo — čítajte ďalej.
Dnes mesačná návštevnosť „Odnoklassnikov“ presahuje 70 miliónov unikátnych návštevníkov. My najväčších sociálnych sietí sveta a v prvej dvadsiatke stránok, na ktorých užívatelia trávia najviac času. Infrastuktúra „OK“ spracováva veľmi vysoké zaťaženia: viac ako milión HTTP požiadaviek/s na fronty. Časti serverového parku v počte viac ako 8000 kusov sú umiestnené blízko seba — v štyroch moskovských dátových centrách, čo umožňuje zabezpečiť sieťovú latenciu menej ako 1 ms medzi nimi.
Cassandra používame od roku 2010, počnúc verziou 0.6. Dnes máme v prevádzke niekoľko desiatok klastra. Najrýchlejší klastra spracováva viac ako 4 milióny operácií za sekundu, najväčší uchováva 260 TB.
To sú však bežné NoSQL klastry používané na ukladanie údajov. My sme sa však chceli nahradiť hlavné konzistentné úložisko, Microsoft SQL Server, ktoré sa používalo od založenia „Odnoklassnikov“. Uloženie pozostávalo z viac ako 300 strojov SQL Server Standard Edition, na ktorých sa nachádzalo 50 TB údajov — obchodných entít. Tieto údaje sa modifikujú v rámci ACID transakcií a vyžadujú .
Na rozdelenie údajov po nodoch SQL Server sme použili ako vertikálne, tak aj horizontálne (sharding). Historicky jsme používali jednoduchý systém shardování dat: každé entitě byl přiřazen token — funkce z ID entity. Entity se stejným tokenem byly umístěny na jeden SQL server. Vztah typu master-detail byl realizován tak, aby tokeny hlavního a odvozeného záznamu vždy odpovídaly a nacházely se na jednom serveru. V sociální síti téměř všechny záznamy vznikají jménem uživatele — to znamená, že všechna data uživatele v rámci jednoho funkčního subsystému jsou uložena na jednom serveru. To znamená, že v obchodní transakci téměř vždy byly zapojeny tabulky jednoho SQL serveru, což umožnilo zajistit konzistenci dat pomocí lokálních ACID transakcí, bez nutnosti použití distribuovaných ACID tranzakcí.
Díky shardování a pro urychlení práce SQL:
- Nepoužíváme Foreign key constraints, protože při shardování může ID entity být na jiném serveru.
- Nepoužíváme uložené procedury a spouštěče kvůli dodatečné zátěži na CPU DBMS.
- Nepoužíváme JOINy kvůli všemu výše uvedenému a mnoha náhodným čtením z disku.
- Mimo transakci pro snížení vzájemného blokování používáme úroveň izolace Read Uncommitted.
- Provádíme pouze krátké transakce (průměrně kratší než 100 ms).
- Nepoužíváme víceřádkové UPDATE a DELETE kvůli velkému množství vzájemného blokování — aktualizujeme pouze jeden záznam.
- Dotazy vždy provádíme pouze podle indexů — dotaz s plánem plného prohlížení tabulky pro nás znamená přetížení DB a jejích selhání.
Tyto kroky nám umožnily vytěžit z SQL serverů téměř maximální výkon. Nicméně problémů stále přibývalo. Pojďme si je prozkoumat.
Problémy se SQL
- Protože jsme používali vlastní shardování, přidání nových shardů bylo prováděno administrátory ručně. Po celou dobu škálovatelné repliky dat nezpracovávaly žádné dotazy.
- S rostoucím počtem záznamů v tabulce se snižuje rychlost vkládání a modifikace, při přidávání indexů k existující tabulce rychlost klesá mnohonásobně, vytváření a obnovování indexů probíhá s výpadkem.
- Přítomnost malé skupiny Windows pro SQL Server v produkci ztěžuje správu infrastruktury.
Ale hlavní problém —
Odolnosť voči zlyhaniam
Klasický SQL server má slabú odolnosť voči výpadkom. Predpokladajme, že máte len jeden databázový server, a ten zlyhá raz za tri roky. Počas tohto času web nefunguje 20 minút, čo je akceptovateľné. Ak máte 64 serverov, web nefunguje už raz za tri týždne. A ak máte 200 serverov, web nefunguje každú týždeň. To je problém.
Čo možno urobiť na zvýšenie odolnosti SQL servera voči výpadkom? Wikipédia nám navrhuje vytvoriť : kde v prípade zlyhania ktoréhokoľvek z komponentov existuje duplikát.
To si vyžaduje park nákladného vybavenia: množstvo duplikovania, optické vlákno, zdieľané úložiská, a dokonca aj aktivovanie rezervovania funguje nespoľahlivo: približne 10% aktivácií končí zlyhaním záložnej uzly, ktorá nasleduje za hlavnou uzlou.
Hlavnou nevýhodou takého vysoko dostupného klastra je však nulová dostupnosť pri zlyhaní dátového centra, v ktorom sa nachádza. „Odaktokosť“ má štyri dátové centrá a musíme zabezpečiť fungovanie pri úplnej havárii v jednom z nich.
Na to by sa mohla použiť replikácia zabudovaná v SQL Serveri. Tento prístup je výrazne drahší z hľadiska nákladov na softvér a trpí dobre známymi problémami s replikáciou – nepredvídateľnými oneskoreniami transakcií pri synchronizovanej replikácii a oneskorením použití replikácií (a tým pádom stratou modifikácií) pri asynchrónnej. Predpokladá sa, že robí túto možnosť pre nás úplne nevhodnou.
Všetky tieto problémy si vyžadovali zásadné riešenie a pustili sme sa do ich podrobnej analýzy. Oslovme sa s tým, čo SQL Server v podstate robí – transakciami.
Jednoduchá transakcia
Zvážme najjednoduchšiu, z pohľadu aplikačného SQL programátora, transakciu: pridanie fotografie do albumu. Albumy a fotografie sa ukladajú do rôznych tabuliek. Album má čítač verejných fotografií. Potom sa takáto transakcia rozdeľuje na nasledujúce kroky:
- Zablokujeme album podľa kľúča.
- Vytvoríme záznam v tabuľke fotografií.
- Ak má fotografia verejný status, zvyšujeme v albume čítač verejných fotografií, aktualizujeme záznam a potvrdíme transakciu.
Alebo vo forme pseudokódu:
TX.start("Albums", id);
Album album = albums.lock(id);
Photo photo = photos.create(…);

if (photo.status == PUBLIC) {
    album.incPublicPhotosCount();
}
album.update();

TX.commit();
Vidíme, že najbežnejším scénarom obchodnej transakcie je prečítanie údajov z databázy do pamäte aplikačného servera, niečo zmeniť a uložiť nové hodnoty späť do databázy. Zvyčajne v takejto transakcii aktualizujeme niekoľko entít, niekoľko tabuliek.
Počas vykonávania transakcie môže dôjsť k súbežnej modifikácii rovnakých údajov z iného systému. Napríklad, Antispam môže zhodnotiť, že používateľ je podozrivý, a preto všetky fotky používateľa by už nemali byť verejné, mali by byť odoslané na moderáciu, čo znamená zmeniť photo.status na nejakú inú hodnotu a resetovať príslušné počítadlá. Je zrejmé, že ak sa táto operácia uskutoční bez záruk atómovosti aplikácie a izolácie súbežných modifikácií, ako v , výsledok nebude to, čo je potrebné — buď počítadlo fotiek bude ukazovať nesprávnu hodnotu, alebo sa všetky fotky neodošlú na moderáciu.
Takýto kód, manipulujúci s rôznymi obchodnými entitami v rámci jednej transakcie, bolo počas existencie Odnoklassnikov napísané veľmi veľa. Na základe skúseností s migráciami na NoSQL s vieme, že najväčšie ťažkosti (a časové náklady) spôsobuje potreba vyvíjať kód, zameraný na udržanie konzistencie údajov. Preto sme považovali za hlavný požiadavok, aby nové úložisko zabezpečilo pre aplikačnú logiku skutočné ACID transakcie.
Iné, nemenej dôležité požiadavky boli:
- Pri výpadku dátového centra musia byť dostupné aj čítanie, aj zápis do nového úložiska.
- Zachovanie aktuálnej rýchlosti vývoja. To znamená, že pri práci s novým úložiskom by malo byť množstvo kódu približne rovnaké, nemalo by byť potrebné dopísavať niečo do úložiska, vyvíjať algoritmy na riešenie konfliktov, udržiavanie sekundárnych indexov a podobne.
- Rýchlosť fungovania nového úložiska by mala byť dostatočne vysoká, ako pri čítaní údajov, tak aj pri spracovaní transakcií, čo efektívne znamenalo nepraktickosť akademicky presných, univerzálnych, ale pomalých riešení, ako napríklad, .
- Automatické škálovanie za behu.
- Použitie bežných lacných serverov, bez potreby kupovať exotické zariadenia.
- Možnosť rozvoja úložiska silami vývojárov spoločnosti. Inými slovami, priorita sa kládla na vlastné alebo riešenia založené na otvorenom zdroji, ideálne v Jave.
Riešenia, riešenia
Analýzou možných riešení sme prišli k dvom možným voľbám architektúry:
Prvá - zobrať akýkoľvek SQL server a realizovať potrebnú odolnosť voči chybám, mechanizmus škálovania, odolný klaster, riešenie konfliktov a distribuované, spoľahlivé a rýchle ACID transakcie. Tento variant sme ohodnotili ako veľmi netriválny a náročný.
Druhá možnosť - zobrať hotové NoSQL úložisko s implementovaným škálovaním, odolným klastrom, riešením konfliktov a realizovať transakcie a SQL sami. Na prvý pohľad vyzerá aj úloha implementácie SQL, nehovoriac o ACID transakciách, ako úloha na roky. Ale potom sme si uvedomili, že súbor možností SQL, ktorý používame v praxi, je ďaleko od ANSI SQL rovnako ďaleko ako ďaleko od ANSI SQL. Po dôkladnejšom preskúmaní CQL sme si uvedomili, že je dostatočne blízko tomu, čo potrebujeme.
Cassandra a CQL
Takže, čím je Cassandra zaujímavá, akými možnosťami disponuje?
Po prvé, tu je možné vytvárať tabuľky s podporou rôznych typov dát, môžeme robiť SELECT alebo UPDATE podľa primárneho kľúča.
CREATE TABLE photos (id bigint KEY, owner bigint,…);
SELECT * FROM photos WHERE id=?;
UPDATE photos SET … WHERE id=?;
Na zabezpečenie konzistencie dát repliky, Cassandra používa V najjednoduchšom prípade to znamená, že pri umiestnení troch replik rovnakého radu na rôzne nody clustra, zápis sa považuje za úspešný, ak väčšina nodov (t.j. dve z troch) potvrdila úspešnosť tejto operácie zápisu. Dáta radu sa považujú za konzistentné, ak pri čítaní bola opýtaná väčšina nodov a potvrdila ich. Takýmto spôsobom, pri existencii troch replik je zaručená úplná a okamžitá konzistencia dát pri zlyhaní jedného nodu. Tento prístup nám umožnil implementovať ešte spoľahlivejší systém: vždy posielať požiadavky na všetky tri repliky a čakať na odpoveď od dvoch najrýchlejších. Odpoveď tretej repliky, ktorá mešká, je v takom prípade odmietnutá. Zmeškaný odpovedajúci nod môže mať pritom vážne problémy — oneskorenia, zber odpadu v JVM, priame uvoľnenie pamäte v linuxovom jadre, chyby hardvéru, odpojenie od siete. Avšak to nijako neovplyvňuje operácie klienta a dáta.
Prístup, pri ktorom komunikujeme s tromi nodami a dostávame odpoveď od dvoch, sa nazýva : požiadavka na zbytočné repliky sa odosiela ešte predtým, ako "vypadnú".
Ďalšou z výhod Cassandra je Batchlog — mechanizmus, ktorý zaručuje buď úplnú aplikáciu, alebo úplné neprijatie balíka vašich zmien. To nám umožňuje vyriešiť A v ACID — atomickosť priamo z krabice.
Najbližšie k transakciám v Cassandre sú tzv.. Ale od "skutočných" ACID transakcií sú ďaleko: v skutočnosti to je možnosť vykonať na dátach len jednej položky, využívajúca konsenzus prostredníctvom ťažkého protokolu Paxos. Preto je rýchlosť takýchto transakcií nízka.
Čo nám chýbalo v Cassandre
Takže sme museli implementovať v Cassandre skutočné ACID transakcie. S ich pomocou by sme mohli jednoducho realizovať dve ďalšie pohodlné funkcie klasických DBMS: konzistentné rýchle indexy, čo by nám umožnilo vykonávať selekcie dát nielen podľa primárneho kľúča a bežný generátor monotónnych autoinkrementálnych ID.
C*One
Tak sa narodila nová databázová správa C*One, zložená z troch typov serverových nodov:
- Úložiská — (takmer) štandardné servery Cassandra, zodpovedajúce za ukladanie dát na lokálnych diskoch. S rastúcim zaťažením a objemom dát je ich počet možné jednoducho rozšíriť na desiatky a stovky.
- Koordinátory transakci – zabezpečujú vykonávanie transakcií.
- Klienti – servery aplikácií, ktoré realizujú podnikové operácie a iniciujú transakcie. Takýchto klientov môže byť tisíce.
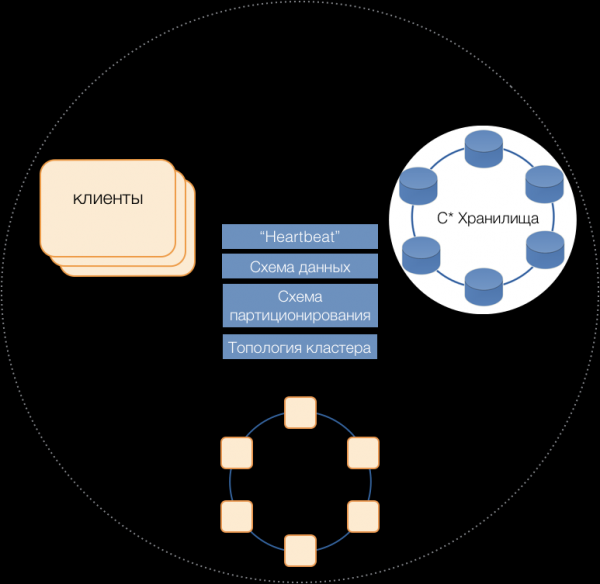
Servery všetkých typov sú súčasťou spoločného klastru, používajú interný protokol správ Cassandra na vzájomnú komunikáciu a na výmenu klastrických informácií. S pomocou Heartbeat sa servery dozvedajú o vzájomných zlyhaniach, udržiavajú jednotnú schému dát – tabuľky, ich štruktúru a replikáciu; schému partitioning, topológiu klastru atď.
Klienti
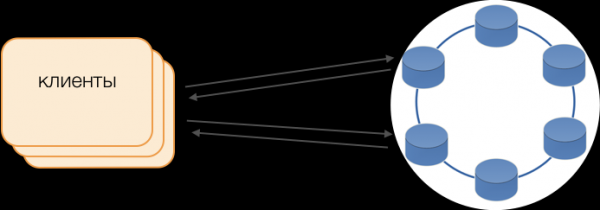
Namiesto štandardných ovládačov sa používa režim Fat Client. Takáto noda neuchováva dáta, ale môže fungovať ako koordinátor vykonávania požiadaviek, teda klient sám vykonáva funkciu koordinátora svojich požiadaviek: dotazuje repliky úložiska a rieši konflikty. To je nielen spoľahlivejšie a rýchlejšie ako štandardný ovládač, ktorý si vyžaduje komunikáciu s vzdialeným koordinátorom, ale aj umožňuje spravovať prenos požiadaviek. Mimo otvorenej transakcie na klientovi sa požiadavky smerujú do úložísk. Ak klient otvoril transakciu, všetky požiadavky v rámci transakcie sa smerujú k koordinátorovi transakcií.
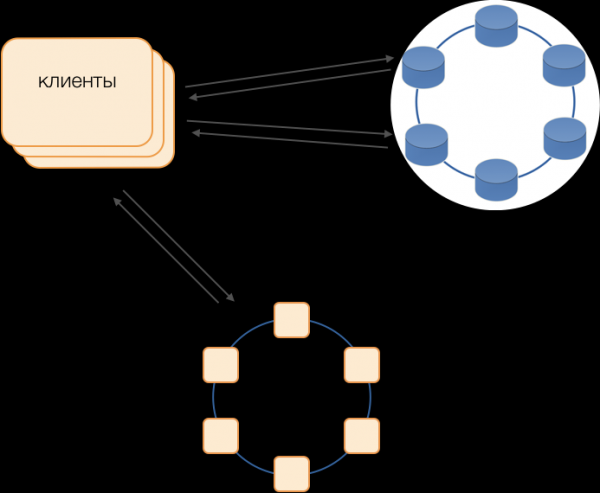
Koordinátor transakcií C*One
Koordinátor – to, čo sme realizovali pre C*One od základov. Zodpovedá za správu transakcií, blokovania a poradia aplikovania transakcií.
Pre každú obsluhovanú transakciu koordinátor generuje časovú značku: každá nasledujúca je väčšia ako u predchádzajúcej transakcie. Keďže v Cassandre je systém riešenia konfliktov založený na časových značkách (z dvoch konfliktujúcich záznamov je aktuálny ten s neskoršou časovou značkou), konflikt bude vždy vyriešený v prospech nasledujúcej transakcie. Takto sme realizovali – lacný spôsob riešenia konfliktov v distribuovanom systéme.
Blokovania
Na zabezpečenie izolácie sme sa rozhodli použiť najjednoduchší spôsob – pesimistické blokovania podľa primárneho kľúča záznamu. Inými slovami, v transakcii je záznam najprv potrebné zablokovať, až potom prečítať, modifikovať a uložiť. Až po úspešnom potvrdení môže byť záznam odblokovaný, aby konkurujúce transakcie mohli jeho používať.
Implementácia takéhoto blokovania je jednoduchá v nedistribuovanej prostredí. V distribuovanej sústave sú dva hlavné prístupy: buď implementovať distribuované blokovanie na klastre, alebo rozložiť transakcie tak, aby transakcie týkajúce sa tej istej položky vždy spracovával ten istý koordinátor.
Keďže v našom prípade sú údaje už rozdelené do skupín lokálnych transakcií v SQL, rozhodlo sa priradiť koordinátorom skupiny lokálnych transakcií: jeden koordinátor vykonáva všetky transakcie s tokenom od 0 do 9, druhý – s tokenom od 10 do 19 a tak ďalej. V dôsledku toho sa každý z inštancií koordinátora stáva majstrom skupiny transakcií.
Vtedy môžu byť blokovania realizované vo forme obyčajného HashMap v pamäti koordinátora.
Zlyhania koordinátorov
Keďže jeden koordinátor obsluhuje výlučne skupinu transakcií, je veľmi dôležité rýchlo určiť fakt jeho zlyhania, aby opätovný pokus o vykonanie transakcie spadal do časového limitu. Aby to bolo rýchle a spoľahlivé, použili sme plne prepojený kvorumový heartbeat protokol:
V každom dátovom centre sa umiestňuje minimálne dve uzly koordinátora. Pravidelne každý koordinátor posiela heartbeat správu ostatným koordinátorom a informuje ich o svojom fungovaní, ako aj o tom, ktoré heartbeat správy dostal naposledy od akých koordinátorov v klastri.
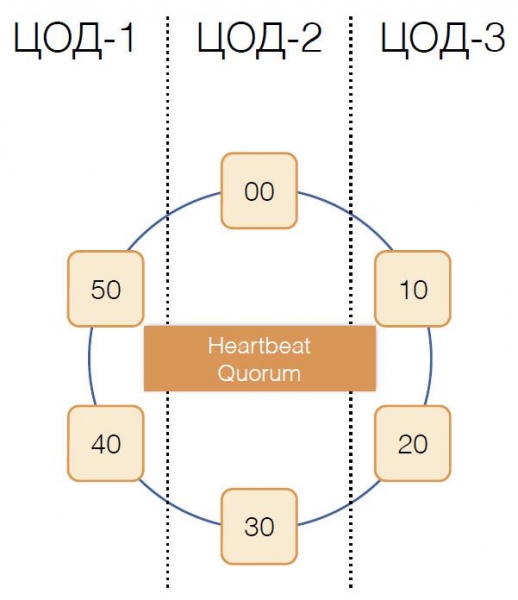
Získaním podobných informácií od ostatných v rámci ich heartbeat správ, sa každý koordinátor rozhoduje, ktoré uzly klastra fungujú a ktoré nie, riadiac sa princípom kvorum: ak uzol X obdržal od väčšiny uzlov v klastri informáciu o normálnom prijímaní správ z uzla Y, znamená to, že Y funguje. A naopak, ak väčšina oznámi, že neobdržala správy z uzla Y, znamená to, že Y zlyhal. Zaujímavé je, že ak kvorum oznámi uzlu X, že od neho už viac správ nedostáva, uzol X sa sám považuje za zlyhaný.
Heartbeat správy sa posielajú s vysokou frekvenciou, približne 20-krát za sekundu, s periódou 50 ms. V Jave je ťažké zaručiť odpoveď aplikácie v priebehu 50 ms kvôli porovnateľnej dĺžke pauz spôsobených garbage collectorom. Podarilo sa nám dosiahnuť taký čas odpovede pomocou garbage collectora G1, ktorý umožňuje nastavit cieľ pre trvanie GC pauz. Avšak, niekedy, dosť zriedkavo, pauzy garbage collectora presahujú 50 ms, čo môže viesť k falošnému zisteniu poruchy. Aby k tomu nedošlo, koordinátor nenahlási poruchu vzdialenej nody pri strate prvého heartbeat správ od nej, iba ak sa stratí niekoľko po sebe idúcich. Tak sme sa dokázali dostať k detekcii poruchy nody koordinátora za 200 ms.
Ale je tiež dôležité rýchlo zistiť, ktorá noda prestala fungovať. Je potrebné s tým niečo urobiť.
Zálohovanie
Klasická schéma predpokladá, že v prípade poruchy majstra sa spustí voľba nového pomocou jedného z algoritmov. Avšak, takéto algoritmy majú dobre známe problémy so zbiehaním v čase a dĺžkou samotného procesu volieb. Takéto dodatočné oneskorenia sme dokázali obísť pomocou schémy náhrady koordinátorov v plne prepojenej sieti:
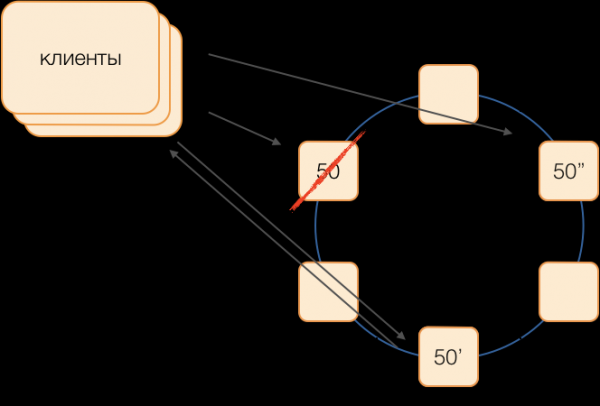
Predpokladajme, že chceme vykonať transakciu v skupine 50. Vopred určíme schému náhrady, to znamená, ktoré nody budú vykonávať transakcie skupiny 50 v prípade poruchy hlavného koordinátora. Naším cieľom je zachovať funkčnosť systému pri poruche dátového centra. Určíme, že prvou rezervou bude noda z iného dátového centra a druhou rezervou bude noda z tretieho. Táto schéma sa vyberá raz a nemení sa, kým sa nezmení topológia klastru, to znamená, kým sa do neho nepridajú nové nody (čo sa stáva veľmi zriedkavo). Poradie voľby nového aktívneho majstra pri poruche starého bude vždy takéto: aktívnym majstrom sa stane prvá rezerva, a ak aj tá prestala fungovať – druhá rezerva.
Takáto schéma je spoľahlivejšia ako univerzálny algoritmus, pretože na aktiváciu nového majstra stačí určenie faktu poruchy starého.
Ale ako majú klienti pochopiť, ktorý z majstrov práve pracuje? Za 50 ms nie je možné rozoslať informácie tisíckam klientov. Môže vzniknúť situácia, keď klient pošle žiadosť o otvorenie transakcie, ešte nevediac, že tento majster už nefunguje, a žiadosť sa zablokuje na timeout. Aby sa tomu predišlo, klienti špekulatívne posielajú žiadosť o otvorenie transakcie priamo majstrovi skupiny a jeho obom rezervám, ale odpovie na túto žiadosť iba ten, kto je v danom momente aktívnym majstrom. Celú následnú komunikáciu v rámci transakcie klient vykonáva iba s aktívnym majstrom.
Rezervní majstri prijaté žiadosti o nie svoje transakcie umiestňujú do fronty nenarodených transakcií, kde zostávajú nejaký čas. Ak aktívny majster zomrie, nový majster spracúva žiadosti o otvorenie transakcií zo svojej fronty a odpovedá klientovi. Ak klient už stihol otvoriť transakciu so starým majstrom, druhá odpoveď sa ignoruje (a, samozrejme, taká transakcia sa neskončí a bude opakovaná klientom).
Ako funguje transakcia
Povedzme, že klient poslal koordinátorovi žiadosť o otvorenie transakcie pre určitú entitu s určitým primárnym kľúčom. Koordinátor túto entitu zablokuje a umiestni ju do tabuľky blokád v pamäti. Ak je to potrebné, koordinátor načíta túto entitu zo skladu a uloží získané údaje do stavu transakcie v pamäti koordinátora.
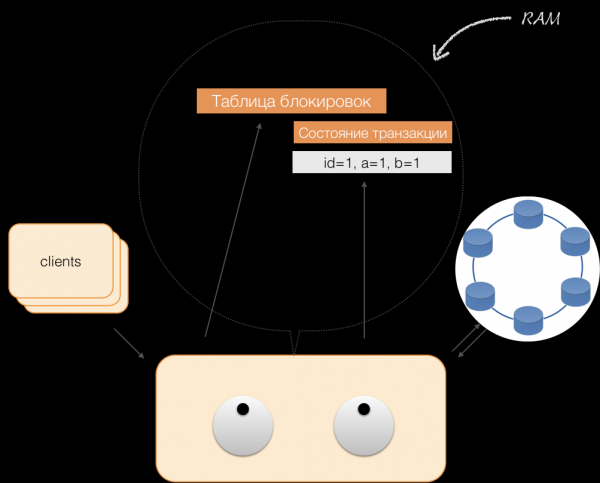
Keď klient chce zmeniť údaje v transakcii, pošle koordinátorovi žiadosť o modifikáciu entity, a ten umiestni nové údaje do tabuľky stavu transakcií v pamäti. Týmto sa zápis uzaviera — zápis do skladu sa neuskutočňuje.
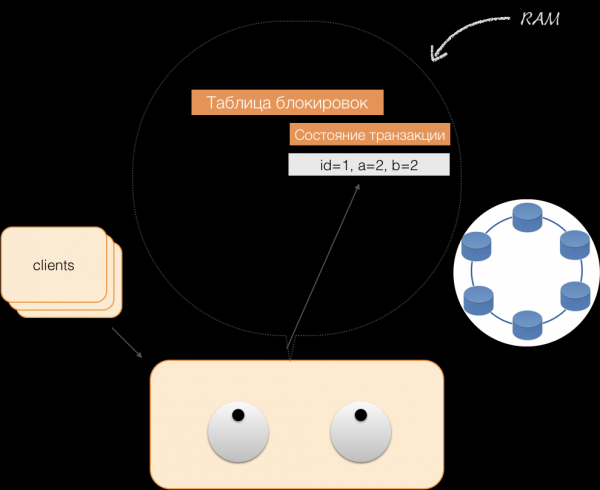
Keď klient vyžaduje v rámci aktívnej transakcie svoje vlastné zmenené údaje, koordinátor postupuje takto:
- ak ID už existuje v transakcii, údaje sa berú z pamäte;
- ak ID v pamäti nie je, chýbajúce údaje sa načítajú z uzlových skladov, skombinujú sa s už existujúcimi v pamäti a výsledok sa odovzdá klientovi.
Takto môže klient prečítať svoje vlastné zmeny, zatiaľ čo iní klienti tieto zmeny nevidia, pretože sú uložené iba v pamäti koordinátora, v uzloch Cassandra ich ešte niet.
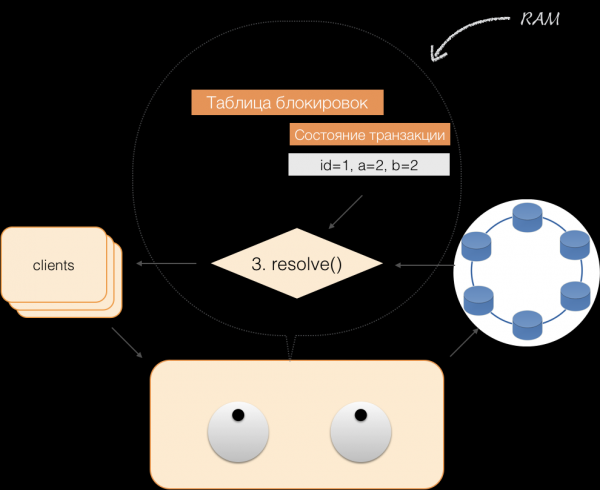
Keď klient odošle commit, stav, ktorý mal služba v pamäti, je koordinátorom uložený do logged batch a už v podobe logged batch odoslaný do úložísk Cassandra. Úložiská robia všetko potrebné, aby bol tento balík atomárne (úplne) aplikovaný, a vracajú odpoveď koordinátorovi, ktorý potom uvoľní zámky a potvrdí úspešnosť transakcie klientovi.
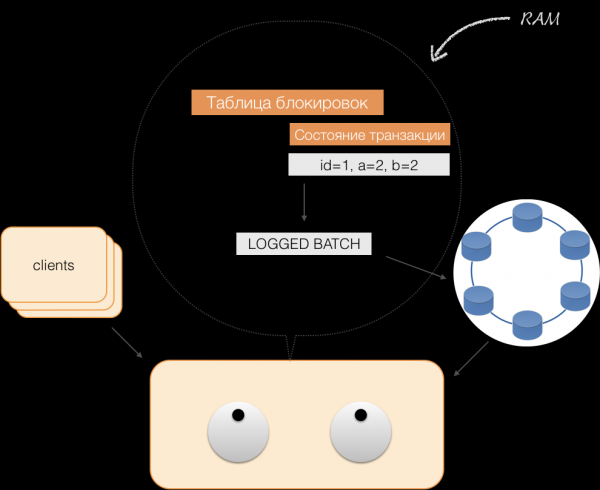
A pre vrátenie koordinátorovi stačí len uvoľniť pamäť, ktorú zaberalo stav transakcie.
V dôsledku vyššie popísaných vylepšení sme implementovali princípy ACID:
- Atomarita. To je záruka, že žiadna transakcia nebude v systéme zaznamenaná čiastočne, buď budú vykonané všetky jej podoperácie, alebo sa nevykoná ani jedna. U nás tento princíp je dodržiavaný vďaka logged batch v Cassandre.
- Konzistencia. Každá úspešná transakcia podľa definície zaznamenáva iba prípustné výsledky. Ak sa po otvorení transakcie a vykonaní časti operácií zistí, že výsledok je neprípustný, vykoná sa vrátenie.
- Izolovanosť. Pri vykonávaní transakcie paralelné transakcie nesmú ovplyvniť jej výsledok. Súťažné transakcie sú izolované pomocou pesimistických zámkov na koordinátorovi. Pre čítania mimo transakcie sa dodržiava princíp izolovanosti na úrovni Read Committed.
- Trvácnosť. Nezávisle od problémov na nižších úrovniach — výpadok systému, porucha hardvéru — zmeny vykonané úspešne dokončenou transakciou musia zostať uložené po obnovení fungovania.
Čítanie podľa indexov
Vezmime si jednoduchú tabuľku:
CREATE TABLE photos (
id bigint primary key,
owner bigint,
modified timestamp,
…)
Má ID (primárny kľúč), vlastníka a dátum zmeny. Potrebujeme vykonať veľmi jednoduchý dotaz — vybrať údaje podľa vlastníka s dátumom zmeny „za posledných 24 hodín“.
SELECT *
WHERE owner=?
AND modified>?
Aby sa takýto dotaz vykonal rýchlo, v klasickej SQL DBMS je potrebné vytvoriť index podľa stĺpcov (owner, modified). Niečo také môžeme urobiť celkom jednoducho, pretože teraz máme záruky ACID!
Indexy v C*One
Existuje pôvodná tabuľka s fotografiami, v ktorej je ID záznamu primárnym kľúčom.
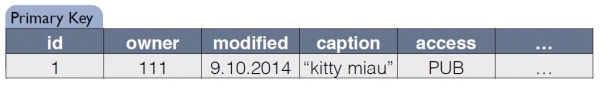
Pre systém C*One sa vytvára nová tabuľka, ktorá je kópiou pôvodnej. Kľúč sa zhoduje s indexovým výrazom a zahŕňa aj primárny kľúč záznamu z pôvodnej tabuľky.
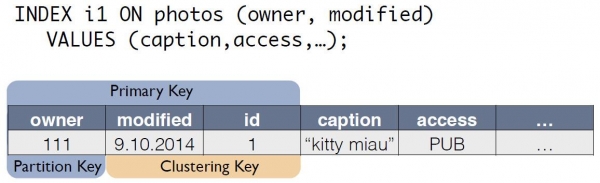
Dotaz na „majiteľa za posledných 24 hodín“ teraz môžeme prepísať ako select z inej tabuľky:
SELECT * FROM i1_test
WHERE owner=?
AND modified>?
Konzistencia údajov pôvodnej tabuľky photos a indexnej tabuľky i1 je automaticky udržiavaná koordinátorom. Na základe samotnej schémy údajov pri obdržaní zmeny koordinátor generuje a uchováva zmenu nielen pre hlavnú tabuľku, ale aj pre zmeny kópií. Nebudú vykonávané žiadne ďalšie akcie s indexovou tabuľkou, logy sa nečítajú, zámky sa nepoužívajú. To znamená, že pridávanie indexov takmer nespotrebováva zdroje a prakticky neovplyvňuje rýchlosť aplikácie modifikácií.
S pomocou ACID sa nám podarilo implementovať indexy „ako v SQL“. Tieto indexy majú konzistenciu, môžu byť škálovateľné, fungujú rýchlo, môžu byť zložené a sú integrované do jazyka dotazov CQL. Na podporu indexov nie je potrebné meniť aplikačný kód. Všetko je jednoduché, ako v SQL. A čo je najdôležitejšie, indexy neovplyvňujú rýchlosť vykonávania modifikácií pôvodnej tabuľky transakcií.
Čo sa podarilo
C*One sme vyvinuli pred tromi rokmi a uviedli do komerčnej prevádzky.
Aký výsledok sme teda dosiahli? Posúďme to na príklade subsystému spracovania a ukladania fotografií, jedného z najdôležitejších typov údajov v sociálne sieti. Hovoríme nielen o samotných snímkach, ale aj o rôznych metainformáciách. V súčasnosti v „Odnoklassnikoch“ existuje približne 20 miliárd takýchto záznamov, systém spracováva 80 000 dotazov na čítanie za sekundu, do 8 000 ACID transakcií za sekundu týkajúcich sa modifikácie údajov.
Keď sme používali SQL s faktorom replikácie = 1 (ale v RAID 10), metainformácie o fotografiách sa ukladali na vysoko dostupnom klastri zo 32 strojov s Microsoft SQL Serverom (plus 11 záložných). Takisto bolo vyčlenených 10 serverov na ukladanie záloh. Celkovo teda 50 nákladných strojov. Systém pritom pracoval s nominálnym zaťažením, bez rezervy.
Po migrácii na nový systém sme dosiahli faktor replikácie = 3 — po kópii v každom dátovom centre. Systém pozostáva z 63 uzlov úložiska Cassandra a 6 strojov koordinátorov, teda dokopy 69 serverov. Tieto stroje sú však výrazne lacnejšie, ich celková cena predstavuje približne 30 % ceny systému na SQL. Zároveň sa zaťaženosť udržuje na úrovni 30 %.
S implementáciou C*One klesli aj oneskorenia: v SQL operácia zápisu trvala približne 4,5 ms. V C*One — približne 1,6 ms. Dĺžka transakcie je v priemere kratšia ako 40 ms, commit sa vykonáva za 2 ms, dĺžka čítania a zápisu — v priemere 2 ms. 99. percentil — len 3-3,1 ms, počet timeoutov klesol stokrát — všetko vďaka širokému využívaniu špekulácií.
K súčasnému momentu bola z prevádzky vypustená väčšina uzlov SQL Server, nové produkty sa vyvíjajú len s využitím C*One. Prispôsobili sme C*One na prácu v našom cloude. , čo umožnilo urýchliť nasadenie nových klastrov, zjednodušiť konfiguráciu a automatizovať prevádzku. Bez zdrojového kódu by to bolo podstatne zložitejšie a krkolomne.
V súčasnosti pracujeme na migrácii našich ďalších úložísk do cloudu — ale to je už úplne iný príbeh.
Zdroj: habr.com
