

Toto je článok preklad mojej článku na medium — , ktorý sa ukázal byť dosť populárny, asi kvôli svojej jednoduchosti. Preto som sa rozhodol napísať ho v slovenčine a trochu doplniť, aby bežný človek, ktorý nie je špecialista na prácu s dátami, pochopil, čo je to úložisko dát (DW), čo je to dátové jazero (Data Lake) a ako spolu koexistujú.
Prečo som sa rozhodol napísať o dátovom jazere? Pracujem s dátami a analytikou viac ako 10 rokov, a teraz určite pracujem s veľkými dátami v Amazon Alexa AI v Cambridge, ktorý je blízko Bostonu, aj keď sám žijem vo Victorii na ostrove Vancouver a často som v Bostone, Seattli a Vancouveri, a niekedy dokonca aj v Moskve vystupujem na konferenciách. Takisto čas od času píšem, ale píšem prevažne v angličtine a už som napísal , zároveň mám potrebu zdieľať trendy analytiky zo Severnej Ameriky, a občas píšem do .
Vždy som pracoval s úložiskami dát, a od roku 2015 som sa intenzívne zaoberal Amazon Web Services, a vôbec som prešiel na cloudovú analytiku (AWS, Azure, GCP). Sledoval som vývoj riešení pre analytiku od roku 2007 a sám som dokonca pracoval u dodávateľa úložiska dát Teradata a implementoval to v Sberbank, vtedy vznikla Big Data s Hadoop. Všetci začali hovoriť, že éra úložísk skončila a teraz sa všetko robí na Hadoop, a potom sa už hovorilo o Dátovom Jazere, opäť že už určite úložisku zomrela.
V tomto článku sa pozrieme na to, čo je to dátové jazero. Článok je určený pre ľudí, ktorí majú málo skúseností s úložiskami dát alebo vôbec žiadne.
Na obrázku je jazero Bled, to je jedno z mojich obľúbených jazier, aj keď som tam bol len raz, ale zapamätal som si ho na celý život. Ale budeme sa rozprávať o inom type jazera — dátovom jazere. Možno mnohí z vás už nie raz počuli tento termín, ale ďalšia definícia nikomu neublíži.
Predovšetkým tu sú najpopulárnejšie definície Dátového Jazera:
"súborové úložisko všetkých typov surových dát, ktoré sú dostupné na analýzu kýmkoľvek v organizácii" — Martin Fowler.
„Ak si myslíte, že dátová vitrína je ako fľaša vody — prefiltrovanej, zabalené a pripravené na pohodlné použitie, tak jazero dát je pre nás obrovská nádrž s vodou v jej prirodzenej podobe. Používatelia môžu čerpať vodu pre seba, ponoriť sa do hĺbky, preskúmavať.“ — James Dickson.
Teraz presne vieme, že jazero dát je o analýze, umožňuje nám uchovávať veľké objemy údajov v ich pôvodnej forme a máme potrebný a pohodlný prístup k údajom.
Často rád zjednodušujem veci, ak môžem vysvetliť zložitý termín jednoduchými slovami, znamená to, že som pochopil, ako to funguje a na čo je to potrebné. Napríklad, keď som prechádzal iPhone v galérii fotografií, uvedomil som si, že to je skutočné jazero dát, dokonca som urobil snímku pre konferencie:
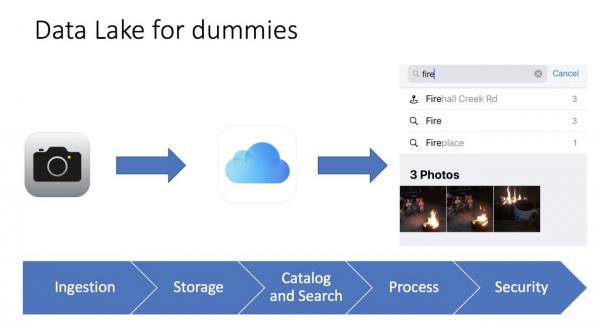
Všetko je veľmi jednoduché. Urobíme fotografiu mobilom, fotografia sa uloží do telefónu a môže byť uložená v iCloudu (úložisko v oblaku). Telefón tiež zhromažďuje metaúdaje fotografie: čo je zobrazené, geolokačné údaje, čas. Ako výsledok, môžeme použiť pohodlné rozhranie iPhonu na nájdenie našej fotografie a pritom vidíme aj ukazovatele, napríklad, keď hľadám fotografie so slovom oheň (fire), nájdem 3 fotografie so zobrazením ohňa. Pre mňa je to ako nástroj Business Intelligence, ktorý funguje veľmi rýchlo a presne.
A samozrejme, nesmieme zabudnúť na bezpečnosť (autorizáciu a autentifikáciu), inak môžu naše údaje jednoducho preniknúť do verejného prístupu. Je veľa správ o veľkých korporáciách a startupoch, ktorých údaje sa dostali do verejného prístupu z dôvodu nedbanlivosti vývojárov a nedodržiavania jednoduchých pravidiel.
Aj taký jednoduchý obrázok nám pomáha predstaviť si, čo je to jazero dát, jeho rozdiely od tradičného úložiska dát a jeho základné prvky:
- Načítanie dát (Ingestion) — kľúčová zložka jazera dát. Údaje môžu vstupovať do úložiska dát dvoma spôsobmi — batch (nahrávanie v intervaloch) a streaming (údržba dátového toku).
- Súborové úložisko (Storage) — hlavná zložka jazera dát. Potrebujeme, aby bolo úložisko ľahko škálovateľné, mimoriadne spoľahlivé a malo nízke náklady. Napríklad v AWS je to S3.
- Katalóg a Hľadanie (Katalóg a Hľadanie) — aby sme sa vyhli Bažinám Dát (to je, keď nahádžeme všetky dáta do jedného miesta a potom s nimi nie je možné pracovať), musíme vytvoriť vrstvu metadát na klasifikáciu dát, aby používatelia mohli ľahko nájsť dáta, ktoré potrebujú na analýzu. Navyše, môžeme použiť ďalšie riešenia na hľadanie, ako ElasticSearch. Hľadanie pomáha používateľovi nájsť potrebné dáta cez pohodlné rozhranie.
- Spracovanie (Proces) — tento krok zodpovedá za spracovanie a transformáciu dát. Môžeme transformovať dáta, meniť ich štruktúry, čistiť ich a mnoho ďalšieho.
- Bezpečnosť (Bezpečnosť) — je dôležité venovať čas návrhu bezpečnosti riešenia. Napríklad, šifrovanie dát počas ukladania, spracovania a preberania. Dôležité je používať metódy autentifikácie a autorizácie. Na záver, potrebujeme nástroj na audit.
Z praktického hľadiska môžeme charakterizovať jazero dát troma atribútmi:
- Zhromažďujte a uložte čokoľvek — jazero dát obsahuje všetky dáta, ako surové neopracované dáta za akékoľvek obdobie, tak aj spracované/čistené dáta.
- Hlboká analýza — jazero dát umožňuje používateľom skúmať a analyzovať dáta.
- Flexibilný prístup — jazero dát zabezpečuje flexibilný prístup k rôznym dátam a rôznym scenárom.
Teraz môžeme hovoriť o rozdieloch medzi úložiskom dát a jazerom dát. Zvyčajne sa ľudia pýtajú:
- A čo úložisko dát?
- Zamieňame úložisko dát za jazero dát alebo ho rozširujeme?
- Môžeme sa skutočne zaobísť bez jazera dát?
Ak by sme to zhrnuli, jasná odpoveď neexistuje. Všetko závisí od konkrétnej situácie, zručností v tíme a rozpočtu. Napríklad migrácia úložiska dát na Oracle do AWS a vytvorenie jazera dát dcérskou spoločnosťou Amazon — Woot — .
Na druhej strane, dodávateľ Snowflake tvrdí, že sa už nemusíte obávať jazera dát, pretože ich dátová platforma (do roku 2020 to bolo úložisko dát), umožňuje skombinovať jazero dát a úložisko dát. Pracoval som trochu so Snowflake a je to naozaj jedinečný produkt, ktorý to dokáže. Cena, to je iná otázka.
Na záver, môj osobný názor je, že stále potrebujeme dátové sklady ako hlavný zdroj dát pre naše reporty, a všetko, čo sa tam nezmestí, ukladáme do dátového jazera. Úlohou analytiky je poskytnúť jednoduchý prístup biznisu na prijímanie rozhodnutí. Nezáleží na tom, čo si myslíme, biznisoví používatelia pracujú efektívnejšie s dátovým skladom než s dátovým jazerom, napríklad v Amazone – existuje Redshift (analytický dátový sklad) a je tu Redshift Spectrum/Athena (SQL rozhranie pre dátové jazero v S3 na báze Hive/Presto). To isté platí aj pre ďalšie moderné analytické dátové sklady.
Poďme sa pozrieť na typickú architektúru dátového skladu:
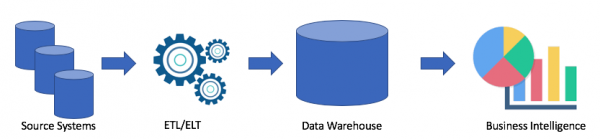
Je to klasické riešenie. Máme systémy zdrojov, pomocou ETL/ELT prenášame dáta do analytického dátového skladu a pripájame ich k riešeniu Business Intelligence (moje obľúbené je Tableau, a vaše?).
Takéto riešenie má nasledujúce nevýhody:
- ETL/ELT operácie si vyžadujú čas a zdroje.
- Spravidla sú náklady na ukladanie dát v analytickom dátovom sklade vysoké (napríklad Redshift, BigQuery, Teradata), pretože musíme zakúpiť celý cluster.
- Biznisoví používatelia majú prístup k vyčisteným a často agregovaným dátam a nemajú možnosť získať surové dáta.
Samozrejme, všetko závisí od vášho prípadu. Ak nemáte problémy so svojím dátovým skladom, potom naozaj nepotrebujete dátové jazero. Ale keď sa objavia problémy s nedostatkom miesta, výkonom alebo cena je rozhodujúcim faktorom, je možné zvážiť variant dátového jazera. Preto je dátové jazero veľmi populárne. Tu je príklad architektúry dátového jazera:
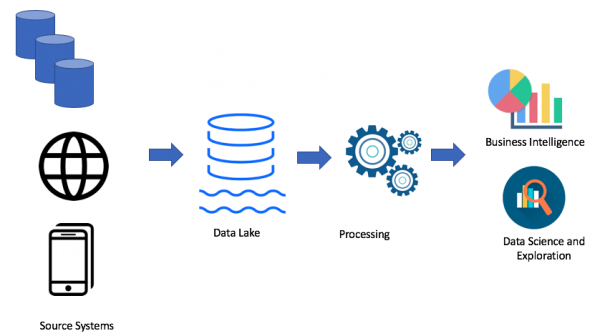
Použitím prístupu dátového jazera nahrávame surové dáta do nášho dátového jazera (v sériovom alebo streamovom režime), následne spracovávame dáta podľa potreby. Dátové jazero umožňuje biznisovým používateľom vytvárať svoje vlastné transformácie dát (ETL/ELT) alebo analyzovať dáta v riešeniach Business Intelligence (ak je k dispozícii potrebný ovládač).
Cieľom akéhokoľvek analytického riešenia je slúžiť biznisovým používateľom. Preto by sme vždy mali vychádzať z požiadaviek biznisu. (V Amazone je to jeden z princípov – pracovať spätným spôsobom).
Pri práci s dátovým skladom aj dátovým jazrom môžeme porovnať obe riešenia:
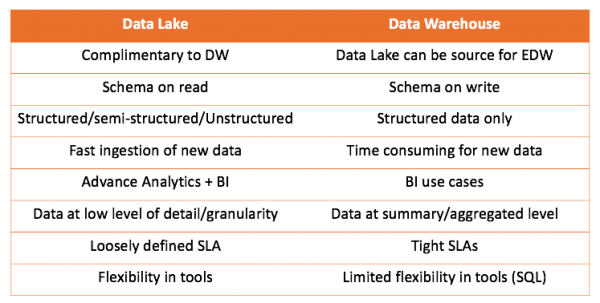
Hlavný záver, ktorý môžeme urobiť, je ten, že úložisko dát nesúťaží s dátovým jazerom, ale skôr ho dopĺňa. Ale je to na vás, čo sa hodí pre vašu situáciu. Vždy je zaujímavé to vyskúšať a spraviť si vlastné závery.
Rád by som sa tiež podelil o jeden z prípadov, keď som začal používať prístup dátového jazera. Všetko je dosť banálne, pokúsil som sa využiť nástroj ELT (mali sme Matillion ETL) a Amazon Redshift, moje riešenie fungovalo, ale nevychádzalo z požiadaviek.
Potreboval som získať webové logy, transformovať ich a agregovať, aby som poskytol dáta pre 2 prípady:
- Tím marketingu chcel analyzovať aktivitu robotov pre SEO
- IT tím chcel sledovať metriky výkonu webových stránok
Veľmi jednoduché, naozaj jednoduché logy. Tu je príklad:
https 2018-07-02T22:23:00.186641Z app/my-loadbalancer/50dc6c495c0c9188
192.168.131.39:2817 10.0.0.1:80 0.086 0.048 0.037 200 200 0 57
"GET https://www.example.com:443/ HTTP/1.1" "curl/7.46.0" ECDHE-RSA-AES128-GCM-SHA256 TLSv1.2
arn:aws:elasticloadbalancing:us-east-2:123456789012:targetgroup/my-targets/73e2d6bc24d8a067
"Root=1-58337281-1d84f3d73c47ec4e58577259" "www.example.com" "arn:aws:acm:us-east-2:123456789012:certificate/12345678-1234-1234-1234-123456789012"
1 2018-07-02T22:22:48.364000Z "authenticate,forward" "-" "-"
Jeden súbor mal hmotnosť 1-4 megabajty.
Ale bol tu jeden problém. Mali sme 7 domén po celom svete a za jeden deň sa vytvorilo 7000 súborov. To nie je veľmi veľký objem, celkom 50 gigabajtov. Ale veľkosť nášho klastru Redshift bola tiež malá (4 uzly). Nahrávanie tradičným spôsobom jedného súboru trvalo asi minútu. To znamená, že sa problém nedal vyriešiť priamo. A to bol ten prípad, keď som sa rozhodol použiť prístup dátového jazera. Riešenie vyzeralo približne takto:
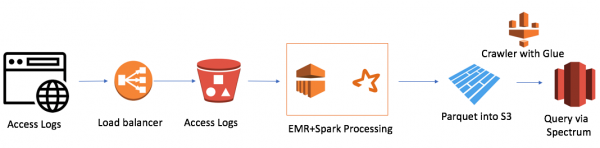
Je to dosť jednoduché (chcem poznamenať, že výhoda práce v cloude je jednoduchosť). Použil som:
- AWS Elastic Map Reduce (Hadoop) ako výpočtovú silu
- AWS S3 ako úložisko súborov s možnosťou šifrovania dát a obmedzenia prístupu
- Spark ako InMemory výpočtovú silu a PySpark pre logiku a transformáciu dát
- Parquet ako výsledok práce Spark
- AWS Glue Crawler ako zberač metadát o nových dátach a partitách
- Redshift Spectrum ako SQL rozhranie k dátovému jazeru pre existujúcich používateľov Redshift
Najmenší klaster EMR+Spark spracovával celú várku súborov za 30 minút. Existujú aj ďalšie prípady pre AWS, zvlášť veľa spojených s Alexou, kde je dát veľmi mnoho.
Nedávno som sa dozvedel o jednej z nevýhod dátového jazera — o GDPR. Problém nastáva, keď klient požaduje jeho odstránenie a údaje sú v jednom z súborov, nemôžeme použiť jazyk manipulácie s údajmi a operáciu DELETE ako v databáze.
Dúfam, že článok objasnil rozdiel medzi dátovým skladom a dátovým jazerom. Ak to bolo zaujímavé, môžem preložiť aj ďalšie svoje články alebo články odborníkov, ktorých čítam. Rád sa tiež podelím o riešenia, s ktorými pracujem, a ich architektúru.
Zdroj: habr.com
