

Klasická otázka, ktorú si vývojár kladie svojmu DBA alebo majiteľ podniku – konzultantovi pre PostgreSQL, takmer vždy znie rovnako: „Prečo sa dopyty na databáze vykonávajú tak dlho?“
Tradičná súprava príčin:
- neefektívny algoritmus
keď sa rozhodnete vykonať JOIN viacerých CTE na niekoľkých desiatkach tisíc záznamov - neaktuálna štatistika
ak sa skutočné rozloženie dát v tabuľke už výrazne líši od toho, ktoré bolo zhromaždené ANALYZE naposledy - problém so zdrojmi
a už nestačí pridelený výpočtový výkon CPU, pamäť neustále naberá gigabajty alebo disk nestíha za všetkými 'požiadavkami' DB - zámky od konkurenčných procesov
A ak sú zámky dostatočne zložité na chytanie a analýzu, pre všetko ostatné nám stačí plán dopytu, ktorý môžeme získať pomocou (najlepšie, samozrejme, hneď EXPLAIN (ANALYZE, BUFFERS) …) alebo .
Ale, ako sa uvádza v tej istej dokumentácii,
„Porozumenie plánu je umenie, a aby ste ho zvládli, potrebujete určitú skúsenosť, …“
Ale môžete sa zaobísť aj bez neho, ak použijete vhodný nástroj!
Ako zvyčajne vyzerá plán dopytu? Takto:
Index Scan using pg_class_relname_nsp_index on pg_class (actual time=0.049..0.050 rows=1 loops=1)
  Index Cond: (relname = $1)
  Filter: (oid = $0)
  Buffers: shared hit=4
  InitPlan 1 (returns $0,$1)
    ->  Limit (actual time=0.019..0.020 rows=1 loops=1)
          Buffers: shared hit=1
          ->  Seq Scan on pg_class pg_class_1 (actual time=0.015..0.015 rows=1 loops=1)
                Filter: (relkind = 'r'::"char")
                Rows Removed by Filter: 5
                Buffers: shared hit=1
alebo takto:
"Append  (cost=868.60..878.95 rows=2 width=233) (actual time=0.024..0.144 rows=2 loops=1)"
"  Buffers: shared hit=3"
"  CTE cl"
"    ->  Seq Scan on pg_class  (cost=0.00..868.60 rows=9972 width=537) (actual time=0.016..0.042 rows=101 loops=1)"
"          Buffers: shared hit=3"
"  ->  Limit  (cost=0.00..0.10 rows=1 width=233) (actual time=0.023..0.024 rows=1 loops=1)"
"        Buffers: shared hit=1"
"        ->  CTE Scan on cl  (cost=0.00..997.20 rows=9972 width=233) (actual time=0.021..0.021 rows=1 loops=1)"
"              Buffers: shared hit=1"
"  ->  Limit  (cost=10.00..10.10 rows=1 width=233) (actual time=0.117..0.118 rows=1 loops=1)"
"        Buffers: shared hit=2"
"        ->  CTE Scan on cl cl_1  (cost=0.00..997.20 rows=9972 width=233) (actual time=0.001..0.104 rows=101 loops=1)"
"              Buffers: shared hit=2"
"Planning Time: 0.634 ms"
"Execution Time: 0.248 ms"
Ale čítať plán textom „z papiera“ – je veľmi ťažké a neprehľadné:
- v uzle sa uvádza súčet po zdrojoch podstromu
teda, aby sme pochopili, ako dlho trvalo vykonanie konkrétneho uzla, alebo koľko presne tieto čítania z tabuľky vyžiadali údajov z disku — musíme akosi odčítať jedno od druhého - čas uzla je potrebný násobiť s loops
áno, odčítanie ešte nie je najťažšia operácia, ktorú treba robiť „v hlave“ — veď čas vykonania je uvedený priemerný pre jedno vykonanie uzla, a tých môže byť stovky - no, a to všetko dohromady bráni odpovedať na hlavnú otázku — takže kto je „najslabší článok“?
Keď sme sa pokúsili vysvetliť toto niekoľkým stovkám našich vývojárov, tak sme pochopili, že z pohľadu to vyzerá asi takto:
A, znamená to, že potrebujeme...
Nástroj
V ňom sme sa pokúsili zhromaždiť všetky kľúčové mechaniky, ktoré pomáhajú podľa plánu a požiadavky pochopiť, „kto je vinný a čo robiť“. No, a sčasťou našich skúseností zdieľať s komunitou.
Vitajte a používajte —
Prehľadnosť plánov
Je ľahké pochopiť plán, keď vyzerá takto?
Seq Scan on pg_class (actual time=0.009..1.304 rows=6609 loops=1)
  Buffers: shared hit=263
Planning Time: 0.108 ms
Execution Time: 1.800 ms
Nie veľmi.
Ale takto, v skrátenej forme, keď sú kľúčové ukazovatele oddelené — už je to oveľa zrozumiteľnejšie:
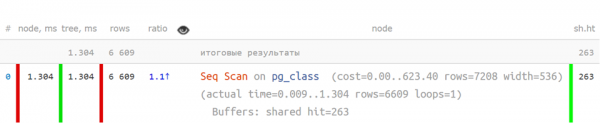
Ale ak je plán zložitejší — na pomoc príde piechart rozdelenia času podľa uzlov:
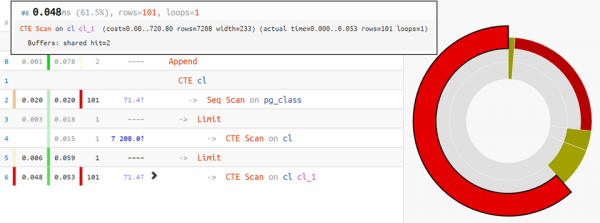
No, a pre najzložitejšie varianty na pomoc spěchajú diagram vykonania:
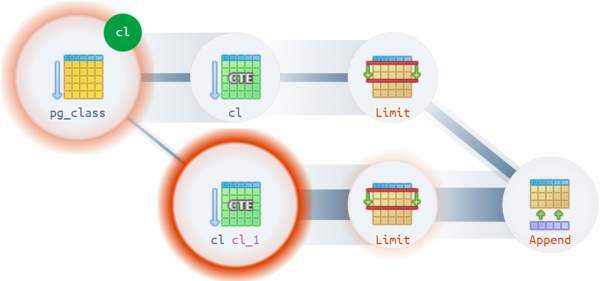
Napríklad, existujú dostatočne netriviálne situácie, keď plán môže mať viac ako jeden skutočný koreň:
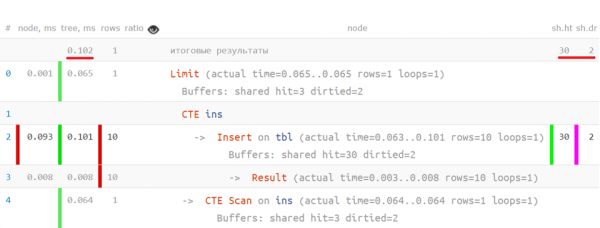
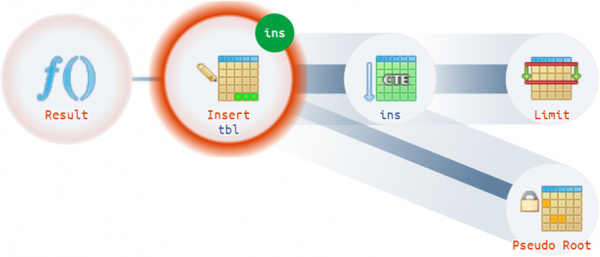
Štrukturálne tipy
No, a ak všetka štruktúra plánu a jej slabé miesta už sú rozložené a viditeľné — prečo by ich nemohli zvýrazniť vývojárovi a nevysvetliť 'po slovensky'?
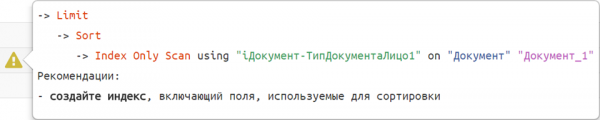 Takéto šablóny odporúčaní sme už zhromaždili desať až dvadsať.
Riadkový profiler dotazu
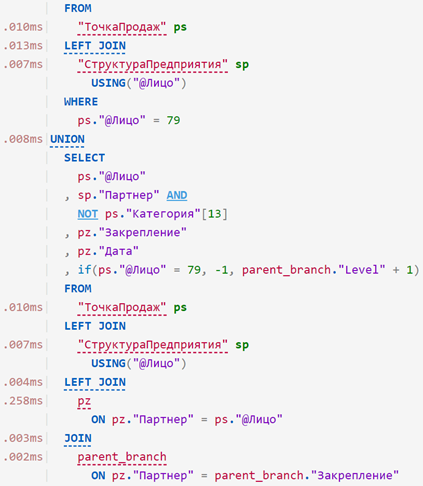
Teraz, ak na analyzovaný plán superponujeme pôvodný dotaz, môžeme vidieť, koľko času trvalo na každý jednotlivý operátor — približne takto:
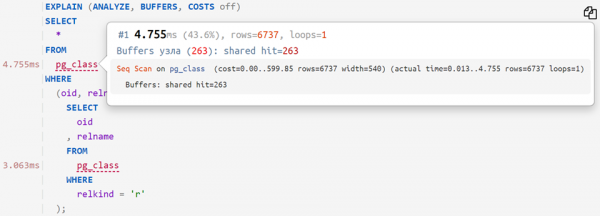
… alebo dokonca takto:
Vkladanie parametrov do dotazu
Ak ste 'pripojili' k plánu nielen dotaz, ale aj jeho parametre z DETAIL riadku logu, môžete ho dodatočne skopírovať v jednom z variantov:
- s vložením hodnôt do dotazu
na okamžité vykonanie na svojej databáze a ďalšiu profiláciuSELECT 'const', 'param'::text; - s vložením hodnôt cez PREPARE/EXECUTE
na simuláciu fungovania plánovača, keď môže byť parametrová časť ignorovaná — napríklad pri práci s delenými tabuľkamiDEALLOCATE ALL; PREPARE q(text) AS SELECT 'const', $1::text; EXECUTE q('param'::text);
Archív plánov
Vkladajte, analyzujte, zdieľajte s kolegami! Plány zostanú v archíve a neskôr sa k nim môžete vrátiť:
Ale ak nechcete, aby váš plán videli iní, nezabudnite zaškrtnúť políčko „nepublikovať v archíve”.
V nasledujúcich článkoch poviem o tých ťažkostiach a riešeniach, ktoré vznikajú pri analýze plánu.
Zdroj: habr.com
