

Úvod
Ahoj!
V tomto článku sa podelím o skúsenosti s navrhovaním mikroservisnej architektúry pre projekt používajúci neuronové siete.
Povedzme si niečo o požiadavkách na architektúru, pozrieme sa na rôzne štrukturálne diagramy, rozoberieme jednotlivé komponenty hotovej architektúry a zhodnotíme technické metriky riešenia.
Príjemné čítanie!
Niekoľko slov o úlohe a jej riešení
Hlavná myšlienka – na základe fotografie posúdiť atraktivitu človeka na desiatichbodovej škále.
V tomto článku sa zameriame na popis použitia neuronových sietí aj na proces prípravy dát, trénovania. Avšak v jednom z nasledujúcich príspevkov sa určite vrátime k rozboru pipeline hodnotenia na hĺbkovej úrovni.
Teraz sa pozrieme na pipeline hodnotenia z vyššieho pohľadu a sústredíme sa na interakciu mikroservisov v kontexte celkovej architektúry projektu.
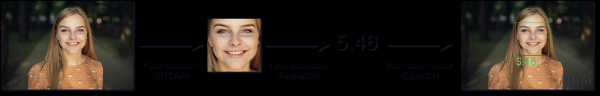
Pri práci na pipeline hodnotenia atraktivity bola úloha rozložená na nasledujúce zložky:
- Detekcia tvárí na fotografiách
- Hodnotenie každého z tvárí
- Renderovanie výsledku
Prvá úloha sa rieši pomocou predtrénovanej . Pre druhú úlohu bola trénovaná konvolučná neurónová sieť na PyTorch, pričom ako backbone bol použitý – zo zháňania „kvalita / rýchlosť inferencie na CPU“
Funkčný diagram pipeline hodnotenia
Analýza požiadaviek na architektúru projektu
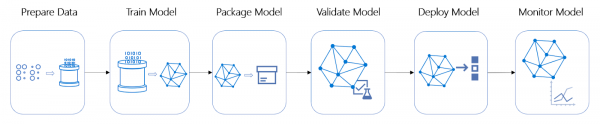
V životnom cykle projekty sú fázy práce na architektúre a automatizácii nasadenia modelu často jedny z najnáročnejších na čas a zdroje.
Životný cyklus ML projektu
Tento projekt nie je výnimkou – rozhodlo sa obaliť pipeline hodnotenia do online služby, na čo bolo potrebné ponoriť sa do architektúry. Boli stanovené nasledujúce základné požiadavky:
- Jednotná úložisko logov – všetky služby musia zapisovať logy na jedno miesto, ktoré by sa malo pohodlne analyzovať
- Možnosť horizontálneho škálovania služby hodnotenia – ako najpravdepodobnejšie Bottleneck
- Na hodnotenie každej fotografie by malo byť vyhradené rovnaké množstvo procesorových zdrojov – aby sa predišlo výkyvom v rozdelení času na inferenciu
- Rýchle (pre)nasadenie ako konkrétnych služieb, tak aj stacku ako celku
- Možnosť, ak to bude potrebné, používať v rôznych službách spoločné objekty
Architektúra
Analýza požiadaviek ukázala, že mikroservisná architektúra prakticky dokonale zapadá.
Aby sme sa zbavili zbytočných starostí, ako frontend bol vybraný Telegram API.
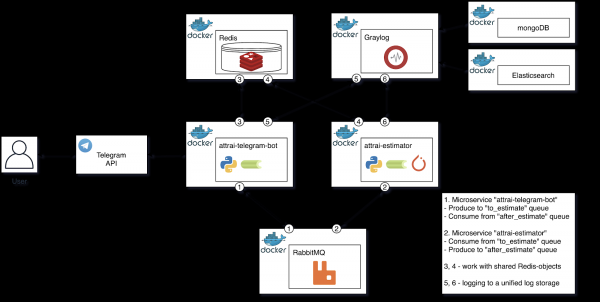
Najprv si pozrime štrukturálny diagram hotovej architektúry, následne prejdeme k popisu každého z komponentov a taktiež formálne zadefinujeme proces úspešného spracovania obrázka.
Štrukturálny diagram hotovej architektúry
Podrobnejšie si prejdeme každý z komponentov diagramu a označíme ich Single Responsibility v procese hodnotenia obrázka.
Mikroservis „attrai-telegram-bot“
Tento mikroservis encapsuluje všetky interakcie s Telegram API. Môžeme identifikovať dva hlavné scenáre – práca s používateľským obrázkom a práca s výsledkom hodnotiaceho pipeline. Oba scenáre si stručne prejdeme.
Pri prijatí používateľskej správy s obrázkom:
- Prebieha filtrovanie, ktoré pozostáva z nasledujúcich kontrol:
- Prítomnosti optimálnej veľkosti obrázka
- Počtu obrázkov používateľa, ktoré už sú v poradí
- Po úspešnom prechode primárnou filtráciou sa obrázok ukladá do docker volume
- Do fronty „to_estimate“ sa vytvorí úloha, v ktorej sa nachádza aj cesta k obrázku, ktorý je uložený v našom volume
- Ak boli uvedené fázy úspešne prekonané – používateľ obdrží správu s približným časom spracovania obrázka, ktorý sa vypočíta na základe počtu úloh vo fronte. V prípade chyby bude používateľ jasne informovaný prostredníctvom správy, ktorá obsahuje informácie o tom, čo sa mohlo pokaziť.
Taktiež tento mikroservis, ako celery worker, sleduje frontu „after_estimate“, ktorá je určená pre úlohy, ktoré prešli hodnotiacim pipeline.
Pri prijatí novej úlohy z „after_estimate“:
- Ak bol obrázok úspešne spracovaný – zašleme výsledok používateľovi, ak nie – informujeme o chybe
- Odstraňujeme obrázok, ktorý je výsledkom hodnotiaceho pipeline
Mikroservis hodnotenia „attrai-estimator“
Tento mikroservis je celery worker a encapsuluje všetko, čo sa týka hodnotiaceho pipeline obrázka. Algoritmus práce je jednoduchý – prejdeme si ho.
Pri prijatí novej úlohy z „to_estimate“:
- Prechádzame obrázok hodnotiacim pipeline:
- Načítame obrázok do pamäte
- Prispôsobujeme obrázok na požadovanú veľkosť
- Nájdeme všetky tváre (MTCNN)
- Hodnotíme všetky tváre (obalíme nájdené tváre z predchádzajúceho kroku do dávky a vykonáme inferenciu s ResNet34)
- Renderujeme konečný obrázok
- Nakreslíme bounding boxy
- Nakreslíme hodnotenia
- Odstránime pôvodný obrázok užívateľa
- Uložíme výstup z hodnotiaceho pipeline
- Dáme úlohu do fronty „after_estimate“, ktorú počúva rozobraný mikroservis „attrai-telegram-bot“
Graylog (+ mongoDB + Elasticsearch)
— to je riešenie na centralizované riadenie logov. V tomto projekte bol využitý na svoj účel.
Výber padol práve na neho, a nie na všetkým známy stack, z dôvodu pohodlia práce s ním z Pythonu. Všetko, čo je potrebné urobiť pre logovanie v Graylog, je pridať GELFTCPHandler z balíka k ostatným root logger handlerom našej python-mikroslužby.
Ja, ako človek, ktorý predtým pracoval iba s ELK stackom, som celkovo získal pozitívne skúsenosti pri práci s Graylog. Jediná vec, ktorá ma mrzí – prevaha funkcií Kibany nad webovým rozhraním Graylog.
RabbitMQ
— to je broker správ založený na protokole AMQP.
V tomto projekte bol využitý ako broker pre Celery a pracoval v durable režime.
Kľuč-hodnota
— to je NoSQL databáza, ktorá pracuje so štruktúrami údajov typu „kľúč — hodnota“
Občas je potrebné používať v rôznych python-mikroslužbách spoločné objekty, ktoré realizujú nejaké štruktúry údajov.
Napríklad v Redis sa uchováva hashmapa typu „telegram_user_id => počet aktívnych úloh vo fronte“, čo umožňuje obmedziť počet požiadaviek od jedného používateľa na konkrétnu hodnotu a tým zabrániť DoS útokom.
Formalizujeme proces úspešného spracovania obrázka
- Používateľ odosiela obrázok do Telegram bota
- „attrai-telegram-bot“ prijíma správu od Telegram API a rozoberá ju
- Úloha s obrázkom sa pridáva do asynchrónnej fronty „to_estimate“
- Používateľ dostáva správu s plánovaným časom hodnotenia
- „attrai-estimator“ berie úlohu z fronty „to_estimate“, prechádza cez hodnotiaci pipeline a posiela úlohu do fronty „after_estimate“
- „attrai-telegram-bot“, ktorý počúva frontu „after_estimate“, posiela výsledok používateľovi
DevOps
Nakoniec, po prehľade architektúry, môžeme prejsť k rovnako zaujímavej časti — DevOps
Docker Swarm
— systém klastrovania, ktorého funkčnosť je realizovaná v rámci Docker Engine a je dostupná priamo.
Pomocou „rojov“ je možné rozdeliť všetky uzly nášho klastra na 2 typy – worker a manager. Na strojoch prvého typu sa rozbiehajú skupiny kontajnerov (staky), stroje druhého typu zodpovedajú za škálovanie, vyvažovanie a Manažéri sú predvolene aj workery.
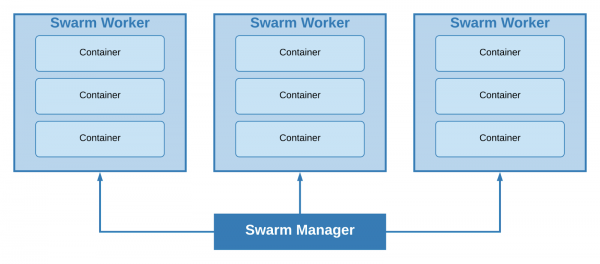
Klastra s jedným leader managerom a tromi workerami.
Minimálna možná veľkosť klastra je 1 uzol, jediný stroj bude súčasne vystupovať ako leader manager a worker. Na základe veľkosti projektu a minimálnych požiadaviek na odolnosť voči poruchám, bolo prijaté rozhodnutie použiť práve tento prístup.
Naznačím, že od prvej produkčnej dodávky, ktorá bola v polovici júna, neboli problémy spojené s touto organizáciou klastra (ale to neznamená, že takáto organizácia je akýmkoľvek spôsobom prípustná v stredne veľkých projektoch, ktoré majú požiadavky na odolnosť voči poruchám).
Docker Stack
V režime „roj“ za nasadenie stackov (súborov docker služieb) zodpovedá
Podporuje konfigurácie docker-compose, čo umožňuje dodatočne použiť parametre nasadenia.
Napríklad, pomocou týchto parametrov boli obmedzené zdroje pre každý z inštancií mikroslužby hodnotenia (vyhradené N jadier na N inštancií, vo vnútri mikroslužby obmedzujeme počet jadier, ktoré používa PyTorch, na jedno).
attrai_estimator:
  image: 'erqups/attrai_estimator:1.2'
  deploy:
    replicas: 4
    resources:
      limits:
        cpus: '4'
    restart_policy:
      condition: on-failure
      …
Je dôležité poznamenať, že Redis, RabbitMQ a Graylog sú stateful služby a rozšíriť ich je rovnako jednoduché, ako „attrai-estimator“, sa nepodarí.
Predvídam otázku – prečo nie Kubernetes?
Zdá sa, že používanie Kubernetes v malých a stredných projektoch je zbytočné, všetky potrebné funkcie možno získať od Docker Swarm, ktorý je veľmi user-friendly pre orchestrátory kontajnerov a má nízky prah vstupu.
Infrastruktúra
Toto všetko bolo nasadené na VDS s nasledujúcimi charakteristikami:
- CPU: 4 jadrá Intel® Xeon® Gold 5120 CPU @ 2.20GHz
- RAM: 8 GB
- SSD: 160 GB
Po lokálnom záťažovom teste sa zdalo, že pri vážnom nápore používateľov, tejto mašinky bude dosť tak akurát.
Avšak krátko po nasadení som zverejnil odkaz na jednu z najpopulárnejších obrazových tabúľ v SNS (áno, tú presne), po čom sa ľudia zaujali, a služba úspešne spracovala desiatky tisíc obrázkov za niekoľko hodín. Počas najvyšších momentov neboli zdroje CPU a RAM ani z polovice vyťažené.
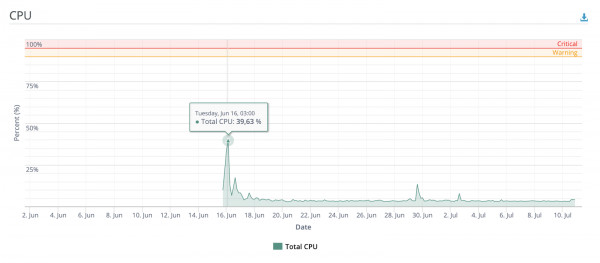
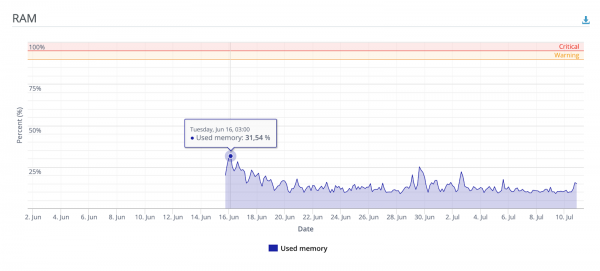
Ešte trochu grafiky
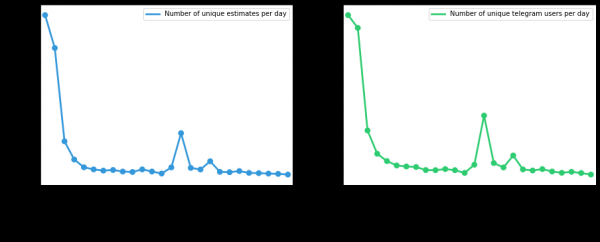
Počet unikátnych používateľov a požiadaviek na hodnotenie od momentu nasadenia, v závislosti od dňa
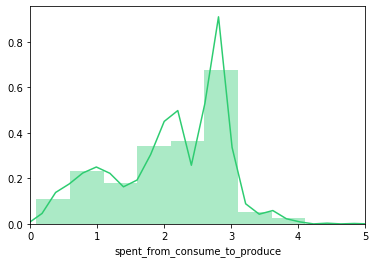
Distribúcia času inferenčného pipeline hodnotenia
Zhrnutie
Zhrnuli by sme, že architektúra a prístup k orchestrácii kontajnerov sa plne osvedčili — ani v najvyšších momentoch neprišlo k pádov a poklesom spracovacieho času.
Myslím, že projekty malého a stredného rozsahu, ktoré vo svojich procesoch využívajú real-time inferenciu neurónových sieťach na CPU, si úspešne môžu prevziať praktiky popísané v tomto článku.
Pridám ešte, že pôvodne bol článok dlhší, ale aby som nezverejnil dlhé čítanie, rozhodol som sa niektoré momenty v tomto článku vynechať — vrátime sa k nim v nasledujúcich publikáciách.
Chatbota si môžete vyskúšať na Telegrame — @AttraiBot, bude fungovať minimálne do konca jesene 2020. Pripomínam — žiadne používateľské údaje nie sú uchovávané — ani pôvodné obrázky, ani výsledky hodnotiaceho pipeline — všetko sa vymaže po spracovaní.
Zdroj: habr.com
