

Vývoj úložiska je dlhý a vážny proces.
Mnohé v živote projektu závisí od toho, ako dobre je premyslená objektová modela a štruktúra databázy na začiatku.
Bežným prístupom boli a zostávajú rôzne varianty kombinácie schémy „hviezdy“ s treťou normálnou formou. Zvyčajne platí princíp: zdrojové údaje — 3NF, vitríny — hviezda. Tento prístup, overený časom a podložený veľkým počtom výskumov, je prvé (a niekedy aj jediné), čo napadne skúseného DWH odborníka pri úvahách o tom, ako by malo vyzerať analytické úložisko.
Na druhej strane, biznis celkovo a požiadavky zákazníka konkrétne majú tendenciu rýchlo sa meniť, a dáta rastú ako „do hĺbky“, tak aj „do šírky“. A tu vychádza na povrch hlavný nedostatok hviezdy — obmedzená kapacita. flexibilita.
A ak v tvojom tichom a útulnom živote DWH vývojára náhle:
- nastala úloha „urobiť rýchlo aspoň niečo, a potom sa pozrieme“;
- vyvstáva rýchlo sa rozvíjajúci projekt, s pripojením nových zdrojov a prekážkami v obchodnom modeli minimálne raz za týždeň;
- existuje zákazník, ktorý si nevie predstaviť, ako by mal systém vyzerať a aké funkcie vykonávať na konci, ale je otvorený experimentom a postupnému objasňovaniu požadovaného výsledku s postupným priblížením k nemu;
- zavíta projektový manažér s radostnou správou: „A teraz máme agil!“
Alebo ak ťa jednoducho zaujíma, ako ešte možno budovať úložiská — vitaj pod kat!
Čo znamená „flexibilita“?
Na začiatok sa dohodnime, akými vlastnosťami by mala disponovať systém, aby sme ho mohli nazvať „flexibilným“.
Samostatne by sa malo vyjasniť, že opísané vlastnosti by sa mali vzťahovať práve na systém, a nie na proces jeho vývoja. Preto, ak ste chceli čítať o Agile ako metodológii vývoja, lepšie sa oboznámte s inými článkami. Napríklad, na Habr-e je množstvo zaujímavých materiálov (ako a , tak aj ).
To není to, že by proces vývoja a štruktúra dátového skladu vôbec neboli prepojené. Vo všeobecnosti by malo byť podstatne jednoduchšie vyvíjať flexibilné úložisko na základe Agile. Avšak v praxi sa častejšie vyskytujú prípady vývoja klasického DWH podľa Kimballa a DataVault — metodológie waterfall, než šťastné zhody flexibility v dvoch jej podobách na jednom projekte.
A aké funkcie by malo mať flexibilné úložisko? Tu môžeme vyzdvihnúť tri body:
- Skoré dodanie a rýchla úprava — to znamená, že ideálne prvý obchodný výsledok (napríklad prvé funkčné správy) by mal byť získaný čo najskôr, teda ešte pred tým, ako je systém celkom navrhnutý a implementovaný. Každá ďalšia úprava by tiež mala trvať čo najkratšie.
- Iteratívna úprava — to znamená, že každá ďalšia úprava by ideálne nemala zasahovať do už fungujúcej funkcie. Tento aspekt sa často stáva najväčšou nočnou morou na veľkých projektoch — skôr alebo neskôr sa jednotlivé objekty začnú preplňať takým množstvom väzieb, že je jednoduchšie celý logický proces zopakovať v vedľajšej kópii, než pridať pole do existujúcej tabuľky. A ak vás prekvapuje, že analýza dopadu úpravy na existujúce objekty môže trvať dlhšie ako samotná úprava — pravdepodobne ste ešte nepracovali s veľkými DWH v banke alebo telekomunikáciách.
- Trvalá adaptácia na meniace sa požiadavky podnikania — celková objektová štruktúra by mala byť navrhnutá nielen so zohľadnením možného rozšírenia, ale aj s výhľadom na to, že smer tohto rozšírenia by vám ani vo sne nenapadlo pri fáze návrhu.
A áno, dodržiavanie všetkých týchto požiadaviek v jednom systéme je možné (samozrejme, v určitých prípadoch a s niektorými obmedzeniami).
Nižšie sa pozriem na dve najpopulárnejšie metodológie flexibilného návrhu pre DWH — Anchor model a Data Vault. Mimo rámca zostávajú také krásne metódy, ako napríklad EAV, 6NF (v čistom znení) a všetko, čo sa týka riešení NoSQL — nie preto, že by boli horšie, a ani preto, že by tento článok hrozil obvyklým rozsahom priemerného dizertačného diela. Je to jednoducho preto, že všetko toto patrí k riešeniam mierne iného druhu — buď k technikám, ktoré môžete použiť v konkrétnych prípadoch bez ohľadu na celkovú architektúru vášho projektu (ako EAV), alebo k globálne iným paradigmatickým systémom ukladania údajov (ako napríklad grafové databázy a iné varianty NoSQL).
Problémy "klasického" prístupu a ich riešenia v flexibilných metódach
Pod "klasickým" prístupom rozumiem starú dobrú hviezdu (nech ma odpusťa stúpenci Kimballa, Inmona a CDM).
1. Pevná kardinalita vzťahov
Do základov takejto modelu sa ukladá jasné rozdelenie údajov na dimenzie (Dimension) a fakty (Fact). A to je, kruci, logické — veď analýza údajov v prevažnej väčšine prípadov spočíva presne v analýze určitých číselných ukazovateľov (faktov) v určitých rozrezoch (dimenziách).
Pri tom vzťahy medzi objektmi sa zakladajú vo forme vzťahov medzi tabuľkami prostredníctvom vonkajšieho kľúča. To vyzerá celkom prirodzene, ale okamžite vedie k prvému obmedzeniu flexibility — pevnému určenie kardinality vzťahov.
To znamená, že v etape projektovania tabuliek musíte presne určiť, pre každý pár súvisiacich objektov, môžu sa týkať ako mnohé-k-mnohým, alebo len 1-k-mnohým, a "v akom smere". Od toho priamo závisí, v ktorej z tabuliek bude primárny kľúč a v ktorej — vonkajší. Zmena tohto vzťahu pri získaní nových požiadaviek s vysokou pravdepodobnosťou povedie k prepracovaniu databázy.
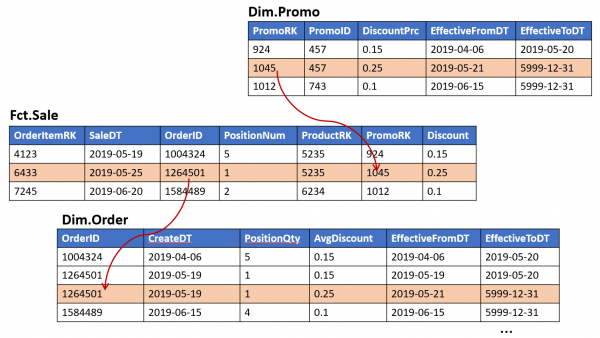
Napríklad, pri projektovaní objektu "pokladničný doklad" ste, opierajúc sa na sľuby predajného oddelenia, zakomponovali možnosť akcie jednej propagačnej akcie na viacero položiek dokladu (ale nie naopak):
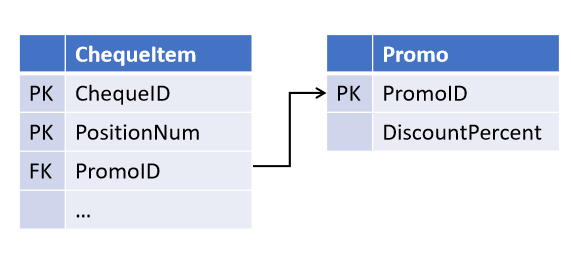
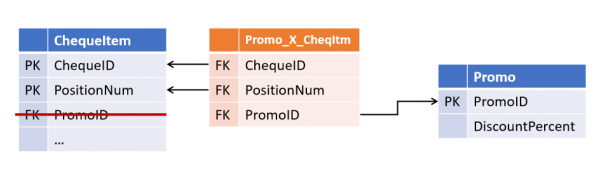
A po nejakom čase, kolegovia zaviedli novú marketingovú stratégiu, v ktorej na jednu a tú istú položku môžu pôsobiť viaceré propagačné akcie súčasne. A teraz musíte upraviť tabuľky, pričom vzťah vyčleníte do samostatného objektu.
(Všetky odvodené objekty, v ktorých sa uskutočňuje pripojenie k akcii, teraz tiež potrebujú úpravy).
Vzťahy v Data Vault a Anchor Model
Vyhnúť sa takej situácii sa ukázalo byť dosť jednoduché: netreba dôverovať predajného oddeleniu, na to stačí všetky vzťahy od začiatku uchovávať v samostatných tabuľkách a spracovávať ich ako mnoho-ku-mnohým.
Takýto prístup bol navrhnutý Danom Linstedtom ako súčasť paradigmy Data Vault a plne podporovaný Larsson Rönnbäckom v Jahodovým modelom.
Nakoniec získavame prvú rozlišovaciu vlastnosť flexibilných metodológií:
Vzťahy medzi objektmi nie sú uchovávané v atribútoch rodičovských entít, ale predstavujú samostatný typ objektov.
V Data Vault takéto prepojovacie tabuľky sa nazývajú Odkaz, a v Jahodový model — Prepojenie. Na prvý pohľad sú veľmi podobné, hoci názvom sa ich rozdiely nevyčerpávajú (o čom bude reč neskôr). V obidvoch architektúrach môžu prepojovacie tabuľky prepájať akýkoľvek počet entít (nie nutne 2).
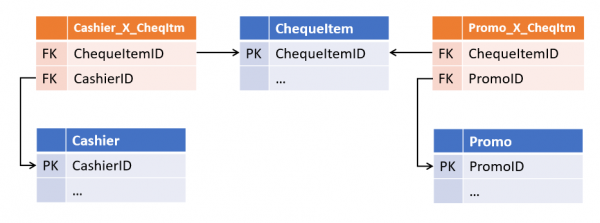
Tento na prvý pohľad nadbytok poskytuje podstatnú flexibilitu pri úpravách. Takáto štruktúra sa stáva tolerantnou nie len voči zmenám existujúcich vzťahov, ale aj k pridávaniu nových - ak teraz k položke na účte pribudne aj odkaz na pokladníka, ktorý ju spracoval, vznik takejto prepojenia sa stane jednoducho nadstavbou nad existujúcimi tabuľkami bez ovplyvnenia akýchkoľvek existujúcich objektov a procesov.
2. Duplicitné dáta
Druhá problém, ktorý riešia flexibilné architektúry, je menej zjavný a patrí predovšetkým meraniam typu SCD2 (pomaly sa meniacim meraniam druhého typu), hoci nielen im.
V klasickom sklade meranie zvyčajne predstavuje tabuľku, ktorá obsahuje surrogate kľúč (ako PK) a súbor obchodných kľúčov a atribútov v samostatných stĺpcoch.
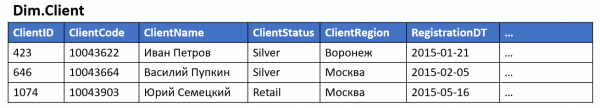
Ak meranie podporuje verziovanie, k štandardnému súboru polí sa pridávajú hranice časovej platnosti verzie, a na jeden riadok v zdroji sa objaví niekoľko verzií v sklade (po jednej na každú zmenu verziových atribútov).
Ak mera obsahuje aspoň jeden často sa meniaci verziový atribút, počet verzií takejto miery bude pôsobivý (aj keď ostatné atribúty nie sú verziové alebo sa nikdy nemenia), a ak je týchto atribútov viac, počet verzií môže rásť geometricky podľa ich počtu. Takáto miera môže zaberáť značné množstvo diskového priestoru, aj keď väčšina uložených dát sú len duplikáty hodnôt nemenných atribútov z iných riadkov.
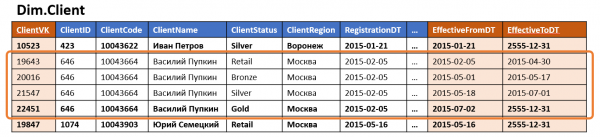
Pri tom sa veľmi často aplikuje aj denormalizácia — časť atribútov je zámerne uložená ako hodnota, a nie ako odkaz na referenčnú tabuľku alebo inú mieru. Tento prístup urýchľuje prístup k dátam, čím sa znižuje počet joinov pri prístupe k miere.
Ako pravidlo, to vedie k tomu, že rovnaké informácie sú uložené súčasne na viacerých miestach. Napríklad informácie o regióne bydliska a kategórii zákazníka môžu byť uložené súčasne v mierach „Zákazník“ a faktoch „Nákup“, „Doručenie“ a „Žiadosti na call centrum“, ako aj v spojovacej tabuľke „Zákazník — Zákaznícky manažér“.
Celkovo sa to, čo bolo opísané vyššie, vzťahuje aj na bežné (neverzné) miery, ale vo verziových môžu mať iný rozsah: vznik novej verzie objektu (najmä spätne) vedie nielen k aktualizácii všetkých súvisiacich tabuliek, ale k kaskádovému vzniku nových verzií súvisiacich objektov — keď Tabuľka 1 sa používa pri zostavovaní Tabuľky 2, a Tabuľka 2 — pri zostavení Tabuľky 3 atď. Aj keď žiadny atribút Tabuľky 1 sa nezúčastňuje na zostavovaní Tabuľky 3 (a zúčastňujú sa iné atribúty Tabuľky 2, získané z iných zdrojov), verzionovanie tejto štruktúry aspoň privedie k dodatočným nákladom, a v najhoršom prípade — k zbytočným verziám v Tabuľke 3, ktorá tu vôbec „nie je zaujímavá“, a ďalej po reťazci.
3. Nelineárna zložitá úprava
Pri tom každá nová vitrína, ktorá sa stavia na základe inej, zvyšuje počet miest, kde sa dáta môžu „rozdeliť“ pri zavádzaní zmien v ETL. To, na druhej strane, vedie k zvýšeniu zložitosti (a dĺžky) každej nasledujúcej úpravy.
Ak sa vyššie uvedené týka systémov s zriedkavo upravovanými ETL procesmi, je možné žiť v takej paradigme – stačí len dbať na to, aby nové úpravy boli správne zavedené do všetkých súvisiacich objektov. Ak sa však úpravy vyskytujú často, pravdepodobnosť náhodne "prehliadnuť" niekoľko väzieb sa značne zvyšuje.
A ak zohľadníme, že "verzionovaný" ETL je podstatne zložitejší než "neverzionovaný", vyhnúť sa chybám pri častých úpravách celého tohto systému sa stáva dosť obtiažne.
Ukladanie objektov a atribútov v Data Vault a Anchor Model
Prístup, ktorý autori flexibilných architektúr navrhujú, môže byť formulovaný takto:
Je potrebné oddeliť to, čo sa mení, od toho, čo zostáva nemenné. Teda ukladať kľúče oddelene od atribútov.
Pri tom netreba zamieňať neverzionovaný atribút s nemenným: prvý neuchováva históriu svojich zmien, ale môže sa meniť (napríklad pri oprave vstupnej chyby alebo získaní nových dát), druhý sa nikdy nemení.
Názory na to, čo presne možno považovať za nemenné v Data Vault a Anchor modele, sa líšia.
Z hľadiska architektúry Data Vault, nemenným možno považovať celú sadu kľúčov – prirodzené (ICO organizácie, kód produktu v systéme zdroja atď.) a surrogate. Ostatné atribúty je možné rozdeliť do skupín podľa zdroja a/alebo frekvencie zmien a pre každú skupinu viesť samostatnú tabuľku s nezávislým súborom verzií.
V paradigme Anchor Model je nemenným považovaný len surrogate kľúč entít. Všetko ostatné (vrátane prirodzených kľúčov) je len špecifickým prípadom jeho atribútov. Pri tom všetky atribúty sú svojim spôsobom nezávislé od seba, preto pre každý atribút musí byť vytvorená samostatná tabuľka.
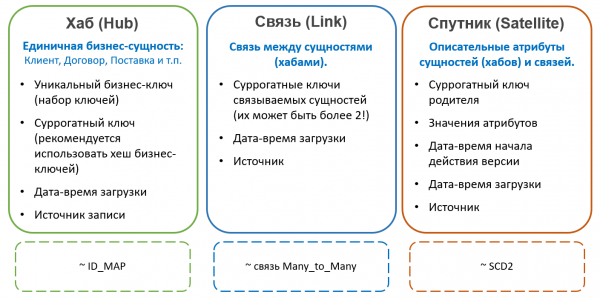
V Data Vault tabuľky, ktoré obsahujú kľúče entít, sa nazývajú Hubmi (Hub). Huby vždy obsahujú fixovaný súbor polí:
- Prirodzené kľúče entít
- Surrogate kľúč
- Referencia na zdroj
- Čas pridania záznamu
Záznamy v Huboch sa nikdy nemenia a nemajú verzie.. Externé huby sa veľmi podobajú na ID-map tabuľky, ktoré sa používajú v niektorých systémoch na generovanie substitútov, avšak ako substitúty v Data Vault sa odporúča používať nie celé číslo sekvencie, ale hash z množiny biznis kľúčov. Tento prístup zjednodušuje načítavanie vzťahov a atribútov zo zdrojov (nie je potrebné sa spojiť s hubom na získanie substitútu, stačí jednoducho vypočítať hash z prirodzeného kľúča), ale môže spôsobiť iné problémy (napríklad s kolíziami, rozlíšením a neviditeľnými znakmi v reťazcových kľúčoch atď.), preto nie je všeobecne akceptovaný.
Všetky ostatné atribúty entít sa uchovávajú v špeciálnych tabuľkách, nazývaných Satellity (Satellit). Jeden hub môže mať niekoľko satelitov, ktoré uchovávajú rôzne sady atribútov.
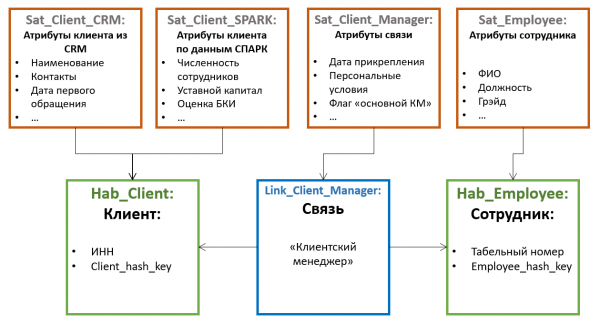
Rozdelenie atribútov medzi satelity sa deje podľa princípu spoločnej zmeny — v jednom satelite môžu byť uložené nie verziové atribúty (napríklad dátum narodenia a SČN pre fyzickú osobu), v druhom — zriedkavo sa meniacie verziové (napríklad priezvisko a číslo pasu), v treťom — často sa meniacie (napríklad adresa dodania, kategória, dátum poslednej objednávky atď.). Verzionovanie sa pritom vedie na úrovni jednotlivých satelitov, nie na úrovni celej entity, a preto je rozdelenie atribútov vhodné vykonať tak, aby sa minimalizovalo prekrývanie verzií v rámci jedného satelitu (čo znižuje celkový počet uchovávaných verzií).
Taktiež, pre optimalizáciu procesu načítania dát sa do samostatných satelitov často vyťahujú atribúty získané z rôznych zdrojov.
Satelity sú spojené s hubom pomocou cudzieho kľúča (čo zodpovedá kardinalite 1-k-many). To znamená, že viacnásobné hodnoty atribútov (napríklad niekoľko kontaktných telefónnych čísel u jedného zákazníka) sú touto architektúrou „predvolením“ podporované.
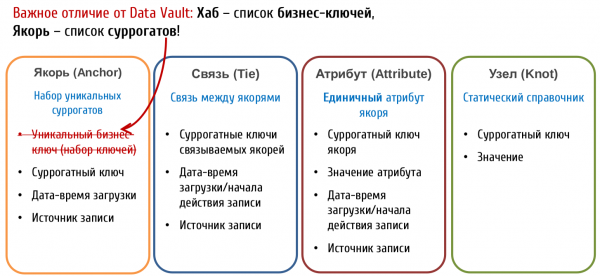
V Anchor Model (Jadrový model) tabuľky, ktoré uchovávajú kľúče, sa nazývajú Jadrá (Anchor). A uchovávajú:
- Iba substitútne kľúče
- Referencia na zdroj
- Čas pridania záznamu
Prirodzené kľúče, pokiaľ ide o Jadrový model, sú považované za bežné atribúty. Tento variant sa môže zdať zložitejší na pochopenie, ale poskytuje omnoho väčší priestor na identifikáciu objektu.
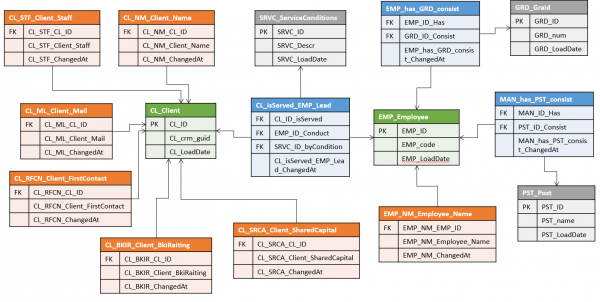
Napríklad, ak môžu údaje o tej istej entite prichádzať z rôznych systémov, pričom každý z nich používa svoj vlastný prirodzený kľúč. V Data Vault to môže viesť k pomerne objemným konštrukciám z niekoľkých hubov (jeden na zdroj + spájajúca master verzia), zatiaľ čo v Jadrovej modely sa prirodzený kľúč každého zdroja dostáva do svojho atribútu a môže sa používať pri načítaní nezávisle od všetkých ostatných.
Ale tu sa skrýva jeden zložitý bod: ak sa v jednej entite spájajú atribúty z rôznych systémov, pravdepodobne existujú určité pravidlá „spájania“, podľa ktorých musí systém chápať, že záznamy z rôznych zdrojov zodpovedajú jednému exempláru entity.
V Data Vault Tieto pravidlá pravdepodobne určia tvorbu „náhradného hubu“ master entity a nijako neovplyvnia Huby, ktoré uchovávajú prirodzené kľúče zdrojov a ich počiatočné atribúty. Ak sa v nejakom momente pravidlá spájania zmenia (alebo príde aktualizácia atribútov, podľa ktorých sa to vykonáva), bude stačiť preformovať náhradné huby.
V Jadrovej modely sa táto entita pravdepodobne bude uchovávať v jediného kotvy. To znamená, že všetky atribúty, bez ohľadu na to, z ktorého zdroja sú získané, budú viazané na ten istý náhradník. Rozdeliť omylom spojené záznamy a celkovo sledovať aktuálnosť spájania v takejto sústave môže byť podstatne ťažšie, obzvlášť ak sú pravidlá dosť zložité a často sa menia, a ten istý atribút môže byť získaný z rôznych zdrojov (aj keď to je presne možné, keďže každá verzia atribútu uchováva odkaz na svoj zdroj).
V každom prípade, ak vo vašej sústave predpokladáte realizáciu funkčnosti odstránenia duplikátov, spájania záznamov a iných prvkov MDM, stojí za to sa obzvlášť podrobne oboznámiť s aspektmi uchovávania prirodzených kľúčov v flexibilných metódach. Pravdepodobne sa objemnejšia konštrukcia Data Vault náhle ukáže ako bezpečnejšia z hľadiska chýb spájania.
Jadrova modela taktiež predpokladá dodatočný typ objektu, nazývaný Uzol (Knot) v podstate ide o špeciálny degenerovaný typ kotvy, ktorý môže obsahovať len jeden atribút. Uzly sa predpokladajú na uchovávanie plochých adresárov (napríklad pohlavie, rodinný stav, kategória zákazníckych služieb a pod.). Na rozdiel od Kotvy, Uzol nemá pridružené tabuľky atribútov, a jeho jediný atribút (názov) sa vždy uchováva v jednej tabuľke s kľúčom. Uzly sú spojené s Kotvami tabuľkami-väzbami (Tie) rovnako, ako sú kotvy spojené navzájom.
Neexistuje jednoznačný názor na používanie Uzlov. Napríklad, , ktorý aktívne podporuje používanie Kotvového modelu v Rusku, tvrdí (nie bezdôvodne), že pre žiadny adresár sa nedá presne potvrdiť, že vždy bude statický a jedný úrovňový, preto je pre všetky objekty lepšie hneď použiť plnohodnotnú Kotvu.
Ďalší dôležitý rozdiel medzi Data Vault a Kotvovým modelom spočíva v prítomnosti atribútov pri väzbách:
V Data Vault Väzby sú rovnako plnohodnotné objekty ako Huby a môžu mať vlastné atribúty. V Jadrovej modely Väzby sa používajú len na spojenie Kotiev a vlastné atribúty mať nemôžu. Tento rozdiel prináša podstatne odlišné prístupy k modelovaniu faktov, o čom budeme hovoriť ďalej.
Ukladanie faktov
Doteraz sme hovorili predovšetkým o modelovaní meraní. S faktmi je situácia o niečo menej jednoznačná.
V Data Vault typický objekt pre ukladanie faktov je Väzba (Link), v Satelitoch ktorej sa zhromažďujú reálne ukazovatele.
Taký prístup sa zdá byť intuitívne pochopiteľný. Poskytuje jednoduchý prístup k analyzovaným ukazovateľom a celkovo sa podobá na tradičnú tabuľku faktov (len ukazovatele nie sú uložené v samotnej tabuľke, ale v „susednej“). No existujú aj úskalia: jedna z typických úprav modelu — rozšírenie kľúča faktu — vyžaduje pridanie nového externého kľúča do Linku. A to zase „porušuje“ modulárnosť a potenciálne spôsobuje potrebu úprav iných objektov.
V Jadrovej modely Väzba nemôže mať vlastné atribúty, takže taký prístup neobstojí — absolútne všetky atribúty a ukazovatele musia mať väzbu na jednu konkrétnu kotvu. Z tohto vyplýva jednoduchý záver — pre každý fakt je potrebná svoju kotvu.. Pre časť toho, čo považujeme za fakty, to môže vyzerať prirodzene — napríklad, fakt nákupu sa krásne prevádza na objekt "objednávka" alebo "bloček", návšteva webu — na reláciu a podobne. Ale sú aj fakty, pri ktorých nie je také jednoduché nájsť prirodzený "objekt-nositeľ" — napríklad, zostatky tovaru v skladoch na začiatku každého dňa.
Zodpovedajúcim spôsobom pri rozširovaní kľúča faktu v Ukotvenej (Anchor) modeli nevznikajú problémy s modulárnosťou (stačí jednoducho pridať novú súvislosť k odpovedajúcemu ukotveniu), ale návrh modelu na zobrazenie faktov je menej jasný, môžu sa objaviť "umelé" ukotvenia, ktoré nezobrazujú objektový model podnikania zjavne.
Ako sa dosahuje flexibilita
Výsledná konštrukcia v oboch prípadoch obsahuje podstatne viac tabuliek, než tradičné meranie. Ale môže zaberáť podstatne menej diskového priestoru pri tom istom súbore verziových atribútov ako tradičné meranie. Nie je tu samozrejme žiadna mágia — celá vec spočíva v normalizácii. Rozdeľovaním atribútov medzi Satelity (v Data Vault) alebo samostatné tabuľky (Anchor Model) znižujeme (alebo úplne vylučujeme) duplicitné hodnoty niektorých atribútov pri zmene iných.
Pre Data Vault výhoda bude závisieť od rozdelenia atribútov medzi Satelity, a pre Jadrovej modely — takmer priamo úmerne priemernému počtu verzií na meraný objekt.
Avšak, výhoda v zaberanom mieste — dôležitá, ale nie hlavná výhoda samostatného ukladania atribútov. Spolu so samostatným uložením väzieb, tento prístup robí úložisko modulárnou konštrukciou. To znamená, že pridávanie ako samostatných atribútov, tak nových predmetných oblastí v takom modeli vyzerá ako nadviazanie na existujúci súbor objektov bez ich zmien. A to je presne to, čo robí opísané metodológie flexibilnými.
Taktiež to pripomína prechod od kusovej výroby k hromadnej — ak v tradičnom prístupe je každá tabuľka modelu jedinečná a vyžaduje osobitnú pozornosť, tak v flexibilných metodológiach — to je už súbor typových "detailov". Na jednej strane, počet tabuliek sa zvyšuje, procesy nahrávania a výberu údajov musia vyzerať zložitejšie. Na druhej strane — stávajú sa typovými. A teda, môžu byť sú automatizované a spravované metadátami. Otázka „ako budeme ukladať?“, na ktorú mohla odpoveď zaberať podstatnú časť práce na dizajne zmien, sa teraz jednoducho nekladie (rovnako ako otázka o vplyve zmeny modelu na fungujúce procesy).
To neznamená, že analytici v takejto sústave nie sú vôbec potrební — niekto musí stále vypracovať súbor objektov s atribútmi a zistiť odkiaľ a ako to všetko načítať. Avšak objem práce, ako aj pravdepodobnosť a cena chyby sa podstatne znižujú. Či už počas analýzy, tak aj pri vývoji ETL, ktorý sa do značnej miery môže zúžiť na úpravu metadát.
Temná stránka
Všetko vyššie uvedené robí oba prístupy naozaj flexibilnými, technologickými a vhodnými na iteratívne úpravy. Samozrejme, že existuje aj „sud dechtu“, o ktorom si, myslím, už tušíte.
Dezkompozícia dát, ležiaca v základe modularity flexibilných architektúr, vedie k zvýšeniu počtu tabuliek a, zodpovedajúcim tomu, nákladov na joiny pri výbere. Na to, aby sme jednoducho získali všetky atribúty dimenzie, v klasickom úložisku stačí jeden select, zatiaľ čo flexibilná architektúra si bude vyžadovať celú radu joinov. A ak pre správy je možné všetky tieto joiny napísať vopred, analytici, zvyknutí písať SQL manuálne, budú trpieť dvakrát.
Existuje niekoľko faktov, ktoré uľahčujú túto situáciu:
Pri práci s veľkými dimenziami sa takmer nikdy nepoužívajú všetky jeho atribúty súčasne. To znamená, že joinov môže byť menej, než sa zdá na prvý pohľad na model. V Data Vault je možné tiež zohľadniť predpokladanú frekvenciu spoločného použitia pri rozdeľovaní atribútov medzi satelity. Samotné Huby alebo Kotvy sú potrebné predovšetkým na generovanie a mapovanie substitútov v priebehu načítania a zriedka sa používajú v dopytoch (najmä čo sa týka Kotiev).
Všetky joiny — na kľúči. Okrem toho, komprimovanejšie ukladanie údajov znižuje režijné náklady pri skenovaní tabuliek tam, kde je to potrebné (napríklad pri filtrovaní na základe hodnoty atribútu). Môže to viesť k tomu, že dotazy z normalizovanej databázy s viacerými spojeniami budú rýchlejšie ako skenovanie jedného ťažkého merania s mnohými verziami v riadku.
Napríklad, v článku je podrobný porovnávací test výkonu Modelu Ukotvenia s dotazom z jednej tabuľky.
Veľa závisí od enginu. Mnoho moderných platforiem má vnútorné mechanizmy na optimalizáciu spojení. Napríklad, MS SQL a Oracle dokážu 'preskočiť' spojenia na tabuľky, ak ich údaje nie sú nikde inde využívané, okrem iných spojení a nemajú vplyv na konečné výsledky (odstránenie tabuliek/spojení), zatiaľ čo MPP Vertica podľa , sa ukázala ako vynikajúci engine pre Model Ukotvenia so zohľadnením určitej ručnej optimalizácie plánu dotazu. Na druhej strane, uchovávať Model Ukotvenia, napríklad, na Click House, ktorý má obmedzenú podporu spojení, zatiaľ nevyzerá ako veľmi dobrý nápad.
Okrem toho existujú pre obe architektúry špeciálne techniky, ktoré uľahčujú prístup k údajom (z pohľadu výkonu dotazov, ako aj pre koncových užívateľov). Napríklad, Point-In-Time tabuľky v Data Vault alebo špeciálne tabuľkové funkcie v Modeli Ukotvenia.
Spolu
Základná podstata týchto flexibilných architektúr spočíva v modularite ich 'konštrukcie'.
Práve táto vlastnosť umožňuje:
- Po určitej počiatočnej príprave, ktorej sa venuje nasadenie metadát a napísanie základných ETL algoritmov, rýchlo poskytnúť zákazníkovi prvý výsledok vo forme niekoľkých správ, ktoré obsahujú údaje z niekoľkých zdrojových objektov. Nie je nutné úplne premýšľať (ani na vyššej úrovni) o celej objektovej modelovej schéme.
- Model dát môže začať fungovať (a prinášať prospech) už s 2-3 objektmi a následne postupne rásť (pokračujúc v Modeli Ukotvenia, Nikolaj pôvabné porovnanie s mycéliom).
- Väčšina úprav, vrátane rozšírenia tematickej oblasti a pridania nových zdrojov menej zasahuje existujúcu funkcionalitu a nevytvára riziko, že sa niečo, čo už funguje, pokazí..
- Vďaka dekompozícii na štandardné prvky, ETL procesy v takýchto systémoch vyzerajú jednotne, ich písanie sa dá algoritmizovať a nakoniec, automatiizácia.
Cenou takejto flexibility je výkonnosť. To neznamená, že dosiahnuť prijateľný výkon na takýchto modeloch je nemožné. Častejšie môže byť potrebné viac úsilia a pozornosti na detaily na dosiahnutie požadovaných metrík.
Aplikácie
Typy entít Data Vault
Viac o Data Vault:
Typy entít Anchor Model
Viac o Anchor Model:
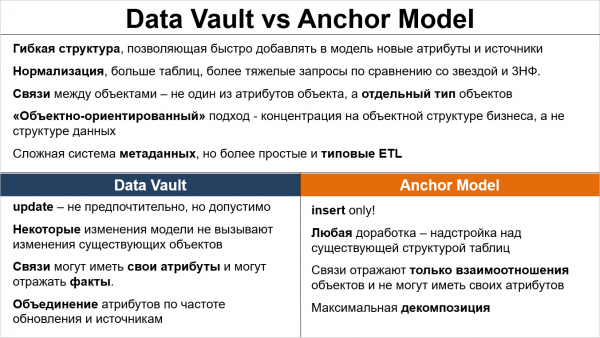
Zhrnutá tabuľka s spoločnými črtami a rozdielmi preskúmaných prístupov:
Zdroj: habr.com
