

Ahoj všetci. Tento článok je napísaný pre tých, ktorí sa stále rozhodujú medzi platformami virtualizácie a po prečítaní článku zo série „Nainstalovali sme proxmox a všetko je skvelé, 6 rokov uptime bez jediného výpadku“. Ale po nainštalovaní niektorého z hotových riešení sa objaví otázka, ako by to tu trochu upraviť a tu, aby bol monitoring zrozumiteľnejší a tu, aby sme mohli kontrolovať zálohy... A potom príde čas a vy si uvedomíte, že chcete niečo funkčnejšie, alebo chcete, aby vo vašej systéme bolo všetko jasné a nie tento čierny box, alebo chcete použiť niečo viac než hypervízor a kopu virtuálnych strojov. Tento článok ponúkne pár úvah a praktických skúseností na základe platformy OpenNebula — vybral som ju, pretože nie je náročná na zdroje a jej architektúra nie je tak komplikovaná.
Takže, ako vidíme, mnohí poskytovatelia cloudových služieb pracujú na KVM a vytvárajú vonkajšie obvody pre správu strojov. Je jasné, že veľkí hostitelia si píšu svoje obvody pre cloudovú infraštruktúru, ako napríklad YANDEX. Niekto využíva OpenStack a vytvára obvod na jeho základe — SELECTEL, MAIL.RU. Ale ak máte vlastný hardvér a malý tím odborníkov, zvyčajne si vyberiete niečo z hotových riešení — VMWARE, HYPER-V, sú dostupné bezplatné a platené licencie, ale teraz nie o tom. Porozprávajme sa o nadšencoch — tí, ktorí sa neboja navrhnúť a vyskúšať niečo nové, aj keď v spoločnosti bolo jasne naznačené „Kto to potom bude po tebe servisovať“, „A my to predsa vyrolujeme do produkcie? Strašidelné.“ Ale predsa je možné na začiatok aplikovať tieto riešenia pod podmienkami testovacieho prostredia a ak sa všetkým zapáči, potom je možné položiť otázku o ďalšom rozvoji a využívaní v vážnejších prostrediach.
Tu je aj odkaz na prednášku od aktívneho účastníka rozvoja tejto platformy.
Možno bude v tomto článku niečo zbytočné a jasné skúsenému odborníkovi, a v niektorých prípadoch nebudem opisovať všetko, pretože takéto príkazy a popisy sú na webe. Tu je len moja skúsenosť s touto platformou. Dúfam, že aktívni účastníci doplnia do komentárov, čo sa dá robiť lepšie a aké chyby som spravil. Všetky akcie prebiehali v podmienkach domáceho testovacieho prostredia zloženého z troch PC s rôznymi charakteristikami. Taktiež som sa rozhodol špeciálne neuvádzať, ako funguje tento softvér a ako sa inštaluje. Nie, iba skúsenosti s administratívou a problémy, s ktorými som sa stretol. Možno to niekomu pomôže pri výbere.
Tak sa pustíme do toho. Pre mňa ako systémového administrátora sú dôležité nasledujúce body, bez ktorých asi nebudem používať toto riešenie.
1. Opakovateľnosť inštalácie
Existuje množstvo návodov na inštaláciu opennebula, tu by nemali nastať problémy. Od verzie k verzii sa objavujú nové funkcie, ktoré nemusia vždy fungovať pri prechode z verzie na verziu.
2. Monitorovanie
Budeme monitorovať samotnú uzol, kvm a opennebula. Našťastie už existuje hotová vec. O monitorovaní linuxových hostiteľov existuje množstvo možností, napríklad Zabbix alebo Node Exporter — každý si môže vybrať to, čo mu viac vyhovuje — momentálne určujem tak, že monitorovanie systémových metrík (teplota tam, kde je to možné merať, konzistentnosť diskového poľa), cez Zabbix, a pokiaľ ide o aplikácie, cez exportér v Prometheovi. Čo sa týka monitorovania kvm, môžeme napríklad vziať projekt a nastaviť spúšťanie cez systemd, celkom dobre funguje a zobrazuje metriky kvm, takisto je k dispozícii hotový dashboard .
Napríklad, tu je môj súbor:
/etc/systemd/system/libvirtd_exporter.service
[Unit]
Description=Node Exporter

[Service]
User=node_exporter
ExecStart=/usr/sbin/prometheus-libvirt-exporter --web.listen-address=":9101"

[Install]
WantedBy=multi-user.target
A tak máme 1 exportér, potrebujeme druhý na monitorovanie samotnej opennebula, použil som nasledovný
Môžeme pridať do bežného pre monitorovanie systému nasledovné.
V súbore pre node_exporter zmeníme štart nasledujúcim spôsobom:
ExecStart=/usr/sbin/node_exporter --web.listen-address=":9102" --collector.textfile.directory=/var/lib/opennebula_exporter/textfile_collectorVytvoríme adresár mkdir -p /var/lib/opennebula_exporter
bash skript uvedený vyššie najprv overíme prácu cez konzolu, ak zobrazuje to, čo treba (ak hlási chybu, nainštalujeme xmlstarlet), skopírujeme ho do /usr/local/bin/opennebula_exporter.sh
Pridáme do cronu úlohu na každú minútu:
*\/1 * * * * (\/usr\/local\/bin\/opennebula_exporter.sh > \/var\/lib\/opennebula_exporter\/textfile_collector\/opennebula.prom)Metódy už sú k dispozícii, môžu sa zbierať Prometheusom, aby sa vytvorili grafy a alarmy. V Grafane môžeme napríklad nakresliť takýto jednoduchý dashboard.
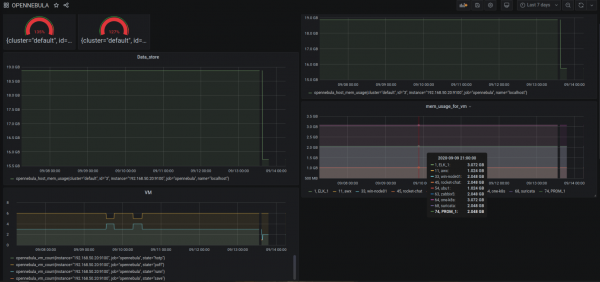
(vidno, že som tu spravil overcommit CPU, RAM)
Pre tých, ktorí majú radi a používajú Zabbix, existuje
Čo sa týka monitorovania, všetko je v poriadku, hlavne, že existuje. Samozrejme, môže sa doplniť použitím vstavaných nástrojov na monitorovanie virtuálnych strojov a exportovaním dát do fakturácie, každý má svoj vlastný pohľad, zatiaľ som sa do toho výraznejšie nepustil.
Čo sa týka logovania, zatiaľ som sa do toho osobitne nepustil. Ako najjednoduchšia možnosť je pridať td-agent na spracovanie adresára \/var\/lib\/one s regulárnymi výrazmi. Napríklad súbor sunstone.log vyhovuje regexp nginx a ďalšie súbory, ktoré ukazujú históriu prístupov k platforme — aký je v tom prínos? Môžeme jasne sledovať počet «Error, error» a rýchlejšie identifikovať, kde a na ktorom úrovni nastala porucha.
3. Zálohy
Existujú aj platené upravené projekty — napríklad sep :OpenNebula_Backup. Tu musíme chápať, že jednoducho zálohovať obraz stroja v tomto prípade nie je to isté, pretože naše virtuálne stroje musia pracovať s plnou integráciou (rovnaký kontext súboru, v ktorom sú popísané nastavenia siete, názov vm a vlastné nastavenia pre vaše aplikácie). Preto sa rozhodneme, čo a ako budeme zálohovať. V niektorých prípadoch je lepšie robiť kópie toho, čo sa nachádza v samotnej vm. A možno je potrebné zálohovať len jeden disk od daného stroja.
Napríklad sme sa dohodli, že všetky stroje sa spúšťajú s persistent images, teda po prečítaní
teda najprv môžeme z našej vm exportovať obraz:
onevm disk-saveas 74 3 prom.qcow2
Image ID: 77

Pozrime sa, pod akým menom bol uložený

oneimage show 77
\/var\/lib\/one\/\/datastores\/100\/f9503161fe180658125a9b32433bf6e8

A ďalej ho skopírujeme tam, kam potrebujeme. Samozrejme, nie je to ideálny spôsob. Chcel som len ukázať, že pomocou nástrojov OpenNebula je možné budovať podobné riešenia.
Na internete som našiel a je tu ešte , ale tento je len pre qcow2 úložisko.
Ako všetci vieme, skôr či neskôr nastane moment, keď človek chce inkrementálne zálohy. Tu to je zložitejšie a možno vedenie uvolní peniaze na platené riešenie, alebo pôjde inou cestou a uvedomí si, že tu len využívame zdroje a zálohovanie by malo byť na úrovni aplikácií a pridaní nových nodov a virtuálnych strojov. Hovorím, že by sme mali používať cloud výlučne na spustenie aplikačných klastrov a databázy spúšťať na inej platforme alebo vziať hotové riešenie od poskytovateľa, ak je taká možnosť.
4. Používateľská prívetivosť
V tomto bode popíšem problémy, s ktorými som sa stretol. Napríklad, pokiaľ ide o obrazy, ako vieme, existujú persistentné — pri pripojení tohto obrazu k VM sa všetky údaje zapisujú do tohto obrazu. A ak je non-persistent, obraz sa skopíruje do úložiska a údaje sa zapisujú do skopírovanej verzie od pôvodného obrazu — takto fungujú šablóny. Viackrát som si sám spôsobil problémy tým, že som zabudol uviesť persistent a 200 GB obraz sa skopíroval. Problém je v tom, že túto procedúru pravdepodobne nie je možné zrušiť, je potrebné ísť na node a zabíjať aktuálny proces „cp“.
Jednou z dôležitých nevýhod je, že akčné kroky nemožno zrušiť len použitím GUI. Presnejšie, zrušíte ich, a uvidíte, že nič sa nedeje, a znovu to spustíte, zrušíte a v skutočnosti už bude existovať 2 procesy cp, ktoré kopírujú obraz.
A tu prichádza pochopenie, prečo opennebula čísluje každý nový inštanc s novým ID. Napríklad v tom istom proxmoxe sa vytvorí VM s ID 101, vymaže sa a potom sa znova vytvorí s ID 101. V opennebula to tak nebude, každý nový inštanc sa vytvorí s novým ID a v tom je logika — napríklad, čistenie starých údajov alebo neúspešných inštalácií.
To isté platí pre úložisko, táto platforma je sústredená predovšetkým na centralizované úložisko. Existujú doplnky na využitie lokálneho, ale v tomto prípade to nie je téma. Myslím si, že v budúcnosti niekto napíše článok o tom, ako úspešne využiť lokálne úložisko na nodoch a úspešne ho použiť v produkcii.
5. Maximálna jednoduchosť
Samozrejme, čím ďalej idete, tým menej zostáva tých, ktorí vás budú chápať.
V podmienkach mojej stanice — 3 uzly s nfs úložiskom — všetko funguje v poriadku. Ale ak by sme robili experimenty s vypínaním energie, napríklad pri spúšťaní snapshotu a vypnutí napájania uzla, máme v databáze zachované nastavenia, že existuje snapshot, avšak v skutočnosti žiadny nie je (všetci vieme, že som pôvodne zapísal do SQL databázy toto konanie, ale samotná operácia prebehla neúspešne). Plus je v tom, že pri vytváraní snímku sa vytvorí samostatný súbor a existuje „rodič“, takže v prípade problémov, aj keby to nefungovalo cez GUI, môžeme získať qcow2 súbor a obnoviť sa samostatne.
Pri sieťach, bohužiaľ, nie je všetko také jednoduché. No aspoň je to jednoduchšie ako v openstack, použil som len vlan (802.1Q) — funguje celkom dobre, ale ak vykonáte zmeny v nastaveniach šablónovej siete, tieto nastavenia sa neaplikujú na už fungujúce stroje, t. j. je potrebné vymazať a pridať sieťovú kartu, potom sa nové nastavenia aplikujú.
Ak by ste chceli ešte porovnávať s openstack, môžeme povedať, že v opennebula nie je jasne definované, aké technológie sa majú používať na ukladanie údajov, správu siete, zdrojov — každý administrátor sa rozhoduje sám, ako mu to najviac vyhovuje.
6. Ďalšie pluginy a inštalácie
Veď ako chápeme, cloudová platforma môže spravovať nielen KVM, ale aj VMware ESXi. Žiaľ, nemal som pool s Vcenter, ak niekto skúšal, napíšte.
V podpore iných cloudových poskytovateľov je uvedené
AWS, AZURE.
Skúšal som pripojiť VMware Cloud od Selectelu, ale nič z toho nevyšlo — celkovo som to vzdal, pretože je tam veľa faktorov, a písanie do technickej podpory hostingového poskytovateľa nedáva zmysel.
Okrem toho, v novej verzii je teraz firecracker — ide o spustenie microvm, akýsi KVM obal nad Dockerom, čo poskytuje ešte väčšiu univerzálnosť, bezpečnosť a zvýšenie výkonu, pretože netreba míňať prostriedky na emuláciu hardvéru. Vidím len výhodu v porovnaní s Dockerom v tom, že nezaberá ďalší počet procesov a nie sú obsadené sockety pri používaní tejto emulácie, tj. celkom sa dá použiť ako vyvažovač záťaže (ale o tom možno stojí za to napísať samostatný článok, zatiaľ som neuskutočnil všetky testy v plnej miere).
7. Pozitívna skúsenosť s použitím a ladením chýb
Chcel by som sa podeliť o svoje postrehy ohľadom fungovania, časť som popísal vyššie, chcel by som napísať viac. Naozaj, pravdepodobne nie som sám, kto si na začiatku myslí, že to nie je ten systém a celkovo je to všetko kostrbaté — ako s tým všetkým vôbec pracujú? Ale potom prichádza pochopenie a zistenie, že všetko je vcelku logické. Samozrejme, nemôžete vyhovieť všetkým a niektoré veci si vyžadujú vylepšenia.
Napríklad, jednoduchá operácia kopírovania obrazu disku z jedného datastore na druhý. V mojom prípade sú dve uzly s NFS, posielam obraz — kopírovanie prebieha cez frontend OpenNebula, aj keď sme si všetci zvykli, že údaje by sa mali kopírovať priamo medzi hostiteľmi — v rovnakom VMware, Hyper-V sme si na to zvykli, ale tu je to iné. Tu je iný prístup a iná ideológia, a v verzii 5.12 bola odstránená tlačidlo „migrate to datastore“ — prenáša sa iba samotná virtuálna mašina, ale nie úložište, pretože sa predpokladá centralizované úložisko.
Ďalej, populárna chyba s rôznymi príčinami „Chyba nasadenia virtuálnej mašiny: Nebolo možné vytvoriť doménu z /var/lib/one//datastores/103/10/deployment.5“ Nižšie bude najčastejšie, čo treba skontrolovať.
- Práva na obraz pre používateľa oneadmin;
- Práva pre používateľa oneadmin na spustenie libvirtd;
- Je datastore správne namontovaný? Choď a skontroluj cestu na samotnom uzle, možno sa niečo odpojilo;
- Nesprávne nakonfigurovaná sieť, skôr na frontende v nastaveniach siete je ako hlavný rozhranie pre VLAN uvedené br0, a na uzle je uvedené — bridge0 — malo by to byť rovnaké.
System datastore uchováva metadáta pre vašu VM, ak spúšťate VM s persistujúcim obrazom, tak VM musí mať prístup k pôvodne vytvorenej konfigurácii na tom úložisku, kde ste vytvorili VM — to je veľmi dôležité. Preto pri prenose VM na iný datastore je potrebné všetko prekontrolovať.
8. Dokumentácia, komunita. Ďalší rozvoj
A ostatné, dobrá dokumentácia, komunita a hlavne, aby projekt v budúcnosti pokračoval.
Vo všeobecnosti je všetko dosť dobre zdokumentované a dokonca podľa oficiálneho zdroja nebude problém nainštalovať a nájsť odpovede na otázky.
Komunita je aktívna. Publikuje množstvo hotových riešení, ktoré môžete využiť vo svojich inštaláciách.
V súčasnosti sa od verzie 5.12 zmenili niektoré politiky v spoločnosti Bude zaujímavé sledovať, ako sa projekt ďalej vyvíja. Na začiatku som úmyselne uviedol niektorých dodávateľov, ktorí používajú svoje riešenia a to, čo ponúka priemysel. Presnej odpovede na to, čo použiť, samozrejme, nie je. Ale pre malé organizácie môže podpora vlastného malého súkromného cloudu nevyjsť tak draho, ako sa zdá. Hlavné je presne vedieť, že to potrebujete.
Ako výsledok, bez ohľadu na to, čo ste si vybrali ako cloudový systém, nemali by ste sa zastaviť na jednom produkte. Ak máte čas, stojí za to pozrieť sa na iné otvorenejšie riešenia.
Je tu dobrý chat aktívne pomáhajú a neposielajú vás hľadať riešenie problému na googli. Pridajte sa.
Zdroj: habr.com
