

Úvod do operačných systémov
Ahoj, Habr! Chcem vám predstaviť sériu článkov-prekladu zaujímavej literatúry, ktorú považujem za zaujímavú — OSTEP. V tomto materiáli sa podrobne zaoberá fungovaním unixových operačných systémov, konkrétne prácou s procesmi, rôznymi plánovačmi, pamäťou a inými podobnými komponentmi, ktoré tvoria moderný OS. Originál všetkých materiálov si môžete pozrieť tu: . Prosím berte na vedomie, že preklad bol vykonaný neprofesionálne (dosť voľne), ale dúfam, že som zachoval celkový zmysel.
Laboratórne práce na tomto predmete nájdete tu:
Ďalšie časti:
A môžete sa pozerať aj na môj kanál v =)
Úvod do plánovača
Jadro problému: Ako vypracovať politiku plánovača
Ako by mali byť navrhnuté základné rámce politík plánovača? Aké by mali byť kľúčové predpoklady? Aké metríky sú dôležité? Aké základné techniky sa používali v skorších výpočtových systémoch?
Predpoklady pracovnej záťaže
Predtým než prediskutujeme možné politiky, urobme niekoľko zjednodušujúcich odbočení o procesoch spustených v systéme, ktoré sú spoločne nazývané pracovná záťaž. Definovaním pracovnej záťaže ako kritickej súčasti vytvárania politík a čím viac viete o záťaži, tým kvalitnejšiu politiku budete schopní napísať.
Urobíme nasledujúce predpoklady o procesoch spustených v systéme, niekedy tiež nazývaných jobs (úlohami). Takmer všetky tieto predpoklady sú nerealistické, ale sú potrebné na rozvoj myšlienok.
- Každá úloha je spustená rovnaký čas,
- Všetky úlohy sú zadané súčasne,
- Zadaná úloha beží až do svojho dokončenia,
- Všetky úlohy využívajú len CPU,
- Čas spracovania každej úlohy je známy.
Metriky plánovača
Okrem niektorých predpokladov o záťaži je potrebný aj nejaký nástroj na porovnávanie rôznych plánovacích politík: metriky plánovača. Metrika je len nejaká miera niečoho. Existuje niekoľko metrík, ktoré môžeme použiť na porovnávanie plánovačov.
Pre príklad použijeme metriky nazývané čas otočenia (turnaround time). Čas otočenia úlohy sa určuje ako rozdiel medzi časom dokončenia úlohy a časom príchodu úlohy do systému.
Tturnaround=Tcompletion−Tarrival
Keďže sme predpokladali, že všetky úlohy prišli v rovnakom čase, Ta=0, a tak Tt=Tc. Táto hodnota sa prirodzene zmení, keď zmeníme vyššie uvedené predpoklady.
Iná metrika je fairness (spravodlivosť, čestnosť). Výkon a spravodlivosť sú často protichodné charakteristiky v plánovaní. Napríklad plánovač môže optimalizovať výkon, ale na úkor čakania na spustenie inými úlohami, čím sa znižuje spravodlivosť.
FIRST IN FIRST OUT (FIFO)
Najzákladnejší algoritmus, ktorý môžeme implementovať, sa nazýva FIFO alebo first come (in), first served (out)Tento algoritmus má několik výhod: je velmi jednoduchý na implementaci a vyhovuje všem našim předpokladům, přičemž práci vykonává poměrně dobře.
Zvažme jednoduchý příklad. Předpokládejme, že byly najednou zadány 3 úkoly. Ale předpokládejme, že úkol A přišel o něco dříve než ostatní, takže v pořadí vykonávání bude před ostatními, stejně jako B na rozdíl od V. Předpokládejme, že každý z nich bude trvat 10 sekund. Jaký bude v tomto případě průměrný čas vykonávání těchto úkolů?
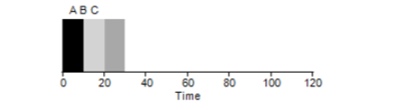
Po sečtení hodnot — 10+20+30 a dělením 3, získáme průměrný čas vykonávání programu roven 20 sekundám.
Teď zkusíme změnit naše předpoklady. Zejména předpoklad 1 a tím pádem nebudeme více předpokládat, že každý úkol se vykonává stejnou dobu. Jak se v tomto případě osvědčí FIFO?
Jak se ukazuje, různá doba vykonávání úkolů má velmi negativní dopad na produktivitu algoritmu FIFO. Předpokládejme, že úkol A bude trvat 100 sekund, zatímco B a V zůstanou na 10 každé.
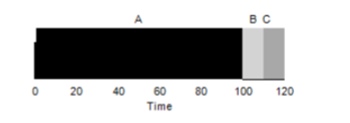
Jak je vidět z obrázku, průměrný čas pro systém bude (100+110+120)/3=110. Tento efekt se nazývá efekt konvoje, kdy někteří krátkodobí spotřebitelé nějakého zdroje čekají v řadě za těžkým spotřebitelem. Je to podobné jako fronta v obchodě s potravinami, kdy před vámi stojí zákazník s plným vozíkem. Nejlepší řešení problému je pokusit se změnit pokladnu nebo se jednoduše uvolnit a hluboce dýchat.
Nejkratší úkol jako první
Lze nějak vyřešit takovou situaci s těžkými procesy? Samozřejmě. Jiný typ plánování se nazýváNejkratší úkol jako první (SJF). Jeho algoritmus je také poměrně primitivní — jak vyplývá z názvu, jako první budou spouštěny nejkratší úkoly jeden za druhým.
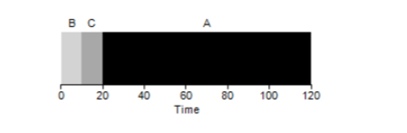
V tomto příkladu výsledkem spuštění stejných procesů bude zlepšení průměrného času otočení programů a ten bude roven 50 místo 110, což je prakticky dvakrát lepší.
Takže pri predpoklade, že všetky úlohy prichádzajú v rovnakom čase, algoritmus SJF sa zdá byť najoptimálnejším algoritmom. Naše predpoklady sa však stále nezdajú realistické. Tentoraz zmeníme predpoklad 2 a predstavíme si, že úlohy môžu prichádzať kedykoľvek, a nie všetky naraz. Aké problémy to môže spôsobiť?
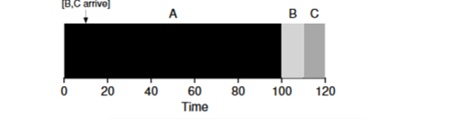
Predstavme si, že úloha A (100s) prichádza ako prvá a začína sa vykonávať. V momente t=10 prichádzajú úlohy B a C, každá z ktorých zaberie 10 sekúnd. Takže priemerný čas vykonania je (100+(110-10)+(120-10))/3 = 103. Čo by mohol plánovač robiť, aby zlepšil situáciu?
Najkratší čas do dokončenia prvý (STCF)
Aby sme zlepšili situáciu, zrušíme predpoklad 3, že program beží a pracuje až do dokončenia. Okrem toho budeme potrebovať podporu hardvéru a, ako ste si mohli domyslieť, použijeme časovač na prerušenie bežiacej úlohy a prepínanie kontextu. Týmto spôsobom plánovač môže niečo podniknúť v momente prichádzania úloh B a C — prerušiť vykonávanie úlohy A a spracovať úlohy B a C a po ich ukončení pokračovať vo vykonávaní procesu A. Takýto plánovač sa nazýva STCFalebo Preemptívna úloha prvá.
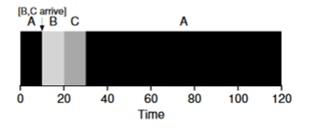
Výsledkom práce tohto plánovača bude nasledujúci výsledok: ((120-0)+(20-10)+(30-10))/3=50. Takže tento plánovač sa stáva ešte optimálnejším pre naše úlohy.
Metrika Čas odozvy (Response Time)
Takže ak vieme, aký je čas na vykonanie úloh a že tieto úlohy využívajú iba CPU, STCF bude najlepším riešením. A niekedy v dávnych časoch tieto algoritmy fungovali a pomerne dobre. Avšak teraz užívateľ trávi väčšinu času za terminálom a očakáva od nej výkonnú interaktívnu spätnú väzbu. Tak sa zrodila nová metrika — čas odozvy (Response Time).
Čas odozvy sa počíta nasledovne:
Tresponse=Tfirstrun−Tarrival
Takže pre predchádzajúci príklad bude čas odozvy takýto: A=0, B=0, C=10 (abg=3,33).
A ukazuje sa, že algoritmus STCF nie je až taký dobrý v situáciách, keď tri úlohy prídu naraz — musí počkať, kým sa malé úlohy úplne dokončia. Takto je algoritmus dobrý pre metriku doby obratu, ale zlý pre metriku interaktivity. Predstavte si, že sedíte za terminálom a snažíte sa zadať znaky do editora, ale musíte čakať viac ako 10 sekúnd, pretože nejaká iná úloha okupuje procesor. To nie je veľmi príjemné.
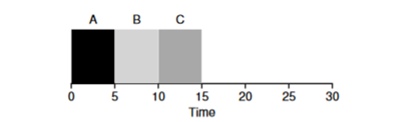
Týmto sa stretneme s iným problémom — ako môžeme postaviť plánovač, ktorý bude citlivý na čas odozvy?
Round Robin
Na riešenie tohto problému bol vyvinutý algoritmus Round Robin (RR). Hlavná myšlienka je pomerne jednoduchá: namiesto spúšťania úloh do úplného dokončenia budeme spúšťať úlohu na určitý časový úsek (nazývaný časový kvant) a potom prepneme na inú úlohu z fronty. Algoritmus opakuje svoju činnosť, kým nie sú všetky úlohy dokončené. Pri tom musí byť doba behu programu násobkom doby, po ktorej časovač preruší proces. Napríklad, ak časovač prerušuje proces každých x=10ms, veľkosť okna vykonávania procesu musí byť násobkom 10 a byť 10, 20 alebo x*10.
Zvážme príklad: Úlohy A, B, C prichádzajú naraz do systému a každá z nich chce pracovať 5 sekúnd. Algoritmus SJF vykoná každú úlohu do konca predtým, ako spustí inú. Na rozdiel od toho algoritmus RR s oknom spustenia=1s prejde cez úlohy nasledovne (obrázok 4.3):
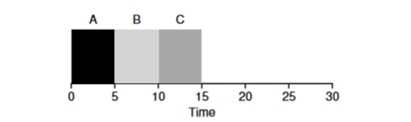
(SJF Znova (Zlé pre čas odozvy)
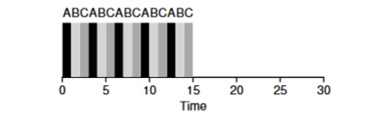
(Round Robin (Dobré pre čas odozvy)
Priemerný čas odozvy pre algoritmus RR (0+1+2) / 3 = 1, zatiaľ čo pre SJF (0+5+10) / 3 = 5.
Je logické predpokladať, že časový úsek je pre RR veľmi dôležitý parameter; čím je menší, tým je rýchlosť odpovede vyššia. Avšak, nemôžeme ho nastaviť príliš malé, pretože čas na prepínanie kontextu tiež zohráva svoju úlohu v celkovom výkone. Takže voľba času vykonávania sa určuje architektom OS a závisí od úloh, ktoré by mali byť vykonané. Prepínanie kontextu nie je jediná pomocná operácia, ktorá spotrebúva čas; spustený program sa zaoberá mnohými ďalšími aspektmi, napríklad rôznymi cache, a pri každom prepínaní je potrebné uložiť a obnoviť toto prostredie, čo môže taktiež vyžadovať veľa času.
RR je skvelý plánovač, ak by bolo reč len o metrike času odpovede. Ale aké bude správanie metriky času obratu úlohy pri tomto algoritme? Pozrime sa na vyššie uvedený príklad, keď majú úlohy A, B, C = 5s a prichádzajú v rovnakom čase. Úloha A sa dokončí v 13, B v 14, C v 15s a priemerný čas obratu bude 14s. Takže RR je najhorší algoritmus z hľadiska metriky obratu.
Všeobecne povedané, akýkoľvek algoritmus typu RR je spravodlivý, delí čas CPU rovnomerne medzi všetky procesy. A týmto spôsobom si tieto metriky neustále odporujú.
Tým pádom máme niekoľko protikladných algoritmov a pritom ostáva niekoľko predpokladov — že je čas úlohy známy a že úloha využíva len CPU.
Zmes s I/O
Predovšetkým odstránime predpoklad 4, že proces využíva len CPU; prirodzene, nie je to tak a procesy môžu pristupovať aj k inému hardvéru.
V okamihu, keď nejaký proces požaduje operáciu vstupu-výstupu, prechádza do stavu blokovaný a čaká na dokončenie I/O. Ak je I/O poslané na pevný disk, takáto operácia môže trvať až niekoľko ms alebo dlhšie a procesor v tomto momente bude nečinne čakať. Počas tohto času plánovač môže obsadiť procesor akýmkoľvek iným procesom. Nasledujúce rozhodnutie, ktoré bude musieť plánovač urobiť — kedy proces ukončí svoj I/O. Keď sa to stane, dôjde k prerušeniu a OS prevedie proces, ktorý požiadal o I/O, do stavu pripravené.
Posúdime príklad s niekoľkými úlohami. Každá z nich potrebuje 50 ms procesorového času. Prvá však každých 10 ms pristupuje k I/O (ktorý sa tiež vykonáva každých 10 ms). Proces B jednoducho využíva 50 ms procesora bez I/O.
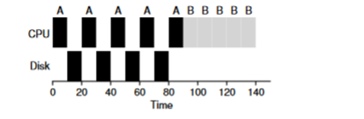
V tomto príklade budeme používať plánovač STCF. Ako sa plánovač správa, ak spustíme na ňom proces A? Postupuje takto — najprv úplne vykoná proces A a potom proces B.
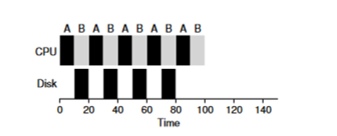
Tradičný prístup na riešenie tohto problému je interpretovať každú 10 ms podúlohu procesu A ako samostatnú úlohu. Týmto spôsobom, pri štarte s algoritmom STJF je voľba medzi úlohou trvajúcou 50 ms a 10 ms úlohou zrejmá. Potom, keď sa podúloha A dokončí, spustí sa proces B a I/O. Po dokončení I/O sa znova spustí 10 ms proces A namiesto procesu B. Týmto spôsobom je možné realizovať prekrývanie, keď je CPU využívané iným procesom, kým prvý čaká na I/O. V dôsledku toho je systém lepšie využitý — v čase, keď interaktívne procesy čakajú na I/O, môžu na procesore bežať aj iné procesy.
Orákulum už neexistuje
Teraz sa pokúsime zbaviť predpokladu, že čas vykonávania úlohy je známy. Tento predpoklad je vôbec najhorší a nerealistický zo všetkých na zozname. V skutočnosti priemerné bežné operačné systémy majú veľmi obmedzené znalosti o čase vykonávania úloh, ako môžeme potom postaviť plánovač bez vedomia, ako dlho úloha bude bežať? Možno by sme mohli použiť určité princípy RR na riešenie tohto problému?
Záver
Preskúmali sme základné myšlienky plánovania úloh a zvážili sme 2 rodiny plánovačov. Prvý spúšťa najkratšiu úlohu najskôr a tým zvyšuje čas obratu, druhý naopak rozdeľuje čas rovnomerne medzi všetky úlohy, zvyšujúc čas odozvy. Obe algoritmy sú slabé tam, kde sú silné algoritmy druhej rodiny. Taktiež sme preskúmali, ako paralelné využitie CPU a I/O môže zlepšiť výkon, avšak problém so zrakom operačného systému sme nevyriešili. A na nasledujúcej lekcii preskúmame plánovač, ktorý sa pozerá do najbližšej minulosti a snaží sa predpovedať budúcnosť. A volá sa multi-level feedback queue.
Zdroj: habr.com
