

Úvod do operačných systémov
Ahoj, Habr! Chcem vám predstaviť sériu článkov-prekladu zaujímavej literatúry, ktorú považujem za zaujímavú — OSTEP. V tomto materiáli sa podrobne zaoberá fungovaním unixových operačných systémov, konkrétne prácou s procesmi, rôznymi plánovačmi, pamäťou a inými podobnými komponentmi, ktoré tvoria moderný OS. Originál všetkých materiálov si môžete pozrieť tu: . Prosím berte na vedomie, že preklad bol vykonaný neprofesionálne (dosť voľne), ale dúfam, že som zachoval celkový zmysel.
Laboratórne práce na tomto predmete nájdete tu:
Ďalšie časti:
A môžete sa pozerať aj na môj kanál v =)
Plánovanie: Multi-Level Feedback Queue
V tejto prednáške sa budeme zaoberať problémami vývoja jedného z najznámejších prístupov k
plánovaniu, ktorý sa nazýva Multi-Level Feedback Queue (MLFQ). Po prvýkrát bol plánovač MLFQ popísaný v roku 1962 Fernando J. Corbató v systéme nazývanom
Compatible Time-Sharing System (CTSS). Tieto práce (vrátane oneskorených prác na
Multics) boli neskôr nominadoé na cenu Turing Award. Plánovač bol
neskôr vylepšený a nadobudol podobu, ktorú už môžeme nájsť v
niektorých moderných systémoch.
Algoritmus MLFQ sa pokúša vyriešiť 2 základné prekrývajúce sa problémy.
Po prvé,snaží sa optimalizovať dobu obratu, ktorá sa, ako sme preberali v predchádzajúcej prednáške, optimalizuje metódou spustenia na začiatku fronty najviac
krátkych úloh. Avšak, OS nevie, ako dlho bude bežať ten či onen proces, a to je
nevyhnutné vedomosti pre fungovanie algoritmov SJF, STCF. Po druhé,MLFQ sa snaží
urobiť systém reagujúcim pre používateľov (napríklad pre tých, ktorí sedí a
hľadia na obrazovku v očakávaní dokončenia úlohy), a tým minimalizovať čas
odpovede. Bohužiaľ, algoritmy ako RR znižujú čas odpovede, ale majú veľmi
malý vplyv na metriky doby obratu. Odtiaľ pramení náš problém: Ako navrhnúť
plánovač, ktorý bude spĺňať naše požiadavky a pritom nič nevedieť o
aký je proces v celkovom pohľade? Ako má plánovač skúmať charakteristiky úloh,
ktoré vykonáva, a tak prijímať lepšie rozhodnutia o plánovaní?
Podstata problému: Ako plánovať úlohy bez dokonalého poznania?
Ako navrhnúť plánovač, ktorý súčasne minimalizuje čas odozvy
pre interaktívne úlohy a zároveň minimalizuje čas obratu bez vedomia
doby vykonania úlohy?
Poznámka: učiť sa na základe predchádzajúcich udalostí
Rada MLFQ je skvelý príklad systému, ktorý sa učí na
predchádzajúcich udalostiach, aby predpovedal budúcnosť. Takéto prístupy
sú časté v OS (a mnohých iných oblastiach informatiky, vrátane vetiev
predpovedania v hardvéri a algoritmov ukladania do pamäte). Tieto prístupy
fungujú, keď úlohy majú správanie a sú tak predvídateľné.
Avšak pri používaní tejto techniky by ste mali byť opatrní, pretože predpovede môžu byť veľmi ľahko
nepresné a môžu viesť systém k prijatiu horších rozhodnutí, než
by boli bez akýchkoľvek vedomostí.
MLFQ: Základné pravidlá
Pozrime sa na základné pravidlá algoritmu MLFQ. A hoci existuje viacero implementácií tohto algoritmu,
základné prístupy sú podobné.
V implementácii, ktorú budeme skúmať, bude MLFQ obsahovať niekoľko
samostatných radov, z ktorých každý bude mať iný prioritu. Kedykoľvek,
úloha pripravená na vykonanie sa nachádza v jednom rade. MLFQ používa priority,
aby určil, ktorú úlohu spustiť na vykonanie, t.j. úloha s vyšším
prioritou (úloha z radu s najvyššou prioritou) bude spustená ako prvá.
Samozrejme, v konkrétnom rade môže byť viac než jedna úloha, tak
budú mať rovnakú prioritu. V tomto prípade sa použije mechanizmus
RR na plánovanie spúšťania medzi týmito úlohami.
Takto sa dostávame k dvom základným pravidlám pre MLFQ:
Pravidlo1: Ak priorita(A) > Priorita(B), úloha A bude spustená (B nebude)
- Pravidlo2: Ak priorita(A) = Priorita(B), A a B sa spúšťajú pomocou RR
- Na základe vyššie uvedeného sú kľúčové prvky plánovania MLFQ
priority. Namiesto toho, aby sme každému úlohám priradili fixnú prioritu,
sú priorítami. Namiesto toho, aby sa každému priradil pevný priorita
úlohe, MLFQ mení jej prioritu na základe pozorovaného správania.
Napríklad, ak úloha neustále prehadzuje prácu na CPU, aby čakala na vstup z klávesnice,
MLFQ udrží prioritu procesu na vysokej úrovni, pretože takto
by mal fungovať interaktívny proces. Naopak, ak úloha neustále a
intenzívne využíva CPU počas dlhého obdobia, MLFQ jej
prioritu zníži. Týmto spôsobom MLFQ spoznáva správanie procesov počas ich výkonu
a využíva toto správanie.
Nakreslime príklad, ako by mohli vyzerať rady v určitom
čase a dostaneme niečo ako toto:
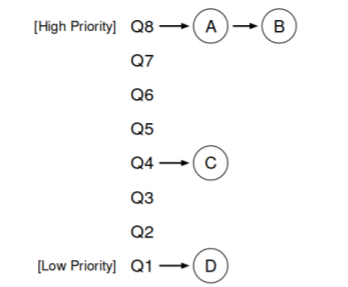
V tejto schéme sú 2 procesy A a B v rade s najvyššou prioritou. Proces
C je niekde v strede a proces D na konci radu. Podľa vyššie uvedených
opisov algoritmu MLFQ plánovač vykoná úlohy len s najvyššou
prioritou podľa RR, a úlohy C, D zostanú mimo.
Samozrejme, statický snímok neposkytne úplný obraz o tom, ako MLFQ funguje.
Je dôležité porozumieť, ako sa obraz mení v priebehu času.
Pok Attempt 1: Ako meniť prioritu
V tomto momente je potrebné rozhodnúť, ako MLFQ bude meniť úroveň priority
úlohy (a tým aj jej pozíciu v rade) v priebehu jej životného cyklu. Na
to je potrebné mať na pamäti pracovný postup: určité množstvo
interaktívnych úloh s krátkou dobou vykonávania (a teda časté uvoľnenie
CPU) a niekoľko dlhých úloh, ktoré využívajú CPU počas celého svojho pracovného času, pričom
časová odozva pre takéto úlohy nie je dôležitá. A tak môžeme urobiť prvý pokus
realizovať algoritmus MLFQ s nasledujúcimi pravidlami:
- Pravidlo 3: Keď úloha vstúpi do systému, umiestni sa do radu s najvyšším
- prioritou.
- Pravidlo 4a: Ak úloha využije celé jej pridelené časové okno, tak jej
- priorita klesá.
- Pravidlo 4b: Ak úloha uvoľní CPU pred uplynutím svojho časového okna, tak zostane
- so svojou predchádzajúcou prioritou.
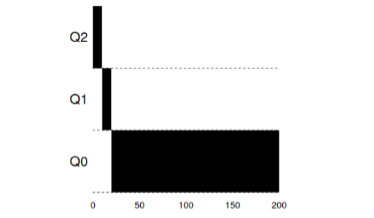
Príklad 1: Jedna dlhodobá úloha
Ako vidno v tomto príklade, úloha pri prijatí dostáva najvyššiu
prioritu. Po časovom okne 10 ms je priorita procesu znížená
plánovačom. Po nasledujúcom časovom okne je úloha konečne znížená na
nižšou prioritou v systéme, kde aj zostáva.
Príklad 2: Doviezli krátku úlohu
Teraz sa pozrime na príklad toho, ako MLFQ sa pokúsi priblížiť k SJF. V tomto
príklade sú dve úlohy: A, ktorá je dlhodobou úlohou neustále
využívajúcou CPU a B, ktorá je krátkou interaktívnou úlohou. Predpokladajme,
že A už pracovala určitý čas, keď sa objavila úloha B.
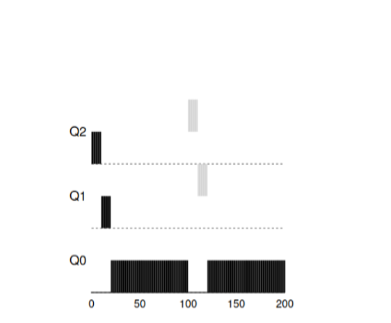
Na tomto grafe sú viditeľné výsledky scenára. Úloha A, ako akákoľvek úloha,
využívajúca CPU, sa ocitla na samom dne. Úloha B sa dostane v čase T=100 a bude
umiestnená do fronty s najvyššou prioritou. Keďže jej doba spracovania je krátka,
dokončí sa skôr, než dosiahne poslednú frontu.
Z tohto príkladu je potrebné pochopiť hlavnú myšlienku algoritmu: keďže algoritmus nevie,
či je úloha dlhá alebo krátka, najprv predpokladá, že úloha
je krátka a pridelením najvyššej prioritnej úrovni. Ak je to naozaj krátka úloha, tak
sa vykoná rýchlo, inak, ak je to dlhá úloha, bude pomaly presúvať
prioritu nadol a čoskoro dokáže, že je to naozaj dlhá úloha, ktorá ne
vyžaduje reakciu.
Príklad 3: Čo teda s vstupom-výstupom?
Teraz sa pozrieme na príklad so vstupom-výstupom. Ako sa uvádzalo v pravidle 4b,
ak proces oslobodí procesor, aniž by úplne využil jeho čas procesora,
zostáva na predchádzajúcej úrovni priority. Zmysel tohto pravidla je celkom jednoduchý
— ak interaktívna úloha vykonáva množstvo operácií vstupu-výstupu, napr. čakajúc
na stlačenia klávesy alebo myši od užívateľa, taká úloha oslobodí procesor
skôr, ako je vyhradený čas. Nechceme, aby taká úloha klesla v prioritách,
a tak zostane na predchádzajúcej úrovni.
Tento príklad ukazuje, ako bude algoritmus pracovať s takýmito procesmi – interaktívna úloha B, ktorá potrebuje CPU len na 1 ms pred vykonaním
procesu vstupu-výstupu a dlhá úloha A, ktorá celé svoje čas využíva CPU.
MLFQ udržuje proces B s najvyššou prioritou, keďže stále,
oslobodzuje CPU. Ak je B interaktívna úloha, tak algoritmus v takom prípade dosiahol
svoju cieľovú rýchlosť spúšťania interaktívnych úloh.
Problémy s aktuálnym algoritmom MLFQ
V predchádzajúcich príkladoch sme vytvorili základnú verziu MLFQ. A zdá sa, že to
dobré fungovanie a spravodlivo rozdeľuje procesorový čas medzi
dlhé úlohy a umožňuje krátkym úlohám alebo úlohám intenzívne využívajúcim
vstup a výstup pracovať rýchlo. Bohužiaľ, tento prístup obsahuje niekoľko
vážnych problémov.
Po prvé,, problém hladu: ak bude v systéme množstvo interaktívnych
úloh, spotrebujú všetok procesorový čas a tým pádom žiadna dlhá
úloha nebude mať možnosť vykonávať sa (trpí hladom).
Po druhé,, inteligentní používatelia by mohli písať svoje programy tak, aby
oškubali planner. Ošklbanie spočíva v tom, že by som mal urobiť niečo také, aby donútil
plánovač prideliť procesoru viac procesorového času. Algoritmus, ktorý
bol opísaný vyššie, je úplne zraniteľný voči takýmto útokom: predtým, ako časové okno prakticky
skončilo, je potrebné vykonať operáciu vstupu a výstupu (na nejaký, nezáleží na tom, aký súbor)
a tým pádom uvoľniť CPU. Takéto správanie umožní zostať v tej istej
černej línii a znova získať väčší percentuálny podiel procesorového času. Ak sa to urobí
správne (napríklad sa vykonáva 99% času v okne pred uvoľnením CPU),
taká úloha môže jednoducho monopolizovať procesor.
Nakoniec, program môže meniť svoje správanie v priebehu času. Tieto úlohy,
ktoré využívali CPU, sa môžu stať interaktívnymi. V našom príklade takéto
úlohy nedostanú riadne zaobchádzanie od plánovača, pretože by dostali iné
(pôvodné) interaktívne úlohy.
Otázka do publika: aké útoky na plánovač by mohli byť vykonané v modernom svete?
Pokús č. 2: Zvyšovanie priorít
Skúsme zmeniť pravidlá a pozrime sa, či sa nám podarí vyhnúť sa problémom s
hladovaním. Čo by sme mohli urobiť, aby sme zaručili, že s
CPU súvisiace úlohy dostanú svoj čas (aj keď nie dlhý).
Ako jednoduché riešenie problému môžeme navrhnúť pravidelne
zvyšovať prioritu všetkých takýchto úloh v systéme. Existuje mnoho spôsobov
ako to dosiahnuť, skúsme realizovať niečo jednoduché: previesť
všetky úlohy na najvyššiu prioritu, odtiaľto nové pravidlo:
- Pravidlo5: Po uplynutí určitého času S previesť všetky úlohy v systéme do najvyššej priority.
Naše nové pravidlo rieši dve problémy naraz. Po prvé, procesy
zaručene netrpia hladovaním: úlohy v najvyššej priorite budú zdieľať
procesorový čas podľa algoritmu RR a tak všetky procesy dostanú
procesorový čas. Po druhé, ak nejaký proces, ktorý predtým používal
iba procesor, sa stane interaktívnym, zostane v rade s vyššou
prioritou po tom, čo raz dostane zvýšenie priority na najvyššiu.
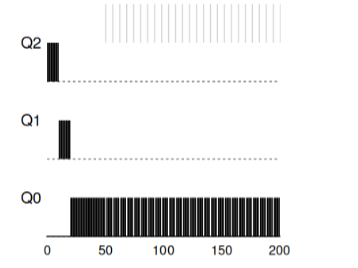
Zvážme príklad. V tomto scenári zvážime jeden proces používajúci
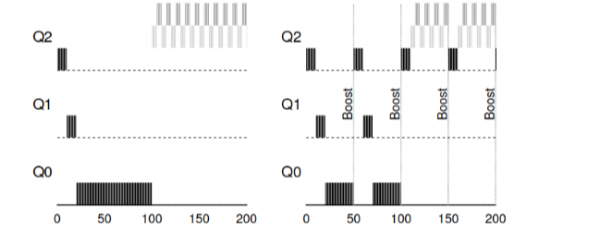
CPU a dva interaktívne, krátke procesy. Vľavo na obrázku je znázornené správanie bez zvýšenia priority, a tak dlhá úloha začína hladovať po príchode do systému dvoch interaktívnych úloh. Na obrázku vpravo sa každých 50ms vykonáva zvýšenie priority a tak všetky procesy zaručene dostanú procesorový čas a budú pravidelne spúšťané. 50ms je v tomto prípade uvedené ako príklad, v skutočnosti je toto číslo o niečo vyššie.
Je zrejmé, že pridanie času periodického zvýšenia S vedie k
logickej otázke: aká hodnota by mala byť nastavená? Jeden zaslúžený
systémový inžinier John Ousterhout volal takéto hodnoty v systémoch voodoo
konštanta, pretože si v určitom zmysle vyžadovali čiernu mágiu na správne
nastavenie. A, žiaľ, S má taký nádych. Ak nastavíte hodnotu príliš
veľkou — dlhé úlohy začnú hladovať. A ak nastavíte príliš nízku hodnotu,
interaktívne úlohy nedostanú primeraný procesorový čas.
PokAttempt 3: Najlepšie sledovanie
Teraz máme ďalší problém, ktorý musíme vyriešiť: ako nenechať
očí tu pľuvať náš plánovač? Vinní sú pravidlá 4a, 4b, ktoré umožňujú úlohe zachovať prioritu uvoľňovaním procesora
pred uplynutím prideleného času. Ako s týmto bojovať?
Riešením v tomto prípade môže byť lepšie sledovanie času CPU na každej
úrovni MLFQ. Namiesto toho, aby sa zabudlo na čas, ktorý program použil
na úrovni MLFQ. Namiesto toho, aby sa zabudlo na čas, ktorý program využil
Pri procesore za určený časový úsek je potrebné ho zohľadniť a uchovať. Po
tom, ako proces minie svoj časový limit, je potrebné jeho prioritu znížiť na
následnú úroveň. Teraz nezáleží na tom, ako proces využije svoj čas — či
stále vypočítava na procesore, alebo ako množstvo volaní. Týmto spôsobom
je potrebné preformulovať pravidlo 4 do nasledujúcej podoby:
- Pravidlo4: Po tom, ako úloha minie pridelenej čas, v súčasnej fronte (bez ohľadu na to, koľkokrát uvoľnila CPU), jej priorita sa zníži (postupuje nižšie v fronte).
Pozrime sa na príklad:
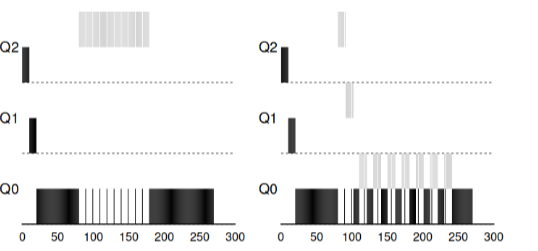 »
Na obrázku je znázornené, čo sa stane, ak sa pokúsime oklamať plánovač, ako
s predchádzajúcimi pravidlami 4a, 4b dostaneme výsledok vľavo. S novým
pravidlom — výsledok vpravo. Pred ochranou mohol akýkoľvek proces vyvolať I/O pred dokončením a
týmto dominovať na CPU, po zapnutí ochrany, bez ohľadu na správanie
I/O, vždy poklesne v poradí a tým nemôže nečestne
získať prostriedky CPU.
Vylepšovanie MLFQ a ďalšie problémy
S uvedenými vylepšeniami sa objavujú nové problémy: jednou z hlavných
otázok je, ako parametrize podobný plánovač? T.j. Koľko by malo byť
front? Aká by mala byť veľkosť pracovného okna programu v rámci fronty? Ako
často by sa mala priorita programu zvyšovať, aby sa predišlo hladu a
zohľadnilo sa zmenené správanie programu? Na tieto otázky nie je jednoduchá
odpoveď a len experimentovanie s zaťažením a následné konfigurácie
plánovača môžu viesť k nejakému uspokojivému vyváženiu.
Napríklad, väčšina realizácií MLFQ umožňuje priradiť rôzne
časové úseky rôznym frontám. Vysokoprioritné fronty obvykle
dostávajú krátke časové intervaly. Tieto fronty pozostávajú z interaktívnych úloh,
medzi ktorými je prepínanie dosť citlivé a malo by trvať 10 alebo menej
ms. Naopak, nízkoprioritné fronty pozostávajú z dlhých úloh, využívajúcich
CPU. A v tomto prípade sú dlhé časové intervaly veľmi vhodné (100ms).
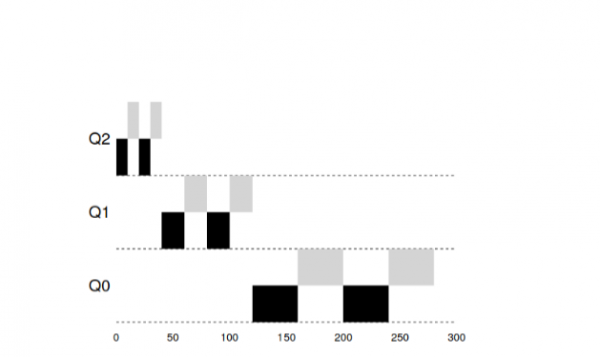
V tomto príklade sú 2 úlohy, ktoré pracovali vo vysokoprioritnej fronte 20
ms, rozdelené do okien po 10 ms. 40 ms v priemernej rade (okno 20 ms) a v nízkoprioritnej
rady, sa dočasné okno stalo 40 ms, kde úlohy dokončili svoju prácu.
Implementácia MLFQ v OS Solaris – trieda plánovačov, ktorá rozdeľuje podľa času.
Plánovač poskytuje súbor tabuliek, ktoré presne určujú, ako by mal
meniť prioritu procesu počas jeho života, aká by mala byť veľkosť
vyhradeného okna a ako často je potrebné zvyšovať priority úlohy. Administrátor
systému môže interagovať s touto tabuľkou a nútiť plánovač, aby sa správal
iným spôsobom. Predvolene má táto tabuľka 60 radov so stupňujúcou sa
veľkosťou okna od 20 ms (vysoká priorita) po niekoľko stoviek ms (nízka priorita), a
taktiež s urýchlením všetkých úloh raz za sekundu.
Iné MLFQ plánovače nepoužívajú tabuľku alebo žiadne konkrétne
pravidlá, ktoré sú popísané v tejto prednáške, naopak, vypočítavajú priority pomocou
matematických vzorcov. Napríklad plánovač v FreeBSD používa vzorec na
vypočítanie aktuálnej priority úlohy, na základe toho, ako často proces
využíval CPU. Okrem toho, využívanie CPU s časom klesá, a takto
zvyšovanie priority prebieha trochu inak, ako je opísané vyššie. Tieto sú
takzvané decay algoritmy. Od verzie 7.1 v FreeBSD sa používa plánovač ULE.
Nakoniec, mnohé plánovače majú ďalšie špecifiká. Napríklad niektoré
plánovače rezervujú vyššie úrovne pre prácu operačného systému, a tak
žiadny používateľský proces nebude môcť získať najvyššiu prioritu v
systéme. Niektoré systémy umožňujú poskytovať rady na pomoc
plánovaču správne nastaviť priority. Tak napríklad pomocou príkazu nice
je možné zvyšovať alebo znižovať prioritu úlohy a takto zvyšovať alebo
znižovať šance programu na procesorový čas.
MLFQ: Zhrnutie
Opísali sme prístup k plánovaniu, ktorý sa nazýva MLFQ. Jeho názov
spočíva v princípe fungovania – má niekoľko radov a využíva spätnú väzbu
na určenie priority úlohy.
Koncový vzor pravidiel bude nasledovný:
- Pravidlo 1: Ak priorita(A) > priorita(B), bude spustená úloha A (B nie).
- Pravidlo 2: Ak je priorita (A) = priorite (B), A a B sa spúšťajú pomocou RR
- Pravidlo3: Keď úloha príde do systému, umiestni sa do frontu s najvyššou prioritou.
- Pravidlo4: Po tom, ako úloha minie pridelenej čas, v súčasnej fronte (bez ohľadu na to, koľkokrát uvoľnila CPU), jej priorita sa zníži (postupuje nižšie v fronte).
- Pravidlo5: Po uplynutí určitého času S previesť všetky úlohy v systéme do najvyššej priority.
MLFQ je zaujímavý z nasledujúceho dôvodu — namiesto toho, aby vyžadoval predchádzajúce vedomie o
prírode úlohy, algoritmus skúma predchádzajúce správanie úlohy a prideľuje
priority zodpovedajúcim spôsobom. Snaží sa tak sedieť na dvoch stoličkách — dosiahnuť výkon pre malé úlohy (SJF, STCF) a spravodlivo spúšťať dlhé,
CPU náročné úlohy. Preto mnohé systémy, vrátane BSD a ich derivátov,
Solaris, Windows, Mac používajú ako plánovač nejakú formu algoritmu
MLFQ ako základnú bázu.
Ďalšie materiály:
- (computing)
Zdroj: habr.com
