

Mikroslužbová architektúra, rovnako ako všetko na tomto svete, má svoje výhody a nevýhody. Niektoré procesy sa s ňou stávajú jednoduchšími, iné — zložitejšími. A na úkor rýchlosti zmien a lepšej škálovateľnosti je potrebné prinášať určité obete. Jedna z nich — skomplikovanie analytiky. Ak sa v monolite celá operačná analytika dá zúžiť na SQL dopyty na analytickú repliku, tak v mult službe má každý servis svoju databázu a zdá sa, že jedným dopytom sa to nedá obísť (ale možno aj dá?). Pre tých, ktorých zaujíma, ako sme vyriešili problém operačnej analytiky v našej firme a ako sme sa naučili žiť s týmto riešením — vitajte.
Volám sa Pavol Sivaš, v DomKliku pracujem v tíme, ktorý zodpovedá za spravovanie analytického dátového skladu. Našu činnosť môžeme z pohľadu označiť za dátovú inžinieriu, ale v skutočnosti je spektrum úloh omnoho širšie. Zvyčajné úlohy pre dátovú inžinieriu ETL/ELT, podpora a prispôsobenie nástrojov na analýzu dát a vývoj našich vlastných nástrojov. Konkrétne, pre operačné reportovanie sme sa rozhodli „predstierať“, že máme monolit a poskytnúť analytikom jednu databázu, v ktorej budú všetky potrebné dáta.
V skutočnosti sme uvažovali o rôznych možnostiach. Mohli sme vybudovať plnohodnotné úložisko — dokonca sme to skúšali, ale úprimne povedané, nikdy sa nám nepodarilo zladiť dosť časté zmeny v logike s dosť pomalým procesom výstavby úložiska a zmenami v ňom (ak sa niekomu podarilo, napíšte to prosím do komentárov). Mohli sme povedať analytikom: „Chlapi, učte sa Python a choďte do analytických replik“, ale to by bolo dodatočné požiadavky na výber zamestnancov, a zdalo sa, že tomuto by sme sa mali vyhnúť, ak je to možné. Rozhodli sme sa vyskúšať technológiu FDW (Foreign Data Wrapper): v podstate ide o štandardný dblink, ktorý je v štandarde SQL, ale s oveľa pohodlnejším rozhraním. Na jej základe sme vyvinuli riešenie, ktoré sa nakoniec uchytilo, na ktorom sme sa zastavili. Jeho podrobnosti sú témou samostatného článku, možno aj viacerých, pretože máme veľa o čom hovoriť: od synchronizácie schém databáz po správu prístupu a anonymizáciu osobných údajov. Takisto je potrebné poznamenať, že toto riešenie nie je náhradou za reálne analytické databázy a úložiská, rieši iba konkrétny problém.
Na vyššej úrovni to vyzerá takto:
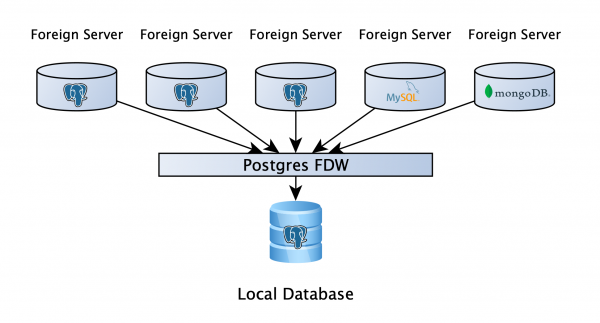
Existuje databáza PostgreSQL, kde si používateľ môže uchovávať svoje pracovné údaje, a najdôležitejšie je, že k tejto databáze sú prostredníctvom FDW pripojené analytické repliky všetkých služieb. To umožňuje napísať dopyt na niekoľko databáz, pričom nezáleží na tom, či ide o PostgreSQL, MySQL, MongoDB alebo niečo iné (súbor, API, ak neexistuje vhodný wrapper, môžete napísať svoj). Takže, všetko super! Môžeme ísť prerozdeliť?
Keby to všetko končilo tak rýchlo a jednoducho, pravdepodobne by tento článok ani neexistoval.
Je dôležité jasne pochopiť, ako PostgreSQL spracováva dopyty na vzdialených serveroch. To sa zdá logické, avšak často si na to nikto nevšimne: PostgreSQL rozdelí dopyt na časti, ktoré sa vykonávajú na vzdialených serveroch nezávisle, zhromažďuje tieto údaje, a konečné výpočty vykonáva samotné, takže rýchlosť vykonania dopytu bude silno závisieť od toho, ako je napísaný. Takisto treba poznamenať: keď údaje prichádzajú z vzdialeného servera, už nemajú indexy, nemajú nič, čo by pomohlo plánovačovi, a preto mu môžeme pomôcť a poradiť len my sami. A práve o tom by som chcel rozprávať podrobnejšie.
Jednoduchý dotaz a plán s ním
Aby sme ukázali, ako PostgreSQL vykonáva dotaz na tabuľku s 6 miliónmi riadkov na vzdialenom serveri, pozrime sa na jednoduchý plán.
explain analyze verbose
SELECT count(1)
FROM fdw_schema.table;

Aggregate  (cost=418383.23..418383.24 rows=1 width=8) (actual time=3857.198..3857.198 rows=1 loops=1)
  Output: count(1)
  ->  Foreign Scan on fdw_schema."table"  (cost=100.00..402376.14 rows=6402838 width=0) (actual time=4.874..3256.511 rows=6406868 loops=1)
        Output: "table".id, "table".is_active, "table".meta, "table".created_dt
        Remote SQL: SELECT NULL FROM fdw_schema.table
Planning time: 0.986 ms
Execution time: 3857.436 ms
Použitie inštrukcie VERBOSE umožňuje vidieť dotaz, ktorý bude odoslaný na vzdialený server a výsledky, ktoré získame na ďalšie spracovanie (riadok RemoteSQL).
Poďme o niečo ďalej a pridajme do nášho dotazu niekoľko filtrov: jeden podľa boolean poľa, jeden podľa výskytu timestamp v intervale a jeden podľa jsonb.
explain analyze verbose
SELECT count(1)
FROM fdw_schema.table
WHERE is_active is True
AND created_dt BETWEEN CURRENT_DATE - INTERVAL '7 month'
AND CURRENT_DATE - INTERVAL '6 month'
AND meta->>'source' = 'test';

Aggregate  (cost=577487.69..577487.70 rows=1 width=8) (actual time=27473.818..25473.819 rows=1 loops=1)
  Output: count(1)
  ->  Foreign Scan on fdw_schema."table"  (cost=100.00..577469.21 rows=7390 width=0) (actual time=31.369..25372.466 rows=1360025 loops=1)
        Output: "table".id, "table".is_active, "table".meta, "table".created_dt
        Filter: (("table".is_active IS TRUE) AND (("table".meta ->> 'source'::text) = 'test'::text) AND ("table".created_dt >= (('now'::cstring)::date - '7 mons'::interval)) AND ("table".created_dt <= ((('now'::cstring)::date)::timestamp with time zone - '6 mons'::interval)))
        Rows Removed by Filter: 5046843
        Remote SQL: SELECT created_dt, is_active, meta FROM fdw_schema.table
Planning time: 0.665 ms
Execution time: 27474.118 ms
Práve tu spočíva moment, na ktorý je potrebné si dávať pozor pri písaní dotazov. Filtrové podmienky neboli odovzdané na vzdialený server, čo znamená, že na jeho vykonanie PostgreSQL ťahá všetkých 6 miliónov riadkov, aby ich následne lokálne filtroval (riadok Filter) a vykonal agregáciu. Kľúčom k úspechu je napísať dotaz tak, aby sa filtre odovzdali na vzdialený stroj a my sme získali a agregovali len potrebné riadky.
To je nejaký booleanshit
S boolean poliami je všetko jasné. V pôvodnom dotaze nastal problém v dôsledku operátora is. Ak ho nahradíme =, dostaneme nasledujúci výsledok:
vysvetliť analyzovať podrobne
SELECT count(1)
FROM fdw_schema.table
WHERE is_active = True
AND created_dt BETWEEN CURRENT_DATE - INTERVAL '7 mesiacov'
AND CURRENT_DATE - INTERVAL '6 mesiacov'
AND meta->>'source' = 'test';

Agregát  (náklady=508010.14..508010.15 riadkov=1 šírka=8) (skutočný čas=19064.314..19064.314 riadkov=1 slučky=1)
  Výstup: count(1)
  ->  Cudzie skenovanie na fdw_schema."table"  (náklady=100.00..507988.44 riadkov=8679 šírka=0) (skutočný čas=33.035..18951.278 riadkov=1360025 slučky=1)
        Výstup: "table".id, "table".is_active, "table".meta, "table".created_dt
        Filter: ((("table".meta ->> 'source'::text) = 'test'::text) AND ("table".created_dt >= (('teraz'::cstring)::date - '7 mesiacov'::interval)) AND ("table".created_dt <= ((('teraz'::cstring)::date)::timestamp with time zone - '6 mesiacov'::interval)))
        Riadky odstránené filtrom: 3567989
        Vzdialený SQL: SELECT created_dt, meta FROM fdw_schema.table WHERE (is_active)
Plánovací čas: 0.834 ms
Čas vykonávania: 19064.534 ms
Ako vidíte, filter sa presunul na vzdialený server a čas vykonávania sa skrátil z 27 na 19 sekúnd.
Je potrebné poznamenať, že operátor is sa líši od operátora = tým, že dokáže pracovať so hodnotou Null. To znamená, že is not True vo filtri ponechá hodnoty False a Null, zatiaľ čo != True ponechá len hodnoty False. Preto pri nahradení operátora is not je potrebné do filtra zahrnúť dve podmienky s operátorom OR, napríklad, WHERE (col != True) OR (col is null).
S boolean hodnotami sme sa vysporiadali, posúvame sa ďalej. A zatiaľ vrátime filter podľa boolean hodnoty do pôvodného stavu, aby sme nezávisle preskúmali efekt iných zmien.
timestamptz? hz
Vo všeobecnosti sa často musíme experimentovať s tým, ako správne napísať dopyt, v ktorom sa zúčastňujú vzdialené servery, a až potom hľadať vysvetlenie, prečo sa to deje presne tak. Veľmi málo informácií o tomto možno nájsť na Internete. Takže v experimentoch sme zistili, že filter podľa pevného dátumu sa presúva na vzdialený server bez problémov, ale keď chceme zadať dátum dynamicky, napríklad now() alebo CURRENT_DATE, to sa nestáva. V našom príklade sme pridali taký filter, aby stĺpec created_at obsahoval údaje presne za 1 mesiac v minulosti (BETWEEN CURRENT_DATE - INTERVAL '7 mesiacov' AND CURRENT_DATE - INTERVAL '6 mesiacov'). Čo sme teda podnikli v tomto prípade?
explain analyze verbose
SELECT count(1)
FROM fdw_schema.table
WHERE is_active is True
AND created_dt >= (SELECT CURRENT_DATE::timestamptz - INTERVAL '7 mesiacov')
AND created_dt >'source' = 'test';

Aggregate  (cost=306875.17..306875.18 rows=1 width=8) (actual time=4789.114..4789.115 rows=1 loops=1)
  Output: count(1)
  InitPlan 1 (returns $0)
    ->  Result  (cost=0.00..0.02 rows=1 width=8) (actual time=0.007..0.008 rows=1 loops=1)
          Output: ((('now'::cstring)::date)::timestamp with time zone - '7 mesiacov'::interval)
  InitPlan 2 (returns $1)
    ->  Result  (cost=0.00..0.02 rows=1 width=8) (actual time=0.002..0.002 rows=1 loops=1)
          Output: ((('now'::cstring)::date)::timestamp with time zone - '6 mesiacov'::interval)
  ->  Foreign Scan on fdw_schema."table"  (cost=100.02..306874.86 rows=105 width=0) (actual time=23.475..4681.419 rows=1360025 loops=1)
        Output: "table".id, "table".is_active, "table".meta, "table".created_dt
        Filter: (("table".is_active IS TRUE) AND (("table".meta ->> 'source'::text) = 'test'::text))
        Rows Removed by Filter: 76934
        Remote SQL: SELECT is_active, meta FROM fdw_schema.table WHERE ((created_dt >= $1::timestamp with time zone)) AND ((created_dt < $2::timestamp with time zone))
Planning time: 0.703 ms
Execution time: 4789.379 ms
Dali sme plánovaču návrh na predvýpočet dátumu v poddotaze a prenos už pripravených premenných do filtra. A táto rada nám priniesla skvelý výsledok, dopyt sa stal rýchlejším takmer 6-krát!
Opäť je dôležité byť pozorný: typ údajov v poddotaze musí byť taký istý, ako pole, podľa ktorého filtrujeme, inak plánovač rozhodne, že keďže typy sú rôzne, je potrebné najprv získať všetky údaje a až následne ich filtrovať lokálne.
Vrátime filter podľa dátumu na pôvodnú hodnotu.
Freddy vs. Jsonb
Vo všeobecnosti už booleovské polia a dátumy dostatočne zrýchlili náš dopyt, avšak zostával ešte jeden typ údajov. Boj s filtráciou na ňom, úprimne povedané, stále nie je ukončený, aj keď aj tu sú úspechy. Takže, takto sa nám podarilo preniesť filter podľa jsonb pola na vzdialený server.
explain analyze verbose
SELECT count(1)
FROM fdw_schema.table
WHERE is_active is True
AND created_dt BETWEEN CURRENT_DATE - INTERVAL '7 mesiacov'
AND CURRENT_DATE - INTERVAL '6 mesiacov'
AND meta @> '{"source":"test"}'::jsonb;

Aggregate  (cost=245463.60..245463.61 rows=1 width=8) (actual time=6727.589..6727.590 rows=1 loops=1)
  Output: count(1)
  ->  Foreign Scan on fdw_schema."table"  (cost=1100.00..245459.90 rows=1478 width=0) (actual time=16.213..6634.794 rows=1360025 loops=1)
        Output: "table".id, "table".is_active, "table".meta, "table".created_dt
        Filter: (("table".is_active IS TRUE) AND ("table".created_dt >= (('now'::cstring)::date - '7 mesiacov'::interval)) AND ("table".created_dt  '{"source": "test"}'::jsonb))
Planning time: 0.747 ms
Execution time: 6727.815 ms
Namiesto filtrácie operátormi je potrebné použiť operátor prítomnosti jedného jsonb v inom. 7 sekúnd namiesto pôvodných 29. Zatiaľ je to jediná úspešná varianta prenášania filtrov cez jsonb na vzdialený server, ale je tu dôležité zohľadniť jednu obmedzenie: používame verziu databázy 9.6, ale do konca apríla plánujeme dokončiť posledné testy a prejsť na verziu 12. Ak sa aktualizujeme, napíšeme, ako to ovplyvnilo, pretože zmien, na ktoré máme veľké očakávania, je dosť: json_path, nové správanie CTE, push down (existuje od verzie 10). Veľmi sa tešíme, že to čoskoro vyskúšame.
Finish him
Skontrolovali sme, ako každá zmena ovplyvňuje rýchlosť dotazu jednotlivo. Poďme sa teraz pozrieť, čo sa stane, keď budú všetky tri filtre napísané správne.
explain analyze verbose
SELECT count(1)
FROM fdw_schema.table
WHERE is_active = True
AND created_dt >= (SELECT CURRENT_DATE::timestamptz - INTERVAL '7 month')
AND created_dt  '{"source":"test"}'::jsonb;

Aggregate  (cost=322041.51..322041.52 rows=1 width=8) (actual time=2278.867..2278.867 rows=1 loops=1)
  Output: count(1)
  InitPlan 1 (returns $0)
    ->  Result  (cost=0.00..0.02 rows=1 width=8) (actual time=0.010..0.010 rows=1 loops=1)
          Output: ((('now'::cstring)::date)::timestamp with time zone - '7 mons'::interval)
  InitPlan 2 (returns $1)
    ->  Result  (cost=0.00..0.02 rows=1 width=8) (actual time=0.003..0.003 rows=1 loops=1)
          Output: ((('now'::cstring)::date)::timestamp with time zone - '6 mons'::interval)
  ->  Foreign Scan on fdw_schema."table"  (cost=100.02..322041.41 rows=25 width=0) (actual time=8.597..2153.809 rows=1360025 loops=1)
        Output: "table".id, "table".is_active, "table".meta, "table".created_dt
        Remote SQL: SELECT NULL FROM fdw_schema.table WHERE (is_active) AND ((created_dt >= $1::timestamp with time zone)) AND ((created_dt  '{"source": "test"}'::jsonb))
Planning time: 0.820 ms
Execution time: 2279.087 ms
Áno, dotaz vyzerá zložitejšie, to je nútená daň, ale rýchlosť vykonania je 2 sekundy, čo je viac ako 10-krát rýchlejšie! A toto hovoríme o jednoduchom dotaze na relatívne malý súbor údajov. Pri reálnych dotazoch sme dostali nárast až o niekoľko stoviek percent.
Zhrňme: ak používate PostgreSQL s FDW, vždy skontrolujte, či sú všetky filtre odoslané na vzdialený server, a bude sa vám dariť... Aspoň dovtedy, kým sa nedostanete k joinom medzi tabuľkami z rôznych serverov. Ale to už je príbeh na ďalší článok.
Ďakujem za pozornosť! Budem rád, ak dostanem otázky, komentáre, ako aj príbehy o vašich skúsenostiach v komentároch.
Zdroj: habr.com
